
[TOC]
04:mysql之综合查询
今日工作任务路线图
flowchart LR subgraph BottomRow[综合查询] direction LR A[内连接查询] --> B[外连接查询] --> C[合并查询结果] --> D[嵌套查询] end一、工作场景
在一家中型企业的人力资源管理工作里,会频繁运用 MySQL 综合查询。企业有员工表,包含员工编号、姓名、入职时间等;部门表记录着部门编号、部门名称等;薪资表存有员工编号、薪资数额、发放日期等。
每到季度末,人力部门需要统计各部门员工的平均薪资。这时就会综合查询这三张表。通过员工编号关联员工表和薪资表,再通过部门编号关联员工表和部门表。筛选出本季度发放的薪资数据,按部门分组计算平均薪资。如此,就能清晰了解各部门的人力成本,为后续的预算规划、薪资调整等提供数据支撑。
二、为什么要学综合查询
在日常工作里,学会 MySQL 综合查询是非常必要的。以员工表、部门表和薪资表为例,单看一张表,能获取的信息有限。员工表只有员工基本信息,部门表只有部门情况,薪资表只有薪资数据。
但当你掌握综合查询,就能将三张表关联起来。比如想知道每个部门的平均薪资,就可以通过员工表关联部门表和薪资表,快速得出结果。还能查询出不同部门入职时间早且薪资高的员工。综合查询让你从多个角度挖掘数据价值,为企业的决策提供准确依据,极大提升工作效率和质量,所以很有学习的必要。
三、内连接查询
当前任务环节
flowchart LR subgraph BottomRow[综合查询] direction LR A[内连接查询] --> B[外连接查询] --> C[合并查询结果] --> D[嵌套查询] end classDef highlight stroke:#f00,stroke-width:2px; class A highlight;MySQL 内连接查询是一种常用的表连接方式,用于从多个表中提取相关联的数据。它分为隐式和显式内连接查询,区别在于是否包含 inner【ing呐】 join【载(白话)】 关键字 。只有主表和从表中的数据都满足连接条件时才能被查询出来,不满足则会被忽略 。
例如有员工表和部门表,若要查询每个员工所在部门的信息,可通过员工表中的部门 ID 与部门表中的 ID 匹配连接,获取员工姓名和部门名称等信息。内连接能确保数据准确,适用于查询具有明确关联关系的表 。
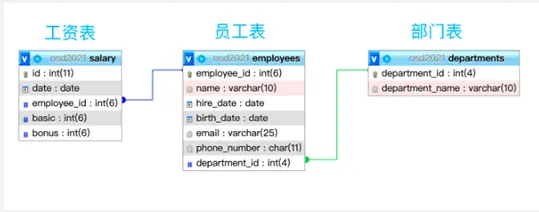
使用moershi库下的3张表做今天的查询练习。
- departments【迪帕踢门特s】:部门表,存储部门信息
- employees【ing普洛伊s】: 员工表,存储员工信息
- salary【撒拉瑞】: 工资表,存储工资信息
三张表的关系如果图
INNER【ing呐】 JOIN【载(白话)】 关键字详解
INNER【ing呐】 JOIN【载(白话)】是SQL中最基础且最重要的连接操作,它通过精确的匹配条件将相关的数据行连接在一起,是构建复杂查询和数据分析的基石。掌握INNER【ing呐】 JOIN【载(白话)】的正确用法对于进行有效的数据处理至关重要。
| 属性 | 说明 |
|---|---|
| 关键字 | INNER【ing呐】 JOIN【载(白话)】 |
| 中文名称 | 内连接 |
| 作用 | 返回两个表中满足连接条件的匹配行 |
| 语法 | SELECT【涩莱克特】 列名 FROM【弗乱】 表1 INNER【ing呐】 JOIN【载(白话)】 表2 ON【昂】 连接条件 |
| 返回值 | 只返回两个表中连接条件为TRUE的行 |
| 等价写法 | 可以省略INNER【ing呐】,直接写JOIN【载(白话)】 |
语法结构
基本语法结构
SELECT【涩莱克特】 列名列表 FROM【弗乱】 表1 INNER【ing呐】 JOIN【载(白话)】 表2 ON【昂】 表1.列名 = 表2.列名;
表1 INNER【ing呐】 JOIN【载(白话)】 表2: 是表连接 的核心部分,用于将 1 表和 2 表的数据关联起来。作用指定主表和从表:1 是主表(左表)。2 是从表(右表)。
定义连接类型:INNER JOIN 表示内连接,只返回两个表中匹配的记录。如果 1 表中的某条记录在 2 表中没有匹配的记录(即 employee_id 不匹配),则该记录不会出现在结果中。
配合连接条件:通常与 ON 子句一起使用(例如 ON employees.employee_id = salary.employee_id ),以指定如何匹配两个表的记录。
ON【昂】 表1.列名 = 表2.列名: 是 连接条件,用于指定 1 表和 2 表之间的关联关系作用定义表之间的关联: 它告诉数据库如何将 employees 表中的记录与 salary 表中的记录匹配起来。 只有当 employees.employee_id 和 salary.employee_id 的值相等时,两条记录才会被关联起来。
确保数据一致性: 通过这个条件,查询只会返回那些在 employees 表和 salary 表中都有对应 employee_id 的记录(如果是 INNER JOIN )。 如果是 LEFT JOIN ,则会返回 employees 表中的所有记录,即使 salary 表中没有匹配的记录(此时 salary 表的字段会显示为 NULL【nò】 )。完整语法格式
SELECT【涩莱克特】 [表别名1].列名, [表别名2].列名, ...FROM【弗乱】 表1 [AS] 表别名1INNER【ing呐】 JOIN【载(白话)】 表2 [AS] 表别名2 ON【昂】 表别名1.连接列 = 表别名2.连接列[WHERE【威尔】 筛选条件][ORDER【欧朵】 BY 排序字段];示例
1:基本INNER【ing呐】 JOIN【载(白话)】查询
-- 查询员工及其部门信息SELECT【涩莱克特】 e.employee【ing普洛伊】_id, e.name, d.dept_name, e.hire_dateFROM【弗乱】 employees【ing普洛伊s】 eINNER【ing呐】 JOIN【载(白话)】 departments【迪帕踢门特s】 d ON【昂】 e.dept_id = d.dept_id;查询结果:
| employee【ing普洛伊】_id | name | dept_name | hire_date |
|---|---|---|---|
| 1 | 张三 | 技术部 | 2023-01-15 |
| 2 | 李四 | 销售部 | 2023-03-20 |
| 3 | 王五 | 技术部 | 2023-02-10 |
| 4 | 赵六 | 人事部 | 2023-04-05 |
2:带WHERE【威尔】条件的INNER【ing呐】 JOIN【载(白话)】
-- 只查询技术部的员工SELECT【涩莱克特】 e.name, d.dept_name, e.hire_dateFROM【弗乱】 employees【ing普洛伊s】 eINNER【ing呐】 JOIN【载(白话)】 departments【迪帕踢门特s】 d ON【昂】 e.dept_id = d.dept_idWHERE【威尔】 d.dept_name = '技术部';查询结果:
| name | dept_name | hire_date |
|---|---|---|
| 张三 | 技术部 | 2023-01-15 |
| 王五 | 技术部 | 2023-02-10 |
3:多表INNER【ing呐】 JOIN【载(白话)】连接
-- 假设有salary【撒拉瑞】表,三表连接SELECT【涩莱克特】 e.name, d.dept_name, s.basic【贝斯克】_salary【撒拉瑞】FROM【弗乱】 employees【ing普洛伊s】 eINNER【ing呐】 JOIN【载(白话)】 departments【迪帕踢门特s】 d ON【昂】 e.dept_id = d.dept_idINNER【ing呐】 JOIN【载(白话)】 salary【撒拉瑞】 s ON【昂】 e.employee【ing普洛伊】_id = s.employee【ing普洛伊】_id;使用场景分析
| 场景 | 说明 | 示例 |
|---|---|---|
| 主从表关联 | 查询主表记录的详细信息 | 员工表关联部门表查部门信息 |
| 多维度分析 | 结合多个维度的数据进行统计 | 销售数据关联产品表、客户表 |
| 数据验证 | 检查两个表的数据一致性 | 验证订单表和库存表的数据匹配 |
| 报表生成 | 生成包含多个表数据的综合报表 | 员工考勤关联工资计算 |
与其他JOIN【载(白话)】类型的对比
| 特性 | INNER【ing呐】 JOIN | LEFT【列夫特】 JOIN【载(白话)】 | RIGHT【来特】 JOIN【载(白话)】 | FULL【fò】 JOIN【载(白话)】 |
|---|---|---|---|---|
| 返回结果 | 只返回匹配行 | 左表所有行+匹配行 | 右表所有行+匹配行 | 左右表所有行 |
| NULL【nò】处理 | 排除不匹配行 | 右表不匹配显示NULL【nò】 | 左表不匹配显示NULL【nò】 | 不匹配都显示NULL【nò】 |
| 使用频率 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐ | ⭐ |
| 性能 | 通常最优 | 中等 | 中等 | 较差 |
最佳实践指南
- 使用表别名提高可读性
-- 推荐写法SELECT【涩莱克特】 emp.name, dept.dept_nameFROM【弗乱】 employees【ing普洛伊s】 empINNER【ing呐】 JOIN【载(白话)】 departments【迪帕踢门特s】 dept ON【昂】 emp.dept_id = dept.dept_id;
-- 不推荐写法SELECT【涩莱克特】 employees【ing普洛伊s】.name, departments【迪帕踢门特s】.dept_nameFROM【弗乱】 employees【ing普洛伊s】INNER【ing呐】 JOIN【载(白话)】 departments【迪帕踢门特s】 ON【昂】 employees【ing普洛伊s】.dept_id = departments【迪帕踢门特s】.dept_id;- 明确指定列所属表
-- 避免列名歧义SELECT【涩莱克特】 e.employee【ing普洛伊】_id, e.name, d.dept_nameFROM【弗乱】 employees【ing普洛伊s】 eINNER【ing呐】 JOIN【载(白话)】 departments【迪帕踢门特s】 d ON【昂】 e.dept_id = d.dept_id;- 合理使用索引优化性能
-- 确保连接列有索引CREATE INDEX idx_employees【ing普洛伊s】_dept_id ON【昂】 employees【ing普洛伊s】(dept_id);CREATE INDEX idx_departments【迪帕踢门特s】_dept_id ON【昂】 departments【迪帕踢门特s】(dept_id);3.1 等值连接查询
- 查询每个员工所在的部门名
Use moershi;select【涩莱克特】 name, dept_namefrom【弗乱】 employees【ing普洛伊s】 inner【ing呐】 join【载(白话)】 departments【迪帕踢门特s】 on【昂】 employees【ing普洛伊s】.dept_id=departments【迪帕踢门特s】.dept_id;
-- mysql> select name,dept_name-- -> from employees inner join departments on employees.dept_id=departments.dept_id;---- | name | dept_name |-- |-----------|-----------|-- | 梁伟 | 人事部 |-- | 郭岩 | 人事部 |-- | 李玉英 | 人事部 |-- | 张健 | 人事部 |-- | 郑静 | 人事部 |-- | 牛建军 | 人事部 |-- | 刘斌 | 人事部 |-- | 汪云 | 人事部 |2)查询员工编号8 的 员工所在部门的部门名称
select【涩莱克特】 name, dept_name from【弗乱】 employees【ing普洛伊s】 inner【ing呐】 join【载(白话)】 departments【迪帕踢门特s】on【昂】 employees【ing普洛伊s】.dept_id=departments【迪帕踢门特s】.dept_id where【威尔】 employees【ing普洛伊s】.employee【ing普洛伊】_id=8;
-- mysql> select name,dept_name from employees inner join departments on employees.dept_id=departments.dept_id where employees.employee_id=8;-- +--------+-----------+-- | name | dept_name |-- +--------+-----------+-- | 汪云 | 人事部 |-- +--------+-----------+-- 1 row in set (0.01 sec)别名规则
| 字段名 | 是否必须加别名 e. 或 d. | 原因说明 |
|---|---|---|
dept_id | 必须 | 因为 employees 和 departments 两个表都有名为 dept_id 的字段,MySQL 无法自动判断您想用的是哪一个。 |
name | 不需要 | 因为只有 employees 表中有 name 字段,departments 表中没有这个字段,MySQL 可以唯一确定它来自哪里。 |
如果字段名在多个表中同时存在,必须带上别名才可以识别你要查询的字段名是那个表的字段名 如果字段名只在其中一个表存在,这就具有唯一性,sql可以明确识别字段名在那个表,就不需要带上别名
3)查询每个员工所有信息及所在的部门名称
给表名定义别名 ,定义别名后必须使用别名表示表名
select【涩莱克特】 e.* , d.dept_namefrom【弗乱】 employees【ing普洛伊s】 as e inner【ing呐】 join【载(白话)】 departments【迪帕踢门特s】 as d on【昂】 e.dept_id=d.dept_id;
-- mysql> select e.*,d.dept_name from employees as e inner join departments as d on e.dept_id=d.dept_id limit 5;#结果太多,加上"limit 5" 只输出前5行-- +-------------+-----------+------------+------------+-----------------------+--------------+---------+-----------+-- | employee_id | name | hire_date | birth_date | email | phone_number | dept_id | dept_name |-- +-------------+-----------+------------+------------+-----------------------+--------------+---------+-----------+-- | 1 | 梁伟 | 2018-06-21 | 1971-08-19 | liangwei@tedu.cn | 13591491431 | 1 | 人事部 |-- | 2 | 郭岩 | 2010-03-21 | 1974-05-13 | guoyan@tedu.cn | 13845285867 | 1 | 人事部 |-- | 3 | 李玉英 | 2012-01-19 | 1974-01-25 | liyuying@tedu.cn | 15628557234 | 1 | 人事部 |-- | 4 | 张健 | 2008-09-17 | 1972-06-07 | zhangjian@moershi.com | 13835990213 | 1 | 人事部 |-- | 5 | 郑静 | 2018-02-03 | 1997-02-14 | zhengjing@tedu.cn | 14508936730 | 1 | 人事部 |-- +-------------+-----------+------------+------------+-----------------------+--------------+---------+-----------+-- 5 rows in set (0.00 sec)4)查询每个员工姓名、部门编号、部门名称
两个表有同名表头,表头名前必须加表名
select【涩莱克特】 e.dept_id , name , dept_name from【弗乱】 employees【ing普洛伊s】 as e inner【ing呐】 join【载(白话)】 departments【迪帕踢门特s】 as d on【昂】 e.dept_id=d.dept_id;
-- mysql> select e.dept_id,name,dept_name from employees as e inner join departments as d on e.dept_id=d.dept_id limit 5;#结果太多,加上"limit 5" 只输出前5行-- +---------+-----------+-----------+-- | dept_id | name | dept_name |-- +---------+-----------+-----------+-- | 1 | 梁伟 | 人事部 |-- | 1 | 郭岩 | 人事部 |-- | 1 | 李玉英 | 人事部 |-- | 1 | 张健 | 人事部 |-- | 1 | 郑静 | 人事部 |-- +---------+-----------+-----------+-- 5 rows in set (0.00 sec)3.2 对连接后的查询结果,筛选、分组、排序、过滤
1)查询11号员工的名字及2018年每个月总工资
select【涩莱克特】 e.employee【ing普洛伊】_id, name, date, basic【贝斯克】+bonus【波诺斯】 as total【偷ò头ō】from【弗乱】 employees【ing普洛伊s】 as e inner【ing呐】 join【载(白话)】 salary【撒拉瑞】 as son【昂】 e.employee【ing普洛伊】_id=s.employee【ing普洛伊】_idwhere【威尔】 year【耶尔】(date)=2018 and e.employee【ing普洛伊】_id=11;-- mysql>-- mysql> select e.employee_id,name,date,basic+bonus as total-- -> from employees as e inner join salary as s on e.employee_id=s.employee_id-- -> where year(date)=2018 and e.employee_id=11;-- +-------------+-----------+------------+-------+-- | employee_id | name | date | total |-- +-------------+-----------+------------+-------+-- | 11 | 郭兰英 | 2018-01-10 | 18206 |-- | 11 | 郭兰英 | 2018-02-10 | 19206 |-- | 11 | 郭兰英 | 2018-03-10 | 18206 |-- | 11 | 郭兰英 | 2018-04-10 | 19206 |-- | 11 | 郭兰英 | 2018-05-10 | 18206 |-- | 11 | 郭兰英 | 2018-06-10 | 19206 |-- | 11 | 郭兰英 | 2018-07-10 | 27206 |-- | 11 | 郭兰英 | 2018-08-10 | 27206 |-- | 11 | 郭兰英 | 2018-09-10 | 19206 |-- | 11 | 郭兰英 | 2018-10-10 | 21206 |-- | 11 | 郭兰英 | 2018-11-10 | 22206 |-- | 11 | 郭兰英 | 2018-12-10 | 25016 |-- +-------------+-----------+------------+-------+-- 12 rows in set (0.00 sec)-- mysql>2) 查询每个员工2018年的总工资
#没分组前select【涩莱克特】 employees【ing普洛伊s】.employee【ing普洛伊】_id,date,basic【贝斯克】,bonus【波诺斯】 from【弗乱】 employees【ing普洛伊s】 inner【ing呐】 join【载(白话)】 salary【撒拉瑞】on【昂】 employees【ing普洛伊s】.employee【ing普洛伊】_id=salary【撒拉瑞】【撒拉瑞】.employee【ing普洛伊】_id where【威尔】 year【耶尔】(date)=2018;-- mysql> select employees.employee_id,date,basic,bonus-- -> from employees inner join salary-- -> on employees.employee_id=salary.employee_id-- -> where year(date)=2018;-- +-------------+------------+-------+-------+-- | employee_id | date | basic | bonus |-- +-------------+------------+-------+-------+-- | 1 | 2018-07-10 | 16206 | 11000 |-- | 1 | 2018-08-10 | 16206 | 8000 |-- | 1 | 2018-09-10 | 16206 | 8000 |-- | 1 | 2018-10-10 | 16206 | 11000 |-- | 1 | 2018-11-10 | 16206 | 8000 |-- ...............-- mysql> # 分组后select【涩莱克特】 employees【ing普洛伊s】.employee【ing普洛伊】_id, sum【桑à姆】(basic【贝斯克】+bonus【波诺斯】) from【弗乱】 employees【ing普洛伊s】 inner【ing呐】 join【载(白话)】 salary【撒拉瑞】on【昂】 employees【ing普洛伊s】.employee【ing普洛伊】_id=salary【撒拉瑞】.employee【ing普洛伊】_idwhere【威尔】 year【耶尔】(date)=2018 group【格鲁普】 by employees【ing普洛伊s】.employee【ing普洛伊】_id;
-- mysql>-- mysql> select employees.employee_id,sum(basic+bonus)-- -> from employees inner join salary-- -> on employees.employee_id=salary.employee_id-- -> where year(date)=2018 --过滤只输出2018年的数据-- -> group by employees.employee_id; --查询结果以employees.employee_id分组-- +-------------+------------------+-- | employee_id | sum(basic+bonus) |-- +-------------+------------------+-- | 1 | 151046 |-- | 2 | 328131 |-- | 3 | 177595 |-- | 4 | 262282 |-- | 5 | 248076 |-- | 6 | 257282 |-- | 7 | 314027 |-- ...............-- mysql>3)查询每个员工2018年的总工资,按总工资升序排列
select【涩莱克特】 employees【ing普洛伊s】.employee【ing普洛伊】_id, sum【桑à姆】(basic【贝斯克】+bonus【波诺斯】) as total【偷ò头ō】 from【弗乱】 employees【ing普洛伊s】 inner【ing呐】 join【载(白话)】 salary【撒拉瑞】 on【昂】 employees【ing普洛伊s】.employee【ing普洛伊】_id=salary【撒拉瑞】.employee【ing普洛伊】_id where【威尔】 year【耶尔】(salary【撒拉瑞】.date)=2018 group【格鲁普】 by employee【ing普洛伊】_id order【欧朵】 by total【偷ò头ō】 asc【阿斯克】;
-- mysql>-- mysql> select employees.employee_id,sum(basic+bonus) as total-- -> from employees inner join salary on employees.employee_id=salary.employee_id-- -> where year(salary.date)=2018 --过滤只输出2018年的数据-- -> group by employee_id --查询结果以employee_id分组-- -> order by total asc; --查询结果以升序排序-- +-------------+--------+-- | employee_id | total |-- +-------------+--------+-- | 8 | 25093 |-- | 10 | 116389 |-- | 16 | 119389 |-- | 51 | 123733 |-- | 18 | 126687 |-- .........4)查询2018年总工资大于30万的员工,按2018年总工资降序排列
select【涩莱克特】 employees【ing普洛伊s】.employee【ing普洛伊】_id, sum【桑à姆】(basic【贝斯克】+bonus【波诺斯】) as total【偷ò头ō】from【弗乱】 employees【ing普洛伊s】 inner【ing呐】 join【载(白话)】 salary【撒拉瑞】 on【昂】 employees【ing普洛伊s】.employee【ing普洛伊】_id=salary【撒拉瑞】.employee【ing普洛伊】_idwhere【威尔】 year【耶尔】(salary【撒拉瑞】.date)=2018group【格鲁普】 by employees【ing普洛伊s】.employee【ing普洛伊】_idhaving【嗨夫营】 total【偷ò头ō】 > 300000order【欧朵】 by total【偷ò头ō】 desc;-- mysql>-- mysql> select employees.employee_id,sum(basic+bonus) as total-- -> from employees inner join salary on employees.employee_id=salary.employee_id-- -> where year(salary.date)=2018-- -> group by employees.employee_id-- -> having total > 300000-- -> order by total desc;-- +-------------+--------+-- | employee_id | total |-- +-------------+--------+-- | 117 | 374923 |-- | 31 | 374923 |-- | 37 | 362981 |-- | 68 | 360923 |-- | 48 | 359923 |-- ......四、外连接查询
当前任何环节
flowchart LR subgraph BottomRow[综合查询] direction LR A[内连接查询] --> B[外连接查询] --> C[合并查询结果] --> D[嵌套查询] end classDef highlight stroke:#f00,stroke-width:2px; class B highlight;MySQL 外连接查询是一种在多个表间获取数据的重要方式,它主要分为左外连接、右外连接和全外连接。
外连接类型对比
| 连接类型 | 关键字 | 返回结果 | 适用场景 |
|---|---|---|---|
| 左外连接 | LEFT【列夫特】 JOIN【载(白话)】 或 LEFT【列夫特】 OUTER【奥特尔】 JOIN【载(白话)】 | 左表所有记录 + 右表匹配记录 | 主表记录必须全部保留,关联表信息可选 |
| 右外连接 | RIGHT【来特】 JOIN【载(白话)】 或 RIGHT【来特】 OUTER【奥特尔】 JOIN【载(白话)】 | 右表所有记录 + 左表匹配记录 | 从表记录必须全部保留,主表信息可选 |
| 全外连接 | FULL【fò】 JOIN【载(白话)】 或 FULL【fò】 OUTER【奥特尔】 JOIN【载(白话)】 | 左右表所有记录 | 需要两个表的完整数据合并 |
外连接是SQL查询中非常重要的功能,特别适用于:
- 需要保留主表所有记录的查询
- 数据完整性检查(查找缺失的关联数据)
- 生成完整的报表和统计分析
- 处理可能存在NULL【nò】关联关系的业务场景
左外连接会返回左表中的所有记录,以及右表中匹配的记录,若右表无匹配项,对应字段会显示为 NULL【nò】。右外连接则相反,返回右表所有记录与左表匹配记录。全外连接会返回左右表的所有记录,无匹配项的字段同样显示为 NULL【nò】。
例如员工表和部门表,用左外连接查询时,即便有员工未分配部门,该员工信息也会显示出来。外连接能满足在关联表查询时,不遗漏某表记录的需求。
4.1 左连接查询
向departments【迪帕踢门特s】表里添加3个部门:小卖部 行政部 公关部
mysql> insert【因涩特】 into【因兔】 departments【迪帕踢门特s】(dept_name) values【挖柳斯】("小卖部"),("行政部"),("公关部");Query OK, 3 rows affected (0.06 sec)Records: 3 Duplicates: 0 Warnings: 0查询部门信息
mysql> select【涩莱克特】 * from【弗乱】 moershi.departments【迪帕踢门特s】;+---------+-----------+| dept_id | dept_name |+---------+-----------+| 1 | 人事部 || 2 | 财务部 || 3 | 运维部 || 4 | 开发部 || 5 | 测试部 || 6 | 市场部 || 7 | 销售部 || 8 | 法务部 || 9 | 小卖部 || 10 | 行政部 || 11 | 公关部 |+---------+-----------+11 rows in set (0.00 sec)mysql>左连接查询例子:输出没有员工的部门名
mysql> select【涩莱克特】 d.dept_name,e.name from【弗乱】 departments【迪帕踢门特s】 as d left【列夫特】 join【载(白话)】 employees【ing普洛伊s】 as e on【昂】 d.dept_id=e.dept_id;......| 法务部 | 王荣 || 法务部 | 刘倩 || 法务部 | 杨金凤 || 小卖部 | NULL || 行政部 | NULL || 公关部 | NULL |+-----------+-----------+136 rows in set (0.00 sec)连接后 输出与筛选条件匹配的行
select【涩莱克特】 d.dept_name,e.name from【弗乱】 departments【迪帕踢门特s】 as d left【列夫特】 join【载(白话)】 employees【ing普洛伊s】 as e on【昂】 d.dept_id=e.dept_id where【威尔】 e.name is null【nò】;+-----------+------+| dept_name | name |+-----------+------+| 小卖部 | NULL || 行政部 | NULL || 公关部 | NULL |+-----------+------+3 rows in set (0.01 sec)mysql>仅显示departments【迪帕踢门特s】表中dept_name表头
select【涩莱克特】 d.dept_name from【弗乱】 departments【迪帕踢门特s】 as d left【列夫特】 join【载(白话)】 employees【ing普洛伊s】 as e on【昂】 d.dept_id=e.dept_id where【威尔】 e.name is null【nò】;+-----------+| dept_name |+-----------+| 小卖部 || 行政部 || 公关部 |+-----------+3 rows in set (0.01 sec)mysql>4.2 右连接查询
向employees【ing普洛伊s】表中添加3个员工 只给name表头赋值
insert【因涩特】 into【因兔】 employees【ing普洛伊s】(name) values【挖柳斯】("bob"),("tom"),("lily");Query OK, 3 rows affected (0.05 sec)Records: 3 Duplicates: 0 Warnings: 0右连接查询例子:显示没有部门的员工名
//右连接查询select【涩莱克特】 e.name ,d.dept_name from【弗乱】 departments【迪帕踢门特s】 as d right【来特】 join【载(白话)】 employees【ing普洛伊s】 as e on【昂】 d.dept_id=e.dept_id;//加筛选条件select【涩莱克特】 e.name ,d.dept_name from【弗乱】 departments【迪帕踢门特s】 as d right【来特】 join【载(白话)】 employees【ing普洛伊s】 as e on【昂】 d.dept_id=e.dept_id where【威尔】 d.dept_name is null【nò】 ;+------+-----------+| name | dept_name |+------+-----------+| bob | NULL || tom | NULL || lily | NULL |+------+-----------+3 rows in set (0.00 sec)mysql>//仅显示员工名select【涩莱克特】 e.name from【弗乱】 departments【迪帕踢门特s】 as d right【来特】 join【载(白话)】 employees【ing普洛伊s】 as e on【昂】 d.dept_id=e.dept_id where【威尔】 d.dept_name is null【nò】 ;+------+| name |+------+| bob || tom || lily |+------+五、合并查询结果
当前任务环节
flowchart LR subgraph BottomRow[综合查询] direction LR A[内连接查询] --> B[外连接查询] --> C[合并查询结果] --> D[嵌套查询] end classDef highlight stroke:#f00,stroke-width:2px; class C highlight;在 MySQL 综合查询里,合并查询是一种实用的操作。它主要用于将多个查询结果合并成一个结果集,使用的关键字是 UNION【U凝】 和 UNION【U凝】 ALL【ò】。
UNION【U凝】 会去除合并结果里的重复记录,只保留一条。比如,你分别从员工表查询出薪资大于 8000 的员工,和从另一筛选条件查出的员工,用 UNION【U凝】 合并后,相同员工就只显示一次。而 UNION【U凝】 ALL【ò】 不会去重,会把所有查询结果直接合并。当你需要查看所有相关数据,不在意重复时,就用 UNION【U凝】 ALL【ò】。合并查询让你能灵活整合不同查询的数据。
基本概念对比
| 特性 | UNION【U凝】 | UNION【U凝】 ALL【ò】 |
|---|---|---|
| 去重处理 | 自动去除重复行 | 保留所有行,包括重复行 |
| 性能 | 较慢(需要排序和去重) | 较快(直接合并) |
| 结果排序 | 默认按第一列升序排列 | 不保证顺序 |
| 语法 | SELECT【涩莱克特】 ... UNION【U凝】 SELECT【涩莱克特】 ... | SELECT【涩莱克特】 ... UNION【U凝】 ALL【ò】 SELECT【涩莱克特】 ... |
| 使用场景 | 需要唯一结果时 | 需要完整数据或已知无重复时 |
| ---------- | --------------- | ------------------- |
| 去重能力 | ✅ 自动去重 | ❌ 保留重复 |
| 执行性能 | ⭐⭐ 较慢 | ⭐⭐⭐⭐ 较快 |
| 内存消耗 | 较高 | 较低 |
| 结果顺序 | 默认排序 | 不保证顺序 |
| 使用频率 | ⭐⭐⭐ 常用 | ⭐⭐⭐⭐⭐ 更常用 |
| 适用场景 | 需要唯一结果 | 完整数据或性能优先 |
关键要点总结
- UNION【U凝】 ALL【ò】 通常比 UNION【U凝】 性能更好,因为它不需要去重操作
- 只有需要去除重复记录时才使用 UNION【U凝】
- 确保所有SELECT【涩莱克特】语句的列数、数据类型和顺序一致
- UNION【U凝】 ALL【ò】 保留所有记录,包括重复项
- 在合并大量数据时,UNION【U凝】 ALL【ò】 是更优选择
基本语法格式
UNION【U凝】 语法
SELECT【涩莱克特】 列名1, 列名2, ...FROM【弗乱】 表1WHERE【威尔】 条件UNION【U凝】SELECT【涩莱克特】 列名1, 列名2, ...FROM【弗乱】 表2WHERE【威尔】 条件;UNION 【U凝】ALL【ò】 语法
SELECT【涩莱克特】 列名1, 列名2, ...FROM【弗乱】 表1WHERE【威尔】 条件UNION【U凝】 ALL【ò】SELECT【涩莱克特】 列名1, 列名2, ...FROM【弗乱】 表2WHERE【威尔】 条件;性能对比分析
| 操作步骤 | UNION【U凝】 | UNION【U凝】 ALL【ò】 |
|---|---|---|
| 数据读取 | 读取所有数据 | 读取所有数据 |
| 排序处理 | 对结果进行排序 | 不需要排序 |
| 去重操作 | 比较并去除重复行 | 保留所有行 |
| 内存使用 | 较高 | 较低 |
| 执行时间 | 较长 | 较短 |
实际示例演示
输出2018年基本工资的最大值和最小值
mysql> ( select【涩莱克特】 basic【贝斯克】 from【弗乱】 salary【撒拉瑞】 where【威尔】 year【耶尔】(date)=2018 order【欧朵】 by basic【贝斯克】 desc limit 1) union【U凝】 (select【涩莱克特】 basic【贝斯克】 from【弗乱】 salary【撒拉瑞】 where【威尔】 year【耶尔】(date)=2018 order【欧朵】 by basic【贝斯克】 asc【阿斯克】 limit【肋梅特】 1 );-- mysql> (select basic from salary where year(date)=2018 order by basic desc limit 1)-- -> union-- -> (select basic from salary where year(date)=2018 order by basic asc limit 1);-- +----------------+-- | basic【贝斯克】 |-- +----------------+-- | 25524 |-- | 5787 |-- +----------------+-- 2 rows in set (0.01 sec)输出2018年1月10号 基本工资的最大值和最小值
mysql> (select【涩莱克特】 date , max【mà 斯】(basic【贝斯克】) as 工资 from【弗乱】 salary【撒拉瑞】 where【威尔】 date=20180110) union【U凝】(select【涩莱克特】 date,min【敏ì】(basic【贝斯克】) from【弗乱】 salary【撒拉瑞】 where【威尔】 date=20180110);
-- mysql> (select date,max(basic) as 工资 from salary where date=20180110)-- -> union-- -> (select date,min(basic) from salary where date=20180110);-- +------------+--------+-- | date | 工资 |-- +------------+--------+-- | 2018-01-10 | 24309 |-- | 2018-01-10 | 5787 |-- +------------+--------+-- 2 rows in set (0.01 sec)union【U凝】 去掉查询结果中重复的行
mysql> (select【涩莱克特】 employee【ing普洛伊】_id , name , birth【波尔斯】_date from【弗乱】 employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 5) union【U凝】 (select【涩莱克特】 employee【ing普洛伊】_id , name , birth【波尔斯】_date from【弗乱】 employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 6);-- mysql> (select employee_id,name,birth_date from employees where employee_id <=5)-- -> union-- -> (select employee_id,name,birth_date from employees where employee_id <=6);+-------------------------+-----------+------------+| employee【ing普洛伊】_id | name | birth_date |+-------------------------+-----------+------------+| 1 | 梁伟 | 1971-08-19 || 2 | 郭岩 | 1974-05-13 || 3 | 李玉英 | 1974-01-25 || 4 | 张健 | 1972-06-07 || 5 | 郑静 | 1997-02-14 || 6 | 牛建军 | 1985-03-19 |+------------------------+-----------+------------+第二个查询只输出了与条件匹配的最后1行
mysql> (select【涩莱克特】 employee【ing普洛伊】_id , name , birth【波尔斯】_date from【弗乱】 employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 5) union【U凝】 (select【涩莱克特】 employee【ing普洛伊】_id , name , birth【波尔斯】_date from【弗乱】 employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 6);-- mysql> (select employee_id,name,birth_date from employees where employee_id <=5)-- -> union-- -> (select employee_id,name,birth_date from employees where employee_id <=6);+------------------------+-----------+-------------+| employee【ing普洛伊】_id | name | birth【波尔斯】_date |+------------------------+-----------+-------------+| 1 | 梁伟 | 1971-08-19 || 2 | 郭岩 | 1974-05-13 || 3 | 李玉英 | 1974-01-25 || 4 | 张健 | 1972-06-07 || 5 | 郑静 | 1997-02-14 || 6 | 牛建军 | 1985-03-19 |+------------------------+-----------+-------------+6 rows in set (0.00 sec)union【U凝】 all 不去重显示查询结果
mysql> (select【涩莱克特】 employee【ing普洛伊】_id , name , birth【波尔斯】_date from【弗乱】 employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 5) union【U凝】 all【ò】 (select【涩莱克特】 employee【ing普洛伊】_id , name , birth【波尔斯】_date from【弗乱】 employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 6);-- mysql> (select employee_id,name,birth_date from employees where employee_id <=5)-- -> union all-- -> (select employee_id,name,birth_date from employees where employee_id <=6);+-------------+-----------+------------+| employee_id | name | birth_date |+-------------+-----------+------------+| 1 | 梁伟 | 1971-08-19 || 2 | 郭岩 | 1974-05-13 || 3 | 李玉英 | 1974-01-25 || 4 | 张健 | 1972-06-07 || 5 | 郑静 | 1997-02-14 || 1 | 梁伟 | 1971-08-19 || 2 | 郭岩 | 1974-05-13 || 3 | 李玉英 | 1974-01-25 || 4 | 张健 | 1972-06-07 || 5 | 郑静 | 1997-02-14 || 6 | 牛建军 | 1985-03-19 |+-------------+-----------+------------+11 rows in set (0.00 sec)六、嵌套查询
当前任务环节
flowchart LR subgraph BottomRow[综合查询] direction LR A[内连接查询] --> B[外连接查询] --> C[合并查询结果] --> D[嵌套查询] end classDef highlight stroke:#f00,stroke-width:2px; class D highlight;嵌套查询:是指在一个完整的查询语句之中,包含若干个不同功能的小查询;从而一起完成复杂查询的一种编写形式。包含的查询放在()里 , 包含的查询出现的位置:
- SELECT【涩莱克特】之后
- FROM【弗乱】之后
- WHERE【威尔】
- HAVING【嗨夫营】之后
嵌套查询的作用
1. 数据筛选与过滤
- 在主查询中使用子查询的结果作为筛选条件
- 实现复杂的多条件数据过滤
2. 数据比较与计算
- 将子查询结果与主查询数据进行对比
- 计算相对值、百分比等复杂指标
3. 数据存在性检查
- 检查某条记录是否存在于另一个表中
- 验证数据的完整性
4. 数据聚合与统计
- 在子查询中进行分组统计
- 将统计结果用于主查询的条件判断
嵌套查询的优势
- 逻辑清晰:将复杂问题分解为多个简单步骤
- 灵活性高:可以处理各种复杂的数据关系
- 可读性强:SQL语句结构清晰,易于理解
- 功能强大:支持多层嵌套,解决复杂业务逻辑
注意事项
- 性能考虑:多层嵌套可能影响查询性能
- 可维护性:过度嵌套会使SQL难以维护
- 替代方案:考虑使用JOIN或CTE(公共表表达式)作为替代方案
6.1 where【威尔】之后嵌套查询
1)查询运维部所有员工信息
#先把 运维部的id 找到mysql> select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name="运维部";-- mysql> select dept_id from departments where dept_name="运维部";+---------+| dept_id |+---------+| 3 |+---------+1 row in set (0.00 sec)#员工表里没有部门名称 但有部门编号 (和部门表的编号是一致的)mysql> select【涩莱克特】 * from【弗乱】 employees【ing普洛伊s】 where【威尔】 dept_id = (select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name="运维部");-- mysql> select * from employees where dept_id=(select dept_id from departments where dept_name="运维部");+-------------+-----------+------------+---------------------+--------------------+--------------+---------+| employee_id | name | hire_date | birth【波尔斯】_date | email | phone_number | dept_id |+-------------+-----------+------------+---------------------+--------------------+--------------+---------+| 14 | 廖娜 | 2012-05-20 | 1982-06-22 | liaona@moershi.com | 15827928192 | 3 || 15 | 窦红梅 | 2018-03-16 | 1971-09-09 | douhongmei@qcjy.cn | 15004739483 | 3 || 16 | 聂想 | 2018-09-09 | 1999-06-05 | niexiang@qcjy.cn | 15501892446 | 3 || 17 | 陈阳 | 2004-09-16 | 1991-04-10 | chenyang@qcjy.cn | 15565662056 | 3 || 18 | 戴璐 | 2001-11-30 | 1975-05-16 | dailu@qcjy.cn | 13465236095 | 3 || 19 | 陈斌 | 2019-07-04 | 2000-01-22 | chenbin@moershi.com | 13621656037 | 3 |+-------------+-----------+------------+---------------------+--------------------+--------------+---------+6 rows in set (0.00 sec)2)查询人事部2018年12月所有员工工资
//查看人事部的部门idmysql> select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name='人事部';-- mysql> select dept_id from departments where dept_name='人事部';+---------+| dept_id |+---------+| 1 |+---------+1 row in set (0.00 sec)//查找employees【ing普洛伊s】表里 人事部的员工idselect【涩莱克特】 employee【ing普洛伊】_id from【弗乱】 employees【ing普洛伊s】 where【威尔】 dept_id=(select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name='人事部');-- mysql> select employee_id from employees where dept_id=(select dept_id from departments where dept_name='人事部');+-------------+| employee_id |+-------------+| 1 || 2 || 3 || 4 || 5 || 6 || 7 || 8 |+-------------+8 rows in set (0.00 sec)//查询人事部2018年12月所有员工工资select【涩莱克特】 * from【弗乱】 salary【撒拉瑞】 where【威尔】 year【耶尔】(date)=2018 and month【mèn斯】(date)=12and employee【ing普洛伊】_id in (select【涩莱克特】 employee【ing普洛伊】_id from【弗乱】 employees【ing普洛伊s】where【威尔】 dept_id=(select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name='人事部') );-- mysql> select * from salary where year(date)=2018 and month(date)=12-- -> and employee_id in (select employee_id from employees-- -> where dept_id=(select dept_id from departments where dept_name='人事部'));+------+------------+-------------+----------------+----------------+| id | date | employee_id | basic【贝斯克】 | bonus【波诺斯】 |+------+------------+-------------+----------------+----------------+| 6252 | 2018-12-10 | 1 | 17016 | 7000 || 6253 | 2018-12-10 | 2 | 20662 | 9000 || 6254 | 2018-12-10 | 3 | 9724 | 8000 || 6255 | 2018-12-10 | 4 | 17016 | 2000 || 6256 | 2018-12-10 | 5 | 17016 | 3000 || 6257 | 2018-12-10 | 6 | 17016 | 1000 || 6258 | 2018-12-10 | 7 | 23093 | 4000 || 6259 | 2018-12-10 | 8 | 23093 | 2000 |+------+------------+-------------+----------------+----------------+8 rows in set (0.00 sec)3)查询人事部和财务部员工信息
//查看人事部和财务部的 部门idselect【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name in ('人事部', '财务部');-- mysql> select dept_id from departments where dept_name in ('人事部','财务部');+---------+| dept_id |+---------+| 1 || 2 |+---------+2 rows in set (0.00 sec)
//查询人事部和财务部员工信息select【涩莱克特】 dept_id , name from【弗乱】 employees【ing普洛伊s】where【威尔】 dept_id in (select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name in ('人事部', '财务部'));-- mysql> select dept_id,name from employees-- -> where dept_id in (-- -> select dept_id from departments where dept_name in ('人事部','财务部'));+---------+-----------+| dept_id | name |+---------+-----------+| 1 | 梁伟 || 1 | 郭岩 || 1 | 李玉英 || 1 | 张健 || 1 | 郑静 || 1 | 牛建军 || 1 | 刘斌 || 1 | 汪云 || 2 | 张建平 || 2 | 郭娟 || 2 | 郭兰英 || 2 | 王英 || 2 | 王楠 |+---------+-----------+13 rows in set (0.00 sec)4)查询2018年12月所有比100号员工基本工资高的工资信息
//把100号员工的基本工资查出来select【涩莱克特】 basic【贝斯克】 from【弗乱】 salary【撒拉瑞】 where【威尔】 year【耶尔】(date)=2018 andmonth【mèn斯】(date)=12 and employee【ing普洛伊】_id=100;-- mysql> select basic from salary where year(date)=2018 and-- -> month(date)=12 and employee_id=100;+----------------+| basic【贝斯克】 |+----------------+| 14585 |+----------------+1 row in set (0.00 sec)
//查看比100号员工工资高的工资信息select【涩莱克特】 * from【弗乱】 salary【撒拉瑞】where【威尔】 year【耶尔】(date)=2018 and month【mèn斯】(date)=12 andbasic【贝斯克】>(select【涩莱克特】 basic【贝斯克】 from【弗乱】 salary【撒拉瑞】 where【威尔】 year【耶尔】(date)=2018 andmonth【mèn斯】(date)=12 and employee【ing普洛伊】_id=100);-- mysql> select * from salary-- -> where year(date)=2018 and month(date)=12 and-- -> basic > (select basic from salary where year(date)=2018 and-- -> month(date)=12 and employee_id=100);+------+------------+-------------+----------------+----------------+| id | date | employee_id | basic【贝斯克】 | bonus【波诺斯】 |+------+------------+-------------+----------------+----------------+| 6252 | 2018-12-10 | 1 | 17016 | 7000 || 6253 | 2018-12-10 | 2 | 20662 | 9000 || 6255 | 2018-12-10 | 4 | 17016 | 2000 || 6256 | 2018-12-10 | 5 | 17016 | 3000 || 6257 | 2018-12-10 | 6 | 17016 | 1000 || 6258 | 2018-12-10 | 7 | 23093 | 4000 || 6259 | 2018-12-10 | 8 | 23093 | 2000 || 6261 | 2018-12-10 | 10 | 21878 | 8000 || 6262 | 2018-12-10 | 11 | 17016 | 8000 || 6263 | 2018-12-10 | 12 | 15800 | 4000 || 6264 | 2018-12-10 | 13 | 18231 | 3000 || 6267 | 2018-12-10 | 16 | 21878 | 8000 || 6268 | 2018-12-10 | 17 | 19448 | 7000 || 6271 | 2018-12-10 | 20 | 19448 | 3000 || 6272 | 2018-12-10 | 21 | 18231 | 11000 || 6276 | 2018-12-10 | 25 | 23093 | 3000 || 6278 | 2018-12-10 | 27 | 24309 | 5000 || 6279 | 2018-12-10 | 28 | 17016 | 9000 || 6280 | 2018-12-10 | 29 | 23093 | 1000 || 6282 | 2018-12-10 | 31 | 25524 | 9000 || 6283 | 2018-12-10 | 32 | 18231 | 11000 || 6284 | 2018-12-10 | 33 | 23093 | 6000 || 6285 | 2018-12-10 | 34 | 23093 | 1000 || 6288 | 2018-12-10 | 37 | 24309 | 4000 || 6289 | 2018-12-10 | 38 | 23093 | 3000 || 6291 | 2018-12-10 | 40 | 20662 | 2000 || 6297 | 2018-12-10 | 46 | 15800 | 7000 || 6299 | 2018-12-10 | 48 | 25524 | 1000 || 6300 | 2018-12-10 | 49 | 15800 | 9000 || 6303 | 2018-12-10 | 52 | 19448 | 9000 || 6304 | 2018-12-10 | 53 | 25524 | 8000 || 6305 | 2018-12-10 | 54 | 21878 | 9000 || 6307 | 2018-12-10 | 56 | 23093 | 3000 || 6308 | 2018-12-10 | 57 | 23093 | 3000 || 6312 | 2018-12-10 | 61 | 24309 | 3000 || 6313 | 2018-12-10 | 62 | 15800 | 4000 || 6314 | 2018-12-10 | 63 | 15800 | 8000 || 6317 | 2018-12-10 | 66 | 19448 | 7000 || 6319 | 2018-12-10 | 68 | 25524 | 9000 || 6324 | 2018-12-10 | 73 | 17016 | 10000 || 6327 | 2018-12-10 | 76 | 20662 | 11000 || 6330 | 2018-12-10 | 79 | 15800 | 4000 || 6332 | 2018-12-10 | 81 | 17016 | 3000 || 6336 | 2018-12-10 | 85 | 15800 | 1000 || 6337 | 2018-12-10 | 86 | 24309 | 4000 || 6339 | 2018-12-10 | 88 | 20662 | 2000 || 6342 | 2018-12-10 | 91 | 20662 | 11000 || 6343 | 2018-12-10 | 92 | 19448 | 2000 || 6346 | 2018-12-10 | 95 | 19448 | 8000 || 6349 | 2018-12-10 | 98 | 19448 | 9000 || 6350 | 2018-12-10 | 99 | 15800 | 5000 || 6353 | 2018-12-10 | 102 | 23093 | 3000 || 6356 | 2018-12-10 | 105 | 21878 | 8000 || 6357 | 2018-12-10 | 106 | 23093 | 5000 || 6358 | 2018-12-10 | 107 | 18231 | 7000 || 6359 | 2018-12-10 | 108 | 18231 | 2000 || 6361 | 2018-12-10 | 110 | 18231 | 2000 || 6363 | 2018-12-10 | 112 | 24309 | 9000 || 6368 | 2018-12-10 | 117 | 25524 | 11000 || 6369 | 2018-12-10 | 118 | 23093 | 3000 || 6370 | 2018-12-10 | 119 | 23093 | 10000 || 6373 | 2018-12-10 | 122 | 21878 | 2000 || 6374 | 2018-12-10 | 123 | 19448 | 10000 || 6376 | 2018-12-10 | 125 | 17016 | 5000 || 6378 | 2018-12-10 | 127 | 17016 | 6000 |+------+------------+-------------+----------------+----------------+65 rows in set (0.01 sec)6.2 having【嗨夫营】之后嵌套查询
查询部门员工总人数比开发部总人数少 的 部门名称和人数
//统计开发部员工总人数select【涩莱克特】 count【kàn特】(name) from【弗乱】 employees【ing普洛伊s】 where【威尔】 dept_id = (select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name="开发部");-- mysql> select count(name) from employees where dept_id=-- -> (select dept_id from departments where dept_name="开发部");+---------------------+| count【kàn特】(name) |+---------------------+| 55 |+---------------------+1 row in set (0.00 sec)
//统计每个部门总人数select【涩莱克特】 dept_id , count【kàn特】(name) from【弗乱】 employees【ing普洛伊s】 group【格鲁普】 by dept_id;-- mysql> select dept_id,count(name) from employees group by dept_id;+---------+---------------------+| dept_id | count【kàn特】(name) |+---------+---------------------+| 1 | 8 || 2 | 5 || 3 | 6 || 4 | 55 || 5 | 12 || 6 | 9 || 7 | 35 || 8 | 3 |+---------+---------------------+8 rows in set (0.00 sec)
//输出总人数比开发部总人数少的部门名及总人数select【涩莱克特】 dept_id , count【kàn特】(name) as total【偷ò头ō】 from【弗乱】 employees【ing普洛伊s】 group【格鲁普】 by dept_idhaving【嗨夫营】 total【偷ò头ō】 < (select【涩莱克特】 count【kàn特】(name) from【弗乱】 employees【ing普洛伊s】 where【威尔】 dept_id=(select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name='开发部'));-- mysql> select dept_id,count(name) as total from employees group by dept_id-- -> having total < (select count(name) from employees where dept_id= (select-- -> dept_id from departments where dept_name='开发部'));+---------+----------------+| dept_id | total【偷ò头ō】 |+---------+----------------+| 1 | 8 || 2 | 5 || 3 | 6 || 5 | 12 || 6 | 9 || 7 | 35 || 8 | 3 |+---------+----------------+7 rows in set (0.00 sec)6.3 from【弗乱】之后嵌套查询
查询3号部门 、部门名称 及其部门内 员工的编号、名字 和 email
select【涩莱克特】 dept_id, dept_name, employee【ing普洛伊】_id, name, email from【弗乱】 (select【涩莱克特】 d.dept_name, e.* from【弗乱】 departments【迪帕踢门特s】 as d inner【ing呐】 join【载(白话)】 employees【ing普洛伊s】 as eon【昂】 d.dept_id=e.dept_id ) as tmp_table【忒-部】 where【威尔】 dept_id=3;-- mysql> select dept_id,dept_name,employee_id,name,email from-- -> (select d.dept_name,e.* from departments as d inner join employees as e-- -> on d.dept_id=e.dept_id) as tmp_toble where dept_id=3;+---------+-----------+-------------+-----------+--------------------+| dept_id | dept_name | employee_id | name | email |+---------+-----------+-------------+-----------+--------------------+| 3 | 运维部 | 14 | 廖娜 | liaona@moershi.com || 3 | 运维部 | 15 | 窦红梅 | douhongmei@qcjy.cn || 3 | 运维部 | 16 | 聂想 | niexiang@qcjy.cn || 3 | 运维部 | 17 | 陈阳 | chenyang@qcjy.cn || 3 | 运维部 | 18 | 戴璐 | dailu@qcjy.cn || 3 | 运维部 | 19 | 陈斌 | chenbin@moershi.com |+---------+-----------+-------------+-----------+--------------------+6 rows in set (0.00 sec)6.4 select【涩莱克特】之后嵌套查询
查询每个部门的人数: dept_id dept_name 部门人数
//显示部门表中的所有列表select【涩莱克特】 d.* from【弗乱】 departments【迪帕踢门特s】 as d;-- mysql> select d.* from departments as d;+---------+-----------+| dept_id | dept_name |+---------+-----------+| 1 | 人事部 || 2 | 财务部 || 3 | 运维部 || 4 | 开发部 || 5 | 测试部 || 6 | 市场部 || 7 | 销售部 || 8 | 法务部 |+---------+-----------+8 rows in set (0.00 sec)
//查询每个部门的人数select【涩莱克特】 d.* , ( select【涩莱克特】 count【kàn特】(name) from【弗乱】 employees【ing普洛伊s】 as e where【威尔】 d.dept_id=e.dept_id) as 部门人数 from【弗乱】 departments【迪帕踢门特s】 as d;-- mysql> select d.*,(select count(name) from employees as e where d.dept_id=e.dept_id) as 部门人数-- -> from departments as d;+---------+-----------+--------------+| dept_id | dept_name | 部门人数 |+---------+-----------+--------------+| 1 | 人事部 | 8 || 2 | 财务部 | 5 || 3 | 运维部 | 6 || 4 | 开发部 | 55 || 5 | 测试部 | 12 || 6 | 市场部 | 9 || 7 | 销售部 | 35 || 8 | 法务部 | 3 |+---------+-----------+--------------+8 rows in set (0.00 sec)七、作业
1 选择题
- 在内连接查询中,使用以下哪种关键字进行连接操作?C A. LEFT JOIN B. RIGHT JOIN C. INNER JOIN D. FULL JOIN
- 外连接查询中,左外连接会返回以下哪些数据?A A. 左表的所有记录和右表匹配的记录 B. 右表的所有记录和左表匹配的记录 C. 左右表的所有记录 D. 只返回左右表匹配的记录
- 合并查询中,
UNION ALL和UNION的区别是? B A.UNION ALL会去除重复记录,UNION不会 B.UNION会去除重复记录,UNION ALL不会 C. 两者都去除重复记录 D. 两者都不去除重复记录 - 嵌套查询是指?B A. 在一个查询语句中嵌套多个表 B. 在一个查询语句中嵌套另一个查询语句 C. 同时进行多个查询操作 D. 以上都不对
2 简答题
-
简述内连接查询和外连接查询的区别。 答: 内连接是:只保留匹配的记录(交集) 外链接是:保留至少一个表的所有记录,不匹配的用NULL填充 应用场景区别:内连接用于需要精确匹配的场景,外连接用于需要保留所有记录的统计分析
-
什么时候使用
UNION,什么时候使用UNION ALL? 答: 需要唯一结果的时候可以使用UNION当需要完整数据或性能优先 时候使用UNION ALL -
请解释嵌套查询的作用和适用场景。 答: 嵌套查询的作用 1. 数据筛选与过滤 2. 数据比较与计算 3. 数据存在性检查 4. 数据聚合与统计
特别适合需要多步骤数据处理和分析的业务场景。
3 操作题
- 使用内连接查询,查询出每个员工所在部门的名称和员工姓名。
mysql>mysql> select e.name,d.dept_name from employees as e inner join departments as d -> on e.dept_id=d.dept_id;+-----------+-----------+| name | dept_name |+-----------+-----------+| 梁伟 | 人事部 || 郭岩 | 人事部 || 李玉英 | 人事部 || 张健 | 人事部 |.........- 使用左外连接查询,查询出所有员工的信息以及他们所在部门的名称(如果员工没有部门,部门名称显示为 NULL)。
mysql>mysql> select e.*,d.dept_name from employees as e left join departments as d on e.dept_id=d.dept_id;+-------------+-----------+------------+------------+---------------------------+--------------+---------+-----------+| employee_id | name | hire_date | birth_date | email | phone_number | dept_id | dept_name |+-------------+-----------+------------+------------+---------------------------+--------------+---------+-----------+| 1 | 梁伟 | 2018-06-21 | 1971-08-19 | liangwei@tedu.cn | 13591491431 | 1 | 人事部 || 2 | 郭岩 | 2010-03-21 | 1974-05-13 | guoyan@tedu.cn | 13845285867 | 1 | 人事部 || 3 | 李玉英 | 2012-01-19 | 1974-01-25 | liyuying@tedu.cn | 15628557234 | 1 | 人事部 || 4 | 张健 | 2008-09-17 | 1972-06-07 | zhangjian@moershi.com | 13835990213 | 1 | 人事部 || 5 | 郑静 | 2018-02-03 | 1997-02-14 | zhengjing@tedu.cn | 14508936730 | 1 | 人事部 || 6 | 牛建军 | 2005-11-18 | 1985-03-19 | niujianjun@moershi.com | 14750937118 | 1 | 人事部 |......- 使用合并查询,将薪资表中基本薪资大于 5000 和奖金大于 2000 的记录合并。
mysql> (select name,basic from salary as s inner join employees as e on e.employee_id=s.employee_id where basic > 5000) -> union -> (select name,bonus from salary as s inner join employees as e on e.employee_id=s.employee_id where bonus >2000);+-----------+-------+| name | basic |+-----------+-------+| 郭岩 | 17000 || 李玉英 | 8000 || 张健 | 14000 || 牛建军 | 14000 || 刘斌 | 19000 || 郭兰英 | 14000 || 王楠 | 15000 || 廖娜 | 10000 || 陈阳 | 16000 |.....- 使用嵌套查询,查询出部门名称为 “开发部” 的所有员工的信息。
mysql>mysql> select * from employees where dept_id= -> (select dept_id from departments where dept_name='开发部');+-------------+-----------+------------+------------+---------------------------+--------------+---------+| employee_id | name | hire_date | birth_date | email | phone_number | dept_id |+-------------+-----------+------------+------------+---------------------------+--------------+---------+| 20 | 蒋红 | 2017-12-29 | 1978-01-24 | jianghong@tedu.cn | 15852915398 | 4 || 21 | 曹宁 | 2004-06-07 | 1988-01-05 | caoning@tedu.cn | 14513022304 | 4 || 22 | 吕刚 | 2014-01-18 | 1980-06-24 | lvgang@tedu.cn | 18136987619 | 4 || 23 | 王莉 | 2021-02-04 | 1972-12-19 | wangli@moershi.com | 15376329290 | 4 || 24 | 邓秀芳 | 2020-09-08 | 1980-12-12 | dengxiufang@moershi.com | 15884927117 | 4 || 25 | 邵佳 | 2011-08-15 | 1978-11-28 | shaojia@tedu.cn | 13296016750 | 4 || 26 | 党丽 | 2014-03-14 | 1978-12-30 | dangli@moershi.com | 13166234580 | 4 || 27 | 梁勇 | 2007-01-19 | 1997-11-12 | liangyong@tedu.cn | 15307868657 | 4 || 28 | 郑秀珍 | 2011-04-28 | 1972-09-01 | zhengxiuzhen@moershi.com | 14543186401 | 4 || 29 | 胡秀云 | 2003-11-03 | 2000-05-14 | huxiuyun@tedu.cn | 18212266720 | 4 || 30 | 邢淑兰 | 2011-07-02 | 1989-06-17 | xingshulan@moershi.com | 13032270370 | 4 || 31 | 刘海燕 | 2018-01-06 | 1982-08-21 | liuhaiyan@moershi.com | 15064354651 | 4 || 32 | 冯建国 | 2014-05-28 | 1980-01-26 | fengjianguo@tedu.cn | 13344957322 | 4 |.........