
[TOC]
01:mysql之基础
今日工作任务路线图
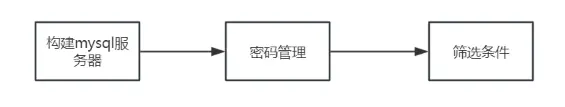
一、工作场景
咱公司最近业务拓展,新入职了好多员工。HR部门要管理员工信息、部门信息和工资信息,财务部门每月得核算工资,老板也想随时了解各部门的人力成本。之前用 Excel 管理,数据多了又乱又容易出错。现在打算用 MySQL 数据库来管理这些数据。但大家都是小白,得先学会 MySQL 安装、密码管理、图形化软件安装,还得会用单表查询、日期函数、聚集函数、case 函数,才能从员工表、部门表、工资表中获取想要的信息,解决工作中的难题。
二、为什么学mysql数据库
为啥要学这些东西呢?想象一下,要是不会 MySQL 安装,就没办法搭建数据库来管理公司的员工、部门和工资信息,那还不得乱成一锅粥。密码管理也很重要,要是密码泄露,公司的重要数据就可能被坏人拿走,损失可就大了。图形化软件能让操作更简单,就像玩游戏一样轻松。单表查询能让你快速找到需要的数据,日期函数可以处理和日期相关的信息,聚集函数能帮你统计数据,case 函数能根据不同条件输出不同结果。学会这些,工作效率蹭蹭往上涨,升职加薪不是梦!
三、构建mysql服务器
当前任务环节
3.1 安装mysql服务
1)准备1台虚拟机,要求如下:
| IP地址 | 主机名 |
|---|---|
| 192.168.90.50 | mysql50 |
2)配置IP地址和主机名
[root@localhost ~]# nmcli connection modify ens160 ipv4.addresses 192.168.90.50/24 autoconnect yes参数详解:* nmcli:NetworkManager 的命令行工具,用于管理网络连接* connection modify:修改现有网络连接的配置* ens160:网络接口的名称(通常是以太网接口)* ipv4.addresses 192.168.90.50/24: * 设置 IPv4 地址为 192.168.90.50 * 子网掩码为 255.255.255.0(/24表示前24位是网络位) * autoconnect yes:设置系统启动时自动连接此网络接口* 效果:将 ens160网络接口配置为使用静态 IP 地址 192.168.90.50,并确保系统重启后自动启用该连接。
[root@localhost ~]# nmcli connection up ens160参数详解:* connection up:激活指定的网络连接* ens160:要激活的网络接口名称* 效果:立即应用对 ens160接口的配置更改,使新的 IP 地址生效。相当于重启网络服务或启用网络接口。
[root@mysql50 ~]# hostnamectl set-hostname mysql50参数详解:* hostnamectl:系统主机名管理工具* set-hostname:设置新的主机名* mysql50:新的主机名称* 效果:将系统的主机名永久更改为 mysql50。主机名用于在网络中标识该系统。3)安装mysql-server服务软件
[root@mysql50 ~]# yum -y install mysql-server[root@mysql50 ~]# rpm -q mysql-servermysql-server-8.0.41-2.el9_5.x86_64
#启动服务root@mysql50 ~]# # systemctl【西斯屯-ctl】 start【s 达儿】 mysqld[root@mysql50 ~]# # systemctl【西斯屯-ctl】 enable【ing 内 步】 mysqld4)查看端口
[root@mysql50 ~]# ss -utnlp | grep 【哥瑞普】 3306 #查看端口tcp LISTEN 0 70 *:33060 *:* users:(("mysqld",pid=21912,fd=22))tcp LISTEN 0 128 *:3306 *:* users:(("mysqld",pid=21912,fd=25))[root@mysql50 ~]#或[root@mysql50 ~]# netstat【劣 s 塔】 -utnlp | grep 【哥瑞普】 mysqld #仅查看mysqld进程tcp6 0 0 :::33060 :::* LISTEN 21912/mysqldtcp6 0 0 :::3306 :::* LISTEN 21912/mysqld| 选项 | 含义 | 作用 |
|---|---|---|
| -t(—tcp) | 显示 TCP 连接 | 过滤只显示 TCP 协议的网络连接 |
| -u(—udp) | 显示 UDP 连接 | 过滤只显示 UDP 协议的网络连接 |
| -n(—numeric) | 数字格式显示 | 不解析主机名和服务名,直接显示 IP 和端口号 |
| -l(—listening) | 只显示监听端口 | 只显示正在监听的套接字(服务端) |
| -p(—processes) | 显示进程信息 | 显示使用该端口的进程信息 |
说明:
MySQL 8中的3306端口是MySQL服务默认使用的端口,主要用于建立客户端与MySQL服务器之间的连接。
MySQL 8中的33060端口是MySQL Shell默认使用的管理端口,主要用于执行各种数据库管理任务。远程管理MySQL服务器:使用MySQL Shell连接到MySQL服务,并在远程管理控制台上执行各种数据库管理操作,例如创建、删除、备份和恢复数据库等。
3.2 连接服务
说明: 数据库管理员本机登陆默认没有密码
[root@mysql50 ~]# mysqlWelcome to the MySQL monitor. Commands end with ; or \g.Your MySQL connection id is 8Server version【沃申】: 8.0.41 Source distribution
Copyright (c) 2000, 2025, Oracle and/or its affiliates.
Oracle is a registered trademark of Oracle Corporation and/or itsaffiliates. Other names may be trademarks of their respectiveowners.
Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.
mysql>mysql> exit【诶西特】Bye[root@mysql50 ~]#3.3 mysql必备命令
mysql> select【涩莱克特】 version【沃申】() ; //查看数据库软件版本+------------------+| version【沃申】() |+------------------+| 8.0.41 |+------------------+1 row in set (0.00 sec)mysql> select【涩莱克特】 user() ; //查看登陆的用户和客户端地址+----------------+| user() |+----------------+| root@localhost | 管理员root本机登陆+----------------+1 row in set (0.00 sec)mysql> show【瘦】 databases;【得塔-贝斯】 //查看已有的库+----------------------------------------------+| Database【得塔-贝斯】 |+----------------------------------------------+| information【因弗梅申】_schema【斯京(白话)磨】 || mysql || performance【破佛曼斯】_schema【斯京(白话)磨】 || sys |+----------------------------------------------+4 rows in set (0.00 sec)说明:
默认4个库 不可以删除,存储的是 服务运行时加载的不同功能的程序和数据。
information【因弗梅申】_schema【斯京(白话)磨】:是MySQL数据库提供的一个虚拟的数据库,存储了MySQL数据库中的相关信息,比如数据库、表、列、索引、权限、角色等信息。它并不存储实际的数据,而是提供了一些视图和存储过程,用于查询和管理数据库的元数据信息。
mysql:存储了MySQL服务器的系统配置、用户、账号和权限信息等。它是MySQL数据库最基本的库,存储了MySQL服务器的核心信息。
performance【破佛曼斯】_schema【斯京(白话)磨】】:存储了MySQL数据库的性能指标、事件和统计信息等数据,可以用于性能分析和优化。
sys:是MySQL 8.0引入的一个新库,它基于 information【因弗梅申】_schema【斯京(白话)磨和performance【破佛曼斯】_schema【斯京(白话)磨】视图,提供了更方便、更直观的方式来查询和管理MySQL数据库的元数据和性能数据。
mysql> select【涩莱克特】 database();【得塔-贝斯】 //查看当前在那个库里 null【nò】 表示没有在任何库里+------------+| database() |【得塔-贝斯】+------------+| NULL【nò】 |+------------+1 row in set (0.00 sec)mysql> use mysql ; //切换到mysql库mysql> select【涩莱克特】 database();【得塔-贝斯】 // 再次显示所在的库+------------+| database() |【得塔-贝斯】+------------+| mysql |+------------+1 row in set (0.00 sec)mysql> show【瘦】 tables;【忒-部s】 //显示库里已有的表+------------------------------------------------------+| Tables【忒-部s】_in_mysql |+------------------------------------------------------+| columns_priv || component || db || default_roles || engine_cost || func || general_log || global_grants || gtid_executed || help_category || help_keyword || help_relation || help_topic || innodb_index_stats || innodb_table【忒-部】_stats || password_history || plugin || procs_priv || proxies_priv || replication_asynchronous_connection_failover || replication_asynchronous_connection_failover_managed || replication_group_configuration_version【沃申】 || replication_group_member_actions || role_edges || server_cost || servers || slave_master_info || slave_relay_log_info || slave_worker_info || slow_log || tables【忒-部s】_priv || time_zone || time_zone_leap_second || time_zone_name || time_zone_transition || time_zone_transition_type || user |+------------------------------------------------------+37 rows in set (0.00 sec)mysql> exit【诶西特】 ; #断开连接Bye[root@mysql50 ~]#四、密码管理
当前任务环节
4.1 问题
1) 在192.168.90.50主机做如下练习:
- 设置root密码为moershi
- 修改root密码为123qqq…A
- 破解root密码为NSD123456…a
4.2 步骤
实现此案例需要按照如下步骤进行。
步骤一:设置root密码为moershi
命令操作如下所示:
2行输出是警告而已不用关心
[root@mysql50 ~]# mysqladmin -uroot -p password "moershi"Enter password: //敲回车mysqladmin: [Warning] Using a password on the command line interface can be insecure.Warning: Since password will be sent to server in plain text, use ssl connection to ensure password safety.[root@mysql50 ~]#[root@mysql50 ~]# mysql //无密码连接被拒绝ERROR 1045 (28000): Access denied for user 'root'@'localhost' (using password: NO)[root@mysql50 ~]#[root@mysql50 ~]# mysql -uroot –pmoershi //连接时输入密码mysql: [Warning] Using a password on the command line interface can be insecure.Welcome to the MySQL monitor. Commands end with ; or \g.Your MySQL connection id is 14Server version【沃申】: 8.0.26 Source distributionCopyright (c) 2000, 2021, Oracle and/or its affiliates.Oracle is a registered trademark of Oracle Corporation and/or itsaffiliates. Other names may be trademarks of their respectiveowners.Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.mysql> 登陆成功步骤二:修改root密码为123qqq…A
命令操作如下所示:
[root@mysql50 ~]# mysqladmin -uroot -pmoershi password "123qqq...A" //修改密码mysqladmin: [Warning] Using a password on the command line interface can be insecure.Warning: Since password will be sent to server in plain text, use ssl connection to ensure password safety.[root@mysql50 ~]#[root@mysql50 ~]# mysql -uroot –pmoershi //旧密码无法登陆mysql: [Warning] Using a password on the command line interface can be insecure.ERROR 1045 (28000): Access denied for user 'root'@'localhost' (using password: YES)[root@mysql50 ~]#[root@mysql50 ~]# mysql -uroot -p123qqq...A //新密码登陆mysql: [Warning] Using a password on the command line interface can be insecure.Welcome to the MySQL monitor. Commands end with ; or \g.Your MySQL connection id is 18Server version【沃申】: 8.0.26 Source distributionCopyright (c) 2000, 2021, Oracle and/or its affiliates.Oracle is a registered trademark of Oracle Corporation and/or itsaffiliates. Other names may be trademarks of their respectiveowners.Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.mysql> 登陆成功步骤三:破解root密码为NSD123456…a
说明:在mysql50主机做此练习
命令操作如下所示:
[root@mysql50 ~]# mysql -uroot -pNSD123456...a //破解前登陆失败mysql: [Warning] Using a password on the command line interface can be insecure.ERROR 1045 (28000): Access denied for user 'root'@'localhost' (using password: YES)[root@mysql50 ~]#[root@mysql50 ~]# vim /etc/my.cnf.d/mysql-server.cnf //修改主配置文件[mysqld]skip-grant-tables【忒-部s】 //手动添加此行 作用登陆时不验证密码:wq[root@mysql50 ~]#[root@mysql50 ~]# # systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld //重启服务 作用让服务以新配置运行[root@mysql50 ~]#[root@mysql50 ~]# mysql //连接服务Welcome to the MySQL monitor. Commands end with ; or \g.Your MySQL connection id is 7Server version【沃申】: 8.0.26 Source distributionCopyright (c) 2000, 2021, Oracle and/or its affiliates.Oracle is a registered trademark of Oracle Corporation and/or itsaffiliates. Other names may be trademarks of their respectiveowners.Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.//查看存放密码的表头名Mysql>Mysql> desc mysql.user ;//把mysql库下user表中 用户root的密码设置为无;Mysql>mysql> update mysql.user set authentication_string="" where【威尔】 user="root";Query OK, 1 row affected (0.05 sec)Rows matched: 1 Changed: 1 Warnings: 0Mysql>mysql> exit【诶西特】; 断开连接Bye[root@mysql50 ~]#[root@mysql50 ~]# vim /etc/my.cnf.d/mysql-server.cnf 编辑配置文件[mysqld]#skip-grant-tables【忒-部s】 //注释添加的行:wq[root@mysql50 ~]#[root@mysql50 ~]# # systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld //重启服务 作用让注释生效[root@mysql50 ~]#[root@localhost ~]# mysql 无密码登陆Welcome to the MySQL monitor. Commands end with ; or \g.Your MySQL connection id is 8Server version【沃申】: 8.0.26 Source distributionCopyright (c) 2000, 2021, Oracle and/or its affiliates.Oracle is a registered trademark of Oracle Corporation and/or itsaffiliates. Other names may be trademarks of their respectiveowners.Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.//设置root用户本机登陆密码Mysql>mysql> alter user root@"localhost" identified by "NSD123456...a";Query OK, 0 rows affected (0.00 sec)Mysql>mysql> exit【诶西特】 断开连接Bye[root@mysql50 ~]#[root@localhost ~]# mysql 不输密码无法登陆ERROR 1045 (28000): Access denied for user 'root'@'localhost' (using password: NO)[root@mysql50 ~]#[root@localhost ~]# mysql -uroot -pNSD123456...a 使用破解的密码登陆mysql: [Warning] Using a password on the command line interface can be insecure.Welcome to the MySQL monitor. Commands end with ; or \g.Your MySQL connection id is 10Server version【沃申】: 8.0.26 Source distributionCopyright (c) 2000, 2021, Oracle and/or its affiliates.Oracle is a registered trademark of Oracle Corporation and/or itsaffiliates. Other names may be trademarks of their respectiveowners.Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.mysql>mysql> #登陆成功Mysql>mysql> show【瘦】 databases;【得塔-贝斯】 查看已有的库+----------------------------------------------+| Database【得塔-贝斯】 |+----------------------------------------------+| information【因弗梅申】_schema【斯京(白话)磨】 || mysql || performance【破佛曼斯】_schema【斯京(白话)磨】 || sys |+----------------------------------------------+4 rows in set (0.01 sec)五、筛选条件
当前任务环节
5.1导入数据
拷贝moershi.sql文件到mysql50主机里,然后使用moershi.sql创建练习使用的数据。
//恢复数据[root@mysql50 ~]# mysql -uroot -pNSD123456...a < /root/moershi.sqlmysql: [Warning] Using a password on the command line interface can be insecure.//连接服务[root@mysql50 ~]# mysql -uroot -pNSD123456...amysql>mysql> show【瘦】 databases;【得塔-贝斯】 //查看库+----------------------------------------------+| Database【得塔-贝斯】 |+----------------------------------------------+| information【因弗梅申】_schema【斯京(白话)磨】 || mysql || performance【破佛曼斯】_schema【斯京(白话)磨】 || sys || moershi | 恢复的库+----------------------------------------------+5 rows in set (0.00 sec)mysql>mysql> use moershi; //进入库Reading table【忒-部】 information【因弗梅申】 for completion of table【忒-部】 and column namesYou can turn off this feature to get a quicker startup【s 达 啊普】 with -ADatabase【得塔-贝斯】 changedmysql>mysql> show【瘦】 tables;【忒-部s】 //查看表+------------------+| Tables【忒-部s】_in_moershi |+------------------+| departments | 部门表| employees | 员工表| salary | 工资表| user | 用户表+------------------+4 rows in set (0.00 sec)5.2 使用user 表做查询练习
user表里存储的是 系统用户信息( 就是 /etc/passwd 文件的内容)
mysql> desc moershi.user; //查看表头+----------+-------------+------+-----+----------------+----------------+| Field | Type | Null【nò】 | Key | Default | Extra |+----------+-------------+------+-----+----------------+----------------+| id | int(11) | NO | PRI | NULL【nò】 | auto_increment |行号| name | char(20) | YES | | NULL【nò】 | |用户名| password | char(1) | YES | | NULL【nò】 | |密码占位符| uid | int(11) | YES | | NULL【nò】 | | uid号| gid | int(11) | YES | | NULL【nò】 | | gid号| comment | varchar(50) | YES | | NULL【nò】 | | 描述信息| homedir | varchar(80) | YES | | NULL【nò】 | | 家目录| shell | char(30) | YES | | NULL【nò】 | | 解释器+----------+-------------+------+-----+----------------+----------------+8 rows in set (0.00 sec)5.3 select【涩莱克特】命令格式演示
语法格式1 select【涩莱克特】 字段列表 FROM【弗乱】 库名.表名;
语法格式2 select【涩莱克特】 字段列表 FROM【弗乱】 库名.表名 where【威尔】 筛选条件;
mysql> select【涩莱克特】 name from【弗乱】 moershi.user; //查看一个表头+-----------------+| name |+-----------------+| root || bin || daemon || adm || lp || sync || shutdown || halt || mail || operator || games || ftp || nobody || systemd-network || dbus || polkitd || sshd || postfix || chrony || rpc || rpcuser || nfsnobody || haproxy || plj || apache || mysql || bob |+-----------------+27 rows in set (0.00 sec)
mysql> select【涩莱克特】 name ,uid from【弗乱】 moershi.user; //查看多个表头+-----------------+-------+| name | uid |+-----------------+-------+| root | 0 || bin | 1 || daemon | 2 || adm | 3 || lp | 4 || sync | 5 || shutdown | 6 || halt | 7 || mail | 8 || operator | 11 || games | 12 || ftp | 14 || nobody | 99 || systemd-network | 192 || dbus | 81 || polkitd | 999 || sshd | 74 || postfix | 89 || chrony | 998 || rpc | 32 || rpcuser | 29 || nfsnobody | 65534 || haproxy | 188 || plj | 1000 || apache | 48 || mysql | 27 || bob | NULL【nò】 |+-----------------+-------+27 rows in set (0.00 sec)
mysql> select【涩莱克特】 * from【弗乱】 moershi.user; //查看所有表头+----+-----------------+----------+-------+-------+----------------------------+--------------------+----------------+| id | name | password | uid | gid | comment | homedir | shell |+----+-----------------+----------+-------+-------+----------------------------+--------------------+----------------+| 1 | root | x | 0 | 0 | root | /root | /bin/bash || 2 | bin | x | 1 | 1 | bin | /bin | /sbin/nologin || 3 | daemon | x | 2 | 2 | daemon | /sbin | /sbin/nologin || 4 | adm | x | 3 | 4 | adm | /var/adm | /sbin/nologin || 5 | lp | x | 4 | 7 | lp | /var/spool/lpd | /sbin/nologin || 6 | sync | x | 5 | 0 | sync | /sbin | /bin/sync || 7 | shutdown | x | 6 | 0 | shutdown | /sbin | /sbin/shutdown || 8 | halt | x | 7 | 0 | halt | /sbin | /sbin/halt || 9 | mail | x | 8 | 12 | mail | /var/spool/mail | /sbin/nologin || 10 | operator | x | 11 | 0 | operator | /root | /sbin/nologin || 11 | games | x | 12 | 100 | games | /usr/games | /sbin/nologin || 12 | ftp | x | 14 | 50 | FTP User | /var/ftp | /sbin/nologin || 13 | nobody | x | 99 | 99 | Nobody | / | /sbin/nologin || 14 | systemd-network | x | 192 | 192 | systemd Network Management | / | /sbin/nologin || 15 | dbus | x | 81 | 81 | System message bus | / | /sbin/nologin || 16 | polkitd | x | 999 | 998 | User for polkitd | / | /sbin/nologin || 17 | sshd | x | 74 | 74 | Privilege-separated SSH | /var/empty/sshd | /sbin/nologin || 18 | postfix | x | 89 | 89 | | /var/spool/postfix | /sbin/nologin || 19 | chrony | x | 998 | 996 | | /var/lib/chrony | /sbin/nologin || 20 | rpc | x | 32 | 32 | Rpcbind Daemon | /var/lib/rpcbind | /sbin/nologin || 21 | rpcuser | x | 29 | 29 | RPC Service User | /var/lib/nfs | /sbin/nologin || 22 | nfsnobody | x | 65534 | 65534 | Anonymous NFS User | /var/lib/nfs | /sbin/nologin || 23 | haproxy | x | 188 | 188 | haproxy | /var/lib/haproxy | /sbin/nologin || 24 | plj | x | 1000 | 1000 | | /home/plj | /bin/bash || 25 | apache | x | 48 | 48 | Apache | /usr/share/httpd | /sbin/nologin || 26 | mysql | x | 27 | 27 | MySQL Server | /var/lib/mysql | /bin/false || 27 | bob | NUL【nò】L | NULL【nò】 | NULL【nò】 | NULL【nò】 | NULL【nò】 | NULL【nò】 |+----+-----------------+----------+-------+-------+----------------------------+--------------------+----------------+27 rows in set (0.00 sec)加筛选条件
mysql> select【涩莱克特】 * from【弗乱】 moershi.user where【威尔】 name = “root”; //查找root用户信息+----+------+----------+------+------+---------+---------+-----------+| id | name | password | uid | gid | comment | homedir | shell |+----+------+----------+------+------+---------+---------+-----------+| 1 | root | x | 0 | 0 | root | /root | /bin/bash |+----+------+----------+------+------+---------+---------+-----------+1 row in set (0.00 sec)mysql>mysql> select【涩莱克特】 * from【弗乱】 moershi.user where【威尔】 id = 2 ; //查找第2行用户信息+----+------+----------+------+------+---------+---------+--------------+| id | name | password | uid | gid | comment | homedir | shell |+----+------+----------+------+------+---------+---------+--------------+| 2 | bin | x | 1 | 1 | bin | /bin | /sbin/nologin |+----+------+----------+------+------+---------+---------+--------------+1 row in set (0.00 sec)5.4 练习数值比较
比较符号:
| 符号 | 意义 |
|---|---|
| = | 相等 |
| != | 不相等 |
| > | 大于 |
| >= | 大于等于 |
| < | 小于 |
| <= | 小于等于 |
符号两边要是数字或数值类型的表头 符号左边与符号右边做比较
//查看第3行的行号、用户名、uid、gid 四个表头的值mysql>mysql> select【涩莱克特】 id,name,uid,gid from【弗乱】 moershi.user where【威尔】 id = 3;+----+--------+------+------+| id | name | uid | gid |+----+--------+------+------+| 3 | daemon | 2 | 2 |+----+--------+------+------+1 row in set (0.00 sec)//查看前2行的行号用户名、uid、gid 四个表头的值mysql>mysql> select【涩莱克特】 id,name,uid,gid from【弗乱】 moershi.user where【威尔】 id < 3;+----+------+------+------+| id | name | uid | gid |+----+------+------+------+| 1 | root | 0 | 0 || 2 | bin | 1 | 1 |+----+------+------+------+2 rows in set (0.00 sec)//查看前3行的行号、用户名、uid、gid 四个表头的值mysql>mysql> select【涩莱克特】 id,name,uid,gid from【弗乱】 moershi.user where【威尔】 id <= 3;+----+--------+------+------+| id | name | uid | gid |+----+--------+------+------+| 1 | root | 0 | 0 || 2 | bin | 1 | 1 || 3 | daemon | 2 | 2 |+----+--------+------+------+3 rows in set (0.00 sec)//查看前uid号大于6000的行号、用户名、uid、gid 四个表头的值mysql>mysql> select【涩莱克特】 id,name,uid,gid from【弗乱】 moershi.user where【威尔】 uid > 6000;+----+-----------+-------+-------+| id | name | uid | gid |+----+-----------+-------+-------+| 22 | nfsnobody | 65534 | 65534 |+----+-----------+-------+-------+1 row in set (0.00 sec)//查看前uid号大于等于1000的行号、用户名、uid、gid 四个表头的值mysql>mysql> select【涩莱克特】 id,name,uid,gid from【弗乱】 moershi.user where【威尔】 uid >= 1000;+----+-----------+-------+-------+| id | name | uid | gid |+----+-----------+-------+-------+| 22 | nfsnobody | 65534 | 65534 || 24 | plj | 1000 | 1000 |+----+-----------+-------+-------+2 rows in set (0.00 sec)//查看uid号和gid号相同的行 仅显示行号、用户名、uid、gid 四个表头的值mysql>mysql> select【涩莱克特】 id,name,uid,gid from【弗乱】 moershi.user where【威尔】 uid = gid;+----+-----------------+-------+-------+| id | name | uid | gid |+----+-----------------+-------+-------+| 1 | root | 0 | 0 || 2 | bin | 1 | 1 || 3 | daemon | 2 | 2 || 13 | nobody | 99 | 99 || 14 | systemd-network | 192 | 192 || 15 | dbus | 81 | 81 || 17 | sshd | 74 | 74 || 18 | postfix | 89 | 89 || 20 | rpc | 32 | 32 || 21 | rpcuser | 29 | 29 || 22 | nfsnobody | 65534 | 65534 || 23 | haproxy | 188 | 188 || 24 | plj | 1000 | 1000 || 25 | apache | 48 | 48 || 26 | mysql | 27 | 27 |+----+-----------------+-------+-------+15 rows in set (0.00 sec)//查看uid号和gid号不一样的行 仅显示行号、用户名、uid、gid 四个表头的值mysql>mysql> select【涩莱克特】 id,name,uid,gid from【弗乱】 moershi.user where【威尔】 uid != gid;+----+----------+------+------+| id | name | uid | gid |+----+----------+------+------+| 4 | adm | 3 | 4 || 5 | lp | 4 | 7 || 6 | sync | 5 | 0 || 7 | shutdown | 6 | 0 || 8 | halt | 7 | 0 || 9 | mail | 8 | 12 || 10 | operator | 11 | 0 || 11 | games | 12 | 100 || 12 | ftp | 14 | 50 || 16 | polkitd | 999 | 998 || 19 | chrony | 998 | 996 |+----+----------+------+------+11 rows in set (0.00 sec)mysql>5.5 练习范围匹配
| in | (值列表) //在…里 |
| not【nuō 特】 in | (值列表) //不在…里 |
| between【B豚ing】 | 数字1 and 数字2 //在…之间 |
| 操作符 | 语法 | 描述 | 示例 | 返回值说明 |
|---|---|---|---|---|
| IN | column_name IN (value1, value2, ...) | 检查列值是否在指定的值列表中 | SELECT * FROM products WHERE category_id IN (1, 3, 5); | 返回 category_id 为 1、3 或 5 的所有产品 |
| NOT【nuō 特】 IN | column_name NOT【nuō 特】 IN (value1, value2, ...) | 检查列值是否不在指定的值列表中 | SELECT * FROM users WHERE country NOT【nuō 特】 IN ('USA', 'Canada'); | 返回不在美国和加拿大的所有用户 |
| BETWEEN【B豚ing】 | column_name BETWEEN【B豚ing】 value1 AND value2 | 检查列值是否在指定的范围内(包含边界值) | SELECT * FROM orders WHERE order_date BETWEEN【B豚ing】 '2023-01-01' AND '2023-01-31'; | 返回 2023 年 1 月期间的所有订单 |
| NOT BETWEEN【B豚ing】 | column_name NOT【nuō 特】 BETWEEN【B豚ing】 value1 AND value2 | 检查列值是否不在指定的范围内 | SELECT * FROM employees WHERE salary NOT【nuō 特】 BETWEEN【B豚ing】 30000 AND 60000; | 返回薪资低于 30,000 或高于 60,000 的所有员工 |
补充说明
- IN 和 NOT【nuō 特】 IN 适用于离散值的匹配,可以用于数字、字符串、日期等数据类型
- BETWEEN【B豚ing】 适用于连续范围的匹配,通常用于数字和日期范围
- BETWEEN【B豚ing】 操作包含边界值,即
BETWEEN【B豚ing】 10 AND 20包含 10 和 20 - 对于日期范围,建议使用标准日期格式(如 ‘YYYY-MM-DD’)以避免歧义
- 这些操作符可以组合使用,并与其他 WHERE 子句条件结合
命令操作如下所示:
//uid号表头的值 是 (1 , 3 , 5 , 7) 中的任意一个即可mysql>mysql> select【涩莱克特】 name,uid from【弗乱】 moershi.user where【威尔】 uid in (1 , 3 , 5 , 7);+------+------+| name | uid |+------+------+| bin | 1 || adm | 3 || sync | 5 || halt | 7 |+------+------+//shell 表头的的值 不是 "/bin/bash"或"/sbin/nologin" 即可mysql>mysql> select【涩莱克特】 name,shell from【弗乱】 moershi.user where【威尔】 shell not【nuō 特】 in ("/bin/bash","/sbin/nologin");+----------+----------------+| name | shell |+----------+----------------+| sync | /bin/sync || shutdown | /sbin/shutdown || halt | /sbin/halt || mysql | /bin/false |+----------+----------------+//id表头的值 在 10 到 20 之间即可 包括 10 和 20 本身mysql>mysql> select【涩莱克特】 id,name,uid from【弗乱】 moershi.user where【威尔】 id between【B豚ing】 10 and 20 ;+----+-----------------+------+| id | name | uid |+----+-----------------+------+| 10 | operator | 11 || 11 | games | 12 || 12 | ftp | 14 || 13 | nobody | 99 || 14 | systemd-network | 192 || 15 | dbus | 81 || 16 | polkitd | 999 || 17 | sshd | 74 || 18 | postfix | 89 || 19 | chrony | 998 || 20 | rpc | 32 |+----+-----------------+------+11 rows in set (0.00 sec)mysql>5.6 练习模糊匹配
where【威尔】 字段名 like【赖特】 “表达式”;
通配符
_ 表示 1个字符
% 表示零个或多个字符
SQL 模糊匹配操作符参考表
| 操作符/通配符 | 语法 | 描述 | 示例 | 匹配结果说明 |
|---|---|---|---|---|
| LIKE【赖特】 | WHERE column_name LIKE【赖特】 'pattern' | 用于在WHERE子句中搜索列中的指定模式 | SELECT * FROM customers WHERE name LIKE【赖特】 'J%'; | 返回所有名字以”J”开头的客户 |
| _ (下划线) | '_' | 匹配任意单个字符 | SELECT * FROM products WHERE code LIKE【赖特】 'A_1'; | 匹配”A” + 任意一个字符 + “1”,如”A01”, “AB1” |
| % (百分号) | '%' | 匹配零个或多个字符 | SELECT * FROM emails WHERE address LIKE【赖特】 '%@gmail.com'; | 匹配所有Gmail邮箱地址 |
| NOT LIKE【赖特】 | WHERE column_name NOT LIKE【赖特】 'pattern' | 查找不匹配指定模式的行 | SELECT * FROM files WHERE name NOT LIKE【赖特】 '%.tmp'; | 返回所有不是临时文件(.tmp)的文件 |
组合使用示例
| 模式 | 示例 | 描述 |
|---|---|---|
'_%' | LIKE【赖特】 '_%' | 匹配至少有一个字符的值 |
'%@%' | LIKE【赖特】 '%@%' | 匹配包含@符号的值(常用于邮箱验证) |
'__-___-____' | LIKE【赖特】 '__-___-____' | 匹配格式为XX-XXX-XXXX的值(如电话号码) |
'A%Z' | LIKE【赖特】 'A%Z' | 匹配以”A”开头并以”Z”结尾的值 |
命令操作如下所示:
//找名字必须是3个字符的 (没有空格挨着敲)mysql> select【涩莱克特】 name from【弗乱】 moershi.user where【威尔】 name like【赖特】 "___";+------+| name |+------+| bin || adm || ftp || rpc || plj || bob |+------+6 rows in set (0.00 sec)//找名字必须是4个字符的(没有空格挨着敲)mysql> select【涩莱克特】 name from【弗乱】 moershi.user where【威尔】 name like【赖特】 "____";+------+| name |+------+| root || sync || halt || mail || dbus || sshd || null【nò】 |+------+7 rows in set (0.00 sec)//找名字以字母a开头的(没有空格挨着敲)mysql> select【涩莱克特】 name from【弗乱】 moershi.user where【威尔】 name like【赖特】 "a%";//查找名字至少是4个字符的表达式mysql> select【涩莱克特】 name from【弗乱】 moershi.user where【威尔】 name like【赖特】 "%____%";(没有空格挨着敲)mysql> select【涩莱克特】 name from【弗乱】 moershi.user where【威尔】 name like【赖特】 "__%__";(没有空格挨着敲)mysql> select【涩莱克特】 name from【弗乱】 moershi.user where【威尔】 name like【赖特】 "____%";(没有空格挨着敲)5.7 练习逻辑比较
多个判断条件
逻辑与 and (&&) 多个判断条件必须同时成立
逻辑或 or (||) 多个判断条件其中某个条件成立即可
逻辑非 not【nuō 特】 (!) 取反
SQL 逻辑操作符参考表
| 操作符 | 语法 | 描述 | 示例 | 结果说明 |
|---|---|---|---|---|
| AND (逻辑与) | condition1 AND condition2 | 所有条件都必须为真,结果才为真 | SELECT * FROM users WHERE age > 18 AND country = 'USA'; | 返回年龄大于18岁且来自美国的用户 |
| OR (逻辑或) | condition1 OR condition2 | 至少一个条件为真,结果就为真 | SELECT * FROM products WHERE category = 'Electronics' OR price > 1000; | 返回电子产品或价格超过1000的产品 |
| NOT (逻辑非) | NOT condition | 反转条件的真假值 | SELECT * FROM orders WHERE NOT status = 'Cancelled'; | 返回所有未取消的订单 |
| && (AND的替代符号) | condition1 && condition2 | 某些数据库系统中AND的替代写法 | SELECT * FROM users WHERE age > 18 && country = 'USA'; | 与AND相同,但并非所有数据库都支持 |
| || (OR的替代符号) | condition1 || condition2 | 某些数据库系统中OR的替代写法 | SELECT * FROM products WHERE category = 'Electronics' || price > 1000; | 与OR相同,但并非所有数据库都支持 |
| ! (NOT的替代符号) | !condition | 某些数据库系统中NOT的替代写法 | SELECT * FROM orders WHERE !status = 'Cancelled'; | 与NOT相同,但并非所有数据库都支持 |
操作符优先级
| 优先级 | 操作符 | 描述 |
|---|---|---|
| 1 | 括号 () | 括号内的表达式最先计算 |
| 2 | NOT | 逻辑非 |
| 3 | AND | 逻辑与 |
| 4 | OR | 逻辑或 |
命令操作如下所示:
//逻辑非例子,查看解释器不是/bin/bash 的mysql> select【涩莱克特】 name,shell from【弗乱】 moershi.user where【威尔】 shell != "/bin/bash";+-----------------+----------------+| name | shell |+-----------------+----------------+| bin | /sbin/nologin || daemon | /sbin/nologin || adm | /sbin/nologin || lp | /sbin/nologin || sync | /bin/sync || shutdown | /sbin/shutdown || halt | /sbin/halt || mail | /sbin/nologin || operator | /sbin/nologin || games | /sbin/nologin || ftp | /sbin/nologin || nobody | /sbin/nologin || systemd-network | /sbin/nologin || dbus | /sbin/nologin || polkitd | /sbin/nologin || sshd | /sbin/nologin || postfix | /sbin/nologin || chrony | /sbin/nologin || rpc | /sbin/nologin || rpcuser | /sbin/nologin || nfsnobody | /sbin/nologin || haproxy | /sbin/nologin || apache | /sbin/nologin || mysql | /bin/false |+-----------------+----------------+24 rows in set (0.00 sec)
//not【nuō 特】 也是取反 要放在表达式的前边mysql> select【涩莱克特】 name,shell from【弗乱】 moershi.user where【威尔】 not【nuō 特】 shell = "/bin/bash";+-----------------+----------------+| name | shell |+-----------------+----------------+| bin | /sbin/nologin || daemon | /sbin/nologin || adm | /sbin/nologin || lp | /sbin/nologin || sync | /bin/sync || shutdown | /sbin/shutdown || halt | /sbin/halt || mail | /sbin/nologin || operator | /sbin/nologin || games | /sbin/nologin || ftp | /sbin/nologin || nobody | /sbin/nologin || systemd-network | /sbin/nologin || dbus | /sbin/nologin || polkitd | /sbin/nologin || sshd | /sbin/nologin || postfix | /sbin/nologin || chrony | /sbin/nologin || rpc | /sbin/nologin || rpcuser | /sbin/nologin || nfsnobody | /sbin/nologin || haproxy | /sbin/nologin || apache | /sbin/nologin || mysql | /bin/false |+-----------------+----------------+24 rows in set (0.00 sec)
//id值不在 10 到 20 之间mysql> select【涩莱克特】 id,name from【弗乱】 moershi.user where【威尔】 not【nuō 特】 id between【B豚ing】 10 and 20 ;+----+-----------+| id | name |+----+-----------+| 1 | root || 2 | bin || 3 | daemon || 4 | adm || 5 | lp || 6 | sync || 7 | shutdown || 8 | halt || 9 | mail || 21 | rpcuser || 22 | nfsnobody || 23 | haproxy || 24 | plj || 25 | apache || 26 | mysql || 27 | bob |+----+-----------+16 rows in set (0.00 sec)
//逻辑与 例子mysql> select【涩莱克特】 name,uid from【弗乱】 moershi.user where【威尔】 name="root" and uid = 1;Empty set (0.00 sec)mysql> select【涩莱克特】 name,uid from【弗乱】 moershi.user where【威尔】 name="root" and uid = 0;+------+------+| name | uid |+------+------+| root | 0 |+------+------+1 row in set (0.00 sec)
//逻辑或 例子mysql> select【涩莱克特】 name , uid from【弗乱】 moershi.user where【威尔】 name = "root" or name = "bin" or uid = 1;+------+------+| name | uid |+------+------+| root | 0 || bin | 1 |+------+------+mysql>逻辑匹配什么时候需要加()
逻辑与and 优先级高于逻辑或 or
如果在筛选条件里既有and 又有 or 默认先判断and 再判断or
//没加() 的查询结果select【涩莱克特】 name,uid from【弗乱】 moershi.user where【威尔】 name = "root" or name = "bin" and uid = 1 ;+------+------+| name | uid |+------+------+| root | 0 || bin | 1 |+------+------+2 rows in set (0.00 sec)//加()的查询结果select【涩莱克特】 name , uid from【弗乱】 moershi.user where【威尔】 (name = "root" or name = "bin") and uid = 1 ;+------+------+| name | uid |+------+------+| bin | 1 |+------+------+1 row in set (0.00 sec)mysql>5.8 练习字符比较/空/非空
符号两边必须是字符 或字符类型的表头
= 相等比较
!= 不相等比较。
SQL 字符比较与空值判断操作符参考表
| 操作符 | 语法 | 描述 | 示例 | 结果说明 |
|---|---|---|---|---|
| = (等于) | column_name = 'value' | 比较两个字符值是否相等 | SELECT * FROM users WHERE name = 'John'; | 返回名字为’John’的用户 |
| != 或 <> (不等于) | column_name != 'value' 或 column_name <> 'value' | 比较两个字符值是否不相等 | SELECT * FROM products WHERE category != 'Electronics'; | 返回类别不是’Electronics’的产品 |
| IS NULL【nò】 (为空) | column_name IS NULL【nò】 | 检查列值是否为NULL【nò】 | SELECT * FROM customers WHERE email IS NULL【nò】; | 返回没有填写邮箱的客户 |
| IS NOT【nuō 特】 NULL【nò】 (非空) | column_name IS NOT【nuō 特】 NULL【nò】 | 检查列值是否不为NULL【nò】 | SELECT * FROM orders WHERE shipping_address IS NOT【nuō 特】 NULL【nò】; | 返回已填写配送地址的订单 |
字符比较注意事项
| 注意事项 | 说明 | 示例 |
|---|---|---|
| 大小写敏感 | 在某些数据库系统中,字符比较可能区分大小写 | 'Apple' = 'apple' 可能返回false |
| 尾部空格 | 比较时可能会忽略或考虑字符串尾部的空格 | 'John ' = 'John' 可能返回true |
| 字符集和排序规则 | 比较结果受数据库字符集和排序规则设置影响 | 不同字符集可能导致不同的比较结果 |
空值判断的特殊性
| 特性 | 说明 | 示例 |
|---|---|---|
| NULL【nò】与任何值的比较 | NULL【nò】与任何值(包括NULL【nò】本身)比较都返回未知(UNKNOWN) | NULL【nò】 = NULL【nò】 返回NULL【nò】而不是true |
| 三值逻辑 | SQL使用三值逻辑: true, false, unknown | WHERE column = NULL【nò】 不会返回任何行 |
| 正确判断空值 | 必须使用IS NULL【nò】或IS NOT【nuō 特】 NULL【nò】判断空值 | WHERE column IS NULL【nò】 正确判断空值 |
命令操作如下所示:
//查看表里是否有名字叫apache的用户mysql> select【涩莱克特】 name from【弗乱】 moershi.user where【威尔】 name="apache" ;+--------+| name |+--------+| apache |+--------+1 row in set (0.00 sec)
//输出解释器不是/bin/bash的用户名 及使用的解释器mysql> select【涩莱克特】 name,shell from【弗乱】 moershi.user where【威尔】 shell != "/bin/bash";+-----------------+----------------+| name | shell |+-----------------+----------------+| bin | /sbin/nologin || daemon | /sbin/nologin || adm | /sbin/nologin || lp | /sbin/nologin || sync | /bin/sync || shutdown | /sbin/shutdown || halt | /sbin/halt || mail | /sbin/nologin || operator | /sbin/nologin || games | /sbin/nologin || ftp | /sbin/nologin || nobody | /sbin/nologin || systemd-network | /sbin/nologin || dbus | /sbin/nologin || polkitd | /sbin/nologin || sshd | /sbin/nologin || postfix | /sbin/nologin || chrony | /sbin/nologin || rpc | /sbin/nologin || rpcuser | /sbin/nologin || nfsnobody | /sbin/nologin || haproxy | /sbin/nologin || apache | /sbin/nologin || mysql | /bin/false |+-----------------+----------------+24 rows in set (0.00 sec)mysql>空 is null【nò】 表头下没有数据
非空 is not【nuō 特】 null【nò】 表头下有数据
mysql服务 使用关键字 null【nò】 或 NULL【nò】 表示表头没有数据
MySQL 空值判断操作符参考表
| 操作符 | 语法 | 描述 | 示例 | 结果说明 |
|---|---|---|---|---|
| IS NULL【nò】 | column_name IS NULL【nò】 | 检查列值是否为 NULL【nò】(空值) | SELECT * FROM users WHERE email IS NULL【nò】; | 返回 email 字段为空的用户 |
| IS NOT【nuō 特】 NULL【nò】 | column_name IS NOT【nuō 特】 NULL【nò】 | 检查列值是否不为 NULL【nò】(非空) | SELECT * FROM orders WHERE amount IS NOT【nuō 特】 NULL【nò】; | 返回 amount 字段有值的订单 |
NULL【nò】 值的特殊性质
| 特性 | 说明 | 示例 |
|---|---|---|
| NULL【nò】 与空字符串的区别 | NULL【nò】 表示没有值,而空字符串(”)是一个有效的值 | NULL【nò】 != '' |
| NULL【nò】 的比较 | NULL【nò】 与任何值(包括 NULL【nò】 本身)比较都返回未知 | NULL【nò】 = NULL【nò】 返回 NULL【nò】 |
| NULL【nò】 的计算 | 任何包含 NULL【nò】 的计算结果通常都是 NULL【nò】 | 5 + NULL【nò】 返回 NULL【nò】 |
| NULL【nò】 的逻辑运算 | NULL【nò】 参与逻辑运算时通常返回未知 | NULL【nò】 AND TRUE 返回 NULL【nò】 |
处理 NULL【nò】 值的函数
| 函数 | 语法 | 描述 | 示例 |
|---|---|---|---|
| IFNULL() | IFNULL(expr1, expr2) | 如果 expr1 不为 NULL【nò】,返回 expr1,否则返回 expr2 | SELECT IFNULL(salary, 0) FROM employees; |
| COALESCE() | COALESCE(expr1, expr2, ...) | 返回参数列表中第一个非 NULL【nò】 的值 | SELECT COALESCE(phone, mobile, '无联系方式') FROM contacts; |
| NULLIF() | NULLIF(expr1, expr2) | 如果 expr1 = expr2,返回 NULL【nò】,否则返回 expr1 | SELECT NULLIF(salary, 0) FROM employees; |
//添加新行 仅给行中的id 表头和name表头赋值mysql> insert【因涩特】 into moershi.user(id,name) values(71,""); //零个字符mysql> insert【因涩特】 into moershi.user(id,name) values(72,"null【nò】");//普通字母mysql> insert【因涩特】 into moershi.user(id,name) values(73,NULL【nò】); //表示空mysql> insert【因涩特】 into moershi.user(id,name) values(74,null【nò】); //表示空//查看id表头值大于等于70 的行 仅显示行中 id表头 和 name 表头的值mysql> select【涩莱克特】 id,name from【弗乱】 moershi.user where【威尔】 id >= 71;+----+-------------+| id | name |+----+-------------+| 71 | || 72 | null【nò】 || 73 | NULL【nò】 || 74 | NULL【nò】 |+----+-------------+
//查看name 表头没有数据的行 仅显示行中id表头 和 naeme 表头的值mysql> select【涩莱克特】 id,name from【弗乱】 moershi.user where【威尔】 name is null【nò】;+----+-------------+| id | name |+----+-------------+| 28 | NULL【nò】 || 29 | NULL【nò】 || 73 | NULL【nò】 || 74 | NULL【nò】 |+----+-------------+
//查看name 表头是0个字符的行, 仅显示行中id表头 和 naeme 表头的值mysql> select【涩莱克特】 id,name from【弗乱】 moershi.user where【威尔】 name="";+----+------+| id | name |+----+------+| 71 | |+----+------+1 row in set (0.00 sec)
//查看name 表头值是null【nò】的行, 仅显示行中id表头 和 naeme 表头的值mysql> select【涩莱克特】 id,name from【弗乱】 moershi.user where【威尔】 name="null【nò】";+----+------+| id | name |+----+------+| 72 | null【nò】 |+----+------+1 row in set (0.00 sec)
//查看name 表头有数据的行, 仅显示行中id表头 和 name 表头的值mysql> select【涩莱克特】 id,name from【弗乱】 moershi.user where【威尔】 name is not【nuō 特】 null【nò】;+----+-----------------+| id | name |+----+-----------------+| 1 | root || 2 | bin || 3 | daemon || 4 | adm || 5 | lp |........| 27 | bob || 71 | || 72 | null【nò】 |+----+-----------------+5.9 练习别名/去重/合并
| 操作类型 | 关键字/函数 | 描述 | 主要用途 |
|---|---|---|---|
| 别名 | AS 或空格 | 为列或表赋予临时名称 | 提高可读性、简化复杂查询 |
| 去重 | DISTINCT【迪斯定特】 | 去除查询结果中的重复行 | 获取唯一值列表 |
| 合并 | UNION / UNION ALL | 合并多个SELECT语句的结果集 | 组合来自不同查询的数据 |
别名
基本语法
-- 列别名SELECT column_name AS alias_name FROM table_name;SELECT column_name alias_name FROM table_name; -- 省略AS
-- 表别名SELECT t.column_name FROM table_name AS t;SELECT t.column_name FROM table_name t; -- 省略AS使用场景
- 简化复杂列名或表达式
- 提高查询结果的可读性
- 在多表连接中简化表引用
命令操作如下所示:
//定义别名使用 as 或 空格mysql> select【涩莱克特】 name,homedir from【弗乱】 moershi.user;+-----------------+--------------------+| name | homedir |+-----------------+--------------------+| root | /root || bin | /bin || daemon | /sbin || adm | /var/adm || lp | /var/spool/lpd || sync | /sbin || shutdown | /sbin || halt | /sbin || mail | /var/spool/mail || operator | /root || games | /usr/games || ftp | /var/ftp || nobody | / || systemd-network | / || dbus | / || polkitd | / || sshd | /var/empty/sshd || postfix | /var/spool/postfix || chrony | /var/lib/chrony || rpc | /var/lib/rpcbind || rpcuser | /var/lib/nfs || nfsnobody | /var/lib/nfs || haproxy | /var/lib/haproxy || plj | /home/plj || apache | /usr/share/httpd || mysql | /var/lib/mysql || bob | NULL |+-----------------+--------------------+27 rows in set (0.00 sec)
mysql> select【涩莱克特】 name as 用户名,homedir 家目录 from【弗乱】 moershi.user;+-----------------+--------------------+| 用户名 | 家目录 |+-----------------+--------------------+| root | /root || bin | /bin || daemon | /sbin || adm | /var/adm || lp | /var/spool/lpd || sync | /sbin || shutdown | /sbin || halt | /sbin || mail | /var/spool/mail || operator | /root || games | /usr/games || ftp | /var/ftp || nobody | / || systemd-network | / || dbus | / || polkitd | / || sshd | /var/empty/sshd || postfix | /var/spool/postfix || chrony | /var/lib/chrony || rpc | /var/lib/rpcbind || rpcuser | /var/lib/nfs || nfsnobody | /var/lib/nfs || haproxy | /var/lib/haproxy || plj | /home/plj || apache | /usr/share/httpd || mysql | /var/lib/mysql || bob | NULL |+-----------------+--------------------+27 rows in set (0.00 sec)合并
SQL 两种“合并”操作对比表
| 特性 | CONCAT() (字符串拼接) | UNION / UNION ALL (结果集合并) |
|---|---|---|
| 操作对象 | 列内的数据(字符串、文本) | 查询结果集(行) |
| 操作方向 | 水平合并(将多个列的值拼接到一行里) | 垂直合并(将多个查询的结果上下堆叠) |
| 目的 | 生成新的格式化字符串 | 组合来自不同查询的数据 |
| 语法示例 | SELECT CONCAT(first_name, ' ', last_name) FROM users; | SELECT name FROM table1 UNION SELECT name FROM table2; |
| 结果图示 | 输入: John Doe输出: John Doe | 输入: 查询1结果: John查询2结果: Jane输出: JohnJane |
1、 CONCAT() - 字符串拼接函数(横向合并)
CONCAT() 用于将多个字符串字段或值连接成一个字符串。它是在单条记录内进行操作。
基本语法:
CONCAT(string1, string2, ..., stringN)//拼接 concat【康(白话)凯特】()mysql> select【涩莱克特】 concat【康(白话)凯特】(name,"-",uid) as 用户信息 from【弗乱】 moershi.user where【威尔】 uid <= 5;+--------------+| 用户信息 |+--------------+| root-0 || bin-1 || daemon-2 || adm-3 || lp-4 || sync-5 |+--------------+6 rows in set (0.00 sec)//2列拼接mysql> select【涩莱克特】 concat【康(白话)凯特】(name,"-",uid) as 用户信息 from【弗乱】 moershi.user where【威尔】 uid <= 5;+--------------+| 用户信息 |+--------------+| root-0 || bin-1 || daemon-2 || adm-3 || lp-4 || sync-5 |+--------------+6 rows in set (0.00 sec)
//多列拼接mysql> select【涩莱克特】 concat【康(白话)凯特】(name,"-",uid ,"-",gid) as 用户信息 from【弗乱】 moershi.user where【威尔】 uid <= 5;+--------------+| 用户信息 |+--------------+| root-0-0 || bin-1-1 || daemon-2-2 || adm-3-4 || lp-4-7 || sync-5-0 |+--------------+2. UNION / UNION ALL - 结果集操作符(纵向合并)
UNION 用于将两个或多个 SELECT 语句的结果集合并为一个结果集。它是在记录之间进行操作。
基本语法:
SELECT column1, column2 FROM table1UNION [ALL]SELECT column1, column2 FROM table2;//把moershi.user表和moershi.departments的name数据纵向合并mysql> select name from moershi.user union select dept_name from moershi.departments;+-----------------+| name |+-----------------+| root || bin || daemon || adm || lp || sync || shutdown || halt || mail || operator || games || ftp || nobody || systemd-network || dbus || polkitd || sshd || postfix || chrony || rpc || rpcuser || nfsnobody || haproxy || plj || apache || mysql || bob || 人事部 || 财务部 || 运维部 || 开发部 || 测试部 || 市场部 || 销售部 || 法务部 |+-----------------+35 rows in set (0.00 sec)//多列纵向合并mysql> select id,name from moershi.user union select dept_id,dept_name from moershi.departments;+----+-----------------+| id | name |+----+-----------------+| 1 | root || 2 | bin || 3 | daemon || 4 | adm || 5 | lp || 6 | sync || 7 | shutdown || 8 | halt || 9 | mail || 10 | operator || 11 | games || 12 | ftp || 13 | nobody || 14 | systemd-network || 15 | dbus || 16 | polkitd || 17 | sshd || 18 | postfix || 19 | chrony || 20 | rpc || 21 | rpcuser || 22 | nfsnobody || 23 | haproxy || 24 | plj || 25 | apache || 26 | mysql || 27 | bob || 1 | 人事部 || 2 | 财务部 || 3 | 运维部 || 4 | 开发部 || 5 | 测试部 || 6 | 市场部 || 7 | 销售部 || 8 | 法务部 |+----+-----------------+35 rows in set (0.00 sec)2. 去重
去重显示 distinct【迪斯定特】 字段名列表 基本语法
SELECT DISTINCT【迪斯定特】 column1, column2 FROM table_name;使用场景
- 获取某列的唯一值列表
- 统计不重复的记录数量
- 避免重复数据影响分析结果
//去重前输出mysql> select【涩莱克特】 shell from【弗乱】 moershi.user where【威尔】 shell in ("/bin/bash","/sbin/nologin") ;+---------------+| shell |+---------------+| /bin/bash || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /sbin/nologin || /bin/bash || /sbin/nologin |+---------------+22 rows in set (0.00 sec)//去重后查看mysql> select【涩莱克特】 distinct【迪斯定特】 shell from【弗乱】 moershi.user where【威尔】 shell in ("/bin/bash","/sbin/nologin") ;+---------------+| shell |+---------------+| /bin/bash || /sbin/nologin |+---------------+2 rows in set (0.01 sec)mysql>六、作业
1. 选择题
-
MySQL 中,预设的拥有最高权限的超级用户的用户名为( D ) A. test B. administrator C. DBA D. root
-
实现将 root 用户的密码修改为“123456”的语句,正确的是( A ) A. ALTER USER ‘root’@‘localhost’ IDENTIFIED BY ‘123456’; B. ALTER USER ‘root’@‘localhost’ IDENTIFIED BY 123456; C. ALTER USER ‘root’@‘localhost’ =‘123456’; D. SET USER ‘root’@‘localhost’ =‘123456’;
-
要启动 MySQL 服务,在 Linux 系统下可以使用的命令是(C ) A. service mysql start B. systemctl start mysql C. both A and B D. mysql -u root -p
-
在
moershi.user表中,查询id大于 10 的记录,正确的 SQL 语句是( A ) A. select * FROM moershi.user where id > 10; B. select * FROM user where id > 10; C. select * FROM moershi.user where id >= 10; D. select * FROM user where id >= 10; -
在
moershi.user表中,查询uid在 100 到 200 之间的记录,使用的关键字是( A ) A. BETWEEN B. IN C. LIKE D. AND -
在
moershi.user表中,查询name以“a”开头的记录,SQL 语句是( A ) A. select * FROM moershi.user where name LIKE ‘a%’; B. select * FROM moershi.user where name LIKE ‘%a’; C. select * FROM moershi.user where name LIKE ‘%a%’; D. select * FROM moershi.user where name = ‘a’; -
在
moershi.user表中,查询id大于 10 并且gid小于 20 的记录,使用的逻辑运算符是(B ) A. OR B. AND C. NOT D. XOR -
在
moershi.user表中,查询password字段不为空的记录,SQL 语句是( A ) A. select * FROM moershi.user where password IS NOT NULL ; B. select * FROM moershi.user where password = ”; C. select * FROM moershi.user where password IS NULL ; D. select * FROM moershi.user where password != ”; -
在
moershi.user表中,查询name字段并给它起别名user_name,SQL 语句是( A ) A. select name AS user_name FROM moershi.user; B. select user_name FROM moershi.user; C. select name = user_name FROM moershi.user; D. select user_name = name FROM moershi.user; -
在
moershi.user表中,查询id字段并去除重复值,使用的关键字是( B ) A. UNIQUE B. DISTINCT C. GROUP BY D. ORDER BY
2 简答题
1. 简述 MySQL 密码管理的重要性以及常见的密码管理操作有哪些?
重要性: 安全性保障:防止未授权访问,保护敏感数据 权限控制:确保只有授权用户才能执行数据库操作 审计追踪:便于跟踪数据库访问和操作记录 合规要求:满足数据安全法规和行业标准
常见的密码管理操作: 设置/修改用户密码:ALTER USER 'username'@'host' IDENTIFIED BY 'new_password'; 密码过期策略:ALTER USER 'username'@'host' PASSWORD EXPIRE; 密码复杂度要求:通过 validate_password 组件设置密码策略 密码加密存储:MySQL 使用加密算法存储密码 重置忘记的密码:通过安全模式启动 MySQL 重置密码 查看用户权限:SHOW GRANTS FOR 'username'@'host';2. 说明 MySQL 服务管理包含哪些方面,以及如何在 Linux 系统下停止和重启 MySQL 服务?
MySQL 服务管理包含的方面: 服务启动和停止 服务状态监控 服务自动启动配置 日志文件管理 配置文件管理 性能调优和监控
### 1. 服务启动和停止- **启动 MySQL 服务**: ```bash systemctl start mysqld # 或使用 service 命令(适用于旧版系统) service mysqld start-
停止 MySQL 服务:
Terminal window systemctl stop mysqldservice mysqld stop -
重启 MySQL 服务(常用于配置更改后):
Terminal window systemctl restart mysqldservice mysqld restart -
重新加载配置(不重启服务):
Terminal window systemctl reload mysqld# 或通过 MySQL 内部命令mysqladmin -u root -p reload
2. 服务状态监控
-
检查服务状态:
Terminal window systemctl status mysqldservice mysqld status -
检查 MySQL 进程是否运行:
Terminal window ps aux | grep mysqld -
检查 MySQL 端口监听(默认 3306):
Terminal window netstat -tlnp | grep 3306# 或使用 ss 命令ss -tlnp | grep 3306 -
检查 MySQL 连接状态(使用 MySQL 客户端):
Terminal window mysqladmin -u root -p status# 或进入 MySQL 后执行SHOW STATUS;SHOW PROCESSLIST;
3. 服务自动启动配置
-
启用开机自动启动:
Terminal window systemctl enable mysqldchkconfig mysqld on # 适用于 SysVinit 系统 -
禁用开机自动启动:
Terminal window systemctl disable mysqldchkconfig mysqld off # 适用于 SysVinit 系统 -
查看自动启动状态:
Terminal window systemctl is-enabled mysqldchkconfig --list mysqld # 适用于 SysVinit 系统
4. 日志文件管理
MySQL 有多种日志类型,如错误日志、查询日志、慢查询日志等。日志位置通常在 /var/log/mysql/ 或 /var/log/ 目录下,具体路径取决于配置文件。
-
查看错误日志:
Terminal window tail -f /var/log/mysql/error.log# 如果路径不同,请检查配置文件 my.cnf 中的 log_error 设置 -
查看通用查询日志:
Terminal window tail -f /var/log/mysql/mysql.log -
查看慢查询日志:
Terminal window tail -f /var/log/mysql/slow.log -
动态启用/禁用日志(需要在 MySQL 配置文件中设置,然后重启或重新加载服务):
-- 在 MySQL 客户端中设置(临时生效)SET GLOBAL general_log = 'ON';SET GLOBAL slow_query_log = 'ON'; -
日志轮转(使用 logrotate): 通常 MySQL 日志由 logrotate 管理,配置文件在
/etc/logrotate.d/mysql。手动轮转:Terminal window logrotate -f /etc/logrotate.d/mysql
5. 配置文件管理
MySQL 配置文件通常是 /etc/my.cnf 或 /etc/mysql/my.cnf,也可能包含在 /etc/mysql/conf.d/ 目录下。
-
编辑配置文件:
Terminal window sudo nano /etc/my.cnf# 或使用其他编辑器 -
检查配置文件语法:
Terminal window mysqld --verbose --help | grep -A1 -B1 "Default options"# 或使用mysqld --validate-config -
应用配置更改:
Terminal window # 重新加载配置(不重启服务)systemctl reload mysqld# 或重启服务systemctl restart mysqld
6. 性能调优和监控
-
监控实时性能:
Terminal window # 使用 mysqladmin 查看状态mysqladmin -u root -p extended-status# 或进入 MySQL 后执行SHOW GLOBAL STATUS;SHOW ENGINE INNODB STATUS; -
检查变量设置:
Terminal window mysql -u root -p -e "SHOW VARIABLES;"# 或特定变量mysql -u root -p -e "SHOW VARIABLES LIKE '%buffer%';" -
性能分析工具:
- mysqltuner:一个常用的脚本,用于分析配置和提供建议。
Terminal window wget https://raw.githubusercontent.com/major/MySQLTuner-perl/master/mysqltuner.plperl mysqltuner.pl --user root --pass - pt-query-digest:分析慢查询日志。
Terminal window pt-query-digest /var/log/mysql/slow.log - mysqlslap:负载测试工具。
Terminal window mysqlslap -u root -p --concurrency=50 --iterations=100 --auto-generate-sql
- mysqltuner:一个常用的脚本,用于分析配置和提供建议。
-
优化表(定期维护):
OPTIMIZE TABLE table_name;# 或使用 mysqlcheckmysqlcheck -u root -p --optimize --all-databases
附加提示
- 确保使用具有适当权限的 MySQL 用户(如 root)执行命令。
- 对于生产环境,建议定期备份和监控。
- 如果使用 Docker 或其他容器化部署,命令可能有所不同。
如果您有特定场景或问题,可以提供更多细节,我可以给出更具体的指导。
#### 3. 请解释 SQL 中的数值比较、范围匹配、模糊匹配、逻辑比较、字符比较/空/非空、别名/去重/合并的概念,并各举一个在 `moershi.user` 表中的应用示例。数值比较:使用比较运算符(=, <>, <, >, <=, >=)比较数值 示例:SELECT * FROM moershi.user WHERE uid > 1000; 范围匹配:使用 BETWEEN 关键字匹配某个范围内的值 示例:SELECT * FROM moershi.user WHERE id BETWEEN 10 AND 20; 模糊匹配:使用 LIKE 关键字和通配符(%, _)进行模式匹配 示例:SELECT * FROM moershi.user WHERE name LIKE ‘a%’; 逻辑比较:使用逻辑运算符(AND, OR, NOT)组合多个条件 示例:SELECT * FROM moershi.user WHERE name = ‘root’ AND uid = 0; 字符比较/空/非空:比较字符串值或检查字段是否为 NULL 字符比较示例:SELECT * FROM moershi.user WHERE name = ‘root’; 空/非空示例:SELECT * FROM moershi.user WHERE homedir IS NOT NULL; 别名/去重/合并: 别名:使用 AS 关键字为列或表指定临时名称 示例:SELECT name AS username, homedir AS home_directory FROM moershi.user; 去重:使用 DISTINCT 关键字去除查询结果中的重复行 示例:SELECT DISTINCT shell FROM moershi.user; 合并:使用 UNION 或 UNION ALL 合并多个查询的结果集 示例:SELECT name FROM moershi.user UNION SELECT dept_name FROM moershi.departments;
### 3 操作题
#### 1.创建一个新的 MySQL 用户 `test_user`,密码为 `test_password`,并授予该用户对 `moershi.user` 表的查询权限。
```sqlmysql> create user if not exists 'test_user'@'%' identified by 'test_password';Query OK, 0 rows affected (0.21 sec)
mysql> GRANT SELECT ON moershi.user TO 'test_user'@'%';Query OK, 0 rows affected (0.16 sec)
mysql> flush privileges;Query OK, 0 rows affected (0.05 sec)2.请编写 SQL 语句,在 moershi.user 表中查询 id 大于 5 且 name 以“r”开头的记录。
mysql> select id,name from moershi.user where id > 5 and name like "r%";+----+---------+| id | name |+----+---------+| 20 | rpc || 21 | rpcuser |+----+---------+2 rows in set (0.00 sec)3.编写 SL 语句,将 moershi.user 表中 id 为 1 的记录的 password 字段更新为 new_password。
mysql> select id,name,password from moershi.user where id =1; --查询原始信息+----+------+----------+| id | name | password |+----+------+----------+| 1 | root | x |+----+------+----------+1 row in set (0.00 sec)
mysql> UPDATE moershi.user SET password = 'new_password' WHERE id = 1; --这个错误表明 password字段的定义长度不足以存储 'new_password'这个值ERROR 1406 (22001): Data too long for column 'password' at row 1
mysql> DESCRIBE moershi.user; --检查表原始结构信息+----------+-------------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+----------+-------------+------+-----+---------+----------------+| id | int | NO | PRI | NULL | auto_increment || name | char(20) | YES | | NULL | || password | char(1) | YES | | NULL | || uid | int | YES | | NULL | || gid | int | YES | | NULL | || comment | varchar(50) | YES | | NULL | || homedir | varchar(80) | YES | | NULL | || shell | char(30) | YES | | NULL | |+----------+-------------+------+-----+---------+----------------+8 rows in set (0.01 sec)
mysql> ALTER TABLE moershi.user MODIFY password VARCHAR(50); --修改password结构大小Query OK, 27 rows affected (2.64 sec)Records: 27 Duplicates: 0 Warnings: 0
mysql> UPDATE moershi.user SET password = 'new_password' WHERE id = 1; --重新修改id=1的password字段Query OK, 1 row affected (0.11 sec)Rows matched: 1 Changed: 1 Warnings: 0
mysql> select id,name,password from moershi.user where id =1; --查看修改后的信息+----+------+--------------+| id | name | password |+----+------+--------------+| 1 | root | new_password |+----+------+--------------+1 row in set (0.00 sec)
mysql>4.编写 SQL 语句,删除 moershi.user 表中 id 小于 3 的记录。
mysql> select * from moershi.user where id < 3;+----+------+--------------+------+------+---------+---------+---------------+| id | name | password | uid | gid | comment | homedir | shell |+----+------+--------------+------+------+---------+---------+---------------+| 1 | root | new_password | 0 | 0 | root | /root | /bin/bash || 2 | bin | x | 1 | 1 | bin | /bin | /sbin/nologin |+----+------+--------------+------+------+---------+---------+---------------+2 rows in set (0.00 sec)
mysql> delete from moershi.user where id < 3;Query OK, 2 rows affected (0.09 sec)
mysql> select * from moershi.user where id < 3;Empty set (0.00 sec)5.编写 SQL 语句,将 moershi.user 表按照 id 字段降序排序,并取前 5 条记录。
mysql>mysql> select * from moershi.user order by id desc; --降序全部+----+-----------------+----------+-------+-------+----------------------------+--------------------+----------------+| id | name | password | uid | gid | comment | homedir | shell |+----+-----------------+----------+-------+-------+----------------------------+--------------------+----------------+| 27 | bob | NULL | NULL | NULL | NULL | NULL | NULL || 26 | mysql | x | 27 | 27 | MySQL Server | /var/lib/mysql | /bin/false || 25 | apache | x | 48 | 48 | Apache | /usr/share/httpd | /sbin/nologin || 24 | plj | x | 1000 | 1000 | | /home/plj | /bin/bash || 23 | haproxy | x | 188 | 188 | haproxy | /var/lib/haproxy | /sbin/nologin || 22 | nfsnobody | x | 65534 | 65534 | Anonymous NFS User | /var/lib/nfs | /sbin/nologin || 21 | rpcuser | x | 29 | 29 | RPC Service User | /var/lib/nfs | /sbin/nologin || 20 | rpc | x | 32 | 32 | Rpcbind Daemon | /var/lib/rpcbind | /sbin/nologin || 19 | chrony | x | 998 | 996 | | /var/lib/chrony | /sbin/nologin || 18 | postfix | x | 89 | 89 | | /var/spool/postfix | /sbin/nologin || 17 | sshd | x | 74 | 74 | Privilege-separated SSH | /var/empty/sshd | /sbin/nologin || 16 | polkitd | x | 999 | 998 | User for polkitd | / | /sbin/nologin || 15 | dbus | x | 81 | 81 | System message bus | / | /sbin/nologin || 14 | systemd-network | x | 192 | 192 | systemd Network Management | / | /sbin/nologin || 13 | nobody | x | 99 | 99 | Nobody | / | /sbin/nologin || 12 | ftp | x | 14 | 50 | FTP User | /var/ftp | /sbin/nologin || 11 | games | x | 12 | 100 | games | /usr/games | /sbin/nologin || 10 | operator | x | 11 | 0 | operator | /root | /sbin/nologin || 9 | mail | x | 8 | 12 | mail | /var/spool/mail | /sbin/nologin || 8 | halt | x | 7 | 0 | halt | /sbin | /sbin/halt || 7 | shutdown | x | 6 | 0 | shutdown | /sbin | /sbin/shutdown || 6 | sync | x | 5 | 0 | sync | /sbin | /bin/sync || 5 | lp | x | 4 | 7 | lp | /var/spool/lpd | /sbin/nologin || 4 | adm | x | 3 | 4 | adm | /var/adm | /sbin/nologin || 3 | daemon | x | 2 | 2 | daemon | /sbin | /sbin/nologin |+----+-----------------+----------+-------+-------+----------------------------+--------------------+----------------+25 rows in set (0.00 sec)
mysql> select * from moershi.user order by id desc limit 5; --提取降序后的前5+----+---------+----------+------+------+--------------+------------------+---------------+| id | name | password | uid | gid | comment | homedir | shell |+----+---------+----------+------+------+--------------+------------------+---------------+| 27 | bob | NULL | NULL | NULL | NULL | NULL | NULL || 26 | mysql | x | 27 | 27 | MySQL Server | /var/lib/mysql | /bin/false || 25 | apache | x | 48 | 48 | Apache | /usr/share/httpd | /sbin/nologin || 24 | plj | x | 1000 | 1000 | | /home/plj | /bin/bash || 23 | haproxy | x | 188 | 188 | haproxy | /var/lib/haproxy | /sbin/nologin |+----+---------+----------+------+------+--------------+------------------+---------------+5 rows in set (0.00 sec)02:mysql之常用函数
今日工作任务路线图
flowchart LR subgraph BottomRow[常用函数] direction LR A[字符串函数] --> B[日期函数] --> C[聚集函数] --> D[数学计算] --> E[if函数] --> F[case函数] end一、工作场景
在电商公司的运营部门,为了评估商品销售情况,需要对数据库中的销售数据进行分析。数据库使用 MySQL 存储订单信息。运营人员需要统计不同商品类别的总销售额、平均销售单价和最高销售单价。
他们使用 MySQL 的聚合函数,SUM() 计算每个商品类别的总销售额,AVG() 求平均销售单价,MAX() 获取最高销售单价。为了筛选出近期一个月内的有效订单,使用 DATE_SUB() 函数确定时间范围。通过 GROUP BY 对商品类别分组,将不同类别的数据区分开。最后,利用这些统计结果,运营人员制定针对性的营销策略,以提高销售额和利润。
二、为什么学mysql的函数
学习 MySQL 函数是提升数据库操作能力和数据处理效率的关键。在日常数据处理中,我们需要对数据进行各种计算、转换和筛选,而 MySQL 函数可以帮助我们轻松完成这些任务。
例如,在统计销售数据时,我们可以使用聚合函数计算总销售额、平均价格等;在处理日期数据时,日期和时间函数能让我们方便地进行日期计算和格式化。掌握 MySQL 函数还能优化查询性能,通过合理运用函数,减少不必要的数据传输和处理,提高数据库的响应速度。此外,函数的使用还能使 SQL 语句更加简洁和易读,提升我们的工作效率和代码质量。
三、字符串函数
当前任务环节
flowchart LR subgraph BottomRow[常用函数] direction LR A[字符串函数] --> B[日期函数] --> C[聚集函数] --> D[数学计算] --> E[if函数] --> F[case函数] end
classDef highlight stroke:#f00,stroke-width:2px; class A highlight;3.1、返回字符串长度
LENGTH(str) 函数
| 项目 | 说明 |
|---|---|
| 函数名称 | LENGTH【冷斯】 (在某些数据库中也称为 LEN) |
| 功能说明 | 返回字符串的长度。注意:在大多数数据库中,此函数返回的是字符串的字节数,而非字符数,这在处理多字节字符集(如UTF-8)时至关重要。 |
| 语法 | LENGTH【冷斯】(string) |
| 参数 | string: 需要计算长度的字符串。可以是字符串字面量(如'ABC')、字段名或变量。 |
| 返回值 | 一个整数值,表示字符串的字节数。如果参数为 NULL,则返回 NULL。 |
| 示例 | 1. SELECT【涩莱克特】 LENGTH【冷斯】('Hello'); -> 5 (5个英文字符,在UTF-8中每个占1字节)2. SELECT【涩莱克特】 LENGTH【冷斯】('你好'); -> 6 (2个中文字符,在UTF-8中每个占3字节,共6字节)3. SELECT【涩莱克特】 LENGTH(column_name) from【弗乱】 table_name; -> 返回表中该字段各值的字节长度 |
| 注意要点 | 1. 字节 vs. 字符: - 这是最关键的区别。如果需要获取字符数(通常更符合直觉),应使用 CHAR_LENGTH【查_冷斯】() 或 CHARACTER_LENGTH【冷斯】() 函数。2. 数据库差异: - MySQL, MariaDB: LENGTH【冷斯】() 返回字节数,CHAR_LENGTH【查_冷斯】() 返回字符数。- SQL Server: 使用 LEN() 返回字符数(但会去掉尾部空格),使用 DATALENGTH【得塔-冷斯】() 返回字节数。- Oracle: 使用 LENGTHB() 返回字节数,LENGTH【冷斯】() 返回字符数。- PostgreSQL: LENGTH() 返回字符数,使用 OCTET_LENGTH() 返回字节数。- SQLite: LENGTH() 返回字符数。3. 空字符串: LENGTH('') 返回 0。4. NULL 值: LENGTH(NULL) 返回 NULL。 |
| 使用建议 | 在不确定数据库字符集或需要处理多语言文本时,强烈建议使用 CHAR_LENGTH【查_冷斯】】() 来获取字符数,以避免因字符编码不同导致的意外结果。LENGTH【冷斯】() 更适用于计算存储空间等需要字节精度的场景。 |
LENGTH vs. CHAR_LENGTH
| 函数 | 测量单位 | UTF-8 示例 LENGTH【冷斯】('你好') | 适用场景 |
|---|---|---|---|
LENGTH【冷斯】(str) | 字节 | 6 (2字符 * 3字节/字符) | 计算存储占用、网络传输大小 |
CHAR_LENGTH【查_冷斯】(str) | 字符 | 2 | 计算字符串的实际字符数量、显示长度、业务逻辑 |
LENGTH(str)
--LENGTH【冷斯】(str) 返字符串长度,以字节为单位mysql> select【涩莱克特】 name from【弗乱】 moershi.user where【威尔】 name = "root" ;+------+| name |+------+| root |+------+1 row in set (0.00 sec)mysql> select【涩莱克特】 name,length【冷斯】(name) as 字节个数 from moershi.user where【威尔】 name = "root" ;+------+--------------+| name | 字节个数 |+------+--------------+| root | 4 |+------+--------------+1 row in set (0.00 sec)
--一个汉字3个字节mysql> select【涩莱克特】 name,length【冷斯】(name) from【弗乱】 moershi.employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id = 3 ;+-----------+--------------+| name | length【冷斯】(name) |+-----------+--------------+| 李玉英 | 9 |+-----------+--------------+CHAR_LENGTH(str)
-- CHAR_LENGTH【查_冷斯】(str) 返回字符串长度,以字符为单位mysql> select【涩莱克特】 name from【弗乱】 moershi.employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id = 3 ;+-----------+| name |+-----------+| 李玉英 |+-----------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 name,char_length【查_冷斯】(name) from【弗乱】 moershi.employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id = 3 ;+-----------+-----------------------------+| name | char_length【查_冷斯】(name) |+-----------+-----------------------------+| 李玉英 | 3 |+-----------+-----------------------------+1 row in set (0.00 sec)3.2、将字符串转换为大写
函数概览
UPPER【阿普厄】(str) 和 UCASE【U kèi 斯】(str) 函数的功能完全相同,都是将字符串 str 中的所有字母字符转换为大写形式。它们互为同义词,区别仅在于函数名称,以适应不同用户的习惯。
| 项目 | 说明 |
|---|---|
| 函数名称 | UPPER【阿普厄】(str), UCASE【U kèi 斯】(str) |
| 功能描述 | 将字符串 str 中的所有字母字符转换为大写形式。非字母字符(如数字、空格、特殊符号)保持不变。 |
| 通用语法 | UPPER【阿普厄】(string【斯jǘn】) UCASE【U kèi 斯】(string【斯jǘn】) |
| 参数 | string【斯jǘn】: 需要转换的字符串。可以是字符串字面量(如 'abc')、字段名或变量。 |
| 返回值 | 一个新的字符串,其中所有小写字母已被转换为大写字母。如果参数为 NULL,则返回 NULL`。 |
基本用法
mysql> SELECT【涩莱克特】 UPPER【阿普厄】('Hello World!') AS UpperText;-- 结果: 'HELLO WORLD!'
mysql> SELECT【涩莱克特】 UCASE【U kèi 斯】('sql is fun') AS UpperText;-- 结果: 'SQL IS FUN'总结与对比
| 特性 | UPPER【阿普厄】(str) | UCASE【U kèi 斯】(str) |
|---|---|---|
| 功能 | 将字符串转换为大写 | 将字符串转换为大写 |
| 标准性 | SQL 标准 | 非标准,但广泛实现 |
| 通用性 | 极高,所有SQL数据库都支持 | 很高,但并非所有数据库都支持(如Oracle不支持UCASE【U kèi 斯】) |
| 推荐度 | ⭐️⭐️⭐️⭐️⭐️ (首选) | ⭐️⭐️⭐️⭐️ |
-- UPPER【阿普厄】(str)和UCASE【U kèi 斯】(str) 将字符串中的字母全部转换成大写mysql> select【涩莱克特】 name from【弗乱】 moershi.user where【威尔】 uid <= 3 ;+--------+| name |+--------+| root || bin || daemon || adm |+--------+4 rows in set (0.00 sec)
mysql> select【涩莱克特】 upper【阿普厄】(name) from【弗乱】 moershi.user where【威尔】 uid <= 3 ;+-------------+| upper【阿普厄】(name) |+-------------+| ROOT || BIN || DAEMON || ADM |+-------------+4 rows in set (0.00 sec)
mysql> select【涩莱克特】 ucase【U kèi 斯】(name) from【弗乱】 moershi.user where【威尔】 uid <= 3 ;+-------------+| ucase【U kèi 斯】(name) |+-------------+| ROOT || BIN || DAEMON || ADM |+-------------+4 rows in set (0.00 sec)3.3、将字符串转换成小写
好的,这是关于 SQL 中 LOWER【喽厄】() 和 LCASE【L kèi 斯】() 函数的详细说明。
函数概览
LOWER【喽厄】(str) 和 LCASE【L kèi 斯】(str) 函数的功能完全相同,都是将字符串 str 中的所有字母字符转换为小写形式。它们互为同义词,区别仅在于函数名称。
| 项目 | 说明 |
|---|---|
| 函数名称 | LOWER【喽厄】(str), LCASE【L kèi 斯】(str) |
| 功能描述 | 将字符串 str 中的所有字母字符转换为小写形式。非字母字符(如数字、空格、特殊符号)保持不变。 |
| 通用语法 | LOWER【喽厄】(string【斯jǘn】) LCASE【L kèi 斯】(string【斯jǘn】) |
| 参数 | string【斯jǘn】: 需要转换的字符串。可以是字符串字面量(如 'ABC')、字段名或变量。 |
| 返回值 | 一个新的字符串,其中所有大写字母已被转换为小写字母。如果参数为 NULL,则返回 NULL。 |
基本用法与示例
1. 直接转换文本字符串
mysql> SELECT LOWER【喽厄】('HELLO World! 123') AS LowerText;+------------------+| LowerText |+------------------+| hello world! 123 |+------------------+1 row in set (0.00 sec)
-- 结果: 'hello world! 123'
mysql> SELECT LCASE【L kèi 斯】('SQL Tutorial') AS LowerText;+--------------+| LowerText |+--------------+| sql tutorial |+--------------+1 row in set (0.00 sec)
-- 结果: 'sql tutorial'3. 在 WHERE 子句中实现不区分大小写的比较或搜索
这是该函数最常用和实用的场景之一。
-- 查找类别为 'electronics' 的所有产品,不区分大小写mysql> SELECT * FROM products WHERE LOWER【喽厄】(category) = 'electronics';
-- 在模糊查询中实现不区分大小写mysql> SELECT * FROM users WHERE LOWER【喽厄】(email) LIKE '%@gmail.com';4. 与 UPPER/UCASE 结合使用进行数据标准化
-- 将用户输入的用户名统一格式化为小写后存储,确保唯一性mysql> UPDATE【阿普dei 特】 users SET username = LOWER【喽厄】('SomeUserName') WHERE id = 100;总结与对比
| 特性 | LOWER【喽厄】(str) | LCASE【L kèi 斯】(str) |
|---|---|---|
| 功能 | 将字符串转换为小写 | 将字符串转换为小写 |
| 标准性 | SQL 标准 | 非标准,但广泛实现 |
| 通用性 | 极高,所有主流SQL数据库都支持 | 很高,但并非所有数据库都支持(如 Oracle 不支持 LCASE【L kèi 斯】) |
| 推荐度 | ⭐️⭐️⭐️⭐️⭐️ (首选) | ⭐️⭐️⭐️⭐️ |
核心结论与最佳实践
- 功能完全相同:
LOWER【喽厄】()和LCASE【L kèi 斯】()的功能完全一致,选择哪一个通常取决于个人习惯。 - 首选
LOWER【喽厄】():LOWER【喽厄】()是 SQL 标准中定义的函数,因此具有最广泛的数据库支持(包括 Oracle)。为了代码的最大兼容性、可读性和可移植性,应优先使用LOWER【喽厄】()。 - 主要应用场景:
- 数据比较:在
WHERE子句中进行不区分大小写的比较。 - 数据搜索:实现不区分大小写的搜索 (
LIKE)。 - 数据标准化:在存储或显示前将文本统一为小写格式。
- 数据比较:在
- 注意 NULL:如果输入参数为
NULL,输出结果也为NULL。
-- LOWER【喽厄】(str)和LCASE【L kèi 斯】(str) 将str中的字母全部转换成小写mysql> select【涩莱克特】 lower【喽厄】("ABCD") ;+---------------+| lower【喽厄】("ABCD") |+---------------+| abcd |+---------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 lcase【L kèi 斯】("ABCD") ;+---------------+| lcase【L kèi 斯】("ABCD") |+---------------+| abcd |+---------------+1 row in set (0.00 sec)mysql>3.4、从字符串中提取子串
substr【杀斯妥】
函数概览
SUBSTR【杀斯妥】() 函数用于从字符串中提取子串。它是 SQL 中最重要和常用的字符串函数之一。
| 项目 | 说明 |
|---|---|
| 函数名称 | SUBSTR【杀斯妥】(string【斯jǘn】, start, length) |
| 别名 | SUBSTRING【杀斯jǘn】() (功能完全相同,SUBSTR【杀斯妥】 更常见) |
| 功能描述 | 从原字符串中返回一个从指定位置开始、具有指定长度的子字符串。 |
| 通用语法 | SUBSTR【杀斯妥】(string【斯jǘn】, start [, length]) |
| 参数 | 1. string【斯jǘn】:必需的。要提取子串的源字符串。2. start:必需的。开始位置。重要:起始位置通常为 1,而不是 0。 3. length:可选的。要提取的字符数。如果省略,则返回从 start 开始到字符串结尾的所有字符。 |
| 返回值 | 提取出的子字符串。如果任何参数为 NULL,则返回 NULL。 |
基本用法与示例
1. 指定起始位置和长度
这是最常用的形式。
mysql> SELECT SUBSTR【杀斯妥】('SQL Tutorial', 1, 3) AS ExtractString;+---------------+| ExtractString |+---------------+| SQL |+---------------+1 row in set (0.02 sec)-- 结果: 'SQL' (从第1个字符开始,取3个字符)
mysql> SELECT SUBSTR【杀斯妥】('SQL Tutorial', 5, 4) AS ExtractString;+---------------+| ExtractString |+---------------+| Tuto |+---------------+1 row in set (0.00 sec)-- 结果: 'Tuto' (从第5个字符('T')开始,取4个字符)2. 省略长度参数(提取到末尾)
如果省略第三个参数,函数将返回从起始位置到字符串末尾的所有字符。
mysql> SELECT SUBSTR【杀斯妥】('SQL Tutorial', 5) AS ExtractString;+---------------+| ExtractString |+---------------+| Tutorial |+---------------+1 row in set (0.00 sec)-- 结果: 'Tutorial' (从第5个字符开始,直到结束)3. 使用负起始位置(从末尾开始计数)
这是一个非常实用的功能。许多数据库(如 MySQL、PostgreSQL、SQLite)支持使用负数作为 start 参数,表示从字符串末尾开始向前计数。
-- 提取最后 3 个字符mysql> SELECT SUBSTR【杀斯妥】('SQL Tutorial', -3) AS ExtractString;+---------------+| ExtractString |+---------------+| ial |+---------------+1 row in set (0.00 sec)-- 结果: 'ial'
-- 从倒数第 6 个字符开始,提取 4 个字符mysql> SELECT SUBSTR【杀斯妥】('SQL Tutorial', -6, 4) AS ExtractString;+---------------+| ExtractString |+---------------+| tori |+---------------+1 row in set (0.00 sec)-- 结果: 'ori' (从倒数第6位('o')开始,取4个字符。但后面只剩3个,所以只返回'ori')注意:SQL Server 不支持负起始位置,需配合 LEN() 函数计算。
4. 在查询中处理表字段数据
-- 提取每个人的姓氏(假设从第6个字符开始)mysql> SELECT full_name, SUBSTR【杀斯妥】(full_name, 6) AS last_name FROM employees【ing普洛伊s】;总结与对比:SUBSTR【杀斯妥】 vs. SUBSTRING【杀斯jǘn】
| 特性 | SUBSTR【杀斯妥】(…) | SUBSTRING【杀斯jǘn】(…) |
|---|---|---|
| 功能 | 从字符串中提取子串 | 从字符串中提取子串 |
| 普及度 | 非常普遍,是许多数据库中的主要函数名 | 也很常见,是 SQL 标准名称 |
| 语法 | SUBSTR【杀斯妥】(str, start, length) | SUBSTRING【杀斯jǘn】(str FROM start FOR length) (标准语法) 或 SUBSTRING(str, start, length) |
| 数据库支持 | MySQL, Oracle, SQLite, PostgreSQL, MariaDB | SQL Server, PostgreSQL, MySQL (也支持SUBSTR) |
| 推荐度 | ⭐️⭐️⭐️⭐️⭐️ (通用性极佳) | ⭐️⭐️⭐️⭐️ (是标准,但需注意数据库方言) |
不同数据库的注意事项
| 数据库 | 主要函数 | 负起始位置 | 备注 |
|---|---|---|---|
| MySQL, MariaDB | SUBSTR【杀斯妥】() 或 SUBSTRING【杀斯jǘn】() | 支持 | 两者完全同义。 |
| Oracle | SUBSTR【杀斯妥】() | 支持 | 不支持 SUBSTRING【杀斯jǘn】。 |
| SQL Server | SUBSTRING【杀斯jǘn】() | 不支持 | 需用 LEN(string【斯jǘn】) + 1 - n 来计算从末尾开始的位置。 |
| PostgreSQL | SUBSTRING【杀斯jǘn】() (标准) 或 SUBSTR【杀斯妥】() | 支持 | 两者都可用。 |
| SQLite | SUBSTR【杀斯妥】() | 支持 |
核心结论与最佳实践
- 功能核心:
SUBSTR【杀斯妥】(str, start, length)用于精确提取字符串的特定部分。 - 起始索引:牢记起始位置通常是 1,这是与许多编程语言(如 Python、Java)从 0 开始索引的最大区别。
- 负索引:负起始位置是一个非常有用的特性,可以轻松地从字符串末尾开始操作,但要注意 SQL Server 不支持。
- 兼容性建议:
- 如果你主要在 MySQL、Oracle、SQLite 中工作,可以放心使用
SUBSTR【杀斯妥】()。 - 如果你在 SQL Server 中工作,则必须使用
SUBSTRING【杀斯jǘn】()。 - 为了编写跨数据库兼容的 SQL,了解这些差异至关重要。在不确定时,查看数据库的官方文档是最好的方法。
- 如果你主要在 MySQL、Oracle、SQLite 中工作,可以放心使用
- 常见用途:提取区号、获取文件扩展名、隐藏部分敏感信息(如
SUBSTR【杀斯妥】(phone_number, -4)显示手机尾号)、解析固定格式的代码等。
--SUBSTR【杀斯妥】(s, start,end) 从s的start位置开始取出到end长度的子串mysql> select【涩莱克特】 name from【弗乱】 moershi.employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 3 ;+-----------+| name |+-----------+| 梁伟 || 郭岩 || 李玉英 |+-----------+3 rows in set (0.00 sec)--不是输出员工的姓 只输出名字(只输出第2、3个字符)mysql> select【涩莱克特】 substr(name,2,3) from【弗乱】 moershi.employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 3 ;+------------------+| substr(name,2,3) |+------------------+| 伟 || 岩 || 玉英 |+------------------+3 rows in set (0.00 sec)3.5、在一个字符串中查找另一个子字符串
函数概览
INSTR() 函数用于在一个字符串中查找另一个子字符串,并返回其首次出现的位置。如果未找到,则返回 0。它是一个非常重要的字符串查找函数。
| 项目 | 说明 |
|---|---|
| 函数名称 | INSTR(string【斯jǘn】, substring【杀斯jǘn】) |
| 别名 | LOCATE() (在MySQL中), CHARINDEX() (在SQL Server中) |
| 功能描述 | 返回子字符串 substring【杀斯jǘn】 在字符串 string【斯jǘn】 中第一次出现的起始位置。 |
| 通用语法 | INSTR(string【斯jǘn】, substring【杀斯jǘn】) |
| 扩展语法 | 某些数据库(如Oracle、MySQL)支持可选参数来指定起始搜索位置和出现次数:INSTR(string【斯jǘn】, substring【杀斯jǘn】 [, start [, occurrence]]) |
| 参数 | 1. string【斯jǘn】:必需的。被搜索的源字符串。2. substring【杀斯jǘn】:必需的。要查找的子字符串。3. start:可选的。开始搜索的位置,默认为 1。4. occurrence:可选的。指定要查找第几次出现的位置,默认为 1。 |
| 返回值 | 一个整数值,表示子串首次出现的起始位置。 位置从 1 开始计数。 如果未找到子串,则返回 0。 如果任何参数为 NULL,则返回 NULL。 |
基本用法与示例
为了演示,我们使用字符串 'Hello World! Welcome to the World of SQL.' 作为示例源字符串。
1. 基本查找:查找子串首次出现的位置
mysql> SELECT INSTR('Hello World!', 'World') AS Position;+----------+| Position |+----------+| 7 |+----------+1 row in set (0.00 sec)
-- 结果: 7 (因为 'W' 是源字符串的第7个字符)-- 分解: H e l l o [空格] W o r l d !-- 位置: 1 2 3 4 5 6 7 8 9 10 11 122. 查找不存在的子串
mysql> SELECT INSTR('Hello World!', 'SQL') AS Position;+----------+| Position |+----------+| 0 |+----------+1 row in set (0.00 sec)-- 结果: 0 (因为 'SQL' 没有出现)3. 在查询中处理表字段数据
-- 找到所有产品代码中连字符 '-' 的位置mysql> SELECT product_code, INSTR(product_code, '-') AS hyphen_position FROM products;4. 与其他函数组合使用(常与 SUBSTR 搭配)
一个非常强大的组合是先用 INSTR 定位,再用 SUBSTR 截取。
-- 提取产品代码中连字符之后的部分(型号)mysql> SELECT product_code,SUBSTR(product_code, INSTR(product_code, '-') + 1) AS model_number FROM products;结果:
| product_code | model_number |
|---|---|
| LAPTOP-001 | 001 |
| MOUSE-002 | 002 |
| KEYBOARD-003 | 003 |
逻辑:先找到 - 的位置 (N),然后从 N+1 的位置开始截取到末尾。
总结与对比:INSTR vs. 其他类似函数
| 特性 | INSTR(string【斯jǘn】, substring【杀斯jǘn】) | LOCATE (MySQL) | CHARINDEX (SQL Server) | POSITION (标准SQL) |
|---|---|---|---|---|
| 语法 | INSTR(str, substr) | LOCATE(substr, str [, start]) | CHARINDEX(substr, str [, start]) | POSITION(substr IN str) |
| 参数顺序 | (字符串, 子串) | (子串, 字符串) | (子串, 字符串) | (子串 IN 字符串) |
| 起始位置 | 可选第三参数 start | 可选第三参数 start | 可选第三参数 start | 不支持 |
| 出现次数 | 可选第四参数 occurrence (Oracle/MySQL) | 不支持 | 不支持 | 不支持 |
| 返回值 | 位置 (从1开始) / 0 | 位置 (从1开始) / 0 | 位置 (从1开始) / 0 | 位置 (从1开始) / 0 |
不同数据库的注意事项与语法
| 数据库 | 主要函数 | 语法示例 | 备注 |
|---|---|---|---|
| Oracle | INSTR | INSTR('abc', 'b') | 支持扩展参数 (start, occurrence) |
| MySQL | INSTR 或 LOCATE | INSTR('abc', 'b') 或 LOCATE('b', 'abc') | INSTR 支持扩展参数,LOCATE 支持 start |
| SQL Server | CHARINDEX | CHARINDEX('b', 'abc') | 不支持 occurrence 参数 |
| PostgreSQL | STRPOS 或 POSITION | STRPOS('abc', 'b') 或 POSITION('b' IN 'abc') | POSITION 是标准SQL语法 |
| SQLite | INSTR | INSTR('abc', 'b') | 只支持两个基本参数 |
核心结论与最佳实践
- 功能核心:
INSTR用于定位,而不是提取。它返回的是数字位置。 - 黄金搭档:
INSTR常与SUBSTR组合使用,实现“先定位,后截取”的强大功能。 - 参数顺序陷阱:不同数据库的参数顺序可能不同(特别是
INSTR和CHARINDEX/LOCATE)。这是最大的混淆点,使用时务必注意。 - 兼容性建议:
- 如果你主要在 Oracle、SQLite 中工作,使用
INSTR。 - 如果你在 MySQL 中工作,
INSTR和LOCATE都可以,但注意参数顺序。 - 如果你在 SQL Server 中工作,必须使用
CHARINDEX。 - 为了编写符合SQL标准的代码,可以使用
POSITION(substr IN str),但功能可能最基础。
- 如果你主要在 Oracle、SQLite 中工作,使用
- 常见用途:查找特定字符或关键字的位置、解析结构化字符串(如URL、代码)、验证字符串中是否包含某部分内容(结果>0即表示包含)。
-- INSTR(str,str1) 返回str1参数,在str参数内的位置mysql> select【涩莱克特】 name from【弗乱】 moershi.user where【威尔】 uid <= 3 ;+--------+| name |+--------+| root || bin || daemon || adm |+--------+4 rows in set (0.00 sec)
--查找名字里有a及出现的位置mysql> select【涩莱克特】 name,instr(name,"a") from【弗乱】 moershi.user where【威尔】 uid <= 3 ;+--------+-----------------+| name | instr(name,"a") |+--------+-----------------+| root | 0 || bin | 0 || daemon | 2 || adm | 1 |+--------+-----------------+4 rows in set (0.00 sec)
-- 查找名字里有英字及出现的位置mysql> select【涩莱克特】 name , instr(name,"英") from【弗乱】 moershi.employees【ing普洛伊s】;+-----------+-------------------+| name | instr(name,"英") |+-----------+-------------------+| 梁伟 | 0 || 郭岩 | 0 || 李玉英 | 3 || 张健 | 0 || 郑静 | 0 || 牛建军 | 0 || 刘斌 | 0 || 汪云 | 0 || 张建平 | 0 || 郭娟 | 0 || 郭兰英 | 3 || 王英 | 2 |3.6、移除字符串开头和/或结尾处的指定字符
函数概览
TRIM【垂姆】() 函数用于移除字符串开头和/或结尾处的指定字符(默认为空格)。它是数据清洗和标准化中最重要、最常用的函数之一。
| 项目 | 说明 |
|---|---|
| 函数名称 | TRIM【垂姆】(...) |
| 功能描述 | 从字符串的两端(开头和结尾)移除指定的前缀和后缀字符(默认为空格)。 |
| 标准语法 | TRIM【垂姆】([removal_spec] [remove_char] FROM string【斯jǘn】) |
| 简化语法 | TRIM【垂姆】(string【斯jǘn】) |
| 参数 | 1. string【斯jǘn】:必需的。要处理的源字符串。2. removal_spec:可选的。指定移除位置:- LEADING:只移除开头的字符。- TRAILING:只移除结尾的字符。- BOTH:移除开头和结尾的字符(默认行为)。3. remove_char:可选的。指定要移除的字符,默认为空格 ' '。 |
| 返回值 | 一个新的字符串,已移除指定位置上的指定字符。如果参数为 NULL,则返回 NULL。 |
基本用法与示例
基本语法说明
TRIM([{BOTH | LEADING | TRAILING} [remstr] FROM] str)
> BOTH:移除字符串开头和结尾的字符(默认选项)。> LEADING:仅移除字符串开头的字符。> TRAILING:仅移除字符串结尾的字符。> remstr:要移除的字符(或字符串)。如果省略,默认移除空格。> str:要处理的原始字符串。1. 基本用法:移除首尾空格(最常见用途)
这是最常用的情况,因此几乎所有数据库都支持最简形式。
mysql> SELECT TRIM【垂姆】(' Hello World ') AS TrimmedString;+---------------+| TrimmedString |+---------------+| Hello World |+---------------+1 row in set (0.00 sec)-- 结果: 'Hello World' (首尾空格被移除,中间空格保留)
-- 等效于标准写法的默认行为mysql> SELECT TRIM【垂姆】(BOTH ' ' FROM ' Hello World ') AS TrimmedString;+---------------+| TrimmedString |+---------------+| Hello World |+---------------+1 row in set (0.00 sec)-- 结果: 'Hello World'2. 指定移除位置 (LEADING / TRAILING / BOTH)
-- 只移除开头的空格 (LTRIM 的功能)mysql> SELECT TRIM【垂姆】(LEADING FROM ' Hello World ') AS LeadingTrimmed;+----------------+| LeadingTrimmed |+----------------+| Hello World |+----------------+1 row in set (0.00 sec)-- 结果: 'Hello World '
-- 只移除结尾的空格 (RTRIM 的功能)mysql> SELECT TRIM【垂姆】(TRAILING FROM ' Hello World ') AS TrailingTrimmed;+-----------------+| TrailingTrimmed |+-----------------+| Hello World |+-----------------+1 row in set (0.00 sec)-- 结果: ' Hello World'
-- 明确指定移除两端 (BOTH 是默认值,可省略)mysql> SELECT TRIM【垂姆】(BOTH FROM ' Hello World ') AS BothTrimmed;+-------------+| BothTrimmed |+-------------+| Hello World |+-------------+1 row in set (0.00 sec)-- 结果: 'Hello World'3. 移除指定字符(不仅仅是空格)
这是一个非常强大的功能,可以移除任何指定的字符。
-- 移除首尾的 'x'mysql> SELECT TRIM【垂姆】('x' FROM 'xxHello Worldxx') AS TrimmedString;+---------------+| TrimmedString |+---------------+| Hello World |+---------------+1 row in set (0.00 sec)-- 结果: 'Hello World'
-- 移除首尾的连字符 '-'mysql> SELECT TRIM【垂姆】('-' FROM '--SQL-') AS TrimmedString;+---------------+| TrimmedString |+---------------+| SQL |+---------------+1 row in set (0.00 sec)-- 结果: 'SQL'
-- 组合使用:只移除开头的 '0'mysql> SELECT TRIM【垂姆】(LEADING '0' FROM '0001234500') AS TrimmedString;+---------------+| TrimmedString |+---------------+| 1234500 |+---------------+1 row in set (0.00 sec)-- 结果: '1234500' (开头的0被移除,结尾的0保留)
-- 组合使用:只移除结尾的逗号 ','mysql> SELECT TRIM【垂姆】(TRAILING ',' FROM 'value1,value2,value3,,,') AS TrimmedString;+----------------------+| TrimmedString |+----------------------+| value1,value2,value3 |+----------------------+1 row in set (0.00 sec)-- 结果: 'value1,value2,value3'4. 在查询中处理表字段数据(数据清洗)
假设有一个 users 表,由于数据导入问题,name 字段可能包含多余空格:
| id | name |
|---|---|
| 1 | ’ John Doe ‘ |
| 2 | ’Alice ’ |
-- 清理并显示姓名mysql> SELECT id, name, TRIM【垂姆】(name) AS cleaned_name FROM users;结果:
| id | name | cleaned_name |
|---|---|---|
| 1 | ’ John Doe ' | 'John Doe’ |
| 2 | ’Alice ' | 'Alice’ |
-- 在 WHERE 子句中使用,确保比较的准确性mysql> SELECT * FROM products WHERE TRIM【垂姆】(product_code) = 'ABC123';-- 即使数据库中存的是 ' ABC123 ' 也能匹配总结与对比:TRIM【垂姆】 vs. LTRIM/RTRIM
| 特性 | TRIM【垂姆】() | LTRIM() / RTRIM() |
|---|---|---|
| 功能 | 可灵活移除首、尾或两端的指定字符 | LTRIM() 只移除开头的空格/字符RTRIM() 只移除结尾的空格/字符 |
| 灵活性 | 高。通过参数配置功能 | 低。功能单一,每个函数只做一件事 |
| 符合标准 | 是 ANSI SQL 标准 | 不是标准,但被广泛实现 |
| 移除指定字符 | 支持。可移除任意指定字符 | 在多数数据库中仅支持空格,或语法有所不同 |
| 推荐度 | ⭐️⭐️⭐️⭐️⭐️ (首选) | ⭐️⭐️⭐️ (用于简单场景或兼容旧代码) |
TRIM【垂姆】() 与 LTRIM()/RTRIM() 的等效操作
-- 移除开头空格:mysql> TRIM【垂姆】(LEADING FROM ' abc ') -- 结果: 'abc 'mysql> LTRIM(' abc ') -- 结果: 'abc '
-- 移除结尾空格:mysql> TRIM【垂姆】(TRAILING FROM ' abc ') -- 结果: ' abc'mysql> RTRIM(' abc ') -- 结果: ' abc'
-- 移除两端空格:mysql> TRIM【垂姆】(' abc ') -- 结果: 'abc'-- 等效组合:mysql> LTRIM(RTRIM(' abc ')) -- 结果: 'abc'不同数据库的注意事项
| 数据库 | TRIM【垂姆】() 支持程度 | 备注 |
|---|---|---|
| MySQL, MariaDB | 完全支持 | 支持标准语法和简化语法 |
| PostgreSQL | 完全支持 | 支持标准语法和简化语法 |
| SQL Server | 支持 (2017及以上版本) | 2017版本之前需使用 LTRIM(RTRIM()) |
| Oracle | 完全支持 | 支持标准语法和简化语法 |
| SQLite | 支持 | 支持简化语法 TRIM【垂姆】(string【斯jǘn】),但从3.38版本开始支持标准语法 |
核心结论与最佳实践
- 功能核心:
TRIM【垂姆】()用于清理字符串边界的无关字符,最常用于移除空格。 - 现代首选:对于新的项目,应优先使用功能更强大、更符合标准的
TRIM【垂姆】()函数,而不是LTRIM()和RTRIM()。 - 数据清洗:在数据导入、数据验证和查询比较前,使用
TRIM【垂姆】()清理用户输入或外部数据至关重要,可以避免因首尾空格导致的匹配失败。 - 灵活运用:记住它可以移除任何指定字符(如
0,-,,),而不仅仅是空格,这在处理固定格式的代码、数字字符串时非常有用。 - 兼容性:虽然是最新标准,但已在主流数据库的最新版本中得到良好支持。对于旧版SQL Server等环境,需回退到
LTRIM(RTRIM())组合。
--TRIM【垂姆】(s) 返回字符串s删除了两边空格之后的字符串mysql> select【涩莱克特】 trim【垂姆】(" ABC ");+-----------------+| trim【垂姆】(" ABC ") |+-----------------+| ABC |+-----------------+1 row in set (0.00 sec)mysql>四、日期函数
当前任务环节
flowchart LR subgraph BottomRow[常用函数] direction LR A[字符串函数] --> B[日期函数] --> C[聚集函数] --> D[数学计算] --> E[if函数] --> F[case函数] end
classDef highlight stroke:#f00,stroke-width:2px; class B highlight;获取系统或指定日期与时间
| 函数 | 说明 |
|---|---|
| curtime【科泰姆】() | 获取时间 |
| curdate【科dei 特】() | 获取日期 |
| now【闹】() | 获取日期和时间 |
| year【耶尔】() | 获取年 |
| month【mèn斯】() | 获取月 |
| day【dèi】() | 获取日 |
| week【wèi kē】() | 获取一年中的第几周 |
| date【dei 特】() | 获取日期 |
| weekday【wèi kē dèi】() | 获取一周中的周几 |
| time【泰姆】() | 获取时间 |
| hour【ào é】() | 获取小时 |
| minute【密 ní 特】 () | 获取分钟 |
| second【塞耿特】() | 获取秒 |
| quarter【扩特】() | 获取一年中第几季度 |
| monthname【mòn斯-内姆】() | 获取月份名称 |
| dayname【dei 内姆】() | 获取日期对应的星期名 |
| dayofyear【dèi诶 符 耶尔】() | 获取一年中第几天 |
| dayofmonth【dèi诶 符 mèn斯】() | 获取一月中第几天 |
命令操作如下所示:
mysql> select【涩莱克特】 curtime【科泰姆】(); //获取系统时间+-----------+| curtime【科泰姆】() |+-----------+| 17:42:20 |+-----------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 curdate【科dei 特】();//获取系统日期+------------+| curdate【科dei 特】() |+------------+| 2023-05-24 |+------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 now【闹】() ;//获取系统日期+时间+---------------------+| now【闹】() |+---------------------+| 2023-05-24 17:42:29 |+---------------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 year【耶尔】(now【闹】()) ; //获取系统当前年+-------------+| year【耶尔】(now【闹】()) |+-------------+| 2023 |+-------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 month【mèn斯】(now【闹】()) ; //获取系统当前月+--------------+| month【mèn斯】(now【闹】()) |+--------------+| 5 |+--------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 day【dèi】(now【闹】()) ; //获取系统当前日+------------+| day【dèi】(now【闹】()) |+------------+| 24 |+------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 hour【ào é】(now【闹】()) ; //获取系统当前小时+-------------+| hour【ào é】(now【闹】()) |+-------------+| 17 |+-------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 minute【密 ní 特】 (now【闹】()) ; //获取系统当分钟+---------------+| minute【密 ní 特】 (now【闹】()) |+---------------+| 46 |+---------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 second【塞耿特】(now【闹】()) ; //获取系统当前秒+---------------+| second【塞耿特】(now【闹】()) |+---------------+| 34 |+---------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 time【泰姆】(now【闹】()) ;//获取当前系统时间+-------------+| time【泰姆】(now【闹】()) |+-------------+| 17:47:36 |+-------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 date【dei 特】(now【闹】()) ; //获取当前系统日期+-------------+| date【dei 特】(now【闹】()) |+-------------+| 2023-05-24 |+-------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 curdate【科dei 特】();//获取当前系统日志+------------+| curdate【科dei 特】() |+------------+| 2023-05-24 |+------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 dayofmonth【dèi诶 符 mèn斯】(curdate【科dei 特】());//获取一个月的第几天+-----------------------+| dayofmonth【dèi诶 符 mèn斯】(curdate【科dei 特】()) |+-----------------------+| 24 |+-----------------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 dayofyear【dèi诶 符 耶尔】(curdate【科dei 特】());//获取一年中的第几天+----------------------+| dayofyear【dèi诶 符 耶尔】(curdate【科dei 特】()) |+----------------------+| 144 |+----------------------+1 row in set (0.00 sec)
mysql>mysql> select【涩莱克特】 monthname【mòn斯-内姆】(curdate【科dei 特】());//获取月份名+----------------------+| monthname【mòn斯-内姆】(curdate【科dei 特】()) |+----------------------+| May |+----------------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 dayname【dei 内姆】(curdate【科dei 特】());//获取星期名+--------------------+| dayname【dei 内姆】(curdate【科dei 特】()) |+--------------------+| Wednesday |+--------------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 quarter【扩特】(curdate【科dei 特】());//获取一年中的第几季度+--------------------+| quarter【扩特】(curdate【科dei 特】()) |+--------------------+| 2 |+--------------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 week【wèi kē】(now【闹】());//一年中的第几周+-------------+| week【wèi kē】(now【闹】()) |+-------------+| 21 |+-------------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 weekday【wèi kē dèi】(now【闹】());//一周中的周几+----------------+| weekday【wèi kē dèi】(now【闹】()) |+----------------+| 2 |+----------------+1 row in set (0.00 sec)五、聚集函数
当前任务环节
flowchart LR subgraph BottomRow[常用函数] direction LR A[字符串函数] --> B[日期函数] --> C[聚集函数] --> D[数学计算] --> E[if函数] --> F[case函数] end
classDef highlight stroke:#f00,stroke-width:2px; class C highlight;对数值类型表头下的数据做统计
命令操作如下所示:
输出3号员工2018每个月的基本工资
mysql> select【涩莱克特】 basic【贝斯克】 from【弗乱】 moershi.salary【撒拉瑞】 where【威尔】 employee【ing普洛伊】_id=3 and year【耶尔】(date【dei 特】)=2018;+-------+| basic【贝斯克】 |+-------+| 9261 || 9261 || 9261 || 9261 || 9261 || 9261 || 9261 || 9261 || 9261 || 9261 || 9261 || 9724 |+-------+12 rows in set (0.00 sec)sum(表头名) 求和
mysql> select【涩莱克特】 sum(basic【贝斯克】) from【弗乱】 moershi.salary【撒拉瑞】 where【威尔】 employee【ing普洛伊】_id=3 and year【耶尔】(date【dei 特】)=2018;+------------+| sum(basic【贝斯克】) |+------------+| 111595 |+------------+1 row in set (0.00 sec)avg(表头名) 计算平均值
mysql> select【涩莱克特】 avg(basic【贝斯克】) from【弗乱】 moershi.salary【撒拉瑞】 where【威尔】 employee【ing普洛伊】_id=3 and year【耶尔】(date【dei 特】)=2018;+------------+| avg(basic【贝斯克】) |+------------+| 9299.5833 |+------------+1 row in set (0.00 sec)min(表头名) 获取最小值
mysql> select【涩莱克特】 min(basic【贝斯克】) from【弗乱】 moershi.salary【撒拉瑞】 where【威尔】 employee【ing普洛伊】_id=3 and year【耶尔】(date【dei 特】)=2018;+------------+| min(basic【贝斯克】) |+------------+| 9261 |+------------+1 row in set (0.00 sec)max(表头名) 获取最大值
mysql> select【涩莱克特】 max(basic【贝斯克】) from【弗乱】 moershi.salary【撒拉瑞】 where【威尔】 employee【ing普洛伊】_id=3 and year【耶尔】(date【dei 特】)=2018;+------------+| max(basic【贝斯克】) |+------------+| 9724 |+------------+1 row in set (0.00 sec)count【kàn特】(表头名) 统计表头值个数
//输出3号员工2018年奖金小于3000的奖金mysql> select【涩莱克特】 bonus【波诺斯】 from【弗乱】 moershi.salary【撒拉瑞】 where【威尔】 employee【ing普洛伊】_id=3 and year【耶尔】(date【dei 特】)=2018 and bonus【波诺斯】<3000;+-------+| bonus【波诺斯】 |+-------+| 1000 || 1000 || 1000 |+-------+3 rows in set (0.00 sec)//统计3号员工2018年奖金小于3000的次数mysql> select【涩莱克特】 count【kàn特】(bonus【波诺斯】) from【弗乱】 moershi.salary【撒拉瑞】 where【威尔】 employee【ing普洛伊】_id=3 and year【耶尔】(date【dei 特】)=2018 and bonus【波诺斯】<3000;+--------------+| count【kàn特】(bonus【波诺斯】) |+--------------+| 3 |+--------------+1 row in set (0.01 sec)六、数学计算
当前任务环节
flowchart LR subgraph BottomRow[常用函数] direction LR A[字符串函数] --> B[日期函数] --> C[聚集函数] --> D[数学计算] --> E[if函数] --> F[case函数] end
classDef highlight stroke:#f00,stroke-width:2px; class D highlight;对行中的列做计算
| 符号 | 用途 | 例子 |
|---|---|---|
+ | 加法 | uid + gid |
- | 减法 | uid - gid |
* | 乘法 | uid * gid |
/ | 除法 | uid / gid |
% | 取余数(求模) | uid % gid |
() | 提高优先级 | (uid + gid) / 2 |
命令操作如下所示:
输出8号员工2019年1月10 工资总和
mysql> select【涩莱克特】 employee【ing普洛伊】_id,date【dei 特】,basic【贝斯克】 + bonus【波诺斯】 as 总工资 from【弗乱】 moershi.salary【撒拉瑞】 where【威尔】employee【ing普洛伊】_id = 8 and date【dei 特】=20190110;+-------------------------+------------+-----------------+| employee【ing普洛伊】_id | date【dei 特】 | 总工资 |+-------------------------+------------+-----------------+| 8 | 2019-01-10 | 24093 |+-------------------------+------------+-----------------+输出8号员工的名字和年龄
mysql> select【涩莱克特】 name, 当前年份 - year【耶尔】(birth_date【dei 特】) as 年龄 from【弗乱】 moershi.employees【ing普洛伊s】 where【威尔】employee【ing普洛伊】_id = 8 ;
-- mysql> select name, year【耶尔】(now【闹】()) - year【耶尔】(birth_date【dei 特】) as 年龄 from moershi.employees where employee_id=8;-- year【耶尔】(now【闹】()) 获取当前年份+--------+--------+| name | 年龄 |+--------+--------+| 汪云 | 29 |+--------+--------+查看8号员工2019年1月10 基本工资翻3倍的 值
mysql> select【涩莱克特】 employee【ing普洛伊】_id , basic【贝斯克】 , basic【贝斯克】 * 3 as 工资翻三倍 from【弗乱】 moershi.salary【撒拉瑞】 where【威尔】 employee【ing普洛伊】_id=8 and date【dei 特】=20190110;
-- mysql> select employee_id,basic,basic * 3 as 工资翻三倍 from moershi.salary where employee_id=8 and date=20190110;+-------------+-------+-----------------+| employee【ing普洛伊】_id | basic【贝斯克】 | 工资翻三倍 |+-------------+-------+-----------------+| 8 | 23093 | 69279 |+-------------+-------+-----------------+1 row in set (0.00 sec)查看8号员工2019年1月10的平均工资
mysql> select【涩莱克特】 employee【ing普洛伊】_id , (basic【贝斯克】+bonus【波诺斯】)/2 as 平均工资 from【弗乱】 moershi.salary【撒拉瑞】 where【威尔】 employee【ing普洛伊】_id=8 and date【dei 特】=20190110 ;
--mysql> select employee_id,(basic + bonus)/2 as 平均工资 from moershi.salary where employee_id=8 and date=20190110;+-------------+--------------+| employee【ing普洛伊】_id | 平均工资 |+-------------+--------------+| 8 | 12046.5000 |+-------------+--------------+1 row in set (0.01 sec)输出员工编号1-10之间偶数员工编号及对应的员工名
mysql> select【涩莱克特】 employee【ing普洛伊】_id , name from【弗乱】 moershi.employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id between【B豚ing】 1 and 10 and employee【ing普洛伊】_id % 2 = 0 ;
-- mysql> select employee_id,name from moershi.employees where employee_id between 1 and 10 and employee_id % 2 = 0;+-------------+-----------+| employee【ing普洛伊】_id | name |+-------------+-----------+| 2 | 郭岩 || 4 | 张健 || 6 | 牛建军 || 8 | 汪云 || 10 | 郭娟 |+-------------+-----------+5 rows in set (0.00 sec)七、if函数
当前任务环节
flowchart LR subgraph BottomRow[常用函数] direction LR A[字符串函数] --> B[日期函数] --> C[聚集函数] --> D[数学计算] --> E[if函数] --> F[case函数] end
classDef highlight stroke:#f00,stroke-width:2px; class E highlight;if(条件,v1,v2) 如果条件是TRUE则返回v1,否则返回v2
ifnull(v1,v2) 如果v1不为NULL,则返回v1,否则返回v2
| 特性 | IF 函数 | IFNULL 函数 |
|---|---|---|
| 主要用途 | 通用的条件判断,根据条件真假返回不同值 | 专门处理 NULL 值 |
| 参数数量 | 三个:IF(条件, 值_if_true, 值_if_false) | 两个:IFNULL(表达式, 替换值) |
| 核心逻辑 | 条件为真(非0且非NULL)返回第二个参数,否则返回第三个参数 | 表达式不为NULL时返回其自身,否则返回替换值 |
| 适用场景 | 两种可能性的选择,如分类、状态转换 | 字段可能为NULL时提供默认值,防止计算错误 |
💡 认识 IF 函数
IF 函数就像一个简单的“如果…那么…否则…”判断器。它的基本语法是:
IF(condition, value_if_true, value_if_false)- condition:要判断的条件表达式。
- value_if_true:当条件为真(TRUE,即非0且非NULL)时返回的值。
- value_if_false:当条件为假(FALSE 或 NULL)时返回的值。
使用示例:
-- 根据年龄判断是否成年SELECT name, IF(age >= 18, '成年', '未成年') AS age_group FROM users;
-- 在商品查询中显示折扣信息SELECT product_name, price, IF(price > 100, '高价商品', '普通商品') AS price_category FROM products;
-- 注意:直接判断浮点数时,MySQL会尝试将其转为整数,这可能不是你想要的结果SELECT IF(0.1, 1, 0); -- 返回 0,因为0.1被转为整数0后判断为假SELECT IF(0.1 <> 0, 1, 0); -- 返回 1,这是正确的比较方式演示if() 语句的执行过程
mysql> select【涩莱克特】 if(1 = 2 , "a","b");+---------------------+| if(1 = 2 , "a","b") |+---------------------+| b |+---------------------+1 row in set (0.00 sec)mysql> select【涩莱克特】 if( 1 = 1 , "a","b");+---------------------+| if(1 = 1 , "a","b") |+---------------------+| a |+---------------------+1 row in set (0.00 sec)mysql>🔄 掌握 IFNULL 函数
IFNULL 函数专为处理可能为 NULL 的值而设计,提供回退方案。它的语法更简洁:
IFNULL(expression, replacement_value)- expression:要检查的表达式或字段。
- replacement_value:如果
expression为NULL,则返回此值。
使用示例:
-- 为用户表中邮箱为空的记录提供默认显示SELECT username, IFNULL(email, '未提供邮箱') AS user_email FROM users;
-- 在计算中避免NULL值导致整体结果为NULLSELECT product, price, discount, price * IFNULL(discount, 1) AS final_price FROM sales;
-- IFNULL返回值的数据类型取决于上下文SELECT IFNULL(1, 'test'); -- 在临时表中,test列的类型可能是CHAR(4)演示ifnull() 语句的执行过程
mysql> select【涩莱克特】 ifnull("abc","xxx");+---------------------+| ifnull("abc","xxx") |+---------------------+| abc |+---------------------+1 row in set (0.00 sec)mysql> select【涩莱克特】 ifnull(null,"xxx");+--------------------+| ifnull(null,"xxx") |+--------------------+| xxx |+--------------------+1 row in set (0.00 sec)mysql>查询例子
根据uid 号 输出用户类型
mysql> select【涩莱克特】 name,uid,if(uid < 1000 , "系统用户","创建用户") as 用户类型 from【弗乱】 moershi.user;+-----------------+-------+--------------+| name | uid | 用户类型 |+-----------------+-------+--------------+| root | 0 | 系统用户 || bin | 1 | 系统用户 || daemon | 2 | 系统用户 || adm | 3 | 系统用户 || lp | 4 | 系统用户 || sync | 5 | 系统用户 || shutdown | 6 | 系统用户 || halt | 7 | 系统用户 || mail | 8 | 系统用户 || operator | 11 | 系统用户 || games | 12 | 系统用户 || ftp | 14 | 系统用户 || nobody | 99 | 系统用户 || systemd-network | 192 | 系统用户 || dbus | 81 | 系统用户 || polkitd | 999 | 系统用户 || sshd | 74 | 系统用户 || postfix | 89 | 系统用户 || chrony | 998 | 系统用户 || rpc | 32 | 系统用户 || rpcuser | 29 | 系统用户 || nfsnobody | 65534 | 创建用户 || haproxy | 188 | 系统用户 || plj | 1000 | 创建用户 || apache | 48 | 系统用户 || mysql | 27 | 系统用户 || bob | NULL | 创建用户 |+-----------------+-------+--------------+27 rows in set (0.00 sec)根据shell 输出用户类型
mysql> select【涩莱克特】 name , shell , if(shell = "/bin/bash" , "交互用户","非交户用户") as 用户类型 from【弗乱】 moershi.user;+-----------------+----------------+-----------------+| name | shell | 用户类型 |+-----------------+----------------+-----------------+| root | /bin/bash | 交互用户 || bin | /sbin/nologin | 非交户用户 || daemon | /sbin/nologin | 非交户用户 || adm | /sbin/nologin | 非交户用户 || lp | /sbin/nologin | 非交户用户 || sync | /bin/sync | 非交户用户 || shutdown | /sbin/shutdown | 非交户用户 || halt | /sbin/halt | 非交户用户 || mail | /sbin/nologin | 非交户用户 || operator | /sbin/nologin | 非交户用户 || games | /sbin/nologin | 非交户用户 || ftp | /sbin/nologin | 非交户用户 || nobody | /sbin/nologin | 非交户用户 || systemd-network | /sbin/nologin | 非交户用户 || dbus | /sbin/nologin | 非交户用户 || polkitd | /sbin/nologin | 非交户用户 || sshd | /sbin/nologin | 非交户用户 || postfix | /sbin/nologin | 非交户用户 || chrony | /sbin/nologin | 非交户用户 || rpc | /sbin/nologin | 非交户用户 || rpcuser | /sbin/nologin | 非交户用户 || nfsnobody | /sbin/nologin | 非交户用户 || haproxy | /sbin/nologin | 非交户用户 || plj | /bin/bash | 交互用户 || apache | /sbin/nologin | 非交户用户 || mysql | /bin/false | 非交户用户 || bob | NULL | 非交户用户 |+-----------------+----------------+-----------------+27 rows in set (0.00 sec)插入没有家目录的用户
mysql> insert【因涩特】 into moershi.user (name, homedir) values【挖柳斯】 ("jerrya",null);查看时加判断
mysql> select【涩莱克特】 name 姓名, ifnull(homedir,"NO home")as 家目录 from【弗乱】 moershi.user;+-----------------+--------------------+| 姓名 | 家目录 |+-----------------+--------------------+| root | /root || bin | /bin || daemon | /sbin || adm | /var/adm || lp | /var/spool/lpd || sync | /sbin || shutdown | /sbin || halt | /sbin || mail | /var/spool/mail || operator | /root || games | /usr/games || ftp | /var/ftp || nobody | / || systemd-network | / || dbus | / || polkitd | / || sshd | /var/empty/sshd || postfix | /var/spool/postfix || chrony | /var/lib/chrony || rpc | /var/lib/rpcbind || rpcuser | /var/lib/nfs || nfsnobody | /var/lib/nfs || haproxy | /var/lib/haproxy || plj | /home/plj || apache | /usr/share/httpd || mysql | /var/lib/mysql || bob | NO home || jerrya | NO home |+-----------------+--------------------+28 rows in set (0.00 sec)Mysql>八、case【kèi 斯】函数
当前任务环节
flowchart LR subgraph BottomRow[常用函数] direction LR A[字符串函数] --> B[日期函数] --> C[聚集函数] --> D[数学计算] --> E[if函数] --> F[case函数] end
classDef highlight stroke:#f00,stroke-width:2px; class F highlight;命令格式
CASE 表头名WHEN【问】 值1 then【diān~】 输出结果WHEN【问】 值2 then【diān~】 输出结果WHEN【问】 值3 then【diān~】 输出结果ELSE 输出结果END或CASEWHEN【问】 判断条件1 then【diān~】 输出结果WHEN【问】 判断条件2 then【diān~】 输出结果WHEN【问】 判断条件3 then【diān~】 输出结果ELSE 输出结果END| 步骤 | 简单 CASE:精确匹配器 (CASE 表头名 WHEN【问】 ...) | 搜索 CASE:条件扫描仪 (CASE WHEN ...) |
|---|---|---|
| 1 | 取出当前行中 表头名 字段的值。 | 评估 第一个 WHEN【问】 后的判断条件1 (如 salary > 5000) 是真还是假。 |
| 2 | 将这个值按顺序与 WHEN【问】 后的值(值1、值2…)进行相等比较。 | 如果 判断条件1 为 TRUE,则立刻返回 结果1,过程结束,后续条件被忽略。 |
| 3 | 一旦遇到一个相等的值(如 值2),则立刻返回其对应的 then【diān~】 结果2,过程结束。 | 如果为 FALSE,则继续评估下一个条件 (判断条件2)。 |
| 4 | 如果所有 WHEN【问】 值都不匹配,则最终返回 ELSE 部分的输出结果。 | 后续条件依此类推,直到找到一个为 TRUE 的条件。 |
| 5 | 如果没有 ELSE 部分且无匹配项,则返回 NULL。 | 如果所有条件都为 FALSE,则返回 ELSE 部分的结果;若无 ELSE 则返回 NULL。 |
如果表头名等于某个值,则返回对应位置then【diān~】后面的值并结束判断,
如果与所有值都不相等,则返回else后面的结果并结束判断
命令操作如下所示:
查看部门表(departments)所有行
mysql> select【涩莱克特】 * from【弗乱】 moershi.departments;+---------+-----------+| dept_id | dept_name |+---------+-----------+| 1 | 人事部 || 2 | 财务部 || 3 | 运维部 || 4 | 开发部 || 5 | 测试部 || 6 | 市场部 || 7 | 销售部 || 8 | 法务部 |+---------+-----------+8 rows in set (0.03 sec)
//输出部门类型select dept_id, dept_name,case dept_namewhen【问】 '运维部' then【diān~】 '技术部门'when【问】 '开发部' then【diān~】 '技术部门'when【问】 '测试部' then【diān~】 '技术部门'else '非技术部门'end as 部门类型 from【弗乱】 moershi.departments;+---------+-----------+-----------------+| dept_id | dept_name | 部门类型 |+---------+-----------+-----------------+| 1 | 人事部 | 非技术部门 || 2 | 财务部 | 非技术部门 || 3 | 运维部 | 技术部门 || 4 | 开发部 | 技术部门 || 5 | 测试部 | 技术部门 || 6 | 市场部 | 非技术部门 || 7 | 销售部 | 非技术部门 || 8 | 法务部 | 非技术部门 |+---------+-----------+-----------------+8 rows in set (0.00 sec)
或mysql> select【涩莱克特】 dept_id,dept_name, -> case -> when【问】 dept_name="运维部" then【diān~】 "技术部" -> when【问】 dept_name="开发部" then【diān~】 "技术部" -> when【问】 dept_name="测试部" then【diān~】 "技术部" -> else "非技术部" -> end as 部门类型 from【弗乱】 moershi.departments;+---------+-----------+--------------+| dept_id | dept_name | 部门类型 |+---------+-----------+--------------+| 1 | 人事部 | 非技术部 || 2 | 财务部 | 非技术部 || 3 | 运维部 | 技术部 || 4 | 开发部 | 技术部 || 5 | 测试部 | 技术部 || 6 | 市场部 | 非技术部 || 7 | 销售部 | 非技术部 || 8 | 法务部 | 非技术部 |+---------+-----------+--------------+8 rows in set (0.00 sec)或mysql> select【涩莱克特】 dept_id,dept_name, -> case -> when【问】 dept_name in ("运维部","开发部","测试部") then【diān~】 "技术部" -> else "非技术部" -> end as 部门类型 from【弗乱】 moershi.departments;+---------+-----------+--------------+| dept_id | dept_name | 部门类型 |+---------+-----------+--------------+| 1 | 人事部 | 非技术部 || 2 | 财务部 | 非技术部 || 3 | 运维部 | 技术部 || 4 | 开发部 | 技术部 || 5 | 测试部 | 技术部 || 6 | 市场部 | 非技术部 || 7 | 销售部 | 非技术部 || 8 | 法务部 | 非技术部 |+---------+-----------+--------------+8 rows in set (0.00 sec)九、作业
1.选择题
- 要从
employees表的email列中提取出@后面的域名部分,应使用以下哪个函数? B A.SUBSTRINGB.SUBSTRING_INDEXC.LEFTD.RIGHT
**要从 `employees` 表的 `email` 列中提取出 `@` 后面的域名部分,应使用以下哪个函数?** * **答案:B ** * **讲解**:`SUBSTRING_INDEX` 函数是完成这个任务最简洁高效的选择。它的语法是 `SUBSTRING_INDEX(str, delimiter, count)`。当 `count` 为负数时,表示从字符串右边开始查找分隔符,并返回分隔符**之后**的所有内容。因此,使用 `SUBSTRING_INDEX(email, '@', -1)` 可以直接提取出域名部分,例如从 `"alice@example.com"` 中提取出 `"example.com"`。其他函数如 `SUBSTRING` 需要结合 `LOCATE` 先找到 `@` 的位置,更为繁琐。- 已知
employees表的hire_date列是日期类型,要计算每个员工入职到当前日期的天数,应使用的函数是? A.TIMESTAMPDIFF(DAY【dèi】, hire_date, CURDATE【科dei 特】())B.TIMESTAMPDIFF(MONTH【mèn斯】, hire_date, CURDATE【科dei 特】())C.TIMESTAMPDIFF(YEAR【耶尔】, hire_date, CURDATE【科dei 特】())D.DATEDIFF(CURDATE【科dei 特】(), hire_date)
**已知 `employees` 表的 `hire_date` 列是日期类型,要计算每个员工入职到当前日期的天数,应使用的函数是?** * **答案:D** * **讲解**:计算两个日期的天数差,最直接和常用的函数是 `DATEDIFF(end_date, start_date)`。它返回两个日期之间相差的天数。因此,`DATEDIFF(CURDATE【科dei 特】(), hire_date)` 可以准确计算出从入职日到今天的天数。选项A的 `TIMESTAMPDIFF` 函数也能实现,但它通常用于计算年、月等更大单位的差值,对于计算天数,`DATEDIFF` 是更常规和简洁的选择。- 在统计每个部门的员工数量时,应使用的聚集函数是? C
A.
SUMB.AVGC.COUNTD.MAX
**在统计每个部门的员工数量时,应使用的聚集函数是?** * **答案:C ** * **讲解**:`COUNT` 是SQL中专门用于**统计行数**的聚合函数。在配合 `GROUP BY department` 使用时,`COUNT(*)` 会返回每个分组(即每个部门)中包含的数据行数,也就是员工数量。`SUM` 用于对数值列求和,`AVG` 用于求平均值,`MAX` 用于找最大值,都不适用于计数场景。- 在
salary表中,要计算每个员工的总薪资(基本工资basic加上奖金bonus),以下表达式正确的是? B A.basic + bonusB.SUM(basic, bonus)C.AVG(basic + bonus)D.MAX(basic, bonus)
**在 `salary` 表中,要计算每个员工的总薪资(基本工资 `basic` 加上奖金 `bonus`),以下表达式正确的是?** * **答案:A** * **讲解**:这里的关键是区分**行内计算**与**多行聚合**。计算单个员工的“基本工资+奖金”属于行内计算,只需要使用基本的算术运算符 `+` 即可,即 `basic + bonus`。而 `SUM` 是一个聚合函数,它的作用是对**一组行**的某个字段值进行求和,例如计算整个部门的工资总和,不能用于对同一行内的不同列进行计算。`SUM(basic, bonus)` 的写法在MySQL中本身就是错误的,因为 `SUM` 函数只能接受一个参数。- 在
employees表中,若要根据员工的入职日期判断,如果入职日期在 2025 年 1 月 1 日之后,标记为 “新员工”,否则标记为 “老员工”,可以使用以下哪个函数实现? A A.IF(hire_date > '2025-01-01', '新员工', '老员工')B.CASE WHEN hire_date > '2025-01-01' THEN '新员工' ELSE '老员工' ENDC. 以上两种都可以 D. 以上两种都不可以
**在 `employees` 表中,若要根据员工的入职日期判断,如果入职日期在 2025 年 1 月 1 日之后,标记为 “新员工”,否则标记为 “老员工”,可以使用以下哪个函数实现?** * **答案:C** * **讲解**:MySQL 提供了两种实现条件逻辑的主要方式。`IF` 函数适合处理简单的“如果...就...否则...”的双分支判断,语法简洁,本题中的 `IF(hire_date > '2025-01-01', '新员工', '老员工')` 完全正确。而 `CASE` 表达式则更强大,尤其适合多分支的复杂条件判断,其搜索形式 `CASE WHEN ... THEN ... ELSE ... END` 同样可以完美实现本题需求。因此,两种方法都是可行的。2.简答题
- 请简述字符串函数
CONCAT和CONCAT_WS的区别。 答: CONCAT:是将多个字符串简单拼接在一起,且任一参数为NULL则返回NULL。 CONCAT_WS:是 CONCAT的基础上增加了分隔符功能,是带分隔符地拼接多个字符,自动忽略参数中的NULL值(分隔符本身不能为NULL)
在MySQL中,`CONCAT` 和 `CONCAT_WS` 都是用于连接字符串的函数,但它们在处理分隔符和空值(`NULL`)时的行为是关键区别所在。下面这个表格能帮你快速把握它们的核心区别。
| 特性 | `CONCAT` | `CONCAT_WS` | | :--- | :--- | :--- | | **核心功能** | 将多个字符串**简单连接**在一起 | **带分隔符**地连接多个字符串 | | **分隔符** | 无内置分隔符概念,需手动在每个参数间添加 | **第一个参数即为分隔符**,一次性指定 | | **处理`NULL`值** | **任一参数为`NULL`,则整个结果返回`NULL`** | **忽略要连接的参数中的`NULL`值**(分隔符本身不能为`NULL`) | | **适用场景** | 简单的、无间隔的字符串拼接 | 需要用特定字符(如逗号、短横线)连接字段,且字段可能包含`NULL`值 |
### 💡 深入了解 `CONCAT` 函数
`CONCAT` 函数的功能非常直接:按顺序将传入的所有参数连接成一个字符串。其语法为 `CONCAT(str1, str2, ...)`。
* **注意事项**:它最大的特点(也常被视为一个“坑”)是,**只要待连接的参数中有一个是 `NULL`,整个函数的返回结果就是 `NULL`**。这在处理可能包含空值的数据库字段时需要格外小心。 * **示例**: ```sql SELECT CONCAT('Hello', ' ', 'World'); -- 返回 'Hello World' SELECT CONCAT('Hello', NULL, 'World'); -- 返回 NULL SELECT CONCAT('2025', '10', '22'); -- 返回 '20251022' (如需日期格式,需手动加分隔符) ```
### 🔄 掌握 `CONCAT_WS` 函数
`CONCAT_WS` 是 "CONCAT With Separator" 的缩写,它在 `CONCAT` 的基础上增加了分隔符功能。其语法为 `CONCAT_WS(separator, str1, str2, ...)`,**第一个参数就是分隔符**。
* **核心优势**:除了能自动添加分隔符,它最实用的特性是**会忽略除分隔符之外的其他参数中的 `NULL` 值**。这意味着即使 `str2` 是 `NULL`,最终结果也会是 `str1` + 分隔符 + `str3`,而不会返回 `NULL`。 * **重要例外**:虽然会忽略参数中的 `NULL`,但如果**分隔符(第一个参数)本身是 `NULL`**,那么结果仍会返回 `NULL`。 * **示例**: ```sql SELECT CONCAT_WS(', ', 'Apple', 'Banana', 'Orange'); -- 返回 'Apple, Banana, Orange' SELECT CONCAT_WS('-', '2025', '10', '22'); -- 返回 '2025-10-22' (轻松格式化日期) SELECT CONCAT_WS(' ', 'Hello', NULL, 'World'); -- 返回 'Hello World' (忽略NULL) ```
### 🛠️ 用场景选择函数
根据上面的区别,你可以在不同场景下选择合适的函数:
* **使用 `CONCAT` 当**:你需要进行简单的、无间隔的字符串拼接,并且能**确保所有参数都不为 `NULL`**,或者你**希望当存在 `NULL` 时结果直接变为 `NULL`**。
* **使用 `CONCAT_WS` 当**:你希望用统一的**分隔符(如逗号、空格、短横线)来连接多个字符串**,特别是当这些字段**可能包含 `NULL` 值**,而你又不希望最终的拼接结果因某个空值而中断或失效时。这在拼接地址、全名或生成特定格式的编码时非常有用。
### 💎 简单总结
记住一个简单的法则:需要加分隔符或者担心字段有`NULL`值影响拼接结果时,优先选择 **`CONCAT_WS`**;否则,进行最简单的无缝拼接且不担心`NULL`值时,可以使用 **`CONCAT`**。-
聚集函数
SUM和AVG在使用上有什么不同? 答:SUM是计算指定列中所有非NULL数值的总和。AVG是计算指定列中所有非NULL数值的算术平均值 -
IF函数和CASE函数在条件判断方面有什么特点和适用场景? 答:IF函数:就像一个简单的“如果…那么…否则…”判断器,适用于简单场景,类似考试成绩if(cj >60,“合格”,“不合格”)CASE函数:是一个多分支条件判断的精确匹配器,可以进行精细的多分支条件判断,像成绩分级case when cj >=90 then “优秀” when cj >=80 and <=89 then “良好”…
这三个问题确实是SQL学习中的关键知识点。下面我用一个表格快速梳理它们的核心区别,然后我们再详细看看。
| 函数对比 | 核心功能与关键区别 | 典型应用场景 | | :---- | :---- | :---- | | **CONCAT vs CONCAT_WS** | **CONCAT**:简单连接字符串,**任一参数为NULL则返回NULL**。<br>**CONCAT_WS**:带分隔符连接,**自动忽略参数中的NULL值**(分隔符本身不能为NULL)。 | **CONCAT**:无间隔拼接,如合并姓和名`CONCAT(last_name, first_name)`。<br>**CONCAT_WS**:需统一分隔符的拼接,如格式化日期`CONCAT_WS('-', year【耶尔】, month【mèn斯】, day【dèi】)`,或拼接可能为NULL的字段。 | | **SUM vs AVG** | **SUM**:计算指定列中所有**非NULL数值的总和**。<br>**AVG**:计算指定列中所有**非NULL数值的算术平均值**(其计算方式为`SUM(列) / COUNT(列)`)。 | **SUM**:回答“总量”问题,如总销售额、总成本。<br>**AVG**:回答“平均水平”问题,如平均分、平均工资。 | | **IF vs CASE** | **IF函数**:MySQL特有,适用于简单的**二元判断**(类似三元运算符`条件 ? 结果1 : 结果2`)。<br>**CASE表达式**:SQL标准语法,适用于**多分支条件判断**,功能更强大,可读性更好。 | **IF函数**:简单的“是/否”判断,如`IF(score >= 60, '及格', '不及格')`。<br>**CASE表达式**:复杂的多条件分支,如成绩分级、会员等级划分。 |
### 💡 字符串连接:CONCAT 与 CONCAT_WS
- **CONCAT 的注意事项**:由于其“遇NULL则NULL”的特性,在拼接可能包含空值的字段时存在风险。为确保结果,通常需要先用`COALESCE`或`IFNULL`函数将`NULL`值转换为空字符串等默认值,例如 `CONCAT(COALESCE(field1, ''), field2)`。 - **CONCAT_WS 的优势**:它在处理如地址等多部分信息时特别有用,因为这些信息中的某些部分很可能为`NULL`。使用`CONCAT_WS`可以避免繁琐的空值检查,直接生成整洁的拼接结果(例如 `CONCAT_WS(' ', address, city, country)`),即使其中部分字段为`NULL`,结果字符串也不会中断。
### 📊 数据汇总:SUM 与 AVG
- **共同点**:`SUM`和`AVG`都是聚合函数,它们在计算时都会**自动忽略**列中的`NULL`值。这意味着计算分母是非`NULL`值的个数,而非总行数。 - **重要细节**: - `AVG`函数的结果类型可能比输入列的类型精度更高。例如,对整数列(`INT`)求平均值,可能会返回浮点数(如`DECIMAL`)结果。 - 它们常与`GROUP BY`子句结合使用,以实现分组统计,例如计算每个部门的平均工资。 - 可以使用`DISTINCT`关键字对唯一值进行计算,如 `AVG(DISTINCT score)` 只计算不同成绩的平均值。
### 🔀 条件判断:IF 与 CASE
- **CASE 表达式的两种形式**: 1. **简单 CASE 表达式**:用于等值比较,语法为 `CASE column WHEN value1 THEN result1 ... END`。例如,根据部门编号显示名称:`CASE department WHEN 'IT' THEN '技术部' ... END`。 2. **搜索型 CASE 表达式**:功能更强,允许进行范围判断和多条件组合,语法为 `CASE WHEN condition1 THEN result1 ... END`。例如,成绩分级:`CASE WHEN score >= 90 THEN '优秀' ... END`。 - **选择策略**: - 当你的逻辑是简单的“如果...就...否则...”(二选一)时,使用 **`IF` 函数**,代码更简洁。 - 当条件超过两种,或判断条件复杂(涉及范围、多条件组合)时,务必使用 **`CASE` 表达式**,其结构更清晰,可读性更强。 - `CASE`表达式是SQL标准,兼容性更好,而`IF`函数通常是MySQL扩展。此外,`CASE`表达式不仅可用于`SELECT`列表,还能用在`ORDER BY`、`WHERE`、`UPDATE`等子句中,实现非常灵活的条件逻辑。3.操作题
- 使用字符串函数,将
employees表中所有员工的姓名转换为小写,并在每个姓名后面添加 “_emp” 后缀。
mysql> select concat(lower(name),'_emp') as 姓名 from moershi.employees;+---------------+| 姓名 |+---------------+| 梁伟_emp || 郭岩_emp || 李玉英_emp || 张健_emp || 郑静_emp || 牛建军_emp |...........| 刘倩_emp || 杨金凤_emp |+---------------+133 rows in set (0.00 sec)
mysql>
```sql SELECT CONCAT(LOWER(name), '_emp') AS formatted_name FROM employees; ```
或者,你也可以使用 `LCASE()` 函数(它与 `LOWER()` 功能完全相同):
```sql SELECT CONCAT(LCASE(name), '_emp') AS formatted_name FROM employees; ```
### 关键点说明
- **`LOWER()` / `LCASE()` 函数**:这两个函数用于将字符串中的所有字母字符转换为小写。例如,如果员工姓名是 "John DOE",转换后将变为 "john doe"。 - **`CONCAT()` 函数**:此函数用于将多个字符串连接在一起。在这里,我们将转换后的小写姓名和固定后缀 "_emp" 拼接起来。 - **注意 `NULL` 值**:需要特别注意的是,如果 `name` 字段的值为 `NULL`,那么 `CONCAT()` 函数的结果也将是 `NULL`。如果您的数据中存在这种情况并且不希望返回 `NULL`,可以使用 `COALESCE()` 或 `IFNULL()` 函数为其设置一个默认值。例如: ```sql SELECT CONCAT(LOWER(COALESCE(name, 'unknown')), '_emp') AS formatted_name FROM employees; ```- 使用日期函数,从
employees表中找出在本月出生的员工信息。
mysql> select name,birth_date birth_date from moershi.employees where month【mèn斯】(birth_date) = month【mèn斯】(now【闹】());+-----------+------------+| name | birth_date |+-----------+------------+| 王英 | 1997-10-11 || 许辉 | 1992-10-21 || 罗岩 | 1986-10-17 || 赵成 | 1985-10-11 || 刘桂兰 | 1982-10-11 || 李莹 | 1995-10-26 || 李柳 | 1972-10-14 || 王小红 | 1989-10-04 || 贾荣 | 1984-10-19 || 张梅 | 1981-10-21 |+-----------+------------+10 rows in set (0.00 sec)
mysql>- 使用数学计算,在
salary表中计算每个员工奖金占总薪资(基本工资basic加上奖金bonus)的比例,并保留两位小数。
mysql> select employee_id,basic,bonus,round(bonus / (basic + bonus) ,2) as 占总薪资比例 from moershi.salary where id<=50; #加个where 减少数据量方便截图+-------------+-------+-------+--------------------+| employee_id | basic | bonus | 占总薪资比例 |+-------------+-------+-------+--------------------+| 2 | 17000 | 10000 | 0.37 || 3 | 8000 | 2000 | 0.20 || 4 | 14000 | 9000 | 0.39 || 6 | 14000 | 10000 | 0.42 || 7 | 19000 | 10000 | 0.34 || 11 | 14000 | 7000 | 0.33 || 13 | 15000 | 1000 | 0.06 || 14 | 10000 | 11000 | 0.52 || 17 | 16000 | 7000 | 0.30 || 18 | 6000 | 10000 | 0.63 || 21 | 15000 | 6000 | 0.29 || 22 | 12000 | 8000 | 0.40 || 25 | 19000 | 2000 | 0.10 || 26 | 7000 | 11000 | 0.61 || 27 | 20000 | 5000 | 0.20 || 28 | 14000 | 5000 | 0.26 || 29 | 19000 | 1000 | 0.05 || 30 | 6000 | 1000 | 0.14 || 32 | 15000 | 8000 | 0.35 || 34 | 19000 | 6000 | 0.24 || 37 | 20000 | 6000 | 0.23 || 38 | 19000 | 11000 | 0.37 || 39 | 12000 | 10000 | 0.45 || 40 | 17000 | 2000 | 0.11 || 41 | 8000 | 7000 | 0.47 || 43 | 11000 | 9000 | 0.45 || 44 | 11000 | 8000 | 0.42 || 45 | 12000 | 1000 | 0.08 || 46 | 13000 | 10000 | 0.43 || 47 | 11000 | 11000 | 0.50 || 48 | 21000 | 10000 | 0.32 || 49 | 13000 | 7000 | 0.35 || 50 | 9000 | 4000 | 0.31 |+-------------+-------+-------+--------------------+33 rows in set (0.00 sec)
mysql>- 使用
CASE函数,结合employees表和departments表,根据部门名称将员工分为 “技术部员工”、“销售部员工” 和 “其他部门员工” 三类。
mysql> select -> e.employee_id, -> e.name as 姓名, -> d.dept_name as 部门, -> case -> when d.dept_name = '运维部' then '技术部员工' -> when d.dept_name = '开发部' then '技术部员工' -> when d.dept_name = '测试部' then '技术部员工' -> when d.dept_name = '市场部' then '销售部员工' -> when d.dept_name = '销售部' then '销售部员工' -> else '其他部门员工' -> end as 部门类型 -> from moershi.employees e -> join moershi.departments d on e.dept_id = d.dept_id;+-------------+-----------+-----------+--------------------+| employee_id | 姓名 | 部门 | 部门类型 |+-------------+-----------+-----------+--------------------+| 1 | 梁伟 | 人事部 | 其他部门员工 || 2 | 郭岩 | 人事部 | 其他部门员工 || 3 | 李玉英 | 人事部 | 其他部门员工 || 4 | 张健 | 人事部 | 其他部门员工 || 5 | 郑静 | 人事部 | 其他部门员工 || 6 | 牛建军 | 人事部 | 其他部门员工 || 7 | 刘斌 | 人事部 | 其他部门员工 |.......| 128 | 许华 | 销售部 | 销售部员工 || 129 | 汤华 | 销售部 | 销售部员工 || 130 | 王玉兰 | 销售部 | 销售部员工 || 131 | 王荣 | 法务部 | 其他部门员工 || 132 | 刘倩 | 法务部 | 其他部门员工 || 133 | 杨金凤 | 法务部 | 其他部门员工 |+-------------+-----------+-----------+--------------------+133 rows in set (0.00 sec)
mysql> 您提出的这几个问题非常典型,涵盖了数据库查询中几个核心函数的用法。下面我将为您逐一提供详细的解答和示例。
| 问题序号 | 核心方法 | 示例 SQL 语句框架 | | :------------- | :------------------------------- | :-------------------------------------------------- | | 1. 姓名转换 | 使用 `LOWER()` 和 `CONCAT()` 函数 | `SELECT CONCAT(LOWER(name), '_emp') ...` | | 2. 查询本月生日 | 使用 `MONTH【mèn斯】()` 函数比较月份 | `SELECT ... WHERE MONTH【mèn斯】(birth_date) = MONTH【mèn斯】(NOW【闹】())` | | 3. 计算奖金占比 | 使用 `ROUND()` 函数控制小数位 | `SELECT ROUND(bonus/(basic+bonus), 2) ...` | | 4. 员工部门分类 | 使用 `CASE` 条件表达式 | `CASE WHEN d.name = '技术部' THEN ... END` |
### 💡 字符串函数:姓名格式化
这个问题的目标是修改姓名显示格式,主要用到两个字符串函数: - `LOWER()`:将字符串中的所有字母转换为小写。 - `CONCAT()`:将两个或多个字符串连接起来。
相应的SQL语句和说明如下: ```sql SELECT employee_id, CONCAT(LOWER(name), '_emp') AS formatted_name FROM employees; ``` **关键点说明**:这个操作创建了一个名为 `formatted_name` 的新列,其中每个员工的名字先被转换为小写,然后与后缀 `_emp` 连接。例如,`"Alice"` 会变成 `"alice_emp"`。
### 📅 日期函数:查询本月生日员工
要找出在本月出生的员工,核心在于使用 `MONTH【mèn斯】()` 函数来提取日期字段中的月份部分,并与当前月份进行比较。
相应的SQL语句和说明如下: ```sql SELECT employee_id, name, birth_date FROM employees WHERE MONTH【mèn斯】(birth_date) = MONTH【mèn斯】(NOW【闹】()); ``` **关键点说明**:`NOW【闹】()` 函数返回当前的日期和时间。`MONTH【mèn斯】(NOW【闹】())` 提取出当前的月份数字(例如10月返回10)。`WHERE` 条件会筛选出 `birth_date` 字段中月份与当前月份相同的所有记录。
### ➗ 数学计算:计算奖金占比
这个问题需要执行除法运算,并使用 `ROUND` 函数对结果进行格式化。
相应的SQL语句和说明如下: ```sql SELECT employee_id, basic, bonus, ROUND(bonus / (basic + bonus), 2) AS bonus_ratio FROM salary; ``` **关键点说明**: - 计算逻辑:使用 `奖金 / (基本工资 + 奖金)` 来得到奖金占总薪资的比例。 - 精度控制:`ROUND(数值, 2)` 函数将计算结果四舍五入到小数点后两位,这是处理金融或比率数据时的常见做法。 - 注意 `NULL` 值:如果 `basic` 或 `bonus` 可能为 `NULL`,直接计算会导致结果为 `NULL`。为确保计算安全,可以使用 `IFNULL(basic, 0)` 等函数为 `NULL` 值设置默认值。
### 🔀 条件判断:对员工进行部门分类
`CASE` 表达式非常适合这种多条件的值映射场景,它允许你根据不同的条件返回不同的结果。这里假设员工表(`employees`)中有一个部门ID字段(`dept_id`)与部门表(`departments`)关联,部门表中有部门名字段(`name`)。
相应的SQL语句和说明如下: ```sql
select e.employee_id, e.name as 姓名, d.dept_name as 部门, case when d.dept_name = '运维部' then '技术部员工' when d.dept_name = '开发部' then '技术部员工' when d.dept_name = '测试部' then '技术部员工' when d.dept_name = '市场部' then '销售部员工' when d.dept_name = '销售部' then '销售部员工' else '其他部门员工' end as 部门类型 from moershi.employees e join moershi.departments d on e.dept_id = d.dept_id;
``` **关键点说明**: - 使用搜索型 `CASE` 表达式:`CASE WHEN condition THEN result ... END`。 - 执行顺序是自上而下评估每个 `WHEN` 条件,一旦某个条件为真,就返回对应的 `THEN` 结果,并跳过后续条件。 - 如果所有 `WHEN` 条件都不满足,则返回 `ELSE` 子句的结果。指定 `ELSE` 是一个好习惯,可以确保所有情况都有明确的输出。03:mysql之单表增删改查
今日工作任务路线图
flowchart LR subgraph BottomRow[单表增删改查] direction LR A[分组查询] --> B[对查询结果进行排序] --> C[分组后条件过滤] --> D[新增数据] --> E[修改数据] --> F[删除数据] end一、工作场景
在电商运营工作中,单表的增删改查操作十分常见。运营人员为了丰富商品种类,会向商品信息表中新增商品记录,包括商品名称、价格、库存等信息,以满足市场需求。若某商品价格调整,运营人员会及时修改商品信息表中该商品的价格字段,保证数据准确性。当一款商品下架时,他们会从表中删除该商品的记录,避免无效数据干扰。同时,在分析销售数据时,运营人员会根据不同条件从表中查询特定商品的信息,比如筛选出销量高的商品,为后续的营销策略提供数据支持。
二、为什么学增删改查
学习 MySQL 单表的增删改查至关重要。在数据管理领域,这是最基础且核心的技能。在日常工作里,我们常常要与各种数据打交道,增删改查操作能让我们灵活处理数据。比如,电商平台需新增商品信息、删除滞销商品数据、修改商品价格、查询特定商品库存。掌握这些操作,能高效维护数据,确保数据实时性与准确性。同时,它们是学习更复杂数据库操作的基石,如多表连接、存储过程等。对于从事数据分析、软件开发等行业的人而言,熟练运用增删改查是必备技能,能提升工作效率与质量。
三、分组查询
当前任务环节
flowchart LR subgraph BottomRow[单表增删改查] direction LR A[分组查询] --> B[对查询结果进行排序] --> C[分组后条件过滤] --> D[新增数据] --> E[修改数据] --> F[删除数据] end
classDef highlight stroke:#f00,stroke-width:2px; class A highlight;分组函数 group【格鲁普】 by
GROUP【格鲁普】 BY是 SQL 中非常重要的一个子句,它的主要作用是对查询结果进行分组统计
| 特性 | 说明 | 示例或关键点 |
|---|---|---|
| 核心功能 | 根据指定列将数据分成若干组,然后对每个组应用聚合函数进行统计。 | 计算每个部门的平均工资、每个产品的总销售额等。 |
| 基本语法 | SELECT【涩莱克特】 列A, 聚合函数(列B) FROM【弗乱】 表名 GROUP【格鲁普】 BY 列A;。 | 列A是分组依据。 |
| 常用聚合函数 | COUNT【kàn特】()(计数), SUM【桑à姆】()(求和), AVG()(平均值), MAX【mà 斯】()(最大值), MIN【敏ì】()(最小值)。 | 对每个分组进行计算。 |
| 与HAVING子句 | WHERE【威尔】 在分组前过滤行,HAVING【嗨夫营】 在分组后过滤组。 | HAVING【嗨夫营】 AVG(salary【晒了瑞】) > 5000(筛选出平均工资大于5000的组)。 |
| 多列分组 | GROUP【格鲁普】 BY 后面可接多个列,按这些列的组合进行分组。 | GROUP【格鲁普】 BY department【迪帕踢门特】, job_title。 |
| 重要注意事项 | SELECT【涩莱克特】 后面非聚合的列,必须出现在 GROUP【格鲁普】 BY 子句中。 | 这是最容易出错的地方。 |
💡 理解分组的过程
你可以把 GROUP【格鲁普】 BY 想象成一个高效的数据整理师。它的工作流程通常是:首先,根据 GROUP【格鲁普】 BY 后面指定的列,将表中所有数据行分成不同的“小组”,每个小组内的这些列的值完全相同。然后,数据库会对每一个这样的小组分别计算聚合函数(如求和、计数等)。最后,查询结果将为每个小组返回一行摘要信息,其中包含分组列的值和聚合函数计算的结果。
例如,有一个员工表,使用 SELECT【涩莱克特】 department【迪帕踢门特】, AVG(salary【晒了瑞】) FROM【弗乱】 employees【ing普洛伊s】 GROUP【格鲁普】 BY department【迪帕踢门特】; 可以计算出每个部门的平均工资。在这里,数据库会先按部门进行分组,然后对每个部门小组计算平均工资。
🛠️ 基本用法与示例
单列分组 这是最常见的情况,即根据一个字段进行分组。
-- 统计每个城市的用户数量SELECT【涩莱克特】 city, COUNT【kàn特】(*) AS user_count【kàn特】FROM【弗乱】 usersGROUP【格鲁普】 BY city;多列分组 当需要根据多个字段的组合进行更精细的分组时,可以使用多列分组。
-- 统计每个部门下每个职位的员工数量SELECT【涩莱克特】 department【迪帕踢门特】, job_title, COUNT【kàn特】(*) AS employee【ing普洛伊】_count【kàn特】FROM【弗乱】 employees【ing普洛伊s】GROUP【格鲁普】 BY department【迪帕踢门特】, job_title;这个查询会返回所有唯一的“部门-职位”组合及其对应的员工数量。
⚠️ 关键规则与常见错误
-
SELECT【涩莱克特】列表的非聚合列规则 这是使用
GROUP【格鲁普】 BY时最需要牢记的规则:出现在SELECT【涩莱克特】列表中的列,要么必须包含在GROUP【格鲁普】 BY子句中,要么必须被包含在聚合函数里。这是因为,对于每个分组来说,分组列的值是唯一的(比如“技术部”),但其他列可能有多条不同的记录(比如“技术部”里有很多不同的员工名)。数据库无法确定应该返回哪一条非分组列的值,因此强制要求通过聚合函数(如MAX【mà 斯】,AVG)将其汇总成一个值,或者将其本身作为分组依据。 -
WHERE【威尔】 与 HAVING【嗨夫营】 的区别
WHERE【威尔】:在 分组之前 过滤数据行。它不能包含聚合函数。HAVING【嗨夫营】:在 分组之后 过滤分组结果。它通常与聚合函数一起使用,用来筛选满足特定条件的组。
-- 正确示例:先过滤出2023年以后的订单,再按客户分组,最后筛选出总金额大于1000的客户SELECT【涩莱克特】 customer_id, SUM【桑à姆】(amount) AS total【偷ò头ō】_amountFROM【弗乱】 orders【欧朵s】WHERE【威尔】 order【欧朵】_date >= '2023-01-01' -- 分组前过滤行GROUP【格鲁普】 BY customer_idHAVING【嗨夫营】 SUM【桑à姆】(amount) > 1000; -- 分组后过滤组
🔍 高级用法与技巧
- 使用表达式或函数分组:可以根据表达式的结果进行分组,这在处理时间序列数据时特别有用。例如,可以按年份和月份分组统计订单。
- 使用ROLLUP生成小计和总计:
WITH ROLLUP选项可以在分组结果的基础上,生成层次性的小计和总计行。 - 处理NULL【nò】值:需要注意的是,如果分组列中包含
NULL【nò】值,所有NULL【nò】值会被归为同一组。
命令操作如下所示:
输出符合条件的shell 和 name
mysql> select【涩莱克特】 shell,name from【弗乱】 moershi.user where【威尔】shell in ("/bin/bash","/sbin/nologin【诺劳京(白话)】");+---------------+-----------------+| shell | name |+---------------+-----------------+| /bin/bash | root || /sbin/nologin | bin || /sbin/nologin | daemon || /sbin/nologin | adm |.................| /sbin/nologin | rpc || /sbin/nologin | rpcuser || /sbin/nologin | nfsnobody || /sbin/nologin | haproxy || /bin/bash | plj || /sbin/nologin | apache |+---------------+-----------------+22 rows in set【赛特】 (0.00 sec)统计每种解释器用户的个数 (按照shell表头值分组统计name表头值个数)
mysql> select【涩莱克特】 shell as 解释器 , count【kàn特】(name) as 总人数 from【弗乱】 moershi.user where【威尔】shell in ("/bin/bash","/sbin/nologin【诺劳京(白话)】") group【格鲁普】 by shell;+---------------+-----------+| 解释器 | 总人数 |+---------------+-----------+| /bin/bash | 2 || /sbin/nologin | 20 |+---------------+-----------+| 子句/部分 | 说明 |
|---|---|
SELECT | 指定要查询的列。 |
shell AS 解释器 | 查询 shell 字段,并将其别名设置为“解释器”。 |
COUNT(name) AS 总人数 | 使用 COUNT 聚合函数统计每个分组中 name 的数目,别名是“总人数”。 |
FROM moershi.user | 指定查询的表为 moershi 数据库下的 user 表。 |
WHERE shell IN (...) | 过滤条件,只统计使用/bin/bash或/sbin/nologin的用户。 |
GROUP BY shell | 根据 shell 字段的值进行分组,将使用相同Shell的用户归为一组进行统计。 |
统计每个部门的总人数 (按照部门表头分组统计name表头值的个数)
mysql> select【涩莱克特】 dept_id , count【kàn特】(name) from【弗乱】moershi.employees【ing普洛伊s】 group【格鲁普】 by dept_id ;+---------+-------------+| dept_id | count【kàn特】(name) |+---------+-------------+| 1 | 8 || 2 | 5 || 3 | 6 || 4 | 55 || 5 | 12 || 6 | 9 || 7 | 35 || 8 | 3 |+---------+-------------+8 rows in set【赛特】 (0.00 sec)四、对查询结果进行排序
当前任务环节
flowchart LR subgraph BottomRow[单表增删改查] direction LR A[分组查询] --> B[对查询结果</n>进行排序] --> C[分组后条件过滤] --> D[新增数据] --> E[修改数据] --> F[删除数据] end
classDef highlight stroke:#f00,stroke-width:2px; class B highlight;排序函数 order【欧朵】 by
| 特性 | 说明 | 示例或关键点 |
|---|---|---|
| 核心功能 | 根据指定的列对查询结果集进行排序。 | 让数据展示更清晰,便于分析和查看。 |
| 基本语法 | `SELECT【涩莱克特】 … FROM【弗乱】 … ORDER【欧朵】 BY column【科勒姆】_name [ASC【阿斯克】 | desc];` |
| 排序方式 | ASC【阿斯克】:升序(默认,可省略)。 desc:降序。 | 若不指定,默认为 ASC【阿斯克】。 |
| 多列排序 | 按多个字段排序,优先级从左到右。 | ORDER【欧朵】 BY column1【科勒姆】 desc, column2【科勒姆】 ASC【阿斯克】; |
| 排序键类型 | 字段名、字段在SELECT【涩莱克特】中的序号(从1开始)、字段别名。 | ORDER【欧朵】 BY 1(按第一列排序)。 |
| 与聚合函数 | 可使用聚合函数结果排序。 | ORDER【欧朵】 BY COUNT【kàn特】(*) desc; |
| NULL【nò】值处理 | NULL【nò】值可能集中出现在开头或末尾,具体取决于数据库系统。 | 需特别注意其默认位置。 |
💡 理解排序规则与语法
ORDER【欧朵】 BY 子句的核心作用是将查询结果按照特定顺序排列。其基本语法遵循以下结构:
SELECT【涩莱克特】 column1【科勒姆】, column2【科勒姆】, ...FROM【弗乱】 table【忒-部】_nameORDER【欧朵】 BY column1【科勒姆】 [ASC【阿斯克】|desc], column2【科勒姆】 [ASC【阿斯克】|desc], ...;这里,ASC【阿斯克】 表示升序(Ascending),desc 表示降序(Descending)。如果省略排序方式,数据库将默认按照升序(ASC【阿斯克】)排列结果 。
🛠️ 掌握多种排序方式
单列排序 这是最基础的排序方式,即根据单个字段的值进行排序。
-- 按产品名称升序排列(ASC【阿斯克】可省略)SELECT【涩莱克特】 prod_name FROM【弗乱】 products ORDER【欧朵】 BY prod_name ASC【阿斯克】;多列排序与优先级
当需要根据多个条件排序时,可以在 ORDER【欧朵】 BY 后列出多个列,它们具有明确的优先级:写在前面的字段优先级最高。数据库会先按第一个字段排序,当第一个字段的值相同时,再按第二个字段排序,以此类推 。
-- 先按价格降序,价格相同的再按产品名称升序排列SELECT【涩莱克特】 prod_id, prod_price, prod_nameFROM【弗乱】 productsORDER【欧朵】 BY prod_price desc, prod_name ASC【阿斯克】;按列位置和别名排序
除了直接使用列名,还可以使用列在 SELECT【涩莱克特】 子句中的位置序号(从1开始)或定义的别名进行排序 。
-- 按位置排序:按SELECT【涩莱克特】中的第二列(prod_price)降序,第三列(prod_name)升序SELECT【涩莱克特】 prod_id, prod_price, prod_nameFROM【弗乱】 productsORDER【欧朵】 BY 2 desc, 3;
-- 按别名排序SELECT【涩莱克特】 prod_id, prod_price AS price, prod_nameFROM【弗乱】 productsORDER【欧朵】 BY price desc;⚠️ 注意关键细节与技巧
- 子句顺序:在 SQL 语句中,
ORDER【欧朵】 BY子句必须位于所有其他子句之后,即正确的书写顺序是:SELECT【涩莱克特】->FROM【弗乱】->WHERE【威尔】->GROUP【格鲁普】 BY->HAVING【嗨夫营】->ORDER【欧朵】 BY。 - NULL【nò】 值的排序:对于包含 NULL【nò】 值的列进行排序时,NULL【nò】 会被集中排列,但具体出现在结果集的开头还是末尾,不同的数据库管理系统可能有不同的默认行为 。
- 与聚合函数结合使用:
ORDER【欧朵】 BY可以根据聚合函数的结果进行排序,这在数据统计和分析时非常有用 。-- 统计每个产品类型的数量,并按数量降序排列SELECT【涩莱克特】 product_type, COUNT【kàn特】(*)FROM【弗乱】 ProductGROUP【格鲁普】 BY product_typeORDER【欧朵】 BY COUNT【kàn特】(*) desc; - 性能考虑:对经常需要排序的列建立索引,可以显著提高排序查询的速度 。
💎 简单总结
ORDER【欧朵】 BY 是控制查询结果展示顺序的关键。记住:ORDER【欧朵】 BY 默认升序,多列排序时左侧列优先级最高,并且它总是 SELECT【涩莱克特】 语句的最后一个子句。
desc : 降序
asc【阿斯克】:升序
命令操作如下所示:
查看满足条件记录的name和uid 字段的值
mysql> select【涩莱克特】 name , uid from【弗乱】 moershi.user where【威尔】uid is not【nuō 特】 null【nò】 and uid between【B豚ing】 100 and 1000 ;+-----------------+------+| name | uid |+-----------------+------+| systemd-network | 192 || polkitd | 999 || chrony | 998 || haproxy | 188 || plj | 1000 |+-----------------+------+5 rows in set【赛特】 (0.00 sec)按照uid升序排序
mysql> select【涩莱克特】 name , uid from【弗乱】 moershi.user where【威尔】uid is not【nuō 特】 null【nò】 and uid between【B豚ing】 100 and 1000 order【欧朵】 by uid asc【阿斯克】;+-----------------+------+| name | uid |+-----------------+------+| haproxy | 188 || systemd-network | 192 || chrony | 998 || polkitd | 999 || plj | 1000 |+-----------------+------+5 rows in set【赛特】 (0.00 sec)按照uid降序排序
mysql> select【涩莱克特】 name , uid from【弗乱】 moershi.user where【威尔】uid is not【nuō 特】 null【nò】 and uid between【B豚ing】 100 and 1000 order【欧朵】 by uid desc;+-----------------+------+| name | uid |+-----------------+------+| plj | 1000 || polkitd | 999 || chrony | 998 || systemd-network | 192 || haproxy | 188 |+-----------------+------+5 rows in set【赛特】 (0.00 sec)查看2015年1月10号员工编号小于10的工资总额
mysql> select【涩莱克特】 employee【ing普洛伊】_id , date , basic【贝斯克】 , bonus【波诺斯】 , basic【贝斯克】+bonus【波诺斯】 as total【偷ò头ō】 from【弗乱】 moershi.salary【晒了瑞】 where【威尔】date=20150110 and employee【ing普洛伊】_id <= 10;+-------------+------------+-----------------+----------------+-----------------+| employee_id | date | basic【贝斯克】 | bonus【波诺斯】 | total【偷ò头ō】 |+-------------+------------+-----------------+----------------+-----------------+| 2 | 2015-01-10 | 17000 | 10000 | 27000 || 3 | 2015-01-10 | 8000 | 2000 | 10000 || 4 | 2015-01-10 | 14000 | 9000 | 23000 || 6 | 2015-01-10 | 14000 | 10000 | 24000 || 7 | 2015-01-10 | 19000 | 10000 | 29000 |+-------------+------------+-----------------+----------------+-----------------+5 rows in set【赛特】 (0.00 sec)以工资总额升序排 ,总额相同按照员工编号升序排
mysql> select【涩莱克特】 employee【ing普洛伊】_id , basic【贝斯克】+bonus【波诺斯】 as total【偷ò头ō】 from【弗乱】 moershi.salary【晒了瑞】 where【威尔】date=20150110 and employee【ing普洛伊】_id <= 10 order【欧朵】 by total【偷ò头ō】 asc【阿斯克】 ,employee【ing普洛伊】_id asc【阿斯克】;+-------------+-------+| employee_id | total【偷ò头ō】 |+-------------+-------+| 3 | 10000 || 4 | 23000 || 6 | 24000 || 2 | 27000 || 7 | 29000 |+-------------+-------+5 rows in set【赛特】 (0.00 sec)五、分组后条件过滤
当前任务环节
flowchart LR subgraph BottomRow[单表增删改查] direction LR A[分组查询] --> B[对查询结果</n>进行排序] --> C[分组后条件过滤] --> D[新增数据] --> E[修改数据] --> F[删除数据] end
classDef highlight stroke:#f00,stroke-width:2px; class C highlight;对分组后的组进行筛选: having【嗨夫营】
| 特性 | HAVING【嗨夫营】 子句 | WHERE【威尔】 子句 |
|---|---|---|
| 核心功能 | 对 分组后的组 进行筛选 | 对 分组前的原始数据行 进行筛选 |
| 作用对象 | 由 GROUP【格鲁普】 BY 产生的分组或聚合函数的结果 | 来自表的单行记录 |
| 聚合函数 | 可以且经常 使用(如 HAVING【嗨夫营】 SUM【桑à姆】(amount) > 100) | 不可以 直接使用 |
| 执行顺序 | 在 GROUP【格鲁普】 BY 之后 | 在 GROUP【格鲁普】 BY 之前 |
| 典型应用 | 筛选满足条件的组,例如”总销售额大于1万的部门” | 筛选满足条件的行,例如”年龄大于30岁的员工” |
💡 理解 HAVING【嗨夫营】 的工作原理
你可以将 SQL 查询的执行顺序理解为:FROM【弗乱】 → WHERE【威尔】 → GROUP【格鲁普】 BY → HAVING【嗨夫营】 → SELECT【涩莱克特】 → ORDER【欧朵】 BY 。
- FROM【弗乱】:首先从表中获取数据。
- WHERE【威尔】:接着,
WHERE【威尔】子句会像一道筛子,根据你设定的条件(比如amount > 100)对原始数据行进行过滤,只保留符合条件的行。这一步会在分组之前有效减少需要处理的数据量 。 - GROUP【格鲁普】 BY:然后,数据库会按照指定的列对
WHERE【威尔】过滤后的结果进行分组,将具有相同值的行归到同一组中。 - HAVING【嗨夫营】:最后,
HAVING【嗨夫营】子句登场,它基于聚合函数的结果(例如组的平均工资、总销售额等)对这些分组进行筛选,只保留满足条件的分组 。
🛠️ HAVING【嗨夫营】 的典型用法场景
1. 基础用法:筛选聚合结果 这是 HAVING【嗨夫营】 最经典的场景,用于找出符合某项统计条件的组。
-- 找出总消费金额超过1000元的客户SELECT【涩莱克特】 customer_id, SUM【桑à姆】(amount) AS total【偷ò头ō】_spendingFROM【弗乱】 ordersGROUP【格鲁普】 BY customer_idHAVING【嗨夫营】 SUM【桑à姆】(amount) > 1000;2. 结合 WHERE【威尔】 使用:提高查询效率
你可以同时使用 WHERE【威尔】 和 HAVING【嗨夫营】,让 WHERE【威尔】 先过滤掉不需要的原始数据,减少分组计算的压力,再由 HAVING【嗨夫营】 完成最终筛选 。
-- 找出在2024年下单次数超过5次的客户SELECT【涩莱克特】 customer_id, COUNT【kàn特】(order_id) AS order_count【kàn特】FROM【弗乱】 ordersWHERE【威尔】 YEAR(order_date) = 2024 -- 先筛选出2024年的订单,提高效率GROUP【格鲁普】 BY customer_idHAVING【嗨夫营】 COUNT【kàn特】(order_id) > 5; -- 再筛选出订单数超过5的客户3. 多条件组合
在 HAVING【嗨夫营】 子句中,你可以使用 AND、OR 来连接多个聚合条件 。
-- 找出总消费超过2000元且平均订单金额大于500元的客户SELECT【涩莱克特】 customer_id, SUM【桑à姆】(amount) AS total【偷ò头ō】, AVG(amount) AS avg_amountFROM【弗乱】 ordersGROUP【格鲁普】 BY customer_idHAVING【嗨夫营】 SUM【桑à姆】(amount) > 2000 AND AVG(amount) > 500;⚠️ 常见误区与注意事项
- 不要在 HAVING【嗨夫营】 中过滤非聚合的原始字段:如果过滤条件不涉及聚合计算,只是针对某一行的原始字段,那么应该把它放在
WHERE【威尔】子句,而不是HAVING【嗨夫营】中。放在WHERE【威尔】子句效率更高,因为它能在分组前就减少数据量 。当然,如果该字段是分组字段,则可以在 HAVING【嗨夫营】 中使用 。 - HAVING【嗨夫营】 通常依赖于 GROUP【格鲁普】 BY:
HAVING【嗨夫营】子句通常与GROUP【格鲁普】 BY一起出现。除非你的查询是对整个表进行聚合(例如SELECT【涩莱克特】 COUNT【kàn特】(*) FROM【弗乱】 table【忒-部】 HAVING【嗨夫营】 COUNT【kàn特】(*) > 10),否则缺少GROUP【格鲁普】 BY会导致语法错误 。 - 别名使用:在某些数据库系统中,
HAVING【嗨夫营】子句可以直接使用在SELECT【涩莱克特】中为聚合函数定义的别名,例如HAVING【嗨夫营】 total【偷ò头ō】_spending > 1000,这可以使查询更简洁 。但为了更好的兼容性,直接在 HAVING【嗨夫营】 中写完整的聚合表达式是更稳妥的做法。
💎 简单总结
记住一个核心原则:当你需要对 分组后的统计结果 设置条件时,就是 HAVING【嗨夫营】 子句大显身手的时候。它与 GROUP【格鲁普】 BY 是形影不离的好搭档,一个负责分组,一个负责对分组后的结果进行筛选 。
命令操作如下所示:
查找部门总人数少于10人的部门名称及人数
//第一步,查看所有员工的部门名称select【涩莱克特】 dept_id , name from【弗乱】 moershi.employees【ing普洛伊s】;//第二步,按部门编号分组 统计人名个数mysql> select【涩莱克特】 dept_id , count【kàn特】(name) as numbers【nèn波s】 from【弗乱】 moershi.employees【ing普洛伊s】 group【格鲁普】 by dept_id;+---------+-------------------+| dept_id | numbers【nèn波s】 |+---------+-------------------+| 1 | 8 || 2 | 5 || 3 | 6 || 4 | 55 || 5 | 12 || 6 | 9 || 7 | 35 || 8 | 3 |+---------+-------------------+8 rows in set【赛特】 (0.00 sec)//第三步,查找部门人数少于10人的部门名称及人数mysql> select【涩莱克特】 dept_id , count【kàn特】(name) as numbers【nèn波s】 from【弗乱】 moershi.employees【ing普洛伊s】 group【格鲁普】 by dept_id having【嗨夫营】 numbers【nèn波s】 < 10;+---------+-------------------+| dept_id | numbers【nèn波s】 |+---------+-------------------+| 1 | 8 || 2 | 5 || 3 | 6 || 6 | 9 || 8 | 3 |+---------+-------------------+5 rows in set【赛特】 (0.00 sec)六、分页查询 limit【类梅特】
在 MySQL 中,LIMIT【类梅特】是用于实现分页查询的关键字,它能够精确控制查询结果返回的记录条数和起始位置 。下面这个表格能帮你快速抓住它的核心用法。
| 特性 | 语法格式A | 语法格式B (MySQL 8.0+ 推荐) | 说明 |
|---|---|---|---|
| 基本语法 | LIMIT【类梅特】 offset【哦夫赛特】, row_count | LIMIT【类梅特】 row_count OFFSET【哦夫赛特】 offset【哦夫赛特】 | 从第 offset【哦夫赛特】 条记录开始,返回 row_count 条记录。 |
| 偏移量(offset【哦夫赛特】) | 从 0 开始计数 | 从 0 开始计数 | 例如,offset【哦夫赛特】 为 0 表示从第一条记录开始。 |
| 简化查询 | LIMIT【类梅特】 row_count | - | 等同于 LIMIT【类梅特】 0, row_count,返回前 row_count 条。 |
| 分页公式 | LIMIT【类梅特】 (pageNum - 1) * pageSize, pageSize | LIMIT【类梅特】 pageSize OFFSET【哦夫赛特】 (pageNum - 1) * pageSize | pageNum: 当前页码(从1开始); pageSize: 每页条数。 |
💡 如何使用 LIMIT【类梅特】 进行分页
掌握 LIMIT【类梅特】 的最佳方式就是动手实践。假设我们有一张 users 表,需要实现每页显示10条记录的分页查询。
-
查询第1页数据
-- 使用语法ASELECT【涩莱克特】 * FROM【弗乱】 users ORDER BY id LIMIT【类梅特】 0, 10;-- 使用语法B (推荐,语义更清晰)SELECT【涩莱克特】 * FROM【弗乱】 users ORDER BY id LIMIT【类梅特】 10 OFFSET【哦夫赛特】 0;这两条语句是等价的,都返回最前面的10条记录。
-
查询第2页数据
-- 偏移量 offset【哦夫赛特】 = (2 - 1) * 10 = 10SELECT【涩莱克特】 * FROM【弗乱】 users ORDER BY id LIMIT【类梅特】 10, 10;-- 或SELECT【涩莱克特】 * FROM【弗乱】 users ORDER BY id LIMIT【类梅特】 10 OFFSET【哦夫赛特】 10;这里从第11条记录开始(偏移10条),再取10条记录。
⚠️ 重要提示:分页查询必须与 ORDER BY 子句配合使用,以确保每次查询结果的顺序一致。否则,数据库返回的记录顺序可能是随机的,导致分页混乱。
🚀 如何优化大偏移量下的分页性能
当需要查询的页码非常靠后时(例如 LIMIT【类梅特】 100000, 10),直接使用 LIMIT【类梅特】 会产生性能问题,因为数据库需要先扫描并丢弃掉偏移量指定的前大量记录,效率很低。
一个高效的优化策略是使用基于主键(或唯一索引)的范围查询来替代大的偏移量。这种方法的原理是记录上一页最后一条记录的唯一ID,然后以此为起点获取下一页。
-- 假设已知上一页最后一条记录的id是10000-- 传统的低效写法:SELECT【涩莱克特】 * FROM【弗乱】 table【忒-部】 ORDER BY id LIMIT【类梅特】 10000, 10;-- 优化后的高效写法:SELECT【涩莱克特】 * FROM【弗乱】 table【忒-部】 WHERE【威尔】 id > 10000 ORDER BY id LIMIT【类梅特】 10;这种方法通过索引直接定位到起始位置,跳过了大量数据的扫描,使得查询速度与页码基本无关。它非常适合实现“上一页/下一页”这种连续翻页的场景。
💎 简单总结
LIMIT【类梅特】 是实现MySQL分页的核心。记住:务必搭配 ORDER BY 保证顺序,在需要跳转到很靠后的页面时,尽量使用基于唯一ID的范围查询来优化性能。
命令操作如下所示:
关键字:limit【类梅特】 数字1,数字2
数字1:起始行
数字2:每页显示总行数
例如:
limit【类梅特】 1 ; 显示查询结果的第1行limit【类梅特】 3 ; 显示查询结果的前3行limit【类梅特】 10 ; 显示查询结果的前10行limit【类梅特】 0,1 ; 从查询结果的第1行开始显示,共显示1行limit【类梅特】 3,5 ; 从查询结果的第4行开始显示,共显示5行limit【类梅特】 10,10; 从查询结果的第11行开始显示,共显示10行查看有解释器的用户信息
mysql> select【涩莱克特】 * from【弗乱】moershi.user where【威尔】shell is not【nuō 特】 null【nò】 ;只显示查询结果的第1行
mysql> select【涩莱克特】 * from【弗乱】moershi.user where【威尔】shell is not【nuō 特】 null【nò】 limit【类梅特】 1;只显示查询结果的前3行
mysql> select【涩莱克特】 * from【弗乱】moershi.user where【威尔】shell is not【nuō 特】 null【nò】 limit【类梅特】 3;仅仅显示查询结果的第1行 到 第3 (0 表示查询结果的第1行)
mysql> select【涩莱克特】 * from【弗乱】user where【威尔】shell is not【nuō 特】 null【nò】 limit【类梅特】 0,3;从查询结果的第4行开始显示,共显示3行
mysql> select【涩莱克特】 name,uid , gid , shell from【弗乱】user where【威尔】shell is not【nuō 特】 null【nò】 limit【类梅特】 3,3;查看uid 号最大的用户名和UID
mysql> select【涩莱克特】 name , uid from【弗乱】 moershi.user order【欧朵】 by uid desc limit【类梅特】 1 ;+-----------+-------+| name | uid |+-----------+-------+| nfsnobody | 65534 |+-----------+-------+1 row in set【赛特】 (0.00 sec)六、新增数据
当前任务环节
flowchart LR subgraph BottomRow[单表增删改查] direction LR A[分组查询] --> B[对查询结果</n>进行排序] --> C[分组后条件过滤] --> D[新增数据] --> E[修改数据] --> F[删除数据] end
classDef highlight stroke:#f00,stroke-width:2px; class D highlight;命令操作如下所示:
查看表头
desc
在SQL中,desc 是一个常用的关键字,但它根据使用场景的不同,主要有两种截然不同的含义和用法。为了帮助你快速区分,我先用一个表格来总结它的核心用途。
| 用途分类 | 语法/上下文 | 核心功能 | 简要说明 |
|---|---|---|---|
| 查看表结构 | desc table【忒-部】_name; | 显示数据表的详细结构信息(列名、类型、约束等)。 | 主要用于数据库管理和调试,是一个命令。 |
| 指定查询排序 | ORDER BY column【科勒姆】_name desc; | 在查询结果中,将指定列按降序(从大到小)排列。 | 必须与 ORDER BY 子句搭配使用,是一个关键字。 |
📊 作为表结构查看命令
这是 desc 命令最直接的用途,相当于数据表的“说明书”。执行后,它会返回一个包含以下字段的表格,帮助你全面了解表的设计 :
| 输出列 | 含义说明 | 备注/示例 |
|---|---|---|
| Field | 表中每一列(字段)的名称。 | 例如 id, name, email。 |
| Type | 该列字段的数据类型。 | 例如 int(11), varchar(255), date。 |
| Null【nò】 | 该列是否允许存储空值(NULL【nò】)。 | YES 表示允许,NO 表示不允许。 |
| Key | 表示该列是否定义了键(索引)。 | PRI(主键),UNI(唯一索引),MUL(可重复的非唯一索引前导列或唯一索引的组成部分但可含空值),或为空(无索引)。 |
| Default | 该列的默认值。如果未显式赋值且未指定默认值,多数情况下显示 NULL【nò】。 | 例如,可设置为 CURRENT_TIMESTAMP。 |
| Extra | 额外信息,如 auto_increment(自动递增)。 | 常见于主键ID列。 |
如何使用:
-- 查看名为 'employees【ing普洛伊s】' 的表结构desc employees【ing普洛伊s】;💡 如何避免混淆?
记住一个简单的规则:看它的位置。
- 如果
desc后面直接跟着表名(如desc employees【ing普洛伊s】;),它就是查看表结构的命令。 - 如果
desc前面有ORDER BY关键字(如ORDER BY salary【晒了瑞】 desc;),它就是指定降序排序的关键字。
命令操作如下所示:
mysql> desc moershi.user;+---------------------+-------------+------------+-----+---------------------+----------------+| Field | Type | Null【nò】 | Key| Default【迪-佛特】 | Extra |+---------------------+-------------+------------+-----+---------------------+----------------+| id | int | NO | PRI | NULL【nò】 | auto_increment || name | char(20) | YES | | NULL【nò】 | || password | char(1) | YES | | NULL【nò】 | || uid | int | YES | | NULL【nò】 | || gid | int | YES | | NULL【nò】 | || comment【坑门特】 | varchar(50) | YES | | NULL【nò】 | || homedir【home-跌儿】 | varchar(80) | YES | | NULL【nò】 | || shell | char(30) | YES | | NULL【nò】 | |+---------------------+-------------+------------+-----+---------------------+----------------+8 rows in set【赛特】 (0.00 sec)插入1条记录给所有表头赋值
(给所有表头赋值表头可以省略不写)id表头的值不能重复,主键的知识在后边课程里讲
mysql> insert【因涩特】 into【因兔】 moershi.user values【挖柳斯】(40,"jingyaya","x",1001,1001,"teacher","/home/jingyaya","/bin/bash");Query OK, 1 row affected (0.05 sec)查看表记录
mysql> select【涩莱克特】 * from【弗乱】 moershi.user where【威尔】name="jingyaya";+----+----------+----------+------+------+------------------+------------------------+-----------+| id | name | password | uid | gid | comment【坑门特】 | homedir【home-跌儿】 | shell |+----+----------+----------+------+------+------------------+------------------------+-----------+| 40 | jingyaya | x | 1001 | 1001 | teacher | /home/jingyaya | /bin/bash |+----+----------+----------+------+------+------------------+------------------------+-----------+1 row in set【赛特】 (0.00 sec)mysql>插入多行记录给所有列赋值
insert【因涩特】 into【因兔】 moershi.user values【挖柳斯】(41,"jingyaya2","x",1002,1002,"teacher","/home/jingyaya2","/bin/bash"),(42,"jingyaya3","x",1003,1003,"teacher","/home/jingyaya3","/bin/bash");插入1行给指定列赋值,必须写列名,没赋值的列 没有数据 后通过设置的默认值赋值
mysql> insert【因涩特】 into【因兔】 moershi.user(name,uid,shell)values【挖柳斯】("benben",1002,"/sbin/nologin");插入多行给指定列赋值,必须写列名,没赋值的列 没有数据 后通过设置的默认值赋值
mysql> insert【因涩特】 into【因兔】 moershi.user(name,uid,shell)values【挖柳斯】("benben2",1002,"/sbin/nologin"),("benben3",1003,"/sbin/nologin");查看记录
mysql> select【涩莱克特】 * from【弗乱】moershi.user where【威尔】name like "benben%";+----+---------+----------+------+------+-------------------+---------------------+------------------------------+| id | name | password | uid | gid | comment【坑门特】 | homedir【home-跌儿】 | shell |+----+---------+----------+------+------+-------------------+---------------------+------------------------------+| 41 | benben | NULL | 1002 | NULL | NULL | NULL | /sbin/nologin【诺劳京(白话)】 || 42 | benben2 | NULL | 1002 | NULL | NULL | NULL | /sbin/nologin【诺劳京(白话)】 || 43 | benben3 | NULL | 1003 | NULL | NULL | NULL | /sbin/nologin【诺劳京(白话)】 |+----+---------+----------+------+------+-------------------+---------------------+------------------------------+3 rows in set【赛特】 (0.00 sec)使用select【涩莱克特】查询结果赋值(查询表头个数和 插入记录命令表头个数要一致)
mysql> select【涩莱克特】 user from【弗乱】 mysql.user;+------------------+| user |+------------------+| mysql.infoschema || mysql.session || mysql.sys || root |+------------------+4 rows in set【赛特】 (0.00 sec)mysql> insert【因涩特】 into【因兔】 moershi.user(name) (select【涩莱克特】 user from【弗乱】 mysql.user);Query OK, 4 rows affected (0.09 sec)Records: 4 Duplicates: 0 Warnings: 0查看插入后的数据
mysql> select【涩莱克特】 * from【弗乱】 moershi.user where【威尔】name like "mysql%" or name="root";+----+------------------+----------+------+------+-----------------------+------------------------+------------+| id | name | password | uid | gid | comment【坑门特】 | homedir【home-跌儿】 | shell |+----+------------------+----------+------+------+-----------------------+------------------------+------------+| 1 | root | x | 0 | 0 | root | /root | /bin/bash || 26 | mysql | x | 27 | 27 | MySQL Server | /var/lib/mysql | /bin/false || 44 | mysql.infoschema | NULL | NULL | NULL | NULL | NULL | NULL || 45 | mysql.session | NULL | NULL | NULL | NULL | NULL | NULL || 46 | mysql.sys | NULL | NULL | NULL | NULL | NULL | NULL || 47 | root | NULL | NULL | NULL | NULL | NULL | NULL |+----+------------------+----------+------+------+-----------------------+------------------------+------------+6 rows in set【赛特】 (0.00 sec)使用set【赛特】命令赋值
mysql> insert【因涩特】 into【因兔】 moershi.user set【赛特】 name="yaya" , uid=99 , gid=99 ;Query OK, 1 row affected (0.06 sec)mysql> select【涩莱克特】 * from【弗乱】 moershi.user where【威尔】name="yaya";+----+------+----------+------+------+------------------+----------------------+-------+| id | name | password | uid | gid | comment【坑门特】 | homedir【home-跌儿】 | shell |+----+------+----------+------+------+------------------+----------------------+-------+| 28 | yaya | NULL | 99 | 99 | NULL | NULL | NULL |+----+------+----------+------+------+------------------+----------------------+-------+1 row in set【赛特】 (0.00 sec)七、修改数据
当前任务环节
flowchart LR subgraph BottomRow[单表增删改查] direction LR A[分组查询] --> B[对查询结果</n>进行排序] --> C[分组后条件过滤] --> D[新增数据] --> E[修改数据] --> F[删除数据] end
classDef highlight stroke:#f00,stroke-width:2px; class E highlight;命令操作如下所示:
//修改前查看mysql> select【涩莱克特】 name , comment【坑门特】 from【弗乱】moershi.user where【威尔】id <= 10 ;+----------+--------------------+| name | comment【坑门特】 |+----------+--------------------+| root | root || bin | bin || daemon | daemon || adm | adm || lp | lp || sync | sync || shutdown | shutdown || halt | halt || mail | mail || operator | operator |+----------+--------------------+10 rows in set【赛特】 (0.00 sec)//修改符合条件mysql> update【阿普 dei 特】 moershi.user set【赛特】 comment【坑门特】=NULL【nò】 where【威尔】id <= 10 ;Query OK, 10 rows affected (0.09 sec)Rows matched: 10 Changed: 10 Warnings: 0//修改后查看mysql> select【涩莱克特】 name , comment【坑门特】 from【弗乱】moershi.user where【威尔】id <= 10 ;+----------+------------------+| name | comment【坑门特】 |+----------+------------------+| root | NULL || bin | NULL || daemon | NULL || adm | NULL || lp | NULL || sync | NULL || shutdown | NULL || halt | NULL || mail | NULL || operator | NULL |+----------+------------------+10 rows in set【赛特】 (0.00 sec)[root@localhost ~]#//修改前查看mysql> select【涩莱克特】 name , homedir from【弗乱】moershi.user;+------------------+--------------------+| name | homedir【home-跌儿】|+------------------+--------------------+| root | /root || bin | /bin || daemon | /sbin || adm | /var/adm || lp | /var/spool/lpd || sync | /sbin || shutdown | /sbin || halt | /sbin || mail | /var/spool/mail || operator | /root || games | /usr/games || ftp | /var/ftp || nobody | / || systemd-network | / || dbus | / || polkitd | / || sshd | /var/empty/sshd || postfix | /var/spool/postfix || chrony | /var/lib/chrony || rpc | /var/lib/rpcbind || rpcuser | /var/lib/nfs || nfsnobody | /var/lib/nfs || haproxy | /var/lib/haproxy || plj | /home/plj || apache | /usr/share/httpd || mysql | /var/lib/mysql || bob | NULL || jerrya | NULL || jingyaya | /home/jingyaya || benben | NULL || benben2 | NULL || benben3 | NULL || mysql.infoschema | NULL || mysql.session | NULL || mysql.sys | NULL || root | NULL |+------------------+--------------------+36 rows in set【赛特】 (0.00 sec)//不加条件批量修改mysql> update【阿普 dei 特】 moershi.user set【赛特】 homedir="/student" ;Query OK, 36 rows affected (0.09 sec)Rows matched: 36 Changed: 36 Warnings: 0//修改后查看mysql> select【涩莱克特】 name , homedir from【弗乱】moershi.user;+------------------+---------------------+| name | homedir【home-跌儿】|+------------------+---------------------+| root | /student || bin | /student || daemon | /student || adm | /student || lp | /student || sync | /student || shutdown | /student || halt | /student || mail | /student || operator | /student || games | /student || ftp | /student || nobody | /student || systemd-network | /student || dbus | /student || polkitd | /student || sshd | /student || postfix | /student || chrony | /student || rpc | /student || rpcuser | /student || nfsnobody | /student || haproxy | /student || plj | /student || apache | /student || mysql | /student || bob | /student || jerrya | /student || jingyaya | /student || benben | /student || benben2 | /student || benben3 | /student || mysql.infoschema | /student || mysql.session | /student || mysql.sys | /student || root | /student |+------------------+---------------------+36 rows in set【赛特】 (0.00 sec)八、删除数据
当前任务环节
flowchart LR subgraph BottomRow[单表增删改查] direction LR A[分组查询] --> B[对查询结果</n>进行排序] --> C[分组后条件过滤] --> D[新增数据] --> E[修改数据] --> F[删除数据] end
classDef highlight stroke:#f00,stroke-width:2px; class F highlight;命令操作如下所示:
//删除前查看mysql> select【涩莱克特】 * from【弗乱】moershi.user where【威尔】id <= 10 ;+----+----------+----------+------+------+------------------+---------------------+----------------+| id | name | password | uid | gid | comment【坑门特】 | homedir【home-跌儿】| shell |+----+----------+----------+------+------+------------------+---------------------+----------------+| 1 | root | x | 0 | 0 | NULL | /student | /bin/bash || 2 | bin | x | 1 | 1 | NULL | /student | /sbin/nologin || 3 | daemon | x | 2 | 2 | NULL | /student | /sbin/nologin || 4 | adm | x | 3 | 4 | NULL | /student | /sbin/nologin || 5 | lp | x | 4 | 7 | NULL | /student | /sbin/nologin || 6 | sync | x | 5 | 0 | NULL | /student | /bin/sync || 7 | shutdown | x | 6 | 0 | NULL | /student | /sbin/shutdown || 8 | halt | x | 7 | 0 | NULL | /student | /sbin/halt || 9 | mail | x | 8 | 12 | NULL | /student | /sbin/nologin || 10 | operator | x | 11 | 0 | NULL | /student | /sbin/nologin |+----+----------+----------+------+------+------------------+---------------------+----------------+10 rows in set【赛特】 (0.00 sec)//仅删除与条件匹配的行mysql> delete【迪利特】 from【弗乱】moershi.user where【威尔】id <= 10 ;Query OK, 10 rows affected (0.06 sec)//查不到符合条件的记录了mysql> select【涩莱克特】 * from【弗乱】moershi.user where【威尔】id <= 10 ;Empty set【赛特】 (0.00 sec)九、作业
1 选择题
-
在
employees【ing普洛伊s】表中,要将查询结果按照hire_date降序排列,应使用以下哪个关键字?B A.ASC【阿斯克】B.descC.GROUP【格鲁普】 BYD.HAVING【嗨夫营】 -
若要在
departments【迪帕踢门特s】表中新增一条记录,dept_name为 ‘市场部’,以下 SQL 语句正确的是? A A.INSERT【因涩特】 INTO【因兔】 departments【迪帕踢门特s】 (dept_name) VALUES【挖柳斯】 ('市场部');B.UPDATE【阿普 dei 特】 departments【迪帕踢门特s】 SET【赛特】 dept_name = '市场部';C.DELETE【迪利特】 from【弗乱】departments【迪帕踢门特s】 where【威尔】dept_name = '市场部';D.SELECT * from【弗乱】departments【迪帕踢门特s】 where【威尔】dept_name = '市场部'; -
在
salary【晒了瑞】表中,要统计每个员工的总薪资(basic【贝斯克】与bonus【波诺斯】之和),并按照总薪资降序排列,以下 SQL 语句正确的是?A A.SELECT employee【ing普洛伊】_id, SUM(basic【贝斯克】 + bonus【波诺斯】) AS total【偷ò头ō】_salary【晒了瑞】 from【弗乱】salary【晒了瑞】 GROUP【格鲁普】 BY employee【ing普洛伊】_id ORDER【欧朵】 BY total【偷ò头ō】_salary【晒了瑞】 desc;B.SELECT employee【ing普洛伊】_id, AVG(basic【贝斯克】 + bonus【波诺斯】) AS total【偷ò头ō】_salary【晒了瑞】 from【弗乱】salary【晒了瑞】 GROUP【格鲁普】 BY employee【ing普洛伊】_id ORDER【欧朵】 BY total【偷ò头ō】_salary【晒了瑞】 desc;C.SELECT employee【ing普洛伊】_id, SUM(basic【贝斯克】 + bonus【波诺斯】) AS total【偷ò头ō】_salary【晒了瑞】 from【弗乱】salary【晒了瑞】 ORDER【欧朵】 BY total【偷ò头ō】_salary【晒了瑞】 desc;D.SELECT employee【ing普洛伊】_id, AVG(basic【贝斯克】 + bonus【波诺斯】) AS total【偷ò头ō】_salary【晒了瑞】 from【弗乱】salary【晒了瑞】 ORDER【欧朵】 BY total【偷ò头ō】_salary【晒了瑞】 desc; -
在分组查询中,
HAVING【嗨夫营】子句的作用是?B A. 对分组前的数据进行过滤 B. 对分组后的数据进行过滤 C. 对查询结果进行排序 D. 对数据进行分组 -
要删除
employees【ing普洛伊s】表中employee【ing普洛伊】_id为 10 的记录,以下 SQL 语句正确的是?B A.UPDATE【阿普 dei 特】 employees SET【赛特】 employee_id = NULL【nò】 where【威尔】employee_id = 10;B.DELETE【迪利特】 from【弗乱】employees where【威尔】employee_id = 10;C.SELECT * from【弗乱】employees where【威尔】employee_id = 10;D.INSERT【因涩特】 INTO【因兔】 employees (employee_id) VALUES【挖柳斯】 (10);
2 简答题
-
简述
WHERE子句和HAVING子句的区别。 答:WHERE是对分组前的原始数据行进行筛选HAVING是对分组后的组进行筛选 -
在
UPDATE语句中,SET关键字的作用是什么? 答:SET关键字的作用是指定要修改的内容 -
新增数据时,
INSERT INTO语句有哪几种常见的使用方式? 答:1、向表中插入一条完整记录。 2、向表中插入部分字段的值(未指定的字段将采用默认值或自动生成的值,如自增主键)。 3、一次性插入多条记录(批量插入)。 4、结合 SELECT语句,将查询结果插入到另一个表中。
3 操作题
- 在
employees表中新增一条记录,name为 ‘李四’,hire_date为 ‘2025-06-01’,birth_date为 ‘1990-05-10’,email为 ‘lisi@example.com’,phone_number为 ‘13800138000’,dept_id为 2。
mysql> insert into moershi.employees values(134,"李四","2025-06-01","1990-05-10","lisi@example.com",13800138000,2);Query OK, 1 row affected (0.19 sec)
mysql> select * from moershi.employees where employee_id=134;+-------------+--------+------------+------------+------------------+--------------+---------+| employee_id | name | hire_date | birth_date | email | phone_number | dept_id |+-------------+--------+------------+------------+------------------+--------------+---------+| 134 | 李四 | 2025-06-01 | 1990-05-10 | lisi@example.com | 13800138000 | 2 |+-------------+--------+------------+------------+------------------+--------------+---------+1 row in set (0.00 sec)- 将
departments表中dept_id为 3 的dept_name修改为 ‘研发部’。
mysql> select * from moershi.departments where dept_id=3;+---------+-----------+| dept_id | dept_name |+---------+-----------+| 3 | 运维部 |+---------+-----------+1 row in set (0.00 sec)
mysql> update moershi.departments set dept_name="研发部" where dept_id=3;Query OK, 1 row affected (0.13 sec)Rows matched: 1 Changed: 1 Warnings: 0
mysql> select * from moershi.departments where dept_id=3;+---------+-----------+| dept_id | dept_name |+---------+-----------+| 3 | 研发部 |+---------+-----------+1 row in set (0.00 sec)- 统计
salary表中每个员工的平均基本工资(basic列),只显示平均基本工资大于 5000 的员工信息,并按照平均基本工资降序排列。
mysql> select employee_id,avg(basic) as 平均工资 from moershi.salary group by employee_id having avg(basic) > 5000 order by 平均工资 desc;+-------------+--------------+| employee_id | 平均工资 |+-------------+--------------+| 103 | 27023.3333 || 19 | 26520.0000 || 104 | 24251.1429 || 117 | 23905.0000 || 8 | 23741.5600 || 86 | 22766.9444 || 112 | 22766.9444 || 10 | 22314.9286 || 16 | 22314.9286 || 102 | 21911.2462 || 119 | 21628.2083 || 118 | 21628.2083 || 7 | 21628.2083 || 106 | 21628.2083 || 105 | 20490.1528 || 122 | 20490.1528 || 91 | 20311.2979 || 76 | 19351.5972 || 88 | 19351.5972 || 2 | 19351.5972 || 95 | 18213.9028 || 98 | 18213.9028 || 123 | 18213.9028 || 92 | 18213.9028 || 17 | 18213.9028 || 107 | 18015.6818 || 80 | 17644.5789 || 1 | 17279.1000 || 5 | 17125.8000 || 110 | 17074.6528 || 108 | 17074.6528 || 13 | 17074.6528 || 131 | 16653.7692 || 125 | 16525.1887 || 127 | 16427.4107 || 81 | 15991.9286 || 4 | 15936.5972 || 6 | 15936.5972 || 11 | 15936.5972 || 12 | 15506.8125 || 85 | 14798.0417 || 79 | 14798.0417 || 99 | 14798.0417 || 75 | 13760.0417 || 129 | 13659.9861 || 94 | 13659.9861 || 96 | 13659.9861 || 124 | 13659.9861 || 100 | 13659.9861 || 9 | 12931.4545 || 115 | 12521.2500 || 14 | 11383.2083 || 120 | 11044.4242 || 15 | 11044.4242 || 128 | 10337.5000 || 78 | 10244.4722 || 126 | 10244.4722 || 84 | 10244.4722 || 113 | 10244.4722 || 132 | 10244.4722 || 83 | 9106.9444 || 121 | 9106.9444 || 116 | 9106.9444 || 3 | 9106.9444 || 130 | 9106.9444 || 82 | 7967.6944 || 93 | 7967.6944 || 109 | 7967.6944 || 77 | 7967.6944 || 87 | 7281.6410 || 89 | 6829.6389 || 101 | 6829.6389 || 18 | 6829.6389 || 97 | 6829.6389 || 114 | 5690.9028 || 111 | 5690.9028 || 90 | 5690.9028 || 133 | 5690.9028 |+-------------+--------------+78 rows in set (0.01 sec)
mysql>
- 删除
employees表中dept_id为 4 的所有记录。
mysql> --查询删除前数据mysql> select * from moershi.employees where dept_id=4;+-------------+-----------+------------+------------+---------------------------+--------------+---------+| employee_id | name | hire_date | birth_date | email | phone_number | dept_id |+-------------+-----------+------------+------------+---------------------------+--------------+---------+| 20 | 蒋红 | 2017-12-29 | 1978-01-24 | jianghong@tedu.cn | 15852915398 | 4 || 21 | 曹宁 | 2004-06-07 | 1988-01-05 | caoning@tedu.cn | 14513022304 | 4 || 22 | 吕刚 | 2014-01-18 | 1980-06-24 | lvgang@tedu.cn | 18136987619 | 4 || 23 | 王莉 | 2021-02-04 | 1972-12-19 | wangli@moershi.com | 15376329290 | 4 || 24 | 邓秀芳 | 2020-09-08 | 1980-12-12 | dengxiufang@moershi.com | 15884927117 | 4 || 25 | 邵佳 | 2011-08-15 | 1978-11-28 | shaojia@tedu.cn | 13296016750 | 4 || 26 | 党丽 | 2014-03-14 | 1978-12-30 | dangli@moershi.com | 13166234580 | 4 || 27 | 梁勇 | 2007-01-19 | 1997-11-12 | liangyong@tedu.cn | 15307868657 | 4 || 28 | 郑秀珍 | 2011-04-28 | 1972-09-01 | zhengxiuzhen@moershi.com | 14543186401 | 4 || 29 | 胡秀云 | 2003-11-03 | 2000-05-14 | huxiuyun@tedu.cn | 18212266720 | 4 || 30 | 邢淑兰 | 2011-07-02 | 1989-06-17 | xingshulan@moershi.com | 13032270370 | 4 || 31 | 刘海燕 | 2018-01-06 | 1982-08-21 | liuhaiyan@moershi.com | 15064354651 | 4 || 32 | 冯建国 | 2014-05-28 | 1980-01-26 | fengjianguo@tedu.cn | 13344957322 | 4 || 33 | 曹杰 | 2017-01-04 | 1975-07-03 | caojie@moershi.com | 13244741822 | 4 || 34 | 苗桂花 | 2001-10-06 | 1974-01-26 | miaoguihua@tedu.cn | 18124884107 | 4 || 35 | 袁建平 | 2020-09-17 | 1990-07-25 | yuanjianping@moershi.com | 13580624147 | 4 || 36 | 黄淑兰 | 2019-08-29 | 1988-02-08 | huangshulan@tedu.cn | 14568738205 | 4 || 37 | 朱淑兰 | 2002-04-26 | 1977-12-10 | zhushulan@tedu.cn | 13635439422 | 4 || 38 | 曹凯 | 2006-07-23 | 1995-11-07 | caokai@moershi.com | 15172694474 | 4 || 39 | 张倩 | 2009-10-27 | 2000-04-27 | zhangqian@tedu.cn | 15053279648 | 4 || 40 | 王淑珍 | 2013-09-21 | 1995-05-06 | wangshuzhen@tedu.cn | 18583012709 | 4 || 41 | 陈玉 | 2011-08-20 | 1985-06-14 | chenyu@tedu.cn | 13632957562 | 4 || 42 | 陈玉英 | 2020-10-03 | 1996-05-19 | chenyuying@tedu.cn | 15100520600 | 4 || 43 | 王波 | 2008-06-14 | 1979-05-26 | wangbo@tedu.cn | 15236208918 | 4 || 44 | 黄文 | 2010-06-05 | 1983-01-30 | huangwen@tedu.cn | 13688719481 | 4 || 45 | 陈刚 | 2010-10-26 | 1978-05-10 | chengang@tedu.cn | 13679861175 | 4 || 46 | 罗建华 | 2004-06-20 | 1989-02-23 | luojianhua@tedu.cn | 13176305978 | 4 || 47 | 黄建平 | 2009-04-09 | 1995-07-15 | huangjianping@moershi.com | 18517722322 | 4 || 48 | 范秀英 | 2001-03-13 | 1996-06-01 | fanxiuying@moershi.com | 18252125689 | 4 || 49 | 李平 | 2003-10-28 | 1998-07-24 | liping@tedu.cn | 18526198243 | 4 || 50 | 臧龙 | 2011-10-06 | 1976-05-11 | zanglong@moershi.com | 13474064425 | 4 || 51 | 吴静 | 2017-09-26 | 1983-08-04 | wujing@tedu.cn | 14762137325 | 4 || 52 | 张冬梅 | 2010-10-26 | 1982-05-09 | zhangdongmei@tedu.cn | 13690746261 | 4 || 53 | 邢成 | 2018-05-07 | 1991-07-13 | xingcheng@moershi.com | 13983238261 | 4 || 54 | 孙丹 | 2012-01-28 | 1997-02-22 | sundan@moershi.com | 13684254376 | 4 || 55 | 梁静 | 2013-03-21 | 1995-05-20 | liangjing@moershi.com | 18077866993 | 4 || 56 | 陈洁 | 2006-08-17 | 1977-04-23 | chenjie@tedu.cn | 14737309895 | 4 || 57 | 许辉 | 2014-09-16 | 1992-10-21 | xuhui@moershi.com | 13143391754 | 4 || 58 | 张伟 | 2007-06-22 | 1999-04-30 | zhangwei@moershi.com | 18172302428 | 4 || 59 | 钟倩 | 2011-02-23 | 1983-06-28 | zhongqian@moershi.com | 18611282765 | 4 || 60 | 贺磊 | 2001-06-19 | 1993-02-07 | helei@tedu.cn | 15897839325 | 4 || 61 | 沈秀梅 | 2003-04-27 | 1992-08-13 | shenxiumei@tedu.cn | 18044302910 | 4 || 62 | 林刚 | 2007-09-19 | 1990-09-23 | lingang@tedu.cn | 13355063263 | 4 || 63 | 王玉华 | 2016-10-09 | 1973-09-14 | wangyuhua@tedu.cn | 18010485419 | 4 || 64 | 徐金凤 | 2015-09-09 | 1972-01-31 | xujinfeng@tedu.cn | 15124816733 | 4 || 65 | 张淑英 | 2010-11-08 | 1996-09-12 | zhangshuying@moershi.com | 18846908114 | 4 || 66 | 罗岩 | 2001-06-13 | 1986-10-17 | luoyan@tedu.cn | 14544559539 | 4 || 67 | 潘玲 | 2017-08-31 | 1993-02-18 | panling@tedu.cn | 13311560534 | 4 || 68 | 柴冬梅 | 2003-11-24 | 1976-01-01 | chaidongmei@moershi.com | 14506733843 | 4 || 69 | 谢莹 | 2017-12-06 | 1996-04-01 | xieying@tedu.cn | 15137904023 | 4 || 70 | 傅雪 | 2001-04-23 | 1976-09-06 | fuxue@moershi.com | 15210059051 | 4 || 71 | 龙旭 | 2019-05-15 | 1974-11-02 | longxu@moershi.com | 15155879580 | 4 || 72 | 赵杰 | 2004-05-08 | 1984-04-06 | zhaojie@tedu.cn | 13466360255 | 4 || 73 | 王璐 | 2003-09-22 | 2000-02-01 | wanglu@moershi.com | 13056592974 | 4 || 74 | 赵成 | 2012-11-30 | 1985-10-11 | zhaocheng@tedu.cn | 18545824587 | 4 |+-------------+-----------+------------+------------+---------------------------+--------------+---------+55 rows in set (0.00 sec)
mysql> --外键约束,先删除salary表对应数据mysql> delete from moershi.salary where employee_id in (select employee_id from moershi.employees where dept_id=4);Query OK, 3308 rows affected (0.36 sec)
mysql> --删除employees表dept_id=4的数据mysql> delete from moershi.employees where dept_id=4;Query OK, 55 rows affected (0.22 sec)
mysql> --查询删除后结果mysql> select * from moershi.employees where dept_id=4;Empty set (0.00 sec)
方案二:临时禁用外键约束 此方法通过
SET FOREIGN_KEY_CHECKS = 0;临时关闭外键约束检查,操作完成后务必记得重新开启。注意:这种方法会暂时破坏数据库的引用完整性,如果操作不当,可能导致数据不一致,请务必确保在可控范围内使用。
方案三:设置级联删除(长远之计) 级联删除是一种“一劳永逸”的解决方案。设置后,当您删除
employees表中的某位员工时,数据库会自动删除salary表中与之相关的所有工资记录。 首先,你需要删除原有的外键约束,然后重新添加一个带有级联删除选项的新约束。设置完成后,您再次执行
DELETE FROM moershi.employees WHERE dept_id=4;,数据库就会自动处理关联的工资记录了。💡 决策建议与总结
- 若当前操作是临时的、一次性的,建议使用方案一(先删关联数据),它最清晰、可控。
- 若经常需要进行此类关联删除,建议使用方案三(设置级联删除),一劳永逸,但务必理解其自动删除的后果。
- 方案二(临时禁用约束) 风险较高,通常用于数据迁移或清理等特定场景,日常操作请谨慎选择。
请根据您的具体需求选择最合适的方法。如果对约束名称或具体操作步骤仍有疑问,可以随时追问。
- 从
employees表中查询出所有在 2025 年入职的员工信息,并按照hire_date升序排列。
mysql>mysql> select * from moershi.employees where year(hire_date) = 2025 order by hire_date asc;+-------------+--------+------------+------------+------------------+--------------+---------+| employee_id | name | hire_date | birth_date | email | phone_number | dept_id |+-------------+--------+------------+------------+------------------+--------------+---------+| 134 | 李四 | 2025-06-01 | 1990-05-10 | lisi@example.com | 13800138000 | 2 |+-------------+--------+------------+------------+------------------+--------------+---------+1 row in set (0.00 sec)
mysql>
04:mysql之综合查询
今日工作任务路线图
flowchart LR subgraph BottomRow[综合查询] direction LR A[内连接查询] --> B[外连接查询] --> C[合并查询结果] --> D[嵌套查询] end一、工作场景
在一家中型企业的人力资源管理工作里,会频繁运用 MySQL 综合查询。企业有员工表,包含员工编号、姓名、入职时间等;部门表记录着部门编号、部门名称等;薪资表存有员工编号、薪资数额、发放日期等。
每到季度末,人力部门需要统计各部门员工的平均薪资。这时就会综合查询这三张表。通过员工编号关联员工表和薪资表,再通过部门编号关联员工表和部门表。筛选出本季度发放的薪资数据,按部门分组计算平均薪资。如此,就能清晰了解各部门的人力成本,为后续的预算规划、薪资调整等提供数据支撑。
二、为什么要学综合查询
在日常工作里,学会 MySQL 综合查询是非常必要的。以员工表、部门表和薪资表为例,单看一张表,能获取的信息有限。员工表只有员工基本信息,部门表只有部门情况,薪资表只有薪资数据。
但当你掌握综合查询,就能将三张表关联起来。比如想知道每个部门的平均薪资,就可以通过员工表关联部门表和薪资表,快速得出结果。还能查询出不同部门入职时间早且薪资高的员工。综合查询让你从多个角度挖掘数据价值,为企业的决策提供准确依据,极大提升工作效率和质量,所以很有学习的必要。
三、内连接查询
当前任务环节
flowchart LR subgraph BottomRow[综合查询] direction LR A[内连接查询] --> B[外连接查询] --> C[合并查询结果] --> D[嵌套查询] end classDef highlight stroke:#f00,stroke-width:2px; class A highlight;MySQL 内连接查询是一种常用的表连接方式,用于从多个表中提取相关联的数据。它分为隐式和显式内连接查询,区别在于是否包含 inner【ing呐】 join【载(白话)】 关键字 。只有主表和从表中的数据都满足连接条件时才能被查询出来,不满足则会被忽略 。
例如有员工表和部门表,若要查询每个员工所在部门的信息,可通过员工表中的部门 ID 与部门表中的 ID 匹配连接,获取员工姓名和部门名称等信息。内连接能确保数据准确,适用于查询具有明确关联关系的表 。
使用moershi库下的3张表做今天的查询练习。
- departments【迪帕踢门特s】:部门表,存储部门信息
- employees【ing普洛伊s】: 员工表,存储员工信息
- salary【撒拉瑞】: 工资表,存储工资信息
三张表的关系如果图
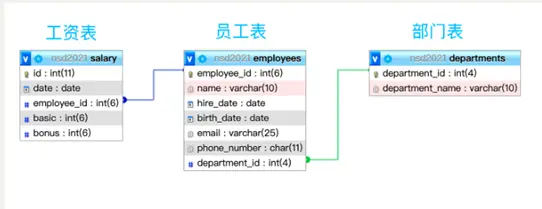
INNER【ing呐】 JOIN【载(白话)】 关键字详解
INNER【ing呐】 JOIN【载(白话)】是SQL中最基础且最重要的连接操作,它通过精确的匹配条件将相关的数据行连接在一起,是构建复杂查询和数据分析的基石。掌握INNER【ing呐】 JOIN【载(白话)】的正确用法对于进行有效的数据处理至关重要。
| 属性 | 说明 |
|---|---|
| 关键字 | INNER【ing呐】 JOIN【载(白话)】 |
| 中文名称 | 内连接 |
| 作用 | 返回两个表中满足连接条件的匹配行 |
| 语法 | SELECT【涩莱克特】 列名 FROM【弗乱】 表1 INNER【ing呐】 JOIN【载(白话)】 表2 ON【昂】 连接条件 |
| 返回值 | 只返回两个表中连接条件为TRUE的行 |
| 等价写法 | 可以省略INNER【ing呐】,直接写JOIN【载(白话)】 |
语法结构
基本语法结构
SELECT【涩莱克特】 列名列表 FROM【弗乱】 表1 INNER【ing呐】 JOIN【载(白话)】 表2 ON【昂】 表1.列名 = 表2.列名;
表1 INNER【ing呐】 JOIN【载(白话)】 表2: 是表连接 的核心部分,用于将 1 表和 2 表的数据关联起来。作用指定主表和从表:1 是主表(左表)。2 是从表(右表)。
定义连接类型:INNER JOIN 表示内连接,只返回两个表中匹配的记录。如果 1 表中的某条记录在 2 表中没有匹配的记录(即 employee_id 不匹配),则该记录不会出现在结果中。
配合连接条件:通常与 ON 子句一起使用(例如 ON employees.employee_id = salary.employee_id ),以指定如何匹配两个表的记录。
ON【昂】 表1.列名 = 表2.列名: 是 连接条件,用于指定 1 表和 2 表之间的关联关系作用定义表之间的关联: 它告诉数据库如何将 employees 表中的记录与 salary 表中的记录匹配起来。 只有当 employees.employee_id 和 salary.employee_id 的值相等时,两条记录才会被关联起来。
确保数据一致性: 通过这个条件,查询只会返回那些在 employees 表和 salary 表中都有对应 employee_id 的记录(如果是 INNER JOIN )。 如果是 LEFT JOIN ,则会返回 employees 表中的所有记录,即使 salary 表中没有匹配的记录(此时 salary 表的字段会显示为 NULL【nò】 )。完整语法格式
SELECT【涩莱克特】 [表别名1].列名, [表别名2].列名, ...FROM【弗乱】 表1 [AS] 表别名1INNER【ing呐】 JOIN【载(白话)】 表2 [AS] 表别名2 ON【昂】 表别名1.连接列 = 表别名2.连接列[WHERE【威尔】 筛选条件][ORDER【欧朵】 BY 排序字段];示例
1:基本INNER【ing呐】 JOIN【载(白话)】查询
-- 查询员工及其部门信息SELECT【涩莱克特】 e.employee【ing普洛伊】_id, e.name, d.dept_name, e.hire_dateFROM【弗乱】 employees【ing普洛伊s】 eINNER【ing呐】 JOIN【载(白话)】 departments【迪帕踢门特s】 d ON【昂】 e.dept_id = d.dept_id;查询结果:
| employee【ing普洛伊】_id | name | dept_name | hire_date |
|---|---|---|---|
| 1 | 张三 | 技术部 | 2023-01-15 |
| 2 | 李四 | 销售部 | 2023-03-20 |
| 3 | 王五 | 技术部 | 2023-02-10 |
| 4 | 赵六 | 人事部 | 2023-04-05 |
2:带WHERE【威尔】条件的INNER【ing呐】 JOIN【载(白话)】
-- 只查询技术部的员工SELECT【涩莱克特】 e.name, d.dept_name, e.hire_dateFROM【弗乱】 employees【ing普洛伊s】 eINNER【ing呐】 JOIN【载(白话)】 departments【迪帕踢门特s】 d ON【昂】 e.dept_id = d.dept_idWHERE【威尔】 d.dept_name = '技术部';查询结果:
| name | dept_name | hire_date |
|---|---|---|
| 张三 | 技术部 | 2023-01-15 |
| 王五 | 技术部 | 2023-02-10 |
3:多表INNER【ing呐】 JOIN【载(白话)】连接
-- 假设有salary【撒拉瑞】表,三表连接SELECT【涩莱克特】 e.name, d.dept_name, s.basic【贝斯克】_salary【撒拉瑞】FROM【弗乱】 employees【ing普洛伊s】 eINNER【ing呐】 JOIN【载(白话)】 departments【迪帕踢门特s】 d ON【昂】 e.dept_id = d.dept_idINNER【ing呐】 JOIN【载(白话)】 salary【撒拉瑞】 s ON【昂】 e.employee【ing普洛伊】_id = s.employee【ing普洛伊】_id;使用场景分析
| 场景 | 说明 | 示例 |
|---|---|---|
| 主从表关联 | 查询主表记录的详细信息 | 员工表关联部门表查部门信息 |
| 多维度分析 | 结合多个维度的数据进行统计 | 销售数据关联产品表、客户表 |
| 数据验证 | 检查两个表的数据一致性 | 验证订单表和库存表的数据匹配 |
| 报表生成 | 生成包含多个表数据的综合报表 | 员工考勤关联工资计算 |
与其他JOIN【载(白话)】类型的对比
| 特性 | INNER【ing呐】 JOIN | LEFT【列夫特】 JOIN【载(白话)】 | RIGHT【来特】 JOIN【载(白话)】 | FULL【fò】 JOIN【载(白话)】 |
|---|---|---|---|---|
| 返回结果 | 只返回匹配行 | 左表所有行+匹配行 | 右表所有行+匹配行 | 左右表所有行 |
| NULL【nò】处理 | 排除不匹配行 | 右表不匹配显示NULL【nò】 | 左表不匹配显示NULL【nò】 | 不匹配都显示NULL【nò】 |
| 使用频率 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐ | ⭐ |
| 性能 | 通常最优 | 中等 | 中等 | 较差 |
最佳实践指南
- 使用表别名提高可读性
-- 推荐写法SELECT【涩莱克特】 emp.name, dept.dept_nameFROM【弗乱】 employees【ing普洛伊s】 empINNER【ing呐】 JOIN【载(白话)】 departments【迪帕踢门特s】 dept ON【昂】 emp.dept_id = dept.dept_id;
-- 不推荐写法SELECT【涩莱克特】 employees【ing普洛伊s】.name, departments【迪帕踢门特s】.dept_nameFROM【弗乱】 employees【ing普洛伊s】INNER【ing呐】 JOIN【载(白话)】 departments【迪帕踢门特s】 ON【昂】 employees【ing普洛伊s】.dept_id = departments【迪帕踢门特s】.dept_id;- 明确指定列所属表
-- 避免列名歧义SELECT【涩莱克特】 e.employee【ing普洛伊】_id, e.name, d.dept_nameFROM【弗乱】 employees【ing普洛伊s】 eINNER【ing呐】 JOIN【载(白话)】 departments【迪帕踢门特s】 d ON【昂】 e.dept_id = d.dept_id;- 合理使用索引优化性能
-- 确保连接列有索引CREATE INDEX idx_employees【ing普洛伊s】_dept_id ON【昂】 employees【ing普洛伊s】(dept_id);CREATE INDEX idx_departments【迪帕踢门特s】_dept_id ON【昂】 departments【迪帕踢门特s】(dept_id);3.1 等值连接查询
- 查询每个员工所在的部门名
Use moershi;select【涩莱克特】 name, dept_namefrom【弗乱】 employees【ing普洛伊s】 inner【ing呐】 join【载(白话)】 departments【迪帕踢门特s】 on【昂】 employees【ing普洛伊s】.dept_id=departments【迪帕踢门特s】.dept_id;
-- mysql> select name,dept_name-- -> from employees inner join departments on employees.dept_id=departments.dept_id;---- | name | dept_name |-- |-----------|-----------|-- | 梁伟 | 人事部 |-- | 郭岩 | 人事部 |-- | 李玉英 | 人事部 |-- | 张健 | 人事部 |-- | 郑静 | 人事部 |-- | 牛建军 | 人事部 |-- | 刘斌 | 人事部 |-- | 汪云 | 人事部 |2)查询员工编号8 的 员工所在部门的部门名称
select【涩莱克特】 name, dept_name from【弗乱】 employees【ing普洛伊s】 inner【ing呐】 join【载(白话)】 departments【迪帕踢门特s】on【昂】 employees【ing普洛伊s】.dept_id=departments【迪帕踢门特s】.dept_id where【威尔】 employees【ing普洛伊s】.employee【ing普洛伊】_id=8;
-- mysql> select name,dept_name from employees inner join departments on employees.dept_id=departments.dept_id where employees.employee_id=8;-- +--------+-----------+-- | name | dept_name |-- +--------+-----------+-- | 汪云 | 人事部 |-- +--------+-----------+-- 1 row in set (0.01 sec)别名规则
| 字段名 | 是否必须加别名 e. 或 d. | 原因说明 |
|---|---|---|
dept_id | 必须 | 因为 employees 和 departments 两个表都有名为 dept_id 的字段,MySQL 无法自动判断您想用的是哪一个。 |
name | 不需要 | 因为只有 employees 表中有 name 字段,departments 表中没有这个字段,MySQL 可以唯一确定它来自哪里。 |
如果字段名在多个表中同时存在,必须带上别名才可以识别你要查询的字段名是那个表的字段名 如果字段名只在其中一个表存在,这就具有唯一性,sql可以明确识别字段名在那个表,就不需要带上别名
3)查询每个员工所有信息及所在的部门名称
给表名定义别名 ,定义别名后必须使用别名表示表名
select【涩莱克特】 e.* , d.dept_namefrom【弗乱】 employees【ing普洛伊s】 as e inner【ing呐】 join【载(白话)】 departments【迪帕踢门特s】 as d on【昂】 e.dept_id=d.dept_id;
-- mysql> select e.*,d.dept_name from employees as e inner join departments as d on e.dept_id=d.dept_id limit 5;#结果太多,加上"limit 5" 只输出前5行-- +-------------+-----------+------------+------------+-----------------------+--------------+---------+-----------+-- | employee_id | name | hire_date | birth_date | email | phone_number | dept_id | dept_name |-- +-------------+-----------+------------+------------+-----------------------+--------------+---------+-----------+-- | 1 | 梁伟 | 2018-06-21 | 1971-08-19 | liangwei@tedu.cn | 13591491431 | 1 | 人事部 |-- | 2 | 郭岩 | 2010-03-21 | 1974-05-13 | guoyan@tedu.cn | 13845285867 | 1 | 人事部 |-- | 3 | 李玉英 | 2012-01-19 | 1974-01-25 | liyuying@tedu.cn | 15628557234 | 1 | 人事部 |-- | 4 | 张健 | 2008-09-17 | 1972-06-07 | zhangjian@moershi.com | 13835990213 | 1 | 人事部 |-- | 5 | 郑静 | 2018-02-03 | 1997-02-14 | zhengjing@tedu.cn | 14508936730 | 1 | 人事部 |-- +-------------+-----------+------------+------------+-----------------------+--------------+---------+-----------+-- 5 rows in set (0.00 sec)4)查询每个员工姓名、部门编号、部门名称
两个表有同名表头,表头名前必须加表名
select【涩莱克特】 e.dept_id , name , dept_name from【弗乱】 employees【ing普洛伊s】 as e inner【ing呐】 join【载(白话)】 departments【迪帕踢门特s】 as d on【昂】 e.dept_id=d.dept_id;
-- mysql> select e.dept_id,name,dept_name from employees as e inner join departments as d on e.dept_id=d.dept_id limit 5;#结果太多,加上"limit 5" 只输出前5行-- +---------+-----------+-----------+-- | dept_id | name | dept_name |-- +---------+-----------+-----------+-- | 1 | 梁伟 | 人事部 |-- | 1 | 郭岩 | 人事部 |-- | 1 | 李玉英 | 人事部 |-- | 1 | 张健 | 人事部 |-- | 1 | 郑静 | 人事部 |-- +---------+-----------+-----------+-- 5 rows in set (0.00 sec)3.2 对连接后的查询结果,筛选、分组、排序、过滤
1)查询11号员工的名字及2018年每个月总工资
select【涩莱克特】 e.employee【ing普洛伊】_id, name, date, basic【贝斯克】+bonus【波诺斯】 as total【偷ò头ō】from【弗乱】 employees【ing普洛伊s】 as e inner【ing呐】 join【载(白话)】 salary【撒拉瑞】 as son【昂】 e.employee【ing普洛伊】_id=s.employee【ing普洛伊】_idwhere【威尔】 year【耶尔】(date)=2018 and e.employee【ing普洛伊】_id=11;-- mysql>-- mysql> select e.employee_id,name,date,basic+bonus as total-- -> from employees as e inner join salary as s on e.employee_id=s.employee_id-- -> where year(date)=2018 and e.employee_id=11;-- +-------------+-----------+------------+-------+-- | employee_id | name | date | total |-- +-------------+-----------+------------+-------+-- | 11 | 郭兰英 | 2018-01-10 | 18206 |-- | 11 | 郭兰英 | 2018-02-10 | 19206 |-- | 11 | 郭兰英 | 2018-03-10 | 18206 |-- | 11 | 郭兰英 | 2018-04-10 | 19206 |-- | 11 | 郭兰英 | 2018-05-10 | 18206 |-- | 11 | 郭兰英 | 2018-06-10 | 19206 |-- | 11 | 郭兰英 | 2018-07-10 | 27206 |-- | 11 | 郭兰英 | 2018-08-10 | 27206 |-- | 11 | 郭兰英 | 2018-09-10 | 19206 |-- | 11 | 郭兰英 | 2018-10-10 | 21206 |-- | 11 | 郭兰英 | 2018-11-10 | 22206 |-- | 11 | 郭兰英 | 2018-12-10 | 25016 |-- +-------------+-----------+------------+-------+-- 12 rows in set (0.00 sec)-- mysql>2) 查询每个员工2018年的总工资
#没分组前select【涩莱克特】 employees【ing普洛伊s】.employee【ing普洛伊】_id,date,basic【贝斯克】,bonus【波诺斯】 from【弗乱】 employees【ing普洛伊s】 inner【ing呐】 join【载(白话)】 salary【撒拉瑞】on【昂】 employees【ing普洛伊s】.employee【ing普洛伊】_id=salary【撒拉瑞】【撒拉瑞】.employee【ing普洛伊】_id where【威尔】 year【耶尔】(date)=2018;-- mysql> select employees.employee_id,date,basic,bonus-- -> from employees inner join salary-- -> on employees.employee_id=salary.employee_id-- -> where year(date)=2018;-- +-------------+------------+-------+-------+-- | employee_id | date | basic | bonus |-- +-------------+------------+-------+-------+-- | 1 | 2018-07-10 | 16206 | 11000 |-- | 1 | 2018-08-10 | 16206 | 8000 |-- | 1 | 2018-09-10 | 16206 | 8000 |-- | 1 | 2018-10-10 | 16206 | 11000 |-- | 1 | 2018-11-10 | 16206 | 8000 |-- ...............-- mysql> # 分组后select【涩莱克特】 employees【ing普洛伊s】.employee【ing普洛伊】_id, sum【桑à姆】(basic【贝斯克】+bonus【波诺斯】) from【弗乱】 employees【ing普洛伊s】 inner【ing呐】 join【载(白话)】 salary【撒拉瑞】on【昂】 employees【ing普洛伊s】.employee【ing普洛伊】_id=salary【撒拉瑞】.employee【ing普洛伊】_idwhere【威尔】 year【耶尔】(date)=2018 group【格鲁普】 by employees【ing普洛伊s】.employee【ing普洛伊】_id;
-- mysql>-- mysql> select employees.employee_id,sum(basic+bonus)-- -> from employees inner join salary-- -> on employees.employee_id=salary.employee_id-- -> where year(date)=2018 --过滤只输出2018年的数据-- -> group by employees.employee_id; --查询结果以employees.employee_id分组-- +-------------+------------------+-- | employee_id | sum(basic+bonus) |-- +-------------+------------------+-- | 1 | 151046 |-- | 2 | 328131 |-- | 3 | 177595 |-- | 4 | 262282 |-- | 5 | 248076 |-- | 6 | 257282 |-- | 7 | 314027 |-- ...............-- mysql>3)查询每个员工2018年的总工资,按总工资升序排列
select【涩莱克特】 employees【ing普洛伊s】.employee【ing普洛伊】_id, sum【桑à姆】(basic【贝斯克】+bonus【波诺斯】) as total【偷ò头ō】 from【弗乱】 employees【ing普洛伊s】 inner【ing呐】 join【载(白话)】 salary【撒拉瑞】 on【昂】 employees【ing普洛伊s】.employee【ing普洛伊】_id=salary【撒拉瑞】.employee【ing普洛伊】_id where【威尔】 year【耶尔】(salary【撒拉瑞】.date)=2018 group【格鲁普】 by employee【ing普洛伊】_id order【欧朵】 by total【偷ò头ō】 asc【阿斯克】;
-- mysql>-- mysql> select employees.employee_id,sum(basic+bonus) as total-- -> from employees inner join salary on employees.employee_id=salary.employee_id-- -> where year(salary.date)=2018 --过滤只输出2018年的数据-- -> group by employee_id --查询结果以employee_id分组-- -> order by total asc; --查询结果以升序排序-- +-------------+--------+-- | employee_id | total |-- +-------------+--------+-- | 8 | 25093 |-- | 10 | 116389 |-- | 16 | 119389 |-- | 51 | 123733 |-- | 18 | 126687 |-- .........4)查询2018年总工资大于30万的员工,按2018年总工资降序排列
select【涩莱克特】 employees【ing普洛伊s】.employee【ing普洛伊】_id, sum【桑à姆】(basic【贝斯克】+bonus【波诺斯】) as total【偷ò头ō】from【弗乱】 employees【ing普洛伊s】 inner【ing呐】 join【载(白话)】 salary【撒拉瑞】 on【昂】 employees【ing普洛伊s】.employee【ing普洛伊】_id=salary【撒拉瑞】.employee【ing普洛伊】_idwhere【威尔】 year【耶尔】(salary【撒拉瑞】.date)=2018group【格鲁普】 by employees【ing普洛伊s】.employee【ing普洛伊】_idhaving【嗨夫营】 total【偷ò头ō】 > 300000order【欧朵】 by total【偷ò头ō】 desc;-- mysql>-- mysql> select employees.employee_id,sum(basic+bonus) as total-- -> from employees inner join salary on employees.employee_id=salary.employee_id-- -> where year(salary.date)=2018-- -> group by employees.employee_id-- -> having total > 300000-- -> order by total desc;-- +-------------+--------+-- | employee_id | total |-- +-------------+--------+-- | 117 | 374923 |-- | 31 | 374923 |-- | 37 | 362981 |-- | 68 | 360923 |-- | 48 | 359923 |-- ......四、外连接查询
当前任何环节
flowchart LR subgraph BottomRow[综合查询] direction LR A[内连接查询] --> B[外连接查询] --> C[合并查询结果] --> D[嵌套查询] end classDef highlight stroke:#f00,stroke-width:2px; class B highlight;MySQL 外连接查询是一种在多个表间获取数据的重要方式,它主要分为左外连接、右外连接和全外连接。
外连接类型对比
| 连接类型 | 关键字 | 返回结果 | 适用场景 |
|---|---|---|---|
| 左外连接 | LEFT【列夫特】 JOIN【载(白话)】 或 LEFT【列夫特】 OUTER【奥特尔】 JOIN【载(白话)】 | 左表所有记录 + 右表匹配记录 | 主表记录必须全部保留,关联表信息可选 |
| 右外连接 | RIGHT【来特】 JOIN【载(白话)】 或 RIGHT【来特】 OUTER【奥特尔】 JOIN【载(白话)】 | 右表所有记录 + 左表匹配记录 | 从表记录必须全部保留,主表信息可选 |
| 全外连接 | FULL【fò】 JOIN【载(白话)】 或 FULL【fò】 OUTER【奥特尔】 JOIN【载(白话)】 | 左右表所有记录 | 需要两个表的完整数据合并 |
外连接是SQL查询中非常重要的功能,特别适用于:
- 需要保留主表所有记录的查询
- 数据完整性检查(查找缺失的关联数据)
- 生成完整的报表和统计分析
- 处理可能存在NULL【nò】关联关系的业务场景
左外连接会返回左表中的所有记录,以及右表中匹配的记录,若右表无匹配项,对应字段会显示为 NULL【nò】。右外连接则相反,返回右表所有记录与左表匹配记录。全外连接会返回左右表的所有记录,无匹配项的字段同样显示为 NULL【nò】。
例如员工表和部门表,用左外连接查询时,即便有员工未分配部门,该员工信息也会显示出来。外连接能满足在关联表查询时,不遗漏某表记录的需求。
4.1 左连接查询
向departments【迪帕踢门特s】表里添加3个部门:小卖部 行政部 公关部
mysql> insert【因涩特】 into【因兔】 departments【迪帕踢门特s】(dept_name) values【挖柳斯】("小卖部"),("行政部"),("公关部");Query OK, 3 rows affected (0.06 sec)Records: 3 Duplicates: 0 Warnings: 0查询部门信息
mysql> select【涩莱克特】 * from【弗乱】 moershi.departments【迪帕踢门特s】;+---------+-----------+| dept_id | dept_name |+---------+-----------+| 1 | 人事部 || 2 | 财务部 || 3 | 运维部 || 4 | 开发部 || 5 | 测试部 || 6 | 市场部 || 7 | 销售部 || 8 | 法务部 || 9 | 小卖部 || 10 | 行政部 || 11 | 公关部 |+---------+-----------+11 rows in set (0.00 sec)mysql>左连接查询例子:输出没有员工的部门名
mysql> select【涩莱克特】 d.dept_name,e.name from【弗乱】 departments【迪帕踢门特s】 as d left【列夫特】 join【载(白话)】 employees【ing普洛伊s】 as e on【昂】 d.dept_id=e.dept_id;......| 法务部 | 王荣 || 法务部 | 刘倩 || 法务部 | 杨金凤 || 小卖部 | NULL || 行政部 | NULL || 公关部 | NULL |+-----------+-----------+136 rows in set (0.00 sec)连接后 输出与筛选条件匹配的行
select【涩莱克特】 d.dept_name,e.name from【弗乱】 departments【迪帕踢门特s】 as d left【列夫特】 join【载(白话)】 employees【ing普洛伊s】 as e on【昂】 d.dept_id=e.dept_id where【威尔】 e.name is null【nò】;+-----------+------+| dept_name | name |+-----------+------+| 小卖部 | NULL || 行政部 | NULL || 公关部 | NULL |+-----------+------+3 rows in set (0.01 sec)mysql>仅显示departments【迪帕踢门特s】表中dept_name表头
select【涩莱克特】 d.dept_name from【弗乱】 departments【迪帕踢门特s】 as d left【列夫特】 join【载(白话)】 employees【ing普洛伊s】 as e on【昂】 d.dept_id=e.dept_id where【威尔】 e.name is null【nò】;+-----------+| dept_name |+-----------+| 小卖部 || 行政部 || 公关部 |+-----------+3 rows in set (0.01 sec)mysql>4.2 右连接查询
向employees【ing普洛伊s】表中添加3个员工 只给name表头赋值
insert【因涩特】 into【因兔】 employees【ing普洛伊s】(name) values【挖柳斯】("bob"),("tom"),("lily");Query OK, 3 rows affected (0.05 sec)Records: 3 Duplicates: 0 Warnings: 0右连接查询例子:显示没有部门的员工名
//右连接查询select【涩莱克特】 e.name ,d.dept_name from【弗乱】 departments【迪帕踢门特s】 as d right【来特】 join【载(白话)】 employees【ing普洛伊s】 as e on【昂】 d.dept_id=e.dept_id;//加筛选条件select【涩莱克特】 e.name ,d.dept_name from【弗乱】 departments【迪帕踢门特s】 as d right【来特】 join【载(白话)】 employees【ing普洛伊s】 as e on【昂】 d.dept_id=e.dept_id where【威尔】 d.dept_name is null【nò】 ;+------+-----------+| name | dept_name |+------+-----------+| bob | NULL || tom | NULL || lily | NULL |+------+-----------+3 rows in set (0.00 sec)mysql>//仅显示员工名select【涩莱克特】 e.name from【弗乱】 departments【迪帕踢门特s】 as d right【来特】 join【载(白话)】 employees【ing普洛伊s】 as e on【昂】 d.dept_id=e.dept_id where【威尔】 d.dept_name is null【nò】 ;+------+| name |+------+| bob || tom || lily |+------+五、合并查询结果
当前任务环节
flowchart LR subgraph BottomRow[综合查询] direction LR A[内连接查询] --> B[外连接查询] --> C[合并查询结果] --> D[嵌套查询] end classDef highlight stroke:#f00,stroke-width:2px; class C highlight;在 MySQL 综合查询里,合并查询是一种实用的操作。它主要用于将多个查询结果合并成一个结果集,使用的关键字是 UNION【U凝】 和 UNION【U凝】 ALL【ò】。
UNION【U凝】 会去除合并结果里的重复记录,只保留一条。比如,你分别从员工表查询出薪资大于 8000 的员工,和从另一筛选条件查出的员工,用 UNION【U凝】 合并后,相同员工就只显示一次。而 UNION【U凝】 ALL【ò】 不会去重,会把所有查询结果直接合并。当你需要查看所有相关数据,不在意重复时,就用 UNION【U凝】 ALL【ò】。合并查询让你能灵活整合不同查询的数据。
基本概念对比
| 特性 | UNION【U凝】 | UNION【U凝】 ALL【ò】 |
|---|---|---|
| 去重处理 | 自动去除重复行 | 保留所有行,包括重复行 |
| 性能 | 较慢(需要排序和去重) | 较快(直接合并) |
| 结果排序 | 默认按第一列升序排列 | 不保证顺序 |
| 语法 | SELECT【涩莱克特】 ... UNION【U凝】 SELECT【涩莱克特】 ... | SELECT【涩莱克特】 ... UNION【U凝】 ALL【ò】 SELECT【涩莱克特】 ... |
| 使用场景 | 需要唯一结果时 | 需要完整数据或已知无重复时 |
| ---------- | --------------- | ------------------- |
| 去重能力 | ✅ 自动去重 | ❌ 保留重复 |
| 执行性能 | ⭐⭐ 较慢 | ⭐⭐⭐⭐ 较快 |
| 内存消耗 | 较高 | 较低 |
| 结果顺序 | 默认排序 | 不保证顺序 |
| 使用频率 | ⭐⭐⭐ 常用 | ⭐⭐⭐⭐⭐ 更常用 |
| 适用场景 | 需要唯一结果 | 完整数据或性能优先 |
关键要点总结
- UNION【U凝】 ALL【ò】 通常比 UNION【U凝】 性能更好,因为它不需要去重操作
- 只有需要去除重复记录时才使用 UNION【U凝】
- 确保所有SELECT【涩莱克特】语句的列数、数据类型和顺序一致
- UNION【U凝】 ALL【ò】 保留所有记录,包括重复项
- 在合并大量数据时,UNION【U凝】 ALL【ò】 是更优选择
基本语法格式
UNION【U凝】 语法
SELECT【涩莱克特】 列名1, 列名2, ...FROM【弗乱】 表1WHERE【威尔】 条件UNION【U凝】SELECT【涩莱克特】 列名1, 列名2, ...FROM【弗乱】 表2WHERE【威尔】 条件;UNION 【U凝】ALL【ò】 语法
SELECT【涩莱克特】 列名1, 列名2, ...FROM【弗乱】 表1WHERE【威尔】 条件UNION【U凝】 ALL【ò】SELECT【涩莱克特】 列名1, 列名2, ...FROM【弗乱】 表2WHERE【威尔】 条件;性能对比分析
| 操作步骤 | UNION【U凝】 | UNION【U凝】 ALL【ò】 |
|---|---|---|
| 数据读取 | 读取所有数据 | 读取所有数据 |
| 排序处理 | 对结果进行排序 | 不需要排序 |
| 去重操作 | 比较并去除重复行 | 保留所有行 |
| 内存使用 | 较高 | 较低 |
| 执行时间 | 较长 | 较短 |
实际示例演示
输出2018年基本工资的最大值和最小值
mysql> ( select【涩莱克特】 basic【贝斯克】 from【弗乱】 salary【撒拉瑞】 where【威尔】 year【耶尔】(date)=2018 order【欧朵】 by basic【贝斯克】 desc limit 1) union【U凝】 (select【涩莱克特】 basic【贝斯克】 from【弗乱】 salary【撒拉瑞】 where【威尔】 year【耶尔】(date)=2018 order【欧朵】 by basic【贝斯克】 asc【阿斯克】 limit【肋梅特】 1 );-- mysql> (select basic from salary where year(date)=2018 order by basic desc limit 1)-- -> union-- -> (select basic from salary where year(date)=2018 order by basic asc limit 1);-- +----------------+-- | basic【贝斯克】 |-- +----------------+-- | 25524 |-- | 5787 |-- +----------------+-- 2 rows in set (0.01 sec)输出2018年1月10号 基本工资的最大值和最小值
mysql> (select【涩莱克特】 date , max【mà 斯】(basic【贝斯克】) as 工资 from【弗乱】 salary【撒拉瑞】 where【威尔】 date=20180110) union【U凝】(select【涩莱克特】 date,min【敏ì】(basic【贝斯克】) from【弗乱】 salary【撒拉瑞】 where【威尔】 date=20180110);
-- mysql> (select date,max(basic) as 工资 from salary where date=20180110)-- -> union-- -> (select date,min(basic) from salary where date=20180110);-- +------------+--------+-- | date | 工资 |-- +------------+--------+-- | 2018-01-10 | 24309 |-- | 2018-01-10 | 5787 |-- +------------+--------+-- 2 rows in set (0.01 sec)union【U凝】 去掉查询结果中重复的行
mysql> (select【涩莱克特】 employee【ing普洛伊】_id , name , birth【波尔斯】_date from【弗乱】 employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 5) union【U凝】 (select【涩莱克特】 employee【ing普洛伊】_id , name , birth【波尔斯】_date from【弗乱】 employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 6);-- mysql> (select employee_id,name,birth_date from employees where employee_id <=5)-- -> union-- -> (select employee_id,name,birth_date from employees where employee_id <=6);+-------------------------+-----------+------------+| employee【ing普洛伊】_id | name | birth_date |+-------------------------+-----------+------------+| 1 | 梁伟 | 1971-08-19 || 2 | 郭岩 | 1974-05-13 || 3 | 李玉英 | 1974-01-25 || 4 | 张健 | 1972-06-07 || 5 | 郑静 | 1997-02-14 || 6 | 牛建军 | 1985-03-19 |+------------------------+-----------+------------+第二个查询只输出了与条件匹配的最后1行
mysql> (select【涩莱克特】 employee【ing普洛伊】_id , name , birth【波尔斯】_date from【弗乱】 employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 5) union【U凝】 (select【涩莱克特】 employee【ing普洛伊】_id , name , birth【波尔斯】_date from【弗乱】 employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 6);-- mysql> (select employee_id,name,birth_date from employees where employee_id <=5)-- -> union-- -> (select employee_id,name,birth_date from employees where employee_id <=6);+------------------------+-----------+-------------+| employee【ing普洛伊】_id | name | birth【波尔斯】_date |+------------------------+-----------+-------------+| 1 | 梁伟 | 1971-08-19 || 2 | 郭岩 | 1974-05-13 || 3 | 李玉英 | 1974-01-25 || 4 | 张健 | 1972-06-07 || 5 | 郑静 | 1997-02-14 || 6 | 牛建军 | 1985-03-19 |+------------------------+-----------+-------------+6 rows in set (0.00 sec)union【U凝】 all 不去重显示查询结果
mysql> (select【涩莱克特】 employee【ing普洛伊】_id , name , birth【波尔斯】_date from【弗乱】 employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 5) union【U凝】 all【ò】 (select【涩莱克特】 employee【ing普洛伊】_id , name , birth【波尔斯】_date from【弗乱】 employees【ing普洛伊s】 where【威尔】 employee【ing普洛伊】_id <= 6);-- mysql> (select employee_id,name,birth_date from employees where employee_id <=5)-- -> union all-- -> (select employee_id,name,birth_date from employees where employee_id <=6);+-------------+-----------+------------+| employee_id | name | birth_date |+-------------+-----------+------------+| 1 | 梁伟 | 1971-08-19 || 2 | 郭岩 | 1974-05-13 || 3 | 李玉英 | 1974-01-25 || 4 | 张健 | 1972-06-07 || 5 | 郑静 | 1997-02-14 || 1 | 梁伟 | 1971-08-19 || 2 | 郭岩 | 1974-05-13 || 3 | 李玉英 | 1974-01-25 || 4 | 张健 | 1972-06-07 || 5 | 郑静 | 1997-02-14 || 6 | 牛建军 | 1985-03-19 |+-------------+-----------+------------+11 rows in set (0.00 sec)六、嵌套查询
当前任务环节
flowchart LR subgraph BottomRow[综合查询] direction LR A[内连接查询] --> B[外连接查询] --> C[合并查询结果] --> D[嵌套查询] end classDef highlight stroke:#f00,stroke-width:2px; class D highlight;嵌套查询:是指在一个完整的查询语句之中,包含若干个不同功能的小查询;从而一起完成复杂查询的一种编写形式。包含的查询放在()里 , 包含的查询出现的位置:
- SELECT【涩莱克特】之后
- FROM【弗乱】之后
- WHERE【威尔】
- HAVING【嗨夫营】之后
嵌套查询的作用
1. 数据筛选与过滤
- 在主查询中使用子查询的结果作为筛选条件
- 实现复杂的多条件数据过滤
2. 数据比较与计算
- 将子查询结果与主查询数据进行对比
- 计算相对值、百分比等复杂指标
3. 数据存在性检查
- 检查某条记录是否存在于另一个表中
- 验证数据的完整性
4. 数据聚合与统计
- 在子查询中进行分组统计
- 将统计结果用于主查询的条件判断
嵌套查询的优势
- 逻辑清晰:将复杂问题分解为多个简单步骤
- 灵活性高:可以处理各种复杂的数据关系
- 可读性强:SQL语句结构清晰,易于理解
- 功能强大:支持多层嵌套,解决复杂业务逻辑
注意事项
- 性能考虑:多层嵌套可能影响查询性能
- 可维护性:过度嵌套会使SQL难以维护
- 替代方案:考虑使用JOIN或CTE(公共表表达式)作为替代方案
6.1 where【威尔】之后嵌套查询
1)查询运维部所有员工信息
#先把 运维部的id 找到mysql> select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name="运维部";-- mysql> select dept_id from departments where dept_name="运维部";+---------+| dept_id |+---------+| 3 |+---------+1 row in set (0.00 sec)#员工表里没有部门名称 但有部门编号 (和部门表的编号是一致的)mysql> select【涩莱克特】 * from【弗乱】 employees【ing普洛伊s】 where【威尔】 dept_id = (select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name="运维部");-- mysql> select * from employees where dept_id=(select dept_id from departments where dept_name="运维部");+-------------+-----------+------------+---------------------+--------------------+--------------+---------+| employee_id | name | hire_date | birth【波尔斯】_date | email | phone_number | dept_id |+-------------+-----------+------------+---------------------+--------------------+--------------+---------+| 14 | 廖娜 | 2012-05-20 | 1982-06-22 | liaona@moershi.com | 15827928192 | 3 || 15 | 窦红梅 | 2018-03-16 | 1971-09-09 | douhongmei@qcjy.cn | 15004739483 | 3 || 16 | 聂想 | 2018-09-09 | 1999-06-05 | niexiang@qcjy.cn | 15501892446 | 3 || 17 | 陈阳 | 2004-09-16 | 1991-04-10 | chenyang@qcjy.cn | 15565662056 | 3 || 18 | 戴璐 | 2001-11-30 | 1975-05-16 | dailu@qcjy.cn | 13465236095 | 3 || 19 | 陈斌 | 2019-07-04 | 2000-01-22 | chenbin@moershi.com | 13621656037 | 3 |+-------------+-----------+------------+---------------------+--------------------+--------------+---------+6 rows in set (0.00 sec)2)查询人事部2018年12月所有员工工资
//查看人事部的部门idmysql> select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name='人事部';-- mysql> select dept_id from departments where dept_name='人事部';+---------+| dept_id |+---------+| 1 |+---------+1 row in set (0.00 sec)//查找employees【ing普洛伊s】表里 人事部的员工idselect【涩莱克特】 employee【ing普洛伊】_id from【弗乱】 employees【ing普洛伊s】 where【威尔】 dept_id=(select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name='人事部');-- mysql> select employee_id from employees where dept_id=(select dept_id from departments where dept_name='人事部');+-------------+| employee_id |+-------------+| 1 || 2 || 3 || 4 || 5 || 6 || 7 || 8 |+-------------+8 rows in set (0.00 sec)//查询人事部2018年12月所有员工工资select【涩莱克特】 * from【弗乱】 salary【撒拉瑞】 where【威尔】 year【耶尔】(date)=2018 and month【mèn斯】(date)=12and employee【ing普洛伊】_id in (select【涩莱克特】 employee【ing普洛伊】_id from【弗乱】 employees【ing普洛伊s】where【威尔】 dept_id=(select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name='人事部') );-- mysql> select * from salary where year(date)=2018 and month(date)=12-- -> and employee_id in (select employee_id from employees-- -> where dept_id=(select dept_id from departments where dept_name='人事部'));+------+------------+-------------+----------------+----------------+| id | date | employee_id | basic【贝斯克】 | bonus【波诺斯】 |+------+------------+-------------+----------------+----------------+| 6252 | 2018-12-10 | 1 | 17016 | 7000 || 6253 | 2018-12-10 | 2 | 20662 | 9000 || 6254 | 2018-12-10 | 3 | 9724 | 8000 || 6255 | 2018-12-10 | 4 | 17016 | 2000 || 6256 | 2018-12-10 | 5 | 17016 | 3000 || 6257 | 2018-12-10 | 6 | 17016 | 1000 || 6258 | 2018-12-10 | 7 | 23093 | 4000 || 6259 | 2018-12-10 | 8 | 23093 | 2000 |+------+------------+-------------+----------------+----------------+8 rows in set (0.00 sec)3)查询人事部和财务部员工信息
//查看人事部和财务部的 部门idselect【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name in ('人事部', '财务部');-- mysql> select dept_id from departments where dept_name in ('人事部','财务部');+---------+| dept_id |+---------+| 1 || 2 |+---------+2 rows in set (0.00 sec)
//查询人事部和财务部员工信息select【涩莱克特】 dept_id , name from【弗乱】 employees【ing普洛伊s】where【威尔】 dept_id in (select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name in ('人事部', '财务部'));-- mysql> select dept_id,name from employees-- -> where dept_id in (-- -> select dept_id from departments where dept_name in ('人事部','财务部'));+---------+-----------+| dept_id | name |+---------+-----------+| 1 | 梁伟 || 1 | 郭岩 || 1 | 李玉英 || 1 | 张健 || 1 | 郑静 || 1 | 牛建军 || 1 | 刘斌 || 1 | 汪云 || 2 | 张建平 || 2 | 郭娟 || 2 | 郭兰英 || 2 | 王英 || 2 | 王楠 |+---------+-----------+13 rows in set (0.00 sec)4)查询2018年12月所有比100号员工基本工资高的工资信息
//把100号员工的基本工资查出来select【涩莱克特】 basic【贝斯克】 from【弗乱】 salary【撒拉瑞】 where【威尔】 year【耶尔】(date)=2018 andmonth【mèn斯】(date)=12 and employee【ing普洛伊】_id=100;-- mysql> select basic from salary where year(date)=2018 and-- -> month(date)=12 and employee_id=100;+----------------+| basic【贝斯克】 |+----------------+| 14585 |+----------------+1 row in set (0.00 sec)
//查看比100号员工工资高的工资信息select【涩莱克特】 * from【弗乱】 salary【撒拉瑞】where【威尔】 year【耶尔】(date)=2018 and month【mèn斯】(date)=12 andbasic【贝斯克】>(select【涩莱克特】 basic【贝斯克】 from【弗乱】 salary【撒拉瑞】 where【威尔】 year【耶尔】(date)=2018 andmonth【mèn斯】(date)=12 and employee【ing普洛伊】_id=100);-- mysql> select * from salary-- -> where year(date)=2018 and month(date)=12 and-- -> basic > (select basic from salary where year(date)=2018 and-- -> month(date)=12 and employee_id=100);+------+------------+-------------+----------------+----------------+| id | date | employee_id | basic【贝斯克】 | bonus【波诺斯】 |+------+------------+-------------+----------------+----------------+| 6252 | 2018-12-10 | 1 | 17016 | 7000 || 6253 | 2018-12-10 | 2 | 20662 | 9000 || 6255 | 2018-12-10 | 4 | 17016 | 2000 || 6256 | 2018-12-10 | 5 | 17016 | 3000 || 6257 | 2018-12-10 | 6 | 17016 | 1000 || 6258 | 2018-12-10 | 7 | 23093 | 4000 || 6259 | 2018-12-10 | 8 | 23093 | 2000 || 6261 | 2018-12-10 | 10 | 21878 | 8000 || 6262 | 2018-12-10 | 11 | 17016 | 8000 || 6263 | 2018-12-10 | 12 | 15800 | 4000 || 6264 | 2018-12-10 | 13 | 18231 | 3000 || 6267 | 2018-12-10 | 16 | 21878 | 8000 || 6268 | 2018-12-10 | 17 | 19448 | 7000 || 6271 | 2018-12-10 | 20 | 19448 | 3000 || 6272 | 2018-12-10 | 21 | 18231 | 11000 || 6276 | 2018-12-10 | 25 | 23093 | 3000 || 6278 | 2018-12-10 | 27 | 24309 | 5000 || 6279 | 2018-12-10 | 28 | 17016 | 9000 || 6280 | 2018-12-10 | 29 | 23093 | 1000 || 6282 | 2018-12-10 | 31 | 25524 | 9000 || 6283 | 2018-12-10 | 32 | 18231 | 11000 || 6284 | 2018-12-10 | 33 | 23093 | 6000 || 6285 | 2018-12-10 | 34 | 23093 | 1000 || 6288 | 2018-12-10 | 37 | 24309 | 4000 || 6289 | 2018-12-10 | 38 | 23093 | 3000 || 6291 | 2018-12-10 | 40 | 20662 | 2000 || 6297 | 2018-12-10 | 46 | 15800 | 7000 || 6299 | 2018-12-10 | 48 | 25524 | 1000 || 6300 | 2018-12-10 | 49 | 15800 | 9000 || 6303 | 2018-12-10 | 52 | 19448 | 9000 || 6304 | 2018-12-10 | 53 | 25524 | 8000 || 6305 | 2018-12-10 | 54 | 21878 | 9000 || 6307 | 2018-12-10 | 56 | 23093 | 3000 || 6308 | 2018-12-10 | 57 | 23093 | 3000 || 6312 | 2018-12-10 | 61 | 24309 | 3000 || 6313 | 2018-12-10 | 62 | 15800 | 4000 || 6314 | 2018-12-10 | 63 | 15800 | 8000 || 6317 | 2018-12-10 | 66 | 19448 | 7000 || 6319 | 2018-12-10 | 68 | 25524 | 9000 || 6324 | 2018-12-10 | 73 | 17016 | 10000 || 6327 | 2018-12-10 | 76 | 20662 | 11000 || 6330 | 2018-12-10 | 79 | 15800 | 4000 || 6332 | 2018-12-10 | 81 | 17016 | 3000 || 6336 | 2018-12-10 | 85 | 15800 | 1000 || 6337 | 2018-12-10 | 86 | 24309 | 4000 || 6339 | 2018-12-10 | 88 | 20662 | 2000 || 6342 | 2018-12-10 | 91 | 20662 | 11000 || 6343 | 2018-12-10 | 92 | 19448 | 2000 || 6346 | 2018-12-10 | 95 | 19448 | 8000 || 6349 | 2018-12-10 | 98 | 19448 | 9000 || 6350 | 2018-12-10 | 99 | 15800 | 5000 || 6353 | 2018-12-10 | 102 | 23093 | 3000 || 6356 | 2018-12-10 | 105 | 21878 | 8000 || 6357 | 2018-12-10 | 106 | 23093 | 5000 || 6358 | 2018-12-10 | 107 | 18231 | 7000 || 6359 | 2018-12-10 | 108 | 18231 | 2000 || 6361 | 2018-12-10 | 110 | 18231 | 2000 || 6363 | 2018-12-10 | 112 | 24309 | 9000 || 6368 | 2018-12-10 | 117 | 25524 | 11000 || 6369 | 2018-12-10 | 118 | 23093 | 3000 || 6370 | 2018-12-10 | 119 | 23093 | 10000 || 6373 | 2018-12-10 | 122 | 21878 | 2000 || 6374 | 2018-12-10 | 123 | 19448 | 10000 || 6376 | 2018-12-10 | 125 | 17016 | 5000 || 6378 | 2018-12-10 | 127 | 17016 | 6000 |+------+------------+-------------+----------------+----------------+65 rows in set (0.01 sec)6.2 having【嗨夫营】之后嵌套查询
查询部门员工总人数比开发部总人数少 的 部门名称和人数
//统计开发部员工总人数select【涩莱克特】 count【kàn特】(name) from【弗乱】 employees【ing普洛伊s】 where【威尔】 dept_id = (select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name="开发部");-- mysql> select count(name) from employees where dept_id=-- -> (select dept_id from departments where dept_name="开发部");+---------------------+| count【kàn特】(name) |+---------------------+| 55 |+---------------------+1 row in set (0.00 sec)
//统计每个部门总人数select【涩莱克特】 dept_id , count【kàn特】(name) from【弗乱】 employees【ing普洛伊s】 group【格鲁普】 by dept_id;-- mysql> select dept_id,count(name) from employees group by dept_id;+---------+---------------------+| dept_id | count【kàn特】(name) |+---------+---------------------+| 1 | 8 || 2 | 5 || 3 | 6 || 4 | 55 || 5 | 12 || 6 | 9 || 7 | 35 || 8 | 3 |+---------+---------------------+8 rows in set (0.00 sec)
//输出总人数比开发部总人数少的部门名及总人数select【涩莱克特】 dept_id , count【kàn特】(name) as total【偷ò头ō】 from【弗乱】 employees【ing普洛伊s】 group【格鲁普】 by dept_idhaving【嗨夫营】 total【偷ò头ō】 < (select【涩莱克特】 count【kàn特】(name) from【弗乱】 employees【ing普洛伊s】 where【威尔】 dept_id=(select【涩莱克特】 dept_id from【弗乱】 departments【迪帕踢门特s】 where【威尔】 dept_name='开发部'));-- mysql> select dept_id,count(name) as total from employees group by dept_id-- -> having total < (select count(name) from employees where dept_id= (select-- -> dept_id from departments where dept_name='开发部'));+---------+----------------+| dept_id | total【偷ò头ō】 |+---------+----------------+| 1 | 8 || 2 | 5 || 3 | 6 || 5 | 12 || 6 | 9 || 7 | 35 || 8 | 3 |+---------+----------------+7 rows in set (0.00 sec)6.3 from【弗乱】之后嵌套查询
查询3号部门 、部门名称 及其部门内 员工的编号、名字 和 email
select【涩莱克特】 dept_id, dept_name, employee【ing普洛伊】_id, name, email from【弗乱】 (select【涩莱克特】 d.dept_name, e.* from【弗乱】 departments【迪帕踢门特s】 as d inner【ing呐】 join【载(白话)】 employees【ing普洛伊s】 as eon【昂】 d.dept_id=e.dept_id ) as tmp_table【忒-部】 where【威尔】 dept_id=3;-- mysql> select dept_id,dept_name,employee_id,name,email from-- -> (select d.dept_name,e.* from departments as d inner join employees as e-- -> on d.dept_id=e.dept_id) as tmp_toble where dept_id=3;+---------+-----------+-------------+-----------+--------------------+| dept_id | dept_name | employee_id | name | email |+---------+-----------+-------------+-----------+--------------------+| 3 | 运维部 | 14 | 廖娜 | liaona@moershi.com || 3 | 运维部 | 15 | 窦红梅 | douhongmei@qcjy.cn || 3 | 运维部 | 16 | 聂想 | niexiang@qcjy.cn || 3 | 运维部 | 17 | 陈阳 | chenyang@qcjy.cn || 3 | 运维部 | 18 | 戴璐 | dailu@qcjy.cn || 3 | 运维部 | 19 | 陈斌 | chenbin@moershi.com |+---------+-----------+-------------+-----------+--------------------+6 rows in set (0.00 sec)6.4 select【涩莱克特】之后嵌套查询
查询每个部门的人数: dept_id dept_name 部门人数
//显示部门表中的所有列表select【涩莱克特】 d.* from【弗乱】 departments【迪帕踢门特s】 as d;-- mysql> select d.* from departments as d;+---------+-----------+| dept_id | dept_name |+---------+-----------+| 1 | 人事部 || 2 | 财务部 || 3 | 运维部 || 4 | 开发部 || 5 | 测试部 || 6 | 市场部 || 7 | 销售部 || 8 | 法务部 |+---------+-----------+8 rows in set (0.00 sec)
//查询每个部门的人数select【涩莱克特】 d.* , ( select【涩莱克特】 count【kàn特】(name) from【弗乱】 employees【ing普洛伊s】 as e where【威尔】 d.dept_id=e.dept_id) as 部门人数 from【弗乱】 departments【迪帕踢门特s】 as d;-- mysql> select d.*,(select count(name) from employees as e where d.dept_id=e.dept_id) as 部门人数-- -> from departments as d;+---------+-----------+--------------+| dept_id | dept_name | 部门人数 |+---------+-----------+--------------+| 1 | 人事部 | 8 || 2 | 财务部 | 5 || 3 | 运维部 | 6 || 4 | 开发部 | 55 || 5 | 测试部 | 12 || 6 | 市场部 | 9 || 7 | 销售部 | 35 || 8 | 法务部 | 3 |+---------+-----------+--------------+8 rows in set (0.00 sec)七、作业
1 选择题
- 在内连接查询中,使用以下哪种关键字进行连接操作?C A. LEFT JOIN B. RIGHT JOIN C. INNER JOIN D. FULL JOIN
- 外连接查询中,左外连接会返回以下哪些数据?A A. 左表的所有记录和右表匹配的记录 B. 右表的所有记录和左表匹配的记录 C. 左右表的所有记录 D. 只返回左右表匹配的记录
- 合并查询中,
UNION ALL和UNION的区别是? B A.UNION ALL会去除重复记录,UNION不会 B.UNION会去除重复记录,UNION ALL不会 C. 两者都去除重复记录 D. 两者都不去除重复记录 - 嵌套查询是指?B A. 在一个查询语句中嵌套多个表 B. 在一个查询语句中嵌套另一个查询语句 C. 同时进行多个查询操作 D. 以上都不对
2 简答题
-
简述内连接查询和外连接查询的区别。 答: 内连接是:只保留匹配的记录(交集) 外链接是:保留至少一个表的所有记录,不匹配的用NULL填充 应用场景区别:内连接用于需要精确匹配的场景,外连接用于需要保留所有记录的统计分析
-
什么时候使用
UNION,什么时候使用UNION ALL? 答: 需要唯一结果的时候可以使用UNION当需要完整数据或性能优先 时候使用UNION ALL -
请解释嵌套查询的作用和适用场景。 答: 嵌套查询的作用 1. 数据筛选与过滤 2. 数据比较与计算 3. 数据存在性检查 4. 数据聚合与统计
特别适合需要多步骤数据处理和分析的业务场景。
3 操作题
- 使用内连接查询,查询出每个员工所在部门的名称和员工姓名。
mysql>mysql> select e.name,d.dept_name from employees as e inner join departments as d -> on e.dept_id=d.dept_id;+-----------+-----------+| name | dept_name |+-----------+-----------+| 梁伟 | 人事部 || 郭岩 | 人事部 || 李玉英 | 人事部 || 张健 | 人事部 |.........- 使用左外连接查询,查询出所有员工的信息以及他们所在部门的名称(如果员工没有部门,部门名称显示为 NULL)。
mysql>mysql> select e.*,d.dept_name from employees as e left join departments as d on e.dept_id=d.dept_id;+-------------+-----------+------------+------------+---------------------------+--------------+---------+-----------+| employee_id | name | hire_date | birth_date | email | phone_number | dept_id | dept_name |+-------------+-----------+------------+------------+---------------------------+--------------+---------+-----------+| 1 | 梁伟 | 2018-06-21 | 1971-08-19 | liangwei@tedu.cn | 13591491431 | 1 | 人事部 || 2 | 郭岩 | 2010-03-21 | 1974-05-13 | guoyan@tedu.cn | 13845285867 | 1 | 人事部 || 3 | 李玉英 | 2012-01-19 | 1974-01-25 | liyuying@tedu.cn | 15628557234 | 1 | 人事部 || 4 | 张健 | 2008-09-17 | 1972-06-07 | zhangjian@moershi.com | 13835990213 | 1 | 人事部 || 5 | 郑静 | 2018-02-03 | 1997-02-14 | zhengjing@tedu.cn | 14508936730 | 1 | 人事部 || 6 | 牛建军 | 2005-11-18 | 1985-03-19 | niujianjun@moershi.com | 14750937118 | 1 | 人事部 |......- 使用合并查询,将薪资表中基本薪资大于 5000 和奖金大于 2000 的记录合并。
mysql> (select name,basic from salary as s inner join employees as e on e.employee_id=s.employee_id where basic > 5000) -> union -> (select name,bonus from salary as s inner join employees as e on e.employee_id=s.employee_id where bonus >2000);+-----------+-------+| name | basic |+-----------+-------+| 郭岩 | 17000 || 李玉英 | 8000 || 张健 | 14000 || 牛建军 | 14000 || 刘斌 | 19000 || 郭兰英 | 14000 || 王楠 | 15000 || 廖娜 | 10000 || 陈阳 | 16000 |.....- 使用嵌套查询,查询出部门名称为 “开发部” 的所有员工的信息。
mysql>mysql> select * from employees where dept_id= -> (select dept_id from departments where dept_name='开发部');+-------------+-----------+------------+------------+---------------------------+--------------+---------+| employee_id | name | hire_date | birth_date | email | phone_number | dept_id |+-------------+-----------+------------+------------+---------------------------+--------------+---------+| 20 | 蒋红 | 2017-12-29 | 1978-01-24 | jianghong@tedu.cn | 15852915398 | 4 || 21 | 曹宁 | 2004-06-07 | 1988-01-05 | caoning@tedu.cn | 14513022304 | 4 || 22 | 吕刚 | 2014-01-18 | 1980-06-24 | lvgang@tedu.cn | 18136987619 | 4 || 23 | 王莉 | 2021-02-04 | 1972-12-19 | wangli@moershi.com | 15376329290 | 4 || 24 | 邓秀芳 | 2020-09-08 | 1980-12-12 | dengxiufang@moershi.com | 15884927117 | 4 || 25 | 邵佳 | 2011-08-15 | 1978-11-28 | shaojia@tedu.cn | 13296016750 | 4 || 26 | 党丽 | 2014-03-14 | 1978-12-30 | dangli@moershi.com | 13166234580 | 4 || 27 | 梁勇 | 2007-01-19 | 1997-11-12 | liangyong@tedu.cn | 15307868657 | 4 || 28 | 郑秀珍 | 2011-04-28 | 1972-09-01 | zhengxiuzhen@moershi.com | 14543186401 | 4 || 29 | 胡秀云 | 2003-11-03 | 2000-05-14 | huxiuyun@tedu.cn | 18212266720 | 4 || 30 | 邢淑兰 | 2011-07-02 | 1989-06-17 | xingshulan@moershi.com | 13032270370 | 4 || 31 | 刘海燕 | 2018-01-06 | 1982-08-21 | liuhaiyan@moershi.com | 15064354651 | 4 || 32 | 冯建国 | 2014-05-28 | 1980-01-26 | fengjianguo@tedu.cn | 13344957322 | 4 |.........05:mysql之表结构管理
今日工作任务路线图
flowchart LR subgraph BottomRow[表结构管理] direction LR A[表管理] --> B[表格字段数据类型] --> C[表头基本约束] end classDef highlight stroke:#f00,stroke-width:2px; class E highlight;一、工作场景
小李在一家小型互联网公司担任数据库管理员。最近公司业务拓展,员工数量大幅增加,原本的数据库表结构逐渐难以满足需求。
在员工表中,原先的“职位”字段过于笼统,无法精准区分不同岗位。部门表也没有记录各部门的成立时间,不利于做部门发展分析。薪资表中奖金计算方式单一,不能适应新的绩效制度。
小李意识到要对表结构进行优化。他先和各部门沟通,了解实际业务需求,再设计新的表结构,在员工表细化“职位”,部门表添加“成立时间”,薪资表调整奖金规则。最后在测试环境验证新结构,确保准确稳定后应用到正式环境。
二、为啥要学表结构管理
学习 MySQL 表结构管理非常有必要。想象下你在一家公司工作,公司有员工表、部门表和薪资表。如果表结构管理不好,问题就会接踵而至。
要是员工表没有合理设置字段,可能会导致员工信息记录不全,影响人事管理。部门表结构混乱,就很难清晰掌握各部门的情况。薪资表如果设计不佳,计算薪资时容易出错,引发员工不满。
学会表结构管理,能让这些表合理存储数据,查询和修改数据更高效,避免数据冗余和错误。可以准确统计各部门员工数量、快速算出员工薪资,让公司运营更顺畅,所以学好它对处理数据很有帮助。
三、表管理
当前任务环节
flowchart LR subgraph BottomRow[表结构管理] direction LR A[表管理] --> B[表格字段数据类型] --> C[表头基本约束] end classDef highlight stroke:#f00,stroke-width:2px; class A highlight;3.1 建库练习
库名命名规则:
仅可以使用数字、字母、下划线、不能纯数字
区分字母大小写,
具有唯一性
不可使用MySQL命令或特殊字符
命令操作如下所示:
//库名区分字母大小写mysql> create【克瑞特】 database【得塔-贝斯】 gamedb ;-- mysql> create database gamedb;Query OK, 1 row affected (0.14 sec)
mysql> create【克瑞特】 database【得塔-贝斯】 GAMEDB ;-- mysql> create database GAMEDB;Query OK, 1 row affected (0.08 sec)
mysql> create【克瑞特】 database【得塔-贝斯】 GAMEDB ;-- mysql> create database GAMEDB;ERROR 1007 (HY000): Can't create【克瑞特】 database【得塔-贝斯】 'GAMEDB'; database【得塔-贝斯】 exists【伊贼谁斯】' //重名报错
//加if not【nuō 特】 exists【伊贼谁斯】 命令避免重名报错mysql> create【克瑞特】 database【得塔-贝斯】 if not【nuō 特】 exists【伊贼谁斯】 gamedb ;-- mysql> create database if not exists gamedb;Query OK, 1 row affected, 1 warning (0.03 sec) //正常
mysql> show【瘦】 databases【得塔-贝斯】; //查看创建的库-- mysql> show databases;+--------------------+| Database |+--------------------+| GAMEDB || gamedb || information_schema || mysql || performance_schema || sys || moershi |+--------------------+7 rows in set (0.00 sec)
mysql> drop【卓-普】 database【得塔-贝斯】 gamedb; //删除库-- mysql> drop database gamedb;Query OK, 0 rows affected (0.11 sec)
mysql> drop【卓-普】 database【得塔-贝斯】 gamedb; // 删除没有的库报错-- mysql> drop database gamedb;ERROR 1008 (HY000): Can’t drop【卓-普】 database【得塔-贝斯】 ‘gamedb’; database【得塔-贝斯】 doesn’t exist
//加if exists【伊贼谁斯】 删除没有的库,也不报错mysql> drop【卓-普】 database【得塔-贝斯】 if exists【伊贼谁斯】 gamedb;-- mysql> drop database if exists gamedb;Query OK, 0 rows affected, 1 warning (0.00 sec)3.2 建表练习
命令操作如下所示:
mysql> create【克瑞特】 database【得塔-贝斯】 studb【斯丢db】; //建库-- mysql> create database studb;Query OK, 1 row affected (0.11 sec)
mysql> create【克瑞特】 table【忒-部】 studb【斯丢db】.stu( //建表 -> name char【查尔】(10), -> class【克拉斯】 char【查尔】(9), -> gender【间德尔】 char【查尔】(4), -> age int【因特】 -> );-- mysql> create table studb.stu(-- -> name char(10),-- -> class char(9),-- -> gender char(4),-- -> age int);Query OK, 0 rows affected (1.17 sec)
mysql> desc studb【斯丢db】.stu; //查看表头-- mysql> desc studb.stu;+--------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+----------+------+-----+---------+-------+| name | char(10) | YES | | NULL | || class | char(9) | YES | | NULL | || gender | char(4) | YES | | NULL | || age | int | YES | | NULL | |+--------+----------+------+-----+---------+-------+4 rows in set (0.00 sec)3.3 修改表练习
命令操作如下所示:
修改表名
mysql> show【瘦】 tables【忒-部s】; //查看表-- mysql> show tables;+-----------------+| Tables_in_studb |+-----------------+| stu |+-----------------+1 row in set (0.00 sec)
mysql> alter【奥-特】 table【忒-部】 studb【斯丢db】.stu rename【瑞-内姆】 studb【斯丢db】.stuinfo【斯丢因否】; //修改表名 rename【瑞-内姆】-- mysql> alter table studb.stu rename studb.stuinfo;Query OK, 0 rows affected (0.28 sec)
mysql> use studb【斯丢db】; //进入库-- mysql> use studb;Reading table【忒-部】 information for completion of table【忒-部】 and column namesYou can turn off this feature to get a quicker startup with -ADatabase changed
mysql> show【瘦】 tables【忒-部s】; //查看表-- mysql> show tables;+-----------------+| Tables_in_studb |+-----------------+| stuinfo |+-----------------+1 row in set (0.00 sec)删除表头
mysql> desc studb【斯丢db】.stu; //查看表头-- mysql> desc studb.stu;+--------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+----------+------+-----+---------+-------+| name | char(10) | YES | | NULL | || class | char(9) | YES | | NULL | || gender | char(4) | YES | | NULL | || age | int | YES | | NULL | |+--------+----------+------+-----+---------+-------+4 rows in set (0.00 sec)
mysql> alter【奥-特】 table【忒-部】 studb【斯丢db】.stuinfo【斯丢因否】 drop【卓-普】 age ; //删除age表头 drop【卓-普】-- mysql> alter table studb.stuinfo drop age;Query OK, 0 rows affected (0.52 sec)Records: 0 Duplicates: 0 Warnings: 0
mysql> desc stuinfo【斯丢因否】; //查看表头-- mysql> desc stuinfo;+--------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+----------+------+-----+---------+-------+| name | char(10) | YES | | NULL | || class | char(9) | YES | | NULL | || gender | char(4) | YES | | NULL | |+--------+----------+------+-----+---------+-------+3 rows in set (0.00 sec)添加表头
//添加表头,默认添加在末尾addmysql> alter【奥-特】 table【忒-部】 studb【斯丢db】.stuinfo【斯丢因否】 add mail【miào e】 char【查尔】(30) ;-- mysql> alter table studb.stuinfo add mail char(30);Query OK, 0 rows affected (0.24 sec)Records: 0 Duplicates: 0 Warnings: 0
//查看表头mysql> desc studb【斯丢db】.stuinfo【斯丢因否】;-- mysql> desc studb.stuinfo;+--------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+----------+------+-----+---------+-------+| name | char(10) | YES | | NULL | || class | char(9) | YES | | NULL | || gender | char(4) | YES | | NULL | || mail | char(30) | YES | | NULL | |+--------+----------+------+-----+---------+-------+4 rows in set (0.00 sec)
//first【佛斯特】 把表头添加首位//after【啊夫特】 添加在指定表头名的下方mysql> alter【奥-特】 table【忒-部】 studb【斯丢db】.stuinfo【斯丢因否】 add number【能波】 char【查尔】(9) first【佛斯特】 , add school【斯故】 char【查尔】(10) after【啊夫特】 name;-- mysql> alter table studb.stuinfo add number char(9) first,add school char(10) after name;Query OK, 0 rows affected (0.48 sec)Records: 0 Duplicates: 0 Warnings: 0
//查看表结构mysql> desc studb【斯丢db】.stuinfo【斯丢因否】; //查看表头-- mysql> desc studb.stuinfo;+--------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+----------+------+-----+---------+-------+| number | char(9) | YES | | NULL | || name | char(10) | YES | | NULL | || school | char(10) | YES | | NULL | || class | char(9) | YES | | NULL | || gender | char(4) | YES | | NULL | || mail | char(30) | YES | | NULL | |+--------+----------+------+-----+---------+-------+6 rows in set (0.00 sec)修改表头数据类型
//修改表头数据类型modify【莫迪fái】mysql> alter【奥-特】 table【忒-部】 studb【斯丢db】.stuinfo【斯丢因否】 modify【莫迪fái】 mail【miào e】 varchar【瓦儿-查儿】(50);-- mysql> alter table studb.stuinfo modify mail varchar(50);Query OK, 0 rows affected (1.17 sec)Records: 0 Duplicates: 0 Warnings: 0
mysql> desc studb【斯丢db】.stuinfo【斯丢因否】;-- mysql> desc studb.stuinfo;+--------+-------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+-------------+------+-----+---------+-------+| number | char(9) | YES | | NULL | || name | char(10) | YES | | NULL | || school | char(10) | YES | | NULL | || class | char(9) | YES | | NULL | || gender | char(4) | YES | | NULL | || mail | varchar(50) | YES | | NULL | |+--------+-------------+------+-----+---------+-------+6 rows in set (0.01 sec)修改表头名
//修改表头名class【克拉斯】mysql> alter【奥-特】 table【忒-部】 studb【斯丢db】.stuinfo【斯丢因否】 change【趁(chèn)吉】 class【克拉斯】 班级 char【查尔】(9) ;-- mysql> alter table studb.stuinfo change class 班级 char(9);Query OK, 0 rows affected (0.12 sec)Records: 0 Duplicates: 0 Warnings: 0
//查看表头mysql> desc studb【斯丢db】.stuinfo【斯丢因否】;-- mysql> desc studb.stuinfo;+--------+-------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+-------------+------+-----+---------+-------+| number | char(9) | YES | | NULL | || name | char(10) | YES | | NULL | || school | char(10) | YES | | NULL | || 班级 | char(9) | YES | | NULL | || gender | char(4) | YES | | NULL | || mail | varchar(50) | YES | | NULL | |+--------+-------------+------+-----+---------+-------+6 rows in set (0.00 sec)删除多个表头
//一起删除多个表头mysql> alter【奥-特】 table【忒-部】 studb【斯丢db】.stuinfo【斯丢因否】 drop【卓-普】 school【斯故】 , drop【卓-普】 班级 ,drop【卓-普】 mail【miào e】 ;-- mysql> alter table studb.stuinfo drop school,drop 班级,drop mail;Query OK, 0 rows affected (0.73 sec)Records: 0 Duplicates: 0 Warnings: 0
//查看表头mysql> desc studb【斯丢db】.stuinfo【斯丢因否】;-- mysql> desc studb.stuinfo;+--------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+----------+------+-----+---------+-------+| number | char(9) | YES | | NULL | || name | char(10) | YES | | NULL | || gender | char(4) | YES | | NULL | |+--------+----------+------+-----+---------+-------+3 rows in set (0.00 sec)修改表头的位置
mysql>//使用modify【莫迪fái】 修改表头的位置mysql> alter【奥-特】 table【忒-部】 studb【斯丢db】.stuinfo【斯丢因否】 modify【莫迪fái】 gender【间德尔】 char【查尔】(4) after【啊夫特】 number【能波】;-- mysql> alter table studb.stuinfo modify gender char(4) after number;Query OK, 0 rows affected (0.77 sec)Records: 0 Duplicates: 0 Warnings: 0
//查看表头mysql> desc studb【斯丢db】.stuinfo【斯丢因否】;-- mysql> desc studb.stuinfo;+--------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+----------+------+-----+---------+-------+| number | char(9) | YES | | NULL | || gender | char(4) | YES | | NULL | || name | char(10) | YES | | NULL | |+--------+----------+------+-----+---------+-------+3 rows in set (0.00 sec)
//再修改回原来位置mysql> alter【奥-特】 table【忒-部】 studb【斯丢db】.stuinfo【斯丢因否】 modify【莫迪fái】 gender【间德尔】 char【查尔】(4) after【啊夫特】 name;-- mysql> alter table studb.stuinfo modify gender char(4) after name;Query OK, 0 rows affected (0.50 sec)Records: 0 Duplicates: 0 Warnings: 0
//查看表头mysql> desc studb【斯丢db】.stuinfo【斯丢因否】;-- mysql> desc studb.stuinfo;+--------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+----------+------+-----+---------+-------+| number | char(9) | YES | | NULL | || name | char(10) | YES | | NULL | || gender | char(4) | YES | | NULL | |+--------+----------+------+-----+---------+-------+3 rows in set (0.01 sec)3.4 复制表
拷贝已有的表 和系统命令 cp 的功能一样
复制表
-- create table 表名 select * from 表名//复制moershi库salary【晒了瑞】表到 studb【斯丢db】库 表名不变mysql> create【克瑞特】 table【忒-部】 studb【斯丢db】.salary【晒了瑞】 select【涩莱克特】 * from【弗乱】 moershi.salary【晒了瑞】;-- mysql> create table studb.salary select * from moershi.salary;Query OK, 8055 rows affected (2.66 sec)Records: 8055 Duplicates: 0 Warnings: 0
//查看表头,源表的key【kì】 不会被复制mysql> desc studb【斯丢db】.salary【晒了瑞】;-- mysql> desc studb.salary;+-------------+------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+-------------+------+------+-----+---------+-------+| id | int | NO | | 0 | || date | date | YES | | NULL | || employee_id | int | YES | | NULL | || basic | int | YES | | NULL | || bonus | int | YES | | NULL | |+-------------+------+------+-----+---------+-------+5 rows in set (0.00 sec)
//查看表行数mysql> select【涩莱克特】 count【kàn特】(*) from【弗乱】 studb【斯丢db】.salary【晒了瑞】;-- mysql> select count(*) from studb.salary;+----------+| count(*) |+----------+| 8055 |+----------+1 row in set (0.00 sec)复制表头
//仅仅复制表头like【赖特mysql> create【克瑞特】 table【忒-部】 studb【斯丢db】.salary2【晒了瑞2】 like【赖特】 moershi.salary【晒了瑞】;-- mysql> create table studb.salary2 like moershi.salary;Query OK, 0 rows affected (0.95 sec)
//查看表头mysql> desc studb【斯丢db】.salary2【晒了瑞2】;-- mysql> desc studb.salary2;+-------------+------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+-------------+------+------+-----+---------+----------------+| id | int | NO | PRI | NULL | auto_increment || date | date | YES | | NULL | || employee_id | int | YES | MUL | NULL | || basic | int | YES | | NULL | || bonus | int | YES | | NULL | |+-------------+------+------+-----+---------+----------------+5 rows in set (0.00 sec)
//查看表行数mysql> select【涩莱克特】 count【kàn特】(*) from【弗乱】 studb【斯丢db】.salary2【晒了瑞2】;-- mysql> select count(*) from studb.salary2;+----------+| count(*) |+----------+| 0 |+----------+1 row in set (0.00 sec)mysql>四、表的字段数据类型
数值类型:INT存储整数,DECIMAL存储精确小数 字符类型:CHAR适合固定长度,VARCHAR适合可变长度 日期时间:DATE存储日期,TIME存储时间 枚举类型:ENUM存储预定义值列表
当前任务环节
flowchart LR subgraph BottomRow[表结构管理] direction LR A[表管理] --> B[表格字段数据类型] --> C[表头基本约束] end classDef highlight stroke:#f00,stroke-width:2px; class B highlight;常用数据类型:数值类型、字符类型、日期时间类型、枚举类型,每种类型都有对应的命令表示、有具体的存储范围。
- 比如存储: 身高、体重、工资、奖金,适合使用数值类型。
- 比如存储: 姓名、家庭地址、收货地址,适合使用字符类型。char
- 比如存储: 生日、出生年份、入职时间、下班时间、注册时间,适合使用日期时间。date(日期) time(时间) datetime(时间日期) yeaer(年份)
- 比如存储: 爱好、性别、社保医院,适合使用枚举类型。
4.1 练习字符类型的使用
命令操作如下所示:
//建表mysql> create【克瑞特】 table【忒-部】 studb【斯丢db】.t2(name char【查尔】(3) , address【额拽斯】 varchar【瓦儿-查儿】(5) );-- mysql> create table studb.t2(name char(3),adderss varchar(5));Query OK, 0 rows affected (0.30 sec)
//查看表头mysql> desc studb【斯丢db】.t2;-- mysql> desc studb.t2;+---------+------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+---------+------------+------+-----+---------+-------+| name | char(3) | YES | | NULL | || address | varchar(5) | YES | | NULL | |+---------+------------+------+-----+---------+-------+2 rows in set (0.00 sec)
//插入记录mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t2 values【挖柳斯】 ("a","a"); //正常-- mysql> insert into studb.t2 values("a","a");Query OK, 1 row affected (0.05 sec)
mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t2 values【挖柳斯】 ("ab","ab"); //正常-- mysql> insert into studb.t2 values ("ab","ab");Query OK, 1 row affected (0.08 sec)
mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t2 values【挖柳斯】 ("abc","abc");//正常-- mysql> insert into studb.t2 values ("abc","abc");Query OK, 1 row affected (0.04 sec)
mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t2 values【挖柳斯】 ("abcd","abcd"); //超出字符个数报错-- mysql> insert into studb.t2 values ("abcd","abcd");ERROR 1406 (22001): Data too long for column 'name' at row 1mysql8 建表默认支持中文字符集
//查看字符集mysql> show【瘦】 create【克瑞特】 table【忒-部】 studb【斯丢db】.t2 \G-- mysql> show create table studb.t2 \G*************************** 1. row *************************** Table: t2Create Table: CREATE TABLE `t2` ( `name` char【查尔】(3) DEFAULT NULL【nào】, `address【额拽斯】` varchar【瓦儿-查儿】(5) DEFAULT NULL【nào】) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci1 row in set (0.00 sec)
说明 :ENGINE=InnoDB 定义存储引擎(存储引擎课程里讲)DEFAULT CHARSET=定义表使用的字符集
//插入记录mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t2 values【挖柳斯】 ("张翠山","武当山");-- mysql> insert into studb.t2 values("张翠山","武当山");Query OK, 1 row affected (0.07 sec)
//查看表记录mysql> SELECT【涩莱克特】 * FROM【弗乱】 studb【斯丢db】.t2;-- mysql> select * from studb.t2;+-----------+-----------+| name | address |+-----------+-----------+| a | a || ab | ab || abc | abc || 张翠山 | 武当山 |+-----------+-----------+4 rows in set (0.00 sec)4.2 练习数值类型的使用
命令操作如下所示:
//建表mysql> create【克瑞特】 table【忒-部】 studb【斯丢db】.t1(name char【查尔】(10) , level【列沃】 tinyint【泰尼因特】 unsigned【安赛因德】 , money【孟妮】 double【答步】 );-- mysql> create table studb.t1(name char(10),level tinyint unsigned , money double );Query OK, 0 rows affected (0.72 sec)
//查看表头mysql> desc studb【斯丢db】.t1;-- mysql> desc studb.t1;+-------+------------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+-------+------------------+------+-----+---------+-------+| name | char(10) | YES | | NULL | || level | tinyint unsigned | YES | | NULL | || money | double | YES | | NULL | |+-------+------------------+------+-----+---------+-------+3 rows in set (0.00 sec)
//插入数据mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t1 values【挖柳斯】("法师",80,88);-- mysql> insert into studb.t1 values("法师",80,88);Query OK, 1 row affected (0.04 sec)
//超出范围报错 tinyint unsigned 最大255 可以是小数,四舍五入取整mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t1 values【挖柳斯】("战士",301,1.292);-- mysql> insert into studb.t1 values("战士",301,1.292);ERROR 1264 (22003): Out of range value for column 'level【列沃】' at row 1 -- 失败是因为值301超出了TINYINT UNSIGNED的数据范围(0-255)
mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t1 values【挖柳斯】("猎人",255,1.292);-- mysql> insert into studb.t1 values("猎人",255,1.292);Query OK, 1 row affected (0.06 sec)
//整数类型 不存储小数位mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t1 values【挖柳斯】 ("英雄",1.292,6.78);-- mysql> insert into studb.t1 values("英雄",1.292,6.78);Query OK, 1 row affected (0.07 sec)
//查看表记录mysql> select【涩莱克特】 * from【弗乱】 studb【斯丢db】.t1 ;-- mysql> select * from studb.t1;+--------+-------+-------+| name | level | money |+--------+-------+-------+| 法师 | 80 | 88 || 猎人 | 255 | 1.292 || 英雄 | 1 | 6.78 |+--------+-------+-------+3 rows in set (0.00 sec)4.3 枚举类型
//建表mysql> create【克瑞特】 table【忒-部】 studb【斯丢db】.t8( -> 姓名 char【查尔】(10), -> 性别 enum【伊牛姆】("男","女","保密"), -> 爱好 set【赛特】("帅哥","金钱","吃","睡") -> );-- mysql> create table studb.t8(-- -> 姓名 char(10),-- -> 性别 enum("男","女","保密"),-- -> 爱好 set("帅哥","金钱","吃","睡"));Query OK, 0 rows affected (0.29 sec)
//查看表头mysql> desc studb【斯丢db】.t8 ;-- mysql> desc studb.t8;+--------+------------------------------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+------------------------------------+------+-----+---------+-------+| 姓名 | char(10) | YES | | NULL | || 性别 | enum('男','女','保密') | YES | | NULL | || 爱好 | set('帅哥','金钱','吃','睡') | YES | | NULL | |+--------+------------------------------------+------+-----+---------+-------+3 rows in set (0.01 sec)
//插入记录超出范围报错mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t8 values【挖柳斯】 ("小包总","男人","帅哥,睡,金钱");-- mysql> insert into studb.t8 values ("小包总","男人","帅哥,睡,金钱");ERROR 1265 (01000): Data truncated for column '性别' at row 1 -- 值"男人"不在ENUM类型的预定义值列表中(只有'男','女','保密')
mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t8 values【挖柳斯】 ("小包总","男","美女,睡,金钱");-- mysql> insert into studb.t8 values ("小包总","男","美女,睡,金钱");ERROR 1265 (01000): Data truncated for column '爱好' at row 1 --"爱好"字段只包含'帅哥','金钱','吃','睡'四个值,不包含"美女"这个值
//在范围内插入成功mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t8 values【挖柳斯】 ("丫丫","女","帅哥,吃");-- mysql> insert into studb.t8 values("丫丫","女","帅哥,吃");Query OK, 1 row affected (0.09 sec)
mysql> select【涩莱克特】 * from【弗乱】 studb【斯丢db】.t8;-- mysql> select * from studb.t8;+--------+--------+------------+| 姓名 | 性别 | 爱好 |+--------+--------+------------+| 丫丫 | 女 | 帅哥,吃 |+--------+--------+------------+1 row in set (0.00 sec)4.4 练习日期时间类型的使用
命令操作如下所示:
//建表mysql> create【克瑞特】 table【忒-部】 studb【斯丢db】.t6( -> 姓名 char【查尔】(10), -> 生日 date , -> 出生年份 year【耶尔】, -> 家庭聚会 datetime , -> 聚会地点 varchar【瓦儿-查儿】(15), -> 上班时间 time -> );-- mysql> create table studb.t6(-- -> 姓名 char(10),-- -> 生日 date,-- -> 出生年份 year,-- -> 家庭聚会 datetime,-- -> 聚会地点 varchar(15),-- -> 上班时间 time);Query OK, 0 rows affected (0.25 sec)
//查看表头mysql> desc studb【斯丢db】.t6 ;-- mysql> desc studb.t6;+--------------+-------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------------+-------------+------+-----+---------+-------+| 姓名 | char(10) | YES | | NULL | || 生日 | date | YES | | NULL | || 出生年份 | year | YES | | NULL | || 家庭聚会 | datetime | YES | | NULL | || 聚会地点 | varchar(15) | YES | | NULL | || 上班时间 | time | YES | | NULL | |+--------------+-------------+------+-----+---------+-------+6 rows in set (0.00 sec)
//插入表头mysql> insert【因涩特】 into【因兔】 studb【斯丢db】.t6 -> values【挖柳斯】 ("翠花",20211120,1990,20220101183000,"天坛校区",090000);-- mysql> insert into studb.t6-- -> values ("翠花",20211120,1990,20220101183000,"天坛校区",090000);Query OK, 1 row affected (0.05 sec)
//查看表记录mysql> select【涩莱克特】 * from【弗乱】 studb【斯丢db】.t6;-- mysql> select * from studb.t6;+--------+------------+--------------+---------------------+--------------+--------------+| 姓名 | 生日 | 出生年份 | 家庭聚会 | 聚会地点 | 上班时间 |+--------+------------+--------------+---------------------+--------------+--------------+| 翠花 | 2021-11-20 | 1990 | 2022-01-01 18:30:00 | 天坛校区 | 09:00:00 |+--------+------------+--------------+---------------------+--------------+--------------+1 row in set (0.00 sec)五、表头基本约束
当前任务环节
flowchart LR subgraph BottomRow[表结构管理] direction LR A[表管理] --> B[表格字段数据类型] --> C[表头基本约束] end classDef highlight stroke:#f00,stroke-width:2px; class C highlight;约束是一种限制,设置在表头上,用来控制表头的赋值,包括以下几种:
- NOT【nuō 特】 NULL【nò】 :非空,用于保证该字段的值不能为空。
- DEFAULT【迪-佛特】:默认值,用于保证该字段有默认值。
- UNIQUE【U尼克】:唯一索引,用于保证该字段的值具有唯一性,可以为空。
- primary【普赖莫瑞】 KEY【kì】:主键,用于保证该字段的值具有唯一性并且非空。
- FOREIGN【佛润】 KEY【kì】:外键,用于限制两个表的关系,用于保证该字段的值必须来自于主表的关联列的值,在从表添加外键约束,用于引用主表中某些的值。
5.1 表头不允许赋空值
//建表时给表头设置默认和不允许赋null【nào】值mysql> create【克瑞特】 database【得塔-贝斯】 if not【nuō 特】 exists【伊贼谁斯】 db1;-- mysql> create database if not exists db1;Query OK, 1 row affected (0.07 sec)
//建表mysql> create【克瑞特】 table【忒-部】 db1.t31( -> name char【查尔】(10) not【nuō 特】 null【nào】 , -> class【克拉斯】 char【查尔】(7) default【迪-佛特】 "nsd", -> likes【赖特s】 set【赛特】("money【孟妮】","game","film","music") not【nuō 特】 null【nào】 default【迪-佛特】 "film,music" );-- mysql> create table db1.t31(-- -> name char(10) not null,-- -> class char(7) default "nsd",-- -> likes set("money","game","film","music") not null default "film,music" );Query OK, 0 rows affected (0.43 sec)
//查看表头mysql> desc db1.t31;-- mysql> desc db1.t31;+-------+------------------------------------+------+-----+------------+-------+| Field | Type | Null | Key | Default | Extra |+-------+------------------------------------+------+-----+------------+-------+| name | char(10) | NO | | NULL | || class | char(7) | YES | | nsd | || likes | set('money','game','film','music') | NO | | film,music | |+-------+------------------------------------+------+-----+------------+-------+3 rows in set (0.01 sec)
//验证默认值和不允许为nullmysql> insert【因涩特】 into【因兔】 db1.t31 values【挖柳斯】 (null, null , null);-- mysql> insert into db1.t31 values(null, null , null);ERROR 1048 (23000): Column 'name' cannot be null //表头name赋null值 报错
//表头likes【赖特s】赋null值 报错mysql> insert【因涩特】 into【因兔】 db1.t31 values【挖柳斯】 ("bob", null , null);-- mysql> insert into db1.t31 values("bob", null , null);ERROR 1048 (23000): Column 'likes' cannot be null
//符合约束不报错mysql> insert【因涩特】 into【因兔】 db1.t31 values【挖柳斯】 ("bob",null,"money【孟妮】,game,film");-- mysql> insert into db1.t31 values("bob",null,"money,game,film");Query OK, 1 row affected (0.06 sec)
//不赋值的表头使用默认值赋值mysql> insert【因涩特】 into【因兔】 db1.t31(name) values【挖柳斯】("jim");-- mysql> insert into db1.t31(name) values("jim");-- Query OK, 1 row affected (0.01 sec)
//根据需要自定义表头的值mysql> insert【因涩特】 into【因兔】 db1.t31 values【挖柳斯】 ("lucy","nsd2108","game,film");-- mysql> insert into db1.t31 values("lucy","nsd2108","game,film");-- Query OK, 1 row affected (0.14 sec)
//查看表记录mysql> select【涩莱克特】 * from【弗乱】 db1.t31;-- mysql> select * from db1.t31;+------+---------+-----------------+| name | class | likes |+------+---------+-----------------+| bob | NULL | money,game,film || jim | nsd | film,music || lucy | nsd2108 | game,film |+------+---------+-----------------+3 rows in set (0.00 sec)5.2 表头加唯一索引练习
唯一索引 (unique【U尼克】)
约束的方式:表头值唯一 , 但可以赋null 值
//建表create【克瑞特】 table【忒-部】 db1.t32 (姓名 char【查尔】(10) , 护照 char【查尔】(18) unique【U尼克】 );-- mysql> create table db1.t32 (姓名 char(10) , 护照 char(18) unique);
//查看表头 唯一索引标志UNImysql> desc db1.t32 ;-- mysql> desc db1.t32;+--------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+----------+------+-----+---------+-------+| 姓名 | char(10) | YES | | NULL | || 护照 | char(18) | YES | UNI | NULL | |+--------+----------+------+-----+---------+-------+2 rows in set (0.00 sec)
//赋null值 可以mysql> insert【因涩特】 into【因兔】 db1.t32 values【挖柳斯】("bob",null);-- mysql> insert into db1.t32 values("bob",null);Query OK, 1 row affected (0.07 sec)
//表头值重复不可以mysql> insert【因涩特】 into【因兔】 db1.t32 values【挖柳斯】("tom","666888");-- mysql> insert into db1.t32 values("tom","666888");Query OK, 1 row affected (0.08 sec)
mysql> insert【因涩特】 into【因兔】 db1.t32 values【挖柳斯】("jim","666888");-- mysql> insert into db1.t32 values("jim","666888");ERROR 1062 (23000): Duplicate entry '666888' for key【kì】 't32.护照'
//不重复 可以mysql> insert【因涩特】 into【因兔】 db1.t32 values【挖柳斯】("jim","766888");-- mysql> insert into db1.t32 values("jim","766888");Query OK, 1 row affected (0.05 sec)
//查看表记录mysql> select【涩莱克特】 * from【弗乱】 DB1.t32;-- mysql> select * from db1.t32;+------+--------+| 姓名 | 护照 |+------+--------+| bob | NULL || tom | 666888 || jim | 766888 |+------+--------+3 rows in set (0.00 sec)2 bob nsd2107 bj
3 bob nsd2107 bj
4 bob nsd2107 bj
1)建表
mysql> create【克瑞特】 table【忒-部】 db1.t38 ( -> 行号 int【因特】 primary【普赖莫瑞】 key【kì】 auto_increment【奥特欧_因克瑞门特】 , -> 姓名 char【查尔】(10) , -> 班级 char【查尔】(7) , -> 住址 char【查尔】(10) -> );-- mysql> create table db1.t38(-- -> 行号 int primary key auto_increment,-- -> 姓名 char(10),-- -> 班级 char(7),-- -> 住址 char(10));Query OK, 0 rows affected (0.76 sec)
//查看表头mysql> desc db1.t38 ;-- mysql> desc db1.t38;+--------+----------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+--------+----------+------+-----+---------+----------------+| 行号 | int | NO | PRI | NULL | auto_increment || 姓名 | char(10) | YES | | NULL | || 班级 | char(7) | YES | | NULL | || 住址 | char(10) | YES | | NULL | |+--------+----------+------+-----+---------+----------------+4 rows in set (0.00 sec)
//插入表记录 不给自增长表头赋值mysql> insert【因涩特】 into【因兔】 db1.t38(姓名,班级,住址) values【挖柳斯】("bob","nsd2107","bj");-- mysql> insert into db1.t38(姓名,班级,住址) values("bob","nsd2107","bj");Query OK, 1 row affected (0.05 sec)
mysql> insert【因涩特】 into【因兔】 db1.t38(姓名,班级,住址) values【挖柳斯】("bob","nsd2107","bj");-- mysql> insert into db1.t38(姓名,班级,住址) values("bob","nsd2107","bj");Query OK, 1 row affected (0.04 sec)
mysql> insert【因涩特】 into【因兔】 db1.t38(姓名,班级,住址) values【挖柳斯】("tom","nsd2107","bj");-- mysql> insert into db1.t38(姓名,班级,住址) values("tom","nsd2107","bj");Query OK, 1 row affected (0.05 sec)
//查看表记录mysql> select【涩莱克特】 * from【弗乱】 db1.t38;-- mysql> select * from db1.t38;+--------+--------+---------+--------+| 行号 | 姓名 | 班级 | 住址 |+--------+--------+---------+--------+| 1 | bob | nsd2107 | bj || 2 | bob | nsd2107 | bj || 3 | tom | nsd2107 | bj |+--------+--------+---------+--------+3 rows in set (0.00 sec)六、作业
1 选择题
- 在 MySQL 中创建表时,用于定义字段为字符类型且长度为 20 的是以下哪种写法?A A. CHAR(20) B. TEXT(20) C. INT(20) D. FLOAT(20)
讲解:CHAR是固定长度的字符类型,TEXT是可变长度文本类型不能指定长度,INT是整数类型,FLOAT是浮点数类型。- 若要修改表名为
students的表,将其中age字段的数据类型从INT改为SMALLINT,应使用以下哪条语句? B A. UPDATE TABLE students CHANGE age age SMALLINT; B. ALTER TABLE students MODIFY age SMALLINT; C. MODIFY TABLE students ALTER age SMALLINT; D. CHANGE TABLE students UPDATE age SMALLINT;
讲解:使用ALTER TABLE + MODIFY来修改字段数据类型,CHANGE用于修改字段名。- 以下哪种方法可以复制表
orders的结构和数据到新表orders_copy?A A. CREATE TABLE orders_copy AS SELECT * FROM orders; B. COPY TABLE orders TO orders_copy; C. INSERT INTO orders_copy SELECT * FROM orders; D. CLONE TABLE orders orders_copy;
讲解:这是最常用的复制表方法,会同时复制表结构和数据。- 以下适合存储邮件地址的字段类型是?C A. DATE B. DECIMAL C. VARCHAR D. TINYINT
讲解:邮件地址是可变长度字符串,VARCHAR最适合。DATE是日期,DECIMAL是小数,TINYINT是整数。- 要在创建表
products时,确保product_name字段的值不为空,应使用以下哪种约束? B A. UNIQUE B. NOT NULL C. CHECK D. DEFAULT
讲解:NOT NULL约束确保字段必须有值,不能为空。2 简答题
-
简述在 MySQL 中创建表时,如何选择合适的字段类型,请举例说明。 答: 存储: 身高、体重、工资、奖金,适合使用数值类型。如:tinyint unsigned、long、int 存储: 姓名、家庭地址、收货地址,适合使用字符类型。如:char、varchar 存储: 生日、出生年份、入职时间、下班时间、注册时间,适合使用日期时间。date、time、datetime、year 存储: 爱好、性别、社保医院,适合使用枚举类型。如:enum、set
-
说明使用
ALTER TABLE语句修改表结构时,修改字段名和修改字段数据类型的操作有什么不同。 答: 1. 修改字段数据类型: 语法:alter table 数据库.表 modify 字段名 新数据类型; 2. 修改字段名: 语法:alter table 数据库.表 change 旧字段名 新字段名 数据类型; -
复制表有哪几种常见方式,它们各自的优缺点是什么? 答: 1. 复制表结构(不复制数据) 语法:CREATE TABLE 新表名 LIKE 旧表名; 优点:快速,只复制结构 缺点:不包含数据 2. 复制表结构和数据: 语法:CREATE TABLE 新表名 AS SELECT * FROM 旧表名; 优点:同时复制结构和数据 缺点:不复制索引和约束
-
解释表的基本约束
NOT NULL和DEFAULT的作用,并举例说明如何在创建表时使用。 答: NOT NULL: 作用: 不允许字段为空、字段必须有值 举例: create table 数据库.表 (字段名 数据类型 not null); DEFAULT: 作用: 设置字段的默认值、当不赋值时使用 举例: create table 数据库.表 (字段名 数据类型 default 默认值);
3 操作题
- 创建一个名为
books的表,包含字段book_title(字符串类型,长度不超过 100)、publish_year(年份类型)、price(小数类型,保留两位小数)。
mysql> create table if not exists studb.books ( -> id int auto_increment primary key, -> book_title varchar(100), -> publish_year year, -> price decimal(10,2) -> );Query OK, 0 rows affected (0.94 sec)
mysql> desc studb.books;+--------------+---------------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+--------------+---------------+------+-----+---------+----------------+| id | int | NO | PRI | NULL | auto_increment || book_title | varchar(100) | YES | | NULL | || publish_year | year | YES | | NULL | || price | decimal(10,2) | YES | | NULL | |+--------------+---------------+------+-----+---------+----------------+4 rows in set (0.00 sec)
mysql>- 在
books表中添加一个新字段author,类型为字符串,长度不超过 50。
mysql>mysql> alter table studb.books add author varchar(50);Query OK, 0 rows affected (2.88 sec)Records: 0 Duplicates: 0 Warnings: 0
mysql> desc studb.books;+--------------+---------------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+--------------+---------------+------+-----+---------+----------------+| id | int | NO | PRI | NULL | auto_increment || book_title | varchar(100) | YES | | NULL | || publish_year | year | YES | | NULL | || price | decimal(10,2) | YES | | NULL | || author | varchar(50) | YES | | NULL | |+--------------+---------------+------+-----+---------+----------------+5 rows in set (0.00 sec)- 复制
books表的结构和数据到一个新表books_archive。
mysql> create table studb.books_archive select * from studb.books;Query OK, 0 rows affected (1.29 sec)Records: 0 Duplicates: 0 Warnings: 0
mysql> show tables;+-----------------+| Tables_in_studb |+-----------------+| books || books_archive || salary || salary2 || stuinfo || t1 || t2 || t6 || t8 |+-----------------+9 rows in set (0.00 sec)
mysql> desc books_archive;+--------------+---------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------------+---------------+------+-----+---------+-------+| id | int | NO | | 0 | || book_title | varchar(100) | YES | | NULL | || publish_year | year | YES | | NULL | || price | decimal(10,2) | YES | | NULL | || author | varchar(50) | YES | | NULL | |+--------------+---------------+------+-----+---------+-------+5 rows in set (0.00 sec)- 修改
books表中price字段的默认值为 0。
mysql> alter table books modify price decimal(10,2) default 0;Query OK, 0 rows affected (0.23 sec)Records: 0 Duplicates: 0 Warnings: 0
mysql> desc books;+--------------+---------------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+--------------+---------------+------+-----+---------+----------------+| id | int | NO | PRI | NULL | auto_increment || book_title | varchar(100) | YES | | NULL | || publish_year | year | YES | | NULL | || price | decimal(10,2) | YES | | 0.00 | || author | varchar(50) | YES | | NULL | |+--------------+---------------+------+-----+---------+----------------+5 rows in set (0.00 sec)
mysql>- 将
books表中的book_title字段设置为不允许为空。
mysql> alter table books modify book_title varchar(100) not null;Query OK, 0 rows affected (2.19 sec)Records: 0 Duplicates: 0 Warnings: 0
mysql> desc books;+--------------+---------------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+--------------+---------------+------+-----+---------+----------------+| id | int | NO | PRI | NULL | auto_increment || book_title | varchar(100) | NO | | NULL | || publish_year | year | YES | | NULL | || price | decimal(10,2) | YES | | 0.00 | || author | varchar(50) | YES | | NULL | |+--------------+---------------+------+-----+---------+----------------+5 rows in set (0.00 sec)06:mysql之主键外键索引
今日工作任务路线图
flowchart LR subgraph BottomRow[主键外键索引] direction LR A[主键] --> B[外键] --> C[MySQL索引] end classDef highlight stroke:#f00,stroke-width:2px; class E highlight;一、工作场景
小型电商公司
林悦是一家小型电商公司的数据库管理员。随着业务发展,订单量逐渐增多,数据库查询变得缓慢。林悦发现订单表缺乏主键约束,数据存在重复,在查询某一订单时效率极低。同时,订单表和商品表之间没有设置外键关联,导致数据一致性难以保证。她为订单表添加主键,建立订单表与商品表的外键关系,并在经常用于查询的字段上创建索引,大大提高了数据查询和写入的效率,保障了数据的准确性。
大型互联网企业
张成就职于大型互联网企业,负责管理用户相关数据库。该企业用户数量庞大,每天产生海量数据。在用户表中,使用自增主键确保数据的唯一标识。为了关联用户表和用户行为表,设置了外键约束,保证数据的参照完整性。随着业务复杂度增加,查询需求多样化,他依据不同业务需求,在用户表的常用查询字段如“注册时间”“用户等级”上创建索引,显著提升了系统响应速度。
二、作用、为什么要学呢
学习 MySQL 的主键、外键和索引十分必要。
从数据完整性看 主键能唯一标识表中每行数据,防止数据重复,确保数据准确。 外键可建立表间关联,保证数据参照完整性,避免出现孤立或错误关联的数据。
从查询性能上 索引能加快数据查询速度。在海量数据中,如果没有索引,查询会全表扫描,效率极低。 合理创建索引后,数据库能快速定位到所需数据。
在实际应用里 如电商系统、金融系统等,都离不开这些技术保障数据质量与系统性能。 掌握它们能让你更高效地管理和操作数据库,为项目稳定运行提供有力支持。
三、主键
当前任务环节
flowchart LR subgraph BottomRow[主键外键索引] direction LR A[主键] --> B[外键] --> C[MySQL索引] end classDef highlight stroke:#f00,stroke-width:2px; class A highlight;主键使用规则:
- 表头值不允许重复,不允许赋NULL【nò】值
- 一个表中只能有一个primary【普赖莫瑞】 key【kì】 表头
- 多个表头做主键,称为复合主键,必须一起创建和删除
- 主键标志PRI
- 主键通常与auto_increment【奥特欧_因克瑞门特】连用
- 通常把表中唯一标识记录的表头设置为主键[行号表]
3.1 主键的创建、查看、删除、添加、验证主键
创建表时创建主键
//语法格式1create【克瑞特】 table【忒-部】 库.表( 表头名 数据类型 primary【普赖莫瑞】 key【kì】 , 表头名 数据类型 , ..... );
//建表mysql> create【克瑞特】 table【忒-部】 db1.t35( -> name char【查尔】(10) , -> hz_id char【查尔】(10) primary【普赖莫瑞】 key【kì】 , -> class【克拉斯】 char【查尔】(10) -> );-- mysql> create table db1.t35(-- -> name char(10),-- -> hz_id char(10) primary key,-- -> class char(10));Query OK, 0 rows affected (0.49 sec)
//查看表头mysql> desc db1.t35;+-------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+-------+----------+------+-----+---------+-------+| name | char(10) | YES | | NULL | || hz_id | char(10) | NO | PRI | NULL | || class | char(10) | YES | | NULL | |+-------+----------+------+-----+---------+-------+3 rows in set (0.00 sec)
//语法格式2create【克瑞特】 table【忒-部】 库.表( 字段名 类型 , 字段名 类型 , primary【普赖莫瑞】 key【kì】(字段名) );
//建表mysql> create【克瑞特】 table【忒-部】 db1.t36( -> name char【查尔】(10) , -> hz_id char【查尔】(10) , -> class【克拉斯】 char【查尔】(10), -> primary【普赖莫瑞】 key【kì】(hz_id) -> );-- mysql> create table db1.t36(-- -> name char(10),-- -> hz_id char(10),-- -> class char(10),-- -> primary key(hz_id));Query OK, 0 rows affected (0.39 sec)
//查看表头mysql> desc db1.t36;+-------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+-------+----------+------+-----+---------+-------+| name | char(10) | YES | | NULL | || hz_id | char(10) | NO | PRI | NULL | || class | char(10) | YES | | NULL | |+-------+----------+------+-----+---------+-------+3 rows in set (0.00 sec)删除主键
//删除主键命令格式mysql> alter【奥-特】 table【忒-部】 库.表 drop【卓-普】 primary【普赖莫瑞】 key【kì】 ;
//例子mysql> alter【奥-特】 table【忒-部】 db1.t36 drop【卓-普】 primary【普赖莫瑞】 key【kì】 ;-- mysql> alter table db1.t36 drop primary key;Query OK, 0 rows affected (1.00 sec)Records: 0 Duplicates: 0 Warnings: 0
//查看表头mysql> desc db1.t36;+-------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+-------+----------+------+-----+---------+-------+| name | char(10) | YES | | NULL | || hz_id | char(10) | NO | | NULL | || class | char(10) | YES | | NULL | |+-------+----------+------+-----+---------+-------+3 rows in set (0.00 sec)mysql>添加主键
//添加主键命令格式mysql> alter【奥-特】 table【忒-部】 库.表 add primary【普赖莫瑞】 key【kì】(表头名);
//例子mysql> alter【奥-特】 table【忒-部】 db1.t36 add primary【普赖莫瑞】 key【kì】(hz_id);-- mysql> alter table db1.t36 add primary key(hz_id);mysql> desc db1.t36;+-------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+-------+----------+------+-----+---------+-------+| name | char(10) | YES | | NULL | || hz_id | char(10) | NO | PRI | NULL | || class | char(10) | YES | | NULL | |+-------+----------+------+-----+---------+-------+3 rows in set (0.00 sec)验证主键约束
//使用t35表 验证主键约束//查看主键表头mysql> desc db1.t35;+-------+----------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+-------+----------+------+-----+---------+-------+| name | char(10) | YES | | NULL | || hz_id | char(10) | NO | PRI | NULL | || class | char(10) | YES | | NULL | |+-------+----------+------+-----+---------+-------+3 rows in set (0.00 sec)
-- 插入第1条记录 正常mysql> insert【因涩特】 into【因兔】 db1.t35 values【挖柳斯】 ("bob","888","nsd2107");-- mysql> insert into db1.t35 values("bob","888","nsd2107");Query OK, 1 row affected (0.05 sec)
-- 主键表头值不允许为null【nò】,否则插入失败mysql> insert【因涩特】 into【因兔】 db1.t35 values【挖柳斯】 ("john",null【nò】,"nsd2107");-- mysql> insert into db1.t35 values("john",null,"nsd2107");ERROR 1048 (23000): Column 'hz_id' cannot be null【nò】mysql>
-- 主键表头值不允许重复,否则插入失败mysql> insert【因涩特】 into【因兔】 db1.t35 values【挖柳斯】 ("john","888","nsd2107");-- mysql> insert into db1.t35 values("john","888","nsd2107");ERROR 1062 (23000): Duplicate entry '888' for key【kì】 'primary【普赖莫瑞】'
-- 主键表头值不重复也不是null【nò】可以mysql> insert【因涩特】 into【因兔】 db1.t35 values【挖柳斯】 ("john","988","nsd2107");-- mysql> insert into db1.t35 values("john","988","nsd2107");Query OK, 1 row affected (0.07 sec)
-- 查看表记录mysql> select【涩莱克特】 * from【弗乱】 db1.t35 ;-- mysql> select * from db1.t35;+------+-------+---------+| name | hz_id | class |+------+-------+---------+| bob | 888 | nsd2107 || john | 988 | nsd2107 |+------+-------+---------+2 rows in set (0.00 sec)3.2 复合主键的使用
创建表时创建复合主键
-- 创建复合主键 表头依次是客户端ip 、服务端口号、访问状态mysql> create【克瑞特】 table【忒-部】 db1.t39(cip varchar【瓦儿-查儿】(15) ,port【破特】 smallint【斯莫尔因特】,status【s 塔丢】 enum【ing纽某】("deny【迪奈】","allow【饿劳】") ,primary【普赖莫瑞】 key【kì】(cip,port【破特】));-- mysql> create table db1.t39(-- -> cip varchar(15),-- -> port smallint,-- -> status enum("deny","allow"),-- -> primary key(cip,port));
-- 插入记录验证insert【因涩特】 into【因兔】 db1.t39 values【挖柳斯】 ("1.1.1.1",22,"deny【迪奈】");-- mysql> insert into db1.t39 values("1.1.1.1",22,"deny");-- Query OK, 1 row affected (0.09 sec)
insert【因涩特】 into【因兔】 db1.t39 values【挖柳斯】 ("1.1.1.1",22,"deny【迪奈】"); --两个复合主键相同报错-- mysql> insert into db1.t39 values("1.1.1.1",22,"deny");-- ERROR 1062 (23000): Duplicate entry '1.1.1.1-22' for key 't39.PRIMARY'
insert【因涩特】 into【因兔】 db1.t39 values【挖柳斯】 ("1.1.1.1",80,"deny【迪奈】"); -- 单个复合主键相同可以插入-- mysql> insert into db1.t39 values("1.1.1.1",80,"deny");-- Query OK, 1 row affected (0.10 sec)
insert【因涩特】 into【因兔】 db1.t39 values【挖柳斯】 ("2.1.1.1",80,"allow【饿劳】"); -- 单个复合主键相同可以插入-- mysql> insert into db1.t39 values("2.1.1.1",80,"allow");-- Query OK, 1 row affected (0.10 sec)
-- 查看记录mysql> select【涩莱克特】 * from【弗乱】 db1.t39;-- mysql> select * from db1.t39;+---------+------+--------+| cip | port | status |+---------+------+--------+| 1.1.1.1 | 22 | deny || 1.1.1.1 | 80 | deny || 2.1.1.1 | 80 | allow |+---------+------+--------+3 rows in set (0.00 sec)删除复合主键
//删除复合主键mysql> alter【奥-特】 table【忒-部】 db1.t39 drop【卓-普】 primary【普赖莫瑞】 key【kì】;-- mysql> alter table db1.t39 drop primary key;Query OK, 3 rows affected (1.10 sec)Records: 3 Duplicates: 0 Warnings: 0
//查看表头mysql> desc db1.t39;-- mysql> desc db1.t39;+--------+----------------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+----------------------+------+-----+---------+-------+| cip | varchar(15) | NO | | NULL | || port | smallint | NO | | NULL | || status | enum('deny','allow') | YES | | NULL | |+--------+----------------------+------+-----+---------+-------+3 rows in set (0.00 sec)
//没有复合主键约束后 ,插入记录不受限制了mysql> insert【因涩特】 into【因兔】 db1.t39 values【挖柳斯】("2.1.1.1",80,"allow【饿劳】");-- mysql> insert into db1.t39 values("2.1.1.1",80,"allow");Query OK, 1 row affected (0.06 sec)mysql> insert【因涩特】 into【因兔】 db1.t39 values【挖柳斯】("2.1.1.1",80,"deny【迪奈】");--mysql> insert into db1.t39 values("2.1.1.1",80,"deny");Query OK, 1 row affected (0.08 sec)
//查看表记录mysql> select【涩莱克特】 * from【弗乱】 db1.t39;-- mysql> select * from db1.t39;+---------+------+--------+| cip | port | status |+---------+------+--------+| 1.1.1.1 | 22 | deny || 1.1.1.1 | 80 | deny || 2.1.1.1 | 80 | allow || 2.1.1.1 | 80 | allow || 2.1.1.1 | 80 | deny |+---------+------+--------+5 rows in set (0.00 sec)添加复合主键
//添加复合主键时 字段下的数据与主键约束冲突 不允许添加mysql> alter【奥-特】 table【忒-部】 db1.t39 add primary【普赖莫瑞】 key【kì】(cip,port【破特】);-- mysql> alter table db1.t39 add primary key(cip,port);ERROR 1062 (23000): Duplicate entry '2.1.1.1-80' for key【kì】 't39.primary【普赖莫瑞】'
//删除重复的数据mysql> delete【迪 利 特】 from【弗乱】 db1.t39 where【威尔】 cip="2.1.1.1";-- mysql> delete from db1.t39 where cip="2.1.1.1";Query OK, 3 rows affected (0.05 sec)
mysql> select【涩莱克特】 * from【弗乱】 db1.t39;-- mysql> select * from db1.t39;+---------+------+--------+| cip | port | status |+---------+------+--------+| 1.1.1.1 | 22 | deny || 1.1.1.1 | 80 | deny |+---------+------+--------+2 rows in set (0.00 sec)
//添加复合主键mysql> alter【奥-特】 table【忒-部】 db1.t39 add primary【普赖莫瑞】 key【kì】(cip,port【破特】);-- mysql> alter table db1.t39 add primary key(cip,port);Query OK, 0 rows affected (0.67 sec)Records: 0 Duplicates: 0 Warnings: 0
//查看表头mysql> desc db1.t39;-- mysql> desc db1.t39;+--------+----------------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+----------------------+------+-----+---------+-------+| cip | varchar(15) | NO | PRI | NULL | || port | smallint | NO | PRI | NULL | || status | enum('deny','allow') | YES | | NULL | |+--------+----------------------+------+-----+---------+-------+3 rows in set (0.00 sec)3.3 auto_increment【奥特欧_因克瑞门特】的使用
表头设置了auto_increment【奥特欧_因克瑞门特】属性后,
插入记录时,如果不给表头赋值表头通过自加1的计算结果赋值
要想让表头有自增长 表头必须有主键设置才可以
查看表结构时 在 Extra【埃斯处了】 (额外设置) 位置显示
建表时 创建有auto_increment【奥特欧_因克瑞门特】 属性的表头。实现的效果如下:
| 行号 | 姓名 | 班级 | 住址 |
|---|---|---|---|
| 1 | bob | nsd2107 | bj |
| 2 | bob | nsd2107 | bj |
| 3 | bob | nsd2107 | bj |
| 4 | bob | nsd2107 | bj |
1)建表
mysql> create【克瑞特】 table【忒-部】 db1.t38 ( -> 行号 int【因特】 primary【普赖莫瑞】 key【kì】 auto_increment【奥特欧_因克瑞门特】, -> 姓名 char【查尔】(10) , -> 班级 char【查尔】(7) , -> 住址 char【查尔】(10) -> );-- mysql> create table db1.t38(-- -> 行号 int primary key auto_increment,-- -> 姓名 char(10),-- -> 班级 char(7),-- -> 住址 char(10));Query OK, 0 rows affected (0.76 sec)
//查看表头mysql> desc db1.t38 ;-- mysql> desc db1.t38;+--------+----------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+--------+----------+------+-----+---------+----------------+| 行号 | int | NO | PRI | NULL | auto_increment || 姓名 | char(10) | YES | | NULL | || 班级 | char(7) | YES | | NULL | || 住址 | char(10) | YES | | NULL | |+--------+----------+------+-----+---------+----------------+4 rows in set (0.00 sec)
//插入表记录 不给自增长表头赋值mysql> insert【因涩特】 into【因兔】 db1.t38(姓名,班级,住址) values【挖柳斯】("bob","nsd2107","bj");-- mysql> insert into db1.t38(姓名,班级,住址) values("bob","nsd2107","bj");Query OK, 1 row affected (0.05 sec)
mysql> insert【因涩特】 into【因兔】 db1.t38(姓名,班级,住址) values【挖柳斯】("bob","nsd2107","bj");-- mysql> insert into db1.t38(姓名,班级,住址) values("bob","nsd2107","bj");Query OK, 1 row affected (0.04 sec)
mysql> insert【因涩特】 into【因兔】 db1.t38(姓名,班级,住址) values【挖柳斯】("tom","nsd2107","bj");-- mysql> insert into db1.t38(姓名,班级,住址) values("tom","nsd2107","bj");Query OK, 1 row affected (0.05 sec)
//查看表记录mysql> select【涩莱克特】 * from【弗乱】 db1.t38;-- mysql> select * from db1.t38;+--------+--------+---------+--------+| 行号 | 姓名 | 班级 | 住址 |+--------+--------+---------+--------+| 1 | bob | nsd2107 | bj || 2 | bob | nsd2107 | bj || 3 | tom | nsd2107 | bj |+--------+--------+---------+--------+3 rows in set (0.00 sec)自增长使用注意事项
//给自增长字段的赋值mysql> insert【因涩特】 into【因兔】 db1.t38(行号,姓名,班级,住址) values【挖柳斯】(5,"lucy","nsd2107","bj");-- mysql> insert into db1.t38(行号,姓名,班级,住址) values(5,"lucy","nsd2107","bj");Query OK, 1 row affected (0.26 sec)
//不赋值后 用最后1条件记录表头的值+1结果赋值mysql> insert【因涩特】 into【因兔】 db1.t38(姓名,班级,住址) values【挖柳斯】("lucy","nsd2107","bj");-- mysql> insert into db1.t38(姓名,班级,住址) values("lucy","nsd2107","bj");Query OK, 1 row affected (0.03 sec)
//查看记录mysql> select【涩莱克特】 * from【弗乱】 db1.t38 ;-- mysql> select * from db1.t38;+--------+--------+---------+--------+| 行号 | 姓名 | 班级 | 住址 |+--------+--------+---------+--------+| 1 | bob | nsd2107 | bj || 2 | bob | nsd2107 | bj || 3 | tom | nsd2107 | bj || 5 | lucy | nsd2107 | bj || 6 | lucy | nsd2107 | bj |+--------+--------+---------+--------+5 rows in set (0.00 sec)
//删除所有行mysql> delete【迪 利 特】 from【弗乱】 db1.t38 ;-- mysql> delete from db1.t38;
//再添加行 继续行号 而不是从 1 开始mysql> insert【因涩特】 into【因兔】 db1.t38(姓名,班级,住址) values【挖柳斯】("lucy","nsd2107","bj");-- mysql> insert into db1.t38(姓名,班级,住址) values("lucy","nsd2107","bj");
mysql> insert【因涩特】 into【因兔】 db1.t38(姓名,班级,住址) values【挖柳斯】("lucy","nsd2107","bj");-- mysql> insert into db1.t38(姓名,班级,住址) values("lucy","nsd2107","bj");
mysql> insert【因涩特】 into【因兔】 db1.t38(姓名,班级,住址) values【挖柳斯】("lucy","nsd2107","bj");-- mysql> insert into db1.t38(姓名,班级,住址) values("lucy","nsd2107","bj");
//查看记录mysql> select【涩莱克特】 * from【弗乱】 db1.t38;-- mysql> select * from db1.t38;+--------+--------+---------+--------+| 行号 | 姓名 | 班级 | 住址 |+--------+--------+---------+--------+| 8 | lucy | nsd2107 | bj || 9 | lucy | nsd2107 | bj || 10 | lucy | nsd2107 | bj |+--------+--------+---------+--------+3 rows in set (0.01 sec)
-- truncate【创kí特】删除行,会同时重置auto_increment值为1开始//truncate【创kí特】删除行 再添加行 从1开始mysql> truncate【创kí特】 table【忒-部】 db1.t38;-- mysql> truncate table db1.t38;Query OK, 0 rows affected (2.66 sec)
//插入记录mysql> insert【因涩特】 into【因兔】 db1.t38(姓名,班级,住址) values【挖柳斯】("lucy","nsd2107","bj");-- mysql> insert into db1.t38(姓名,班级,住址) values("lucy","nsd2107","bj");Query OK, 1 row affected (0.04 sec)
mysql> insert【因涩特】 into【因兔】 db1.t38(姓名,班级,住址) values【挖柳斯】("lucy","nsd2107","bj");-- mysql> insert into db1.t38(姓名,班级,住址) values("lucy","nsd2107","bj");Query OK, 1 row affected (0.30 sec)
//查看记录mysql> select【涩莱克特】 * from【弗乱】 db1.t38;-- mysql> select * from db1.t38;+--------+--------+---------+--------+| 行号 | 姓名 | 班级 | 住址 |+--------+--------+---------+--------+| 1 | lucy | nsd2107 | bj || 2 | lucy | nsd2107 | bj |+--------+--------+---------+--------+2 rows in set (0.01 sec)mysql>四、外键
当前任务环节
flowchart LR subgraph BottomRow[主键外键索引] direction LR A[主键] --> B[外键] --> C[MySQL索引] end classDef highlight stroke:#f00,stroke-width:2px; class B highlight;外键使用规则:
- 表存储引擎必须是innodb【伊诺 DB】
- 表头数据类型要一致
- 被参照表头必须要是索引类型的一种(primary【普赖莫瑞】 key【kì】)
作用:
- 插入记录时,表头值在另一个表的表头值范围内选择。
4.1 外键的创建、查看、删除、添加
创建外键命令
create【克瑞特】 table【忒-部】 库.表(表头列表 ,foreign【佛润】 key【kì】(表头名) #指定外键references【略粉谁斯】 库.表(表头名) #指定参考的表头名on【昂】 update【阿普 dei 特】 cascade【卡斯kèi】 #同步更新on【昂】 delete【迪 利 特】 cascade【卡斯kèi】 #同步删除)engine【恩-京】=innodb【伊诺 DB】;需求: 仅给公司里已经入职的员工发工资
首先创建存储员工信息的员工表
表名 yg
员工编号 yg_id
姓名 name
#创建员工表create【克瑞特】 table【忒-部】 db1.yg (yg_id int【因特】 primary【普赖莫瑞】 key【kì】 auto_increment【奥特欧_因克瑞门特】,name char【查尔】(16)) engine【恩-京】=innodb【伊诺 DB】;-- mysql> create table db1.yg (-- -> yg_id int primary key auto_increment,-- -> name char(16)-- -> )engine=innodb;创建工资表
表名 gz
员工编号 gz_id
工资 pay
#创建工资表 指定外键表头-- 语句一mysql> create【克瑞特】 table【忒-部】 db1.gz( gz_id int【因特】 primary【普赖莫瑞】 key【kì】 auto_increment【奥特欧_因克瑞门特】, -- 指定主键 pay float【弗洛特】,foreign【佛润】 key【kì】(gz_id) references【略粉谁斯】 db1.yg(yg_id) -- 指定外键值为主键,即yg表的yg_id值为gz表的gz_idon【昂】 update【阿普 dei 特】 cascade【卡斯kèi】 -- 同步更新on【昂】 delete【迪 利 特】 cascade【卡斯kèi】 -- 同步删除)engine【恩-京】=innodb【伊诺 DB】 ; -- 指定存储引擎-- mysql> create table db1.gz(-- -> gz_id int primary key auto_increment,-- -> pay float,-- -> foreign key(gz_id) references db1.yg(yg_id)-- -> on update cascade-- -> on delete cascade-- -> )engine=innodb;
-- 语句二(推荐)mysql> create【克瑞特】 table【忒-部】 db1.gz ( -> gz_id int【因特】 primary【普赖莫瑞】 key【kì】 auto_increment【奥特欧_因克瑞门特】, -- 指定主键 -> pay float【弗洛特】, -> yg_id int【因特】, -> foreign【佛润】 key【kì】(yg_id) references【略粉谁斯】 db1.yg(yg_id) -- 指定外键 -> on【昂】 update【阿普 dei 特】 cascade【卡斯kèi】 -- 同步更新 -> on【昂】 delete【迪 利 特】 cascade【卡斯kèi】-- 同步删除 -> )engine【恩-京】=innodb【伊诺 DB】; -- 指定存储引擎-- mysql> create table db1.gz(-- -> gz_id int primary key auto_increment,-- -> pay float,-- -> yg_id int,-- -> foreign key(yg_id) references db1.yg(yg_id)-- -> on update cascade-- -> on delete cascade-- -> )engine=innodb;查看外键
//查看工资表外键mysql> show【瘦】 create【克瑞特】 table【忒-部】 db1.gz \G-- mysql> show create table db1.gz \G*************************** 1. row *************************** Table: gzCreate Table: CREATE TABLE `gz` ( `gz_id` int NOT NULL AUTO_INCREMENT, `pay` float DEFAULT NULL, `yg_id` int DEFAULT NULL, PRIMARY KEY (`gz_id`), KEY `yg_id` (`yg_id`), CONSTRAINT `gz_ibfk_1` FOREIGN KEY (`yg_id`) REFERENCES `yg` (`yg_id`) ON DELETE CASCADE ON UPDATE CASCADE) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci1 row in set (0.022 sec)删除外键
//删除外键mysql> alter【奥-特】 table【忒-部】 db1.gz drop【卓-普】 FOREIGN【佛润】 KEY【kì】 gz_ibfk_1;-- mysql> alter table db1.gz drop foreign key gz_ibfk_1;
-- 手动命名:在创建外键时,使用 CONSTRAINT关键字后面跟一个自定义的名称,例如 CONSTRAINT fk_student_class。这样做的好处是名称有意义,便于记忆和管理-- CREATE TABLE db1.gz(-- gz_id INT PRIMARY KEY AUTO_INCREMENT,-- pay FLOAT,-- yg_id INT,-- CONSTRAINT fk_gz_yg_id -- 这里添加了显式的外键约束名-- FOREIGN KEY(yg_id) REFERENCES db1.yg(yg_id)-- ON UPDATE CASCADE-- ON DELETE CASCADE-- ) ENGINE=InnoDB;
-- 自动生成:创建外键时没有指定名称(即省略了 CONSTRAINT [symbol]部分),MySQL 会自动生成一个约束名。自动生成的名称通常遵循 表名_ibfk_序号的规则-- 在MySQL中,当创建一个外键时,无论是手动命名还是系统自动生成,数据库都会为这个约束关系分配一个唯一的名称。这个名称就是外键约束的标识符。-- 在MySQL中,外键约束的标识符是以表名和外键列名作为前缀,后跟一个下划线和一个数字作为后缀。
-- 在上面的示例中,外键约束的标识符是 gz_ibfk_1。-- gz:这是您当前表(从表)的名字。-- ibfk:这是 InnoDB 存储引擎为外键(InnoDB Foreign Key)生成的标识符,表示这是一个外键约束。-- 1:这是一个数字,表示这是该表中第一个外键约束,如果表中有多个外键,序号会依次递增(如 gz_ibfk_2, gz_ibfk_3)。
-- 可以使用 SHOW CREATE TABLE 语句来查看外键约束的标识符。
//查看不到外键mysql> show【瘦】 create【克瑞特】 table【忒-部】 db1.gz \G-- mysql> show create table db1.gz \G*************************** 1. row *************************** Table: gzCreate Table: CREATE TABLE `gz` ( `gz_id` int NOT NULL AUTO_INCREMENT, `pay` float DEFAULT NULL, `yg_id` int DEFAULT NULL, PRIMARY KEY (`gz_id`), KEY `yg_id` (`yg_id`)) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci1 row in set (0.00 sec)添加外键
//添加外键mysql> alter【奥-特】 table【忒-部】 db1.gzadd foreign【佛润】 key【kì】(yg_id) references【略粉谁斯】 db1.yg(yg_id)on【昂】 update【阿普 dei 特】 cascade【卡斯kèi】 on【昂】 delete【迪 利 特】 cascade【卡斯kèi】 ;-- mysql> alter table db1.gz-- -> add foreign key(yg_id) references db1.yg(yg_id)-- -> on update cascade on delete cascade;
//查看外键mysql> show【瘦】 create【克瑞特】 table【忒-部】 db1.gz \G-- mysql> show create table db1.gz \G*************************** 1. row *************************** Table: gzCreate Table: CREATE TABLE `gz` ( `gz_id` int NOT NULL AUTO_INCREMENT, `pay` float DEFAULT NULL, `yg_id` int DEFAULT NULL, PRIMARY KEY (`gz_id`), KEY `yg_id` (`yg_id`), CONSTRAINT `gz_ibfk_1` FOREIGN KEY (`yg_id`) REFERENCES `yg` (`yg_id`) ON DELETE CASCADE ON UPDATE CASCADE) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci1 row in set (0.00 sec)4.2 验证外键功能
1)、外键字段的值必须在参考表字段值范围内
-- 员工表插入记录mysql> insert【因涩特】 into【因兔】 db1.yg (name) values【挖柳斯】 ("jerry"),("tom");-- mysql> insert into db1.yg(name) values("jerry"),("tom");-- Query OK, 2 rows affected (0.15 sec)-- Records: 2 Duplicates: 0 Warnings: 0
mysql> select【涩莱克特】 * from【弗乱】 db1.yg;-- mysql> select *from db1.yg;-- +-------+-------+-- | yg_id | name |-- +-------+-------+-- | 1 | jerry |-- | 2 | tom |-- +-------+-------+-- 2 rows in set (0.00 sec)
-- 工资表插入记录mysql> insert【因涩特】 into【因兔】 db1.gz values【挖柳斯】(1,50000);-- mysql> insert into db1.gz values(1,50000,1);-- Query OK, 1 row affected (0.15 sec)
mysql> insert【因涩特】 into【因兔】 db1.gz values【挖柳斯】(2,60000);-- mysql> insert into db1.gz values(2,50000,2);-- Query OK, 1 row affected (0.16 sec)
mysql> select【涩莱克特】 * from【弗乱】 db1.gz;-- mysql> select * from db1.gz;+-------+-------+-------+| gz_id | pay | yg_id |+-------+-------+-------+| 1 | 50000 | 1 || 2 | 50000 | 2 |+-------+-------+-------+2 rows in set (0.00 sec)
-- 没有的3号员工 工资表插入记录报错(因为yg表中没有3号员工数据,需要先插入3号员工数据)mysql> insert【因涩特】 into【因兔】 db1.gz values【挖柳斯】(3,50000);-- mysql> insert into db1.gz values(3,50000,3);ERROR 1452 (23000): Cannot add or update【阿普 dei 特】 a child row: a foreign key【kì】 constraint fails (`db1`.`gz`, CONSTRAINT `gz_ibfk_1` FOREIGN KEY【kì】 (`gz_id`) REFERENCES【略粉谁斯】 `yg` (`yg_id`) ON【昂】 DELETE【迪 利 特】 CASCADE【卡斯kèi】 ON【昂】 UPDATE【阿普 dei 特】 CASCADE【卡斯kèi】)
-- 员工表 插入编号3的员工mysql> insert【因涩特】 into【因兔】 db1.yg (name) values【挖柳斯】 ("Lucy");-- mysql> insert into db1.yg(name) values("Lucy");-- Query OK, 1 row affected (0.14 sec)
mysql> select【涩莱克特】 * from【弗乱】 db1.yg;-- mysql> select * from yg;-- +-------+-------+-- | yg_id | name |-- +-------+-------+-- | 1 | jerry |-- | 2 | tom |-- | 3 | Lucy |-- +-------+-------+-- 3 rows in set (0.00 sec)
-- 可以给3号员工 发工资了mysql> insert【因涩特】 into【因兔】 db1.gz values【挖柳斯】(3,40000,3);-- mysql> insert into db1.gz values(3,40000,3);-- Query OK, 1 row affected (0.12 sec)2)、验证同步更新
-- 查看员工表记录mysql> select【涩莱克特】 * from【弗乱】 db1.yg;-- mysql> select * from db1.yg;+-------+-------+| yg_id | name |+-------+-------+| 1 | jerry || 2 | tom || 3 | lucy |+-------+-------+3 rows in set (0.00 sec)
-- 把yg表里编号是3的改成9mysql> update【阿普 dei 特】 db1.yg set yg_id=9 where【威尔】 yg_id=3;-- mysql> update db1.yg set yg_id=9 where yg_id=3;-- Query OK, 1 row affected (0.17 sec)-- Rows matched: 1 Changed: 1 Warnings: 0
mysql> select【涩莱克特】 * from【弗乱】 db1.yg;-- mysql> select * from db1.yg;+-------+-------+| yg_id | name |+-------+-------+| 1 | jerry || 2 | tom || 9 | Lucy |+-------+-------+3 rows in set (0.00 sec)
-- 工资表里编号是3的自动变成 9mysql> select【涩莱克特】 * from【弗乱】 db1.gz;-- mysql> select * from db1.gz;+-------+-------+-------+| gz_id | pay | yg_id |+-------+-------+-------+| 1 | 50000 | 1 || 2 | 50000 | 2 || 3 | 40000 | 9 |+-------+-------+-------+3 rows in set (0.00 sec)3)、验证同步删除
-- 删除前查看员工表记录mysql> select【涩莱克特】 * from【弗乱】 db1.yg;-- mysql> select * from db1.yg;+-------+-------+| yg_id | name |+-------+-------+| 1 | jerry || 2 | tom || 9 | Lucy |+-------+-------+3 rows in set (0.00 sec)
-- 删除编号2的员工mysql> delete【迪 利 特】 from【弗乱】 db1.yg where【威尔】 yg_id=2;-- mysql> delete from db1.yg where yg_id=2;-- Query OK, 1 row affected (0.19 sec)
-- 删除后查看mysql> select【涩莱克特】 * from【弗乱】 db1.yg;-- mysql> select * from db1.yg;+-------+-------+| yg_id | name |+-------+-------+| 1 | jerry || 9 | Lucy |+-------+-------+2 rows in set (0.00 sec)
-- 查看工资表也没有编号2的工资了mysql> select【涩莱克特】 * from【弗乱】 db1.gz;-- mysql> select * from db1.gz;+-------+-------+-------+| gz_id | pay | yg_id |+-------+-------+-------+| 1 | 50000 | 1 || 3 | 40000 | 9 |+-------+-------+-------+2 rows in set (0.00 sec)4)、外键使用注意事项
-- 被参考的表不能删除mysql> drop【卓-普】 table【忒-部】 db1.yg;-- mysql> drop table db1.yg; --因为db1.yg的yg_id表被db1.gz表的yg_id参考引用为外键,所以不能删除,只能先解除外键或者先删除gz表ERROR 1217 (23000): Cannot delete【迪 利 特】 or update【阿普 dei 特】 a parent row: a foreign key【kì】 constraint failsmysql>
-- 给gz表的gz_id表头 加主键标签-- 保证每个员工只能发1遍工资 且有员工编号的员工才能发工资-- 如果重复发工资和没有编号的发了工资 删除记录后 再添加主键mysql> delete【迪 利 特】 form db1.gz;-- mysql> delete from db1.gz;-- Query OK, 2 rows affected (0.15 sec)
-- 删除主键-- 先查看表头mysql> desc db1.gz;+-------+-------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+-------+-------+------+-----+---------+----------------+| gz_id | int | NO | PRI | NULL | auto_increment || pay | float | YES | | NULL | || yg_id | int | YES | MUL | NULL | |+-------+-------+------+-----+---------+----------------+3 rows in set (0.00 sec)
-- 删除auto_increment(一个列是auto_increment自增长,该列就必须定义为主键,所有要删除该主键必须先删除auto_increment属性)mysql> alter table db1.gz modify gz_id int;Query OK, 0 rows affected (2.83 sec)Records: 0 Duplicates: 0 Warnings: 0
-- 再次查看表头属性(现在自增长属性已删除,可以开始删除主键了)mysql> desc db1.gz;+-------+-------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+-------+-------+------+-----+---------+-------+| gz_id | int | NO | PRI | NULL | || pay | float | YES | | NULL | || yg_id | int | YES | MUL | NULL | |+-------+-------+------+-----+---------+-------+3 rows in set (0.00 sec)
-- 删除主键mysql> alter table db1.gz drop primary key;Query OK, 0 rows affected (2.82 sec)Records: 0 Duplicates: 0 Warnings: 0
-- 查看表头属性(已删除,没有PRI标识)mysql> desc db1.gz;+-------+-------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+-------+-------+------+-----+---------+-------+| gz_id | int | NO | | NULL | || pay | float | YES | | NULL | || yg_id | int | YES | MUL | NULL | |+-------+-------+------+-----+---------+-------+3 rows in set (0.00 sec)
--添加主键mysql> alter【奥-特】 table【忒-部】 db1.gz add primary【普赖莫瑞】 key【kì】(gz_id);-- mysql> alter table db1.gz add primary key(gz_id);Query OK, 0 rows affected (2.21 sec)Records: 0 Duplicates: 0 Warnings: 0
-- 查看表头属性mysql> desc db1.gz;+-------+-------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+-------+-------+------+-----+---------+-------+| gz_id | int | NO | PRI | NULL | || pay | float | YES | | NULL | || yg_id | int | YES | MUL | NULL | |+-------+-------+------+-----+---------+-------+3 rows in set (0.00 sec)
-- 添加auto_increment自增长属性mysql> alter table db1.gz modify gz_id int auto_increment;Query OK, 0 rows affected (2.75 sec)Records: 0 Duplicates: 0 Warnings: 0
-- 查看表头属性mysql> desc db1.gz;+-------+-------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+-------+-------+------+-----+---------+----------------+| gz_id | int | NO | PRI | NULL | auto_increment || pay | float | YES | | NULL | || yg_id | int | YES | MUL | NULL | |+-------+-------+------+-----+---------+----------------+3 rows in set (0.00 sec)
-- 保证每个员工只能发1遍工资 且有员工编号的员工才能发工资mysql> insert【因涩特】 into【因兔】 db1.gz values【挖柳斯】 (1,53000); 报错-- mysql> insert into db1.gz values(1,53000);-- ERROR 1136 (21S01): Column count doesn't match value count at row 1
mysql> insert into db1.gz values(1,53000,9);Query OK, 1 row affected (0.19 sec)
mysql> select * from gz;+-------+-------+-------+| gz_id | pay | yg_id |+-------+-------+-------+| 1 | 53000 | 9 |+-------+-------+-------+Query OK, 1 row affected (0.10 sec)
mysql> insert【因涩特】 into【因兔】 db1.gz values【挖柳斯】 (NULL【nò】,53000,2); 报错-- mysql> insert into db1.gz values(NULL,53000,2); -- 主键值不能为空ERROR 1452 (23000): Cannot add or update a child row: a foreign key constraint fails (`db1`.`gz`, CONSTRAINT `gz_ibfk_1` FOREIGN KEY (`yg_id`) REFERENCES `yg` (`yg_id`) ON DELETE CASCADE ON UPDATE CASCADE)五、MySQL索引
当前任务环节
flowchart LR subgraph BottomRow[主键外键索引] direction LR A[主键] --> B[外键] --> C[MySQL索引] end classDef highlight stroke:#f00,stroke-width:2px; class C highlight;使用规则:
- 一个表中可以有多个index【因戴克斯】
- 任何数据类型的表头都可以设置索引
- 表头值可以重复,也可以赋NULL【nò】值
- 通常在where【威尔】条件中的表头上设置Index【因戴克斯】
- index【因戴克斯】索引标志MUL
主键和唯一索引和普通索引的区别
主键和唯一索引是数据库设计中两个核心但易混淆的概念。下面这个表格能帮你快速把握它们的核心区别。
| 特性维度 | 主键 (PRIMARY KEY) | 外键 (FOREIGN KEY) | 唯一索引 (UNIQUE INDEX) | 普通索引 (INDEX) |
|---|---|---|---|---|
| 本质 | 约束,用于唯一标识每条记录 | 引用约束,用于建立和加强表间的数据关联 | 索引,附带唯一性保证 | 最基本的索引类型,没有唯一性约束 |
| 数量限制 | 一个表只能有一个 | 一个表可以有多个 | 一个表可以有多个 | 一个表可以有多个 |
| 空值处理 | 不允许为 NULL | 允许为 NULL,表示该记录无关联记录 | 允许为 NULL,且可包含多个 NULL | 允许出现重复值和空值 |
| 核心功能 | 唯一标识表中的每一行记录,保证实体完整性 | 维护引用完整性,确保值必须在另一表的主键中存在 | 确保索引列的数据唯一,防止重复 | 加速查询,提高查询效率,不做任何约束 |
| 外键引用 | 可以被其他表的外键引用 | 定义表间关系(如一对多),外键是另一表主键的引用 | 不可以直接作为外键引用目标 | 不可以直接作为外键引用目标 |
| 核心语句 | ALTER TABLE 表名 ADD PRIMARY KEY (字段); | ALTER TABLE 从表 ADD FOREIGN KEY (外键字段) REFERENCES 主表(主键字段); | ALTER TABLE 表名 ADD UNIQUE [索引名] (字段); | ALTER TABLE 表名 ADD INDEX [索引名] (字段); 或 CREATE INDEX 索引名 ON 表名 (字段); |
核心内涵与进阶理解
- 主键:数据存储的基石 “主键还充当聚簇索引”非常关键。在InnoDB存储引擎中,表数据本身就是按主键顺序组织存储的。这使得主键查询极快,但同时也意味着如果主键值是随机的(如UUID),可能导致频繁的页分裂,影响插入性能并产生碎片。因此,使用与业务无关的自增主键往往是性能最佳实践。
- 外键:表间关系的纽带与数据一致性的守护者
外键的本质是一个约束,它通过强制要求子表(从表)中的外键字段值必须存在于主表(被引用表)的主键中,来维护参照完整性。这有效防止了“孤立数据”的产生,例如,确保了不会有一条订单记录指向一个不存在的客户ID。外键关系通常用于实现“一对多”的关联,例如,一个客户(主表)可以拥有多个订单(子表)。
在实现上,定义外键时通常可以指定级联操作(如
ON DELETE CASCADE或ON UPDATE SET NULL),这允许在主表数据变更时自动处理子表中的关联数据,但使用时需谨慎,以免导致非预期的数据修改。 - 唯一索引:业务规则的守护者
它的强大之处在于将业务唯一性要求(如“手机号不可重复”)固化在数据库层,从根源上防止了脏数据的产生。与主键不同,一个表可以有多个唯一索引,为多个业务字段提供唯一性保障。它也可以是复合索引(多列组合),确保几个字段的组合值唯一,例如防止同一用户对同一商品重复评论
(user_id, product_id)。 - 普通索引:纯粹的查询加速器 它唯一的目标就是“快”。其核心价值在于大幅减少磁盘I/O,通过索引数据结构(如B+Tree)快速定位数据,避免全表扫描。创建普通索引时,应考虑字段的“区分度”(选择性),即不重复值的比例。区分度越高,索引筛选效率越好。像“性别”这种区分度很低的字段创建索引意义不大。
创建唯一索引
-- 语法一mysql> alter table db1.customers add unique index email_index(email);Query OK, 0 rows affected (0.01 sec)Records: 0 Duplicates: 0 Warnings: 0
-- 语法二mysql> alter table db1.customers add unique (email);Query OK, 0 rows affected (4.387 sec)Records: 0 Duplicates: 0 Warnings: 0
-- 建表时创建 CREATE TABLE 库.表 ( id INT, 表头名 VARCHAR(255), ..., UNIQUE INDEX 索引名 (表头名) );-- 或 CREATE TABLE 库.表 ( id INT, 表头名 VARCHAR(255) UNIQUE, ...);
-- 为已存在表添加 ALTER TABLE 库.表 ADD UNIQUE INDEX 索引名 (表头名);-- 或 ALTER TABLE 库.表 ADD UNIQUE (表头名);--或 CREATE UNIQUE INDEX 索引名 ON 库.表 (表头名);
-- 删除唯一索引 DROP INDEX 索引名 ON 库.表;-- 或 ALTER TABLE 库.表 DROP INDEX 索引名;
-- 修改唯一索引-- MySQL 不直接支持修改索引。通常需要先删除旧索引,再添加新索引。-- 例如,先 DROP INDEX 旧索引名 ON 库.表;-- 再 CREATE UNIQUE INDEX 新索引名 ON 库.表 (表头名);5.1 索引的创建、查看、删除、添加
1)建表时创建索引命令格式
CREATE【克瑞特】 TABLE【忒-部】 库.表(字段列表 ,INDEX【因戴克斯】(字段名) ,INDEX【因戴克斯】(字段名));Create【克瑞特】 database home;Use home;CREATE【克瑞特】 TABLE【忒-部】 tea4(id char【查尔】(6),name varchar【瓦儿-查儿】(6),age int(3),gender enum【ing纽某】('boy','girl') DEFAULT【迪-佛特】 'boy',INDEX【因戴克斯】(id),INDEX【因戴克斯】(name));-- mysql> create database home;-- Query OK, 1 row affected (0.17 sec)
-- mysql> use home;-- Database changed-- mysql> create table tea4(-- -> id char(6),-- -> name varchar(6),-- -> age int(3),-- -> gender enum('boy','girl') default 'boy',-- -> index(id),index(name));-- 创建名为 `id`和`name` 的普通索引-- Query OK, 0 rows affected, 1 warning (1.70 sec)
-- mysql> desc tea4;-- +--------+--------------------+------+-----+---------+-------+-- | Field | Type | Null | Key | Default | Extra |-- +--------+--------------------+------+-----+---------+-------+-- | id | char(6) | YES | MUL | NULL | |-- | name | varchar(6) | YES | MUL | NULL | |-- | age | int | YES | | NULL | |-- | gender | enum('boy','girl') | YES | | boy | |-- +--------+--------------------+------+-----+---------+-------+-- 4 rows in set (0.00 sec)2)查看索引
des 库.表;mysql> desc home.tea4;+--------+--------------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+--------------------+------+-----+---------+-------+| id | char(6) | YES | MUL | NULL | || name | varchar(6) | YES | MUL | NULL | || age | int(3) | YES | | NULL | || gender | enum('boy','girl') | YES | | boy | |+--------+--------------------+------+-----+---------+-------+4 rows in set (0.00 sec)
mysql> system ls /var/lib/mysql/home/tea4.ibd 保存排队信息的文件/var/lib/mysql/home/tea4.ibdmysql>3)查看索引详细信息
show【瘦】 index【因戴克斯】 from【弗乱】 库.表;-- mysql> show index from home.tea4;+-------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+| Table | Non_unique | Key_name | Seq_in_index | Column_name | Collation | Cardinality | Sub_part | Packed | Null | Index_type | Comment | Index_comment | Visible | Expression |+-------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+| tea4 | 1 | id | 1 | id | A | 0 | NULL | NULL | YES | BTREE | | | YES | NULL || tea4 | 1 | name | 1 | name | A | 0 | NULL | NULL | YES | BTREE | | | YES | NULL |+-------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+2 rows in set (0.00 sec)show【瘦】 index【因戴克斯】 from【弗乱】 home.tea4 \G-- mysql> show index from home.tea4 \G*************************** 1. row *************************** Table: tea4 -- 表名 Non_unique: 1 Key_name: id -- 索引名 (默认索引名和表头名相同,删除索引时,使用的索引名) Seq_in_index: 1 Column_name: id -- 表头名 Collation: A Cardinality: 0 Sub_part: NULL Packed: NULL Null: Index_type: BTREE -- 索引类型 Comment:Index_comment:*************************** 2. row *************************** Table: tea4 -- 表名 Non_unique: 1 Key_name: name -- 索引名 Seq_in_index: 1 Column_name: name -- 表头名 Collation: A Cardinality: 0 Sub_part: NULL Packed: NULL Null: Index_type: BTREE -- 排队算法 Comment:Index_comment:2 rows in set (0.00 sec)mysql>4)删除索引
命令格式 DROP【卓-普】 INDEX【因戴克斯】 索引名 ON【昂】 库.表;mysql> drop【卓-普】 index【因戴克斯】 id on【昂】 home.tea4 ;-- mysql> drop index id on home.tea4;-- Query OK, 0 rows affected (0.48 sec)-- Records: 0 Duplicates: 0 Warnings: 0
mysql> desc home.tea4;-- mysql> desc home.tea4;+--------+--------------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+--------------------+------+-----+---------+-------+| id | char(6) | YES | | NULL | || name | varchar(6) | YES | MUL | NULL | || age | int(3) | YES | | NULL | || gender | enum('boy','girl') | YES | | boy | |+--------+--------------------+------+-----+---------+-------+4 rows in set (0.14 sec)
mysql> show【瘦】 index【因戴克斯】 from【弗乱】 home.tea4 \G-- mysql> show index from home.tea4 \G*************************** 1. row *************************** Table: tea4 Non_unique: 1 Key_name: name Seq_in_index: 1 Column_name: name Collation: A Cardinality: 0 Sub_part: NULL Packed: NULL Null: Index_type: BTREE Comment:Index_comment:1 row in set (0.00 sec)mysql>5)已有表添加索引命令
CREATE【克瑞特】 INDEX【因戴克斯】 索引名 ON【昂】 库.表(字段名);mysql> create【克瑞特】 index【因戴克斯】 nianling on【昂】 home.tea4(age);-- mysql> create index nianling on home.tea4(age); -- 给age创建一个索引,索引命令为"nianling"-- Query OK, 0 rows affected (0.50 sec)-- Records: 0 Duplicates: 0 Warnings: 0
mysql> desc home.tea4;+--------+--------------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+--------+--------------------+------+-----+---------+-------+| id | char(6) | YES | | NULL | || name | varchar(6) | YES | MUL | NULL | || age | int(3) | YES | MUL | NULL | || gender | enum('boy','girl') | YES | | boy | |+--------+--------------------+------+-----+---------+-------+4 rows in set (0.00 sec)
mysql> show【瘦】 create【克瑞特】 table【忒-部】 home.tea4 \G-- mysql> show create table home.tea4 \G*************************** 1. row *************************** Table: tea4Create Table: CREATE TABLE `tea4` ( `id` char(6) DEFAULT NULL, `name` varchar(6) DEFAULT NULL, `age` int DEFAULT NULL, `gender` enum('boy','girl') DEFAULT 'boy', KEY `name` (`name`), KEY `nianling` (`age`)) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci1 row in set (0.00 sec)
mysql> show【瘦】 index【因戴克斯】 from【弗乱】 home.tea4;mysql> show index from home.tea4;+-------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+| Table | Non_unique | Key_name | Seq_in_index | Column_name | Collation | Cardinality | Sub_part | Packed | Null | Index_type | Comment | Index_comment | Visible | Expression |+-------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+| tea4 | 1 | name | 1 | name | A | 0 | NULL | NULL | YES | BTREE | | | YES | NULL || tea4 | 1 | nianling | 1 | age | A | 0 | NULL | NULL | YES | BTREE | | | YES | NULL |+-------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+2 rows in set (0.07 sec)
mysql> show【瘦】 index【因戴克斯】 from【弗乱】 home.tea4 \G-- mysql> show index from home.tea4 \G*************************** 1. row *************************** Table: tea4 Non_unique: 1 Key_name: name Seq_in_index: 1 Column_name: name Collation: A Cardinality: 0 Sub_part: NULL Packed: NULL Null: Index_type: BTREE Comment:Index_comment:*************************** 2. row *************************** Table: tea4 Non_unique: 1 Key_name: nianling -- 设置的索引名 Seq_in_index: 1 Column_name: age -- 表头名 Collation: A Cardinality: 0 Sub_part: NULL Packed: NULL Null: Index_type: BTREE Comment:Index_comment:2 rows in set (0.00 sec)mysql>6)验证索引
mysql> explain【e 斯 波 类】 select【涩莱克特】 * from【弗乱】 moershi.user where【威尔】 name="sshd" \G-- mysql> explain select * from moershi.user where name="sshd" \G*************************** 1. row *************************** id: 1 select_type: SIMPLE table: user -- 表名 partitions: NULL type: refpossible_keys: name key: name -- 使用的索引名 key_len: 21 ref: const rows: 1 -- 查找的总行数 filtered: 100.00 Extra: NULL -- 额外说明1 row in set, 1 warning (0.00 sec)六、作业
1 选择题
- 以下关于主键的描述,正确的是( C ) A. 一个表可以有多个主键 B. 主键的值可以为 NULL C. 主键用于唯一标识表中的每一行记录 D. 主键只能由一个字段组成
主键的核心作用是 唯一标识表中的每一行记录 一个表只能有一个主键(不论是单字段还是多字段联合主键), 且主键值不可重复、不可为NULL 主键可以由多个字段组成(联合主键)- 外键的作用是( B ) A. 保证表中数据的唯一性 B. 建立表与表之间的关联 C. 提高数据的查询速度 D. 对数据进行加密
外键的主要作用是 建立并维护表与表之间的关联关系 从而保证数据的参照完整性,防止产生“孤立数据”。 保证数据唯一性是主键或唯一约束的作用- 以下哪种情况适合创建索引( C ) A. 经常进行更新操作的字段 B. 数据量很小的表 C. 经常作为查询条件的字段 D. 很少使用的字段
为频繁作为查询条件(WHERE子句) 的字段创建索引,可以显著提高查询速度。而经常更新的字段、数据量小的表或很少使用的字段创建索引,可能无法带来性能提升,反而增加维护开销- 在 MySQL 中,创建主键的关键字是( B ) A. PRIMARY B. PRIMARY KEY C. UNIQUE D. FOREIGN KEY
在MySQL中,定义主键的语法关键字是 PRIMARY KEY- 若要删除表中的外键约束,应使用的关键字是( A ) A. DROP FOREIGN KEY B. DELETE FOREIGN KEY C. REMOVE FOREIGN KEY D. ALTER FOREIGN KEY
删除外键约束需要使用 ALTER TABLE 库.表 DROP FOREIGN KEY(表头名);语句,后接具体的外键约束名2 简答题
-
简述主键和唯一索引的区别。 答: 主键: 是一种约束,用于唯一标识每条记录,可以作为外键的引用。一个表只能有一个主键(但可以是复合主键),主键值不可重复、不可为NULL。
唯一索引: 是一种索引,附带唯一性保证,用于确保索引列的数据唯一。一个表可以有多个唯一索引,也可以作为外键的引用(只要它满足唯一性)。唯一索引允许NULL值,并且可以包含多个NULL(但具体取决于数据库系统,如MySQL中唯一索引允许多个NULL)。
-
说明外键约束在数据库设计中的重要性。 答: 外键约束通过强制要求子表(从表)中的外键字段值必须存在于主表(被引用表)的主键中,来维护参照完整性,这有效防止了”孤立数据”的产生。
-
索引在什么情况下会失效?如何避免索引失效? 答: 索引在以下情况下会失效: 索引在以下情况下会失效(针对WHERE条件): 查询条件中使用了函数或表达式,如 WHERE YEAR(date_column) = 2020。 查询条件中使用了通配符(以%开头),如 WHERE name LIKE ‘%John%’。 查询条件中使用了不等于操作符(如 !=或 <>),但如果是覆盖索引可能有效。 数据类型隐式转换(如字符串列与数字比较)。 OR条件连接多个索引列(如果未优化)。
为了避免索引失效,可以采取以下措施: 避免在查询条件中使用函数或表达式,尽量使用索引列原始值。 尽量使用等值查询,避免通配符开头;如果必须用LIKE,尝试用前缀匹配(如 LIKE ‘John%’)。 确保ORDER BY或GROUP BY的列上有索引,以利用索引排序。 使用覆盖索引(索引包含所有查询字段)来优化不等于查询。 避免数据类型转换,确保比较时类型一致。
3 操作题
- 创建一个名为
customers的表,包含customer_id(作为主键)、customer_name、email字段。
mysql> create table db1.customers ( -> customer_id int primary key auto_increment, -> customer_name char(10), -> email varchar(255) -> )engine=innodb;Query OK, 0 rows affected (1.44 sec)- 创建一个
orders表,包含order_id、customer_id(作为外键关联customers表的customer_id)、order_date字段。
mysql> create table db1.orders ( -> order_id int primary key auto_increment, -> customer_id int, -> order_date datetime, -> foreign key (customer_id) references customers(customer_id) -> )engine=innodb;Query OK, 0 rows affected (0.01 sec)- 在
customers表的email字段上创建一个唯一索引。
mysql>mysql> alter table db1.customers add unique (email);Query OK, 0 rows affected (4.387 sec)Records: 0 Duplicates: 0 Warnings: 0- 修改
orders表,添加一个新的外键约束,关联products表(假设products表已存在,有product_id字段)。
-- 添加product_id字段mysql> alter table db1.orders add product_id int;Query OK, 0 rows affected (5.441 sec)Records: 0 Duplicates: 0 Warnings: 0-- 创建product表mysql> create table db1.products( -> product_id int primary key auto_increment -> )engine=innodb;Query OK, 0 rows affected (0.689 sec)-- 添加外键约束mysql> alter table db1.orders -> add foreign key(product_id) references db1.products(product_id) -> on update cascade;Query OK, 0 rows affected (2.100 sec)Records: 0 Duplicates: 0 Warnings: 0-- 查看orders表mysql> show create table db1.orders \G*************************** 1. row *************************** Table: ordersCreate Table: CREATE TABLE `orders` ( `order_id` int NOT NULL AUTO_INCREMENT, `customer_id` int DEFAULT NULL, `order_date` datetime DEFAULT NULL, `product_id` int DEFAULT NULL, PRIMARY KEY (`order_id`), KEY `customer_id` (`customer_id`), KEY `product_id` (`product_id`), CONSTRAINT `orders_ibfk_1` FOREIGN KEY (`customer_id`) REFERENCES `customers` (`customer_id`), CONSTRAINT `orders_ibfk_2` FOREIGN KEY (`product_id`) REFERENCES `products` (`product_id`) ON UPDATE CASCADE) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci1 row in set (0.065 sec)- 删除
customers表上的索引。
-- 查看`customers` 表索引mysql> show index from db1.customers;+-----------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+| Table | Non_unique | Key_name | Seq_in_index | Column_name | Collation | Cardinality | Sub_part | Packed | Null | Index_type | Comment | Index_comment | Visible | Expression |+-----------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+| customers | 0 | PRIMARY | 1 | customer_id | A | 0 | NULL | NULL | | BTREE | | | YES | NULL || customers | 0 | email | 1 | email | A | 0 | NULL | NULL | YES | BTREE | | | YES | NULL |+-----------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+2 rows in set (1.751 sec)-- 删除email唯一索引mysql> alter table db1.customers drop index email;Query OK, 0 rows affected (2.905 sec)Records: 0 Duplicates: 0 Warnings: 0-- 查看`customers` 表索引mysql> show index from db1.customers;+-----------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+| Table | Non_unique | Key_name | Seq_in_index | Column_name | Collation | Cardinality | Sub_part | Packed | Null | Index_type | Comment | Index_comment | Visible | Expression |+-----------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+| customers | 0 | PRIMARY | 1 | customer_id | A | 0 | NULL | NULL | | BTREE | | | YES | NULL |+-----------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+1 row in set (0.256 sec)删除 orders 表上的索引。
-- 查看外键属性mysql> show create table db1.orders \G*************************** 1. row *************************** Table: ordersCreate Table: CREATE TABLE `orders` ( `order_id` int NOT NULL AUTO_INCREMENT, `customer_id` int DEFAULT NULL, `order_date` datetime DEFAULT NULL, `product_id` int DEFAULT NULL, PRIMARY KEY (`order_id`), KEY `customer_id` (`customer_id`), KEY `product_id` (`product_id`), CONSTRAINT `orders_ibfk_1` FOREIGN KEY (`customer_id`) REFERENCES `customers` (`customer_id`), CONSTRAINT `orders_ibfk_2` FOREIGN KEY (`product_id`) REFERENCES `products` (`product_id`) ON UPDATE CASCADE) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci1 row in set (1.279 sec)
-- 删除外键orders_ibfk_1mysql> alter table db1.orders drop foreign key orders_ibfk_1;Query OK, 0 rows affected (1.222 sec)Records: 0 Duplicates: 0 Warnings: 0-- 删除外键orders_ibfk_2mysql> alter table db1.orders drop foreign key orders_ibfk_2;Query OK, 0 rows affected (0.342 sec)Records: 0 Duplicates: 0 Warnings: 0
-- 查看索引名mysql> show index from db1.orders;+--------+------------+-------------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+| Table | Non_unique | Key_name | Seq_in_index | Column_name | Collation | Cardinality | Sub_part | Packed | Null | Index_type | Comment | Index_comment | Visible | Expression |+--------+------------+-------------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+| orders | 0 | PRIMARY | 1 | order_id | A | 0 | NULL | NULL | | BTREE | | | YES | NULL || orders | 1 | product_id | 1 | product_id | A | 0 | NULL | NULL | YES | BTREE | | | YES | NULL || orders | 1 | customer_id | 1 | customer_id | A | 0 | NULL | NULL | YES | BTREE | | | YES | NULL |+--------+------------+-------------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+3 rows in set (1.037 sec)
-- 删除索引 product_idmysql> drop index product_id on db1.orders;Query OK, 0 rows affected (1.191 sec)Records: 0 Duplicates: 0 Warnings: 0-- 删除索引 customer_idmysql> drop index customer_id on db1.orders;Query OK, 0 rows affected (0.326 sec)Records: 0 Duplicates: 0 Warnings: 0
-- 查看索引属性mysql> show index from db1.orders;+--------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+| Table | Non_unique | Key_name | Seq_in_index | Column_name | Collation | Cardinality | Sub_part | Packed | Null | Index_type | Comment | Index_comment | Visible | Expression |+--------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+| orders | 0 | PRIMARY | 1 | order_id | A | 0 | NULL | NULL | | BTREE | | | YES | NULL |+--------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+---------+------------+1 row in set (0.392 sec)07 mysql之数据导入导出与用户管理
今天工作任务路线图
flowchart LR subgraph BottomRow[数据导入导出与用户管理] direction LR A[数据导入导出] --> B[用户管理] end classDef highlight stroke:#f00,stroke-width:2px; class E highlight;一、工作场景
小李是一家电商公司的数据库管理员。最近公司要对业务系统进行升级,需要将旧数据库中的商品信息、订单记录等数据迁移到新数据库,这就需要他运用数据导出与导入功能。小李使用 SELECT【涩莱克特】 ... INTO【因兔】 OUTFILE【奥特-伐尔】 语句把旧数据库的数据导出到文件,再用 LOAD【漏德】 DATA INFILE【因-伐尔】 语句将数据导入新数据库,保证数据完整迁移。
同时,公司业务拓展后新成立了营销和客服部门,需要为这些新员工创建数据库账户。小李使用 CREATE【克瑞特】 USER 语句创建用户,用 grant【古亮普】 语句根据岗位需求赋予不同权限,确保数据的安全性和员工操作的规范性。
二、为什么学呢
学习 MySQL 数据导入导出与用户管理具有很强的现实意义。在数据迁移场景中,当公司更换数据库系统或升级服务器时,掌握数据导入导出技能,能确保数据完整、准确地从旧环境过渡到新环境,避免业务中断。比如电商平台促销活动前后,要灵活调整数据存储。
在数据共享方面,可与合作伙伴安全、高效地交换数据。而用户管理是数据库安全的关键,合理设置用户权限,能防止未经授权的访问和数据泄露,保护公司核心数据。掌握这些技能,可提升数据库管理能力,为企业的稳定运行保驾护航,也增强个人在职场上的竞争力。
三、数据导入导出
当前任务环节
flowchart LR subgraph BottomRow[数据导入导出与用户管理] direction LR A[数据导入导出] --> B[用户管理] end classDef highlight stroke:#f00,stroke-width:2px; class A highlight;secure【瑟Q儿】_file【伐尔】_priv【破略夫】 是 MySQL 中的一个系统变量,主要用于控制数据导入和导出操作的安全性。下面为你详细介绍:
作用
它限定了 MySQL 服务器在执行数据导入(LOAD【漏德】 DATA INFILE【因-伐尔】)和导出(SELECT【涩莱克特】 ... INTO【因兔】 OUTFILE【奥特-伐尔】)操作时,可以访问的文件路径。通过设置该变量,可以防止 MySQL 服务器随意访问系统上的文件,从而增强系统的安全性,避免潜在的文件访问风险。
查看与修改
- 查看:可以使用
SHOW【瘦】 VARIABLES【wèi 利 bóu 斯】 LIKE【赖特】 'secure【瑟Q儿】_file【伐尔】_priv【破略夫】';语句查看当前secure【瑟Q儿】_file【伐尔】_priv【破略夫】的值。 - 修改:要修改该变量的值,需要编辑 MySQL 的配置文件,在其中添加或修改
secure【瑟Q儿】_file【伐尔】_priv【破略夫】参数,然后重启 MySQL 服务器使修改生效。
3.1 修改文件存储路径
修改检索目录为/myload【my漏德】。
检查目录存放导入导出数据时存放数据的文件
[root@mysql50 ~]# mysql -uroot -pNSD123456...amysql> show【瘦】 variables【wèi 利 bóu 斯】 like【赖特】 "%file【伐尔】%"; -- 查看与文件相关的配置项-- mysql> show variables like "%file%";+---------------------------------------+---------------------------------+| Variable_name | Value |+---------------------------------------+---------------------------------+| character_set_filesystem | binary || core_file | OFF || ft_stopword_file | (built-in) || general_log_file | /var/lib/mysql/mysql50.log || init_file | || innodb_buffer_pool_filename | ib_buffer_pool || innodb_buffer_pool_in_core_file | ON || innodb_data_file_path | ibdata1:12M:autoextend || innodb_disable_sort_file_cache | OFF || innodb_doublewrite_files | 2 || innodb_file_per_table | ON || innodb_log_file_size | 50331648 || innodb_log_files_in_group | 2 || innodb_open_files | 4000 || innodb_temp_data_file_path | ibtmp1:12M:autoextend || keep_files_on_create | OFF || large_files_support | ON || local_infile | OFF || lower_case_file_system | OFF || myisam_max_sort_file_size | 9223372036853727232 || open_files_limit | 10000 || performance_schema_max_file_classes | 80 || performance_schema_max_file_handles | 32768 || performance_schema_max_file_instances | -1 || pid_file | /run/mysqld/mysqld.pid || relay_log_info_file | relay-log.info || secure_file_priv | /var/lib/mysql-files/ || slow_query_log_file | /var/lib/mysql/mysql50-slow.log |+---------------------------------------+---------------------------------+28 rows in set (0.00 sec)
-- 查看默认检索目录mysql> show【瘦】 variables【wèi 利 bóu 斯】 like【赖特】 "secure【瑟Q儿】_file【伐尔】_priv【破略夫】";-- mysql> show variables like "secure_file_priv";+------------------+-----------------------+| Variable_name | Value |+------------------+-----------------------+| secure_file_priv | /var/lib/mysql-files/ |+------------------+-----------------------+1 row in set (0.00 sec)mysql> exit【诶西特】
-- 安装MySQL服务软件时自动创建[root@mysql50 ~]# ls -ld /var/lib/mysql-files【伐尔】/-- [root@mha ~]# ls -ld /var/lib/mysql-files/drwxr-x--- 2 mysql mysql 6 Sep 22 2021 /var/lib/mysql-files【伐尔】/
-- 修改主配置文件[root@mysql50 ~]# vim /etc/my.cnf.d/mysql-server.cnf[mysqld]secure【瑟Q儿】_file【伐尔】_priv【破略夫】=/myload【my漏德】 -- 添加此行:wq
-- 创建目录并修改所有者为mysql用户 ,并保证mysql用户对父目录有rx[root@mysql50 ~]# mkdir /myload【my漏德】-- [root@mha ~]# mkdir /myload[root@mysql50 ~]# chown【吃-昂】 mysql /myload【my漏德】-- [root@mha ~]# chown mysql /myload
-- 关闭selinux[root@mysql50 ~]# setenforce【赛特-因佛尔斯】 0-- [root@mha ~]# setenforce 0setenforce: SELinux is disabled
-- 重启服务[root@mysql50 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld-- [root@mha ~]# systemctl restart mysqld
-- 管理员员登陆查看目录[root@mysql50 ~]# mysql -uroot -pNSD123456...amysql> show【瘦】 variables【wèi 利 bóu 斯】 like【赖特】 "secure【瑟Q儿】_file【伐尔】_priv【破略夫】";-- mysql> show variables like "secure_file_priv";+------------------+----------+| Variable_name | Value |+------------------+----------+| secure_file_priv | /myload/ |+------------------+----------+1 row in set (0.01 sec)3.2 导入数据
将/etc/passwd文件导入db1库的user3表里。
命令操作如下所示:
[root@mysql50 ~]# mysql -uroot -pNSD123456...amysql> create【克瑞特】 database【得塔-贝斯】 db1;-- mysql> create database db1;-- Query OK, 1 row affected (0.01 sec)
-- 建表( 根据导入的文件内容 创建表头)mysql> create【克瑞特】 table【忒-部】 db1.user3( name varchar【瓦儿-查儿】(30), password【帕斯沃德】 char【查尔】(1), uid int【因特】 , gid int【因特】 , comment【坑门特】 varchar【瓦儿-查儿】(200), homedir【home-跌儿】 varchar【瓦儿-查儿】(50), shell varchar【瓦儿-查儿】(30));Query OK, 0 rows affected (0.41 sec)-- mysql> create table db1.user3(-- name varchar(30),-- password char(1),-- uid int,-- gid int,-- comment varchar(200),-- homedir varchar(50),-- shell varchar(30));-- Query OK, 0 rows affected (0.06 sec)
-- 查看表头mysql> desc db1.user3;-- mysql> desc db1.user3;+----------+--------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+----------+--------------+------+-----+---------+-------+| name | varchar(30) | YES | | NULL | || password | char(1) | YES | | NULL | || uid | int | YES | | NULL | || gid | int | YES | | NULL | || comment | varchar(200) | YES | | NULL | || homedir | varchar(50) | YES | | NULL | || shell | varchar(30) | YES | | NULL | |+----------+--------------+------+-----+---------+-------+7 rows in set (0.01 sec)
-- 没有数据mysql> select【涩莱克特】 * from【弗乱】 db1.user3;-- mysql> select * from db1.user3;Empty set (0.01 sec)
-- 拷贝文件到检索目录 system【西斯屯】 在MySQL 里执行系统命令mysql> system【西斯屯】 cp /etc/passwd /myload【my漏德】/-- mysql> system cp /etc/passwd /myload-- mysql>
-- mysql> system cp /etc/passwd /myload-- cp: cannot stat '/etc/passwd': No such file or directory -- 提示该报错是因为一、没有权限,需要修改权限,二、没有文件,需要拷贝文件,三、当前登录的mysql账号没有权限,需要修改权限-- 一、修改权限-- mysql> system【西斯屯】 chmod【吃-默德】 777 /myload【my漏德】/-- mysql> system chmod 777 /myload-- 三、修改mysql用户权限-- mysql> grant【格拉特】 all【阿尔】 on /myload【my漏德】/* to【托 敏 内提】 mysql@'%'【托 敏 内提】;-- mysql> grant all on /myload/* to mysql@'%';-- 或者切换有权限用户-- mysql> system whoami --查看当前登录用户-- sf\ta206682
mysql> system【西斯屯】 ls /myload【my漏德】/ -- 查看文件-- mysql> system ls /myloadpasswdmysql>
-- 导入数据mysql> load【漏德】 data infile【因-伐尔】 "/myload【my漏德】/passwd" into【因兔】 table【忒-部】 db1.user3 fields【菲尔兹】 terminated【托 敏 内提】 by【拜】 ":" lines【赖嗯 s】 terminated【托 敏 内提】 by【拜】 "\n" ;-- mysql> load data infile "/myload/passwd" into table db1.user3 fields terminated by ":" lines terminated by "\n";Query OK, 23 rows affected (0.06 sec)Records: 23 Deleted: 0 Skipped: 0 Warnings: 0
-- 查看表记录mysql> select【涩莱克特】 count【kàn特】(*) from【弗乱】 db1.user3;-- mysql> select count(*) from db1.user3;+----------+| count(*) |+----------+| 23 |+----------+1 row in set (0.00 sec)
mysql> select【涩莱克特】 * from【弗乱】 db1.user3;-- mysql> select * from db1.user3;+------------------+----------+-------+-------+-----------------------------+-----------------+----------------+| name | password | uid | gid | comment | homedir | shell |+------------------+----------+-------+-------+-----------------------------+-----------------+----------------+| root | x | 0 | 0 | root | /root | /bin/bash || bin | x | 1 | 1 | bin | /bin | /sbin/nologin || daemon | x | 2 | 2 | daemon | /sbin | /sbin/nologin || adm | x | 3 | 4 | adm | /var/adm | /sbin/nologin || lp | x | 4 | 7 | lp | /var/spool/lpd | /sbin/nologin || sync | x | 5 | 0 | sync | /sbin | /bin/sync || shutdown | x | 6 | 0 | shutdown | /sbin | /sbin/shutdown || halt | x | 7 | 0 | halt | /sbin | /sbin/halt || mail | x | 8 | 12 | mail | /var/spool/mail | /sbin/nologin || operator | x | 11 | 0 | operator | /root | /sbin/nologin || games | x | 12 | 100 | games | /usr/games | /sbin/nologin || ftp | x | 14 | 50 | FTP User | /var/ftp | /sbin/nologin || nobody | x | 65534 | 65534 | Kernel Overflow User | / | /sbin/nologin || dbus | x | 81 | 81 | System message bus | / | /sbin/nologin || systemd-coredump | x | 999 | 997 | systemd Core Dumper | / | /sbin/nologin || systemd-resolve | x | 193 | 193 | systemd Resolver | / | /sbin/nologin || polkitd | x | 998 | 995 | User for polkitd | / | /sbin/nologin || unbound | x | 997 | 994 | Unbound DNS resolver | /etc/unbound | /sbin/nologin || tss | x | 59 | 59 | Account used for TPM access | /dev/null | /sbin/nologin || chrony | x | 996 | 993 | | /var/lib/chrony | /sbin/nologin || sshd | x | 74 | 74 | Privilege-separated SSH | /var/empty/sshd | /sbin/nologin || tcpdump | x | 72 | 72 | | / | /sbin/nologin || mysql | x | 27 | 27 | MySQL Server | /var/lib/mysql | /sbin/nologin |+------------------+----------+-------+-------+-----------------------------+-----------------+----------------+23 rows in set (0.00 sec)mysql>3.3 导出数据
将db1库user3表所有记录导出, 存到/myload【my漏德】/user.txt文件里。
命令操作如下所示:
mysql> select【涩莱克特】 * from【弗乱】 db1.user3 into【因兔】 outfile【奥特-伐尔】 "/myload【my漏德】/user.txt" ;-- mysql> select * from db1.user3 into outfile "/myload/user.txt";Query OK, 23 rows affected (0.00 sec)
mysql> system【西斯屯】 ls /myload【my漏德】/-- mysql> system ls /myload/passwd user.txt
mysql> system【西斯屯】 wc -l /myload【my漏德】/user.txt-- mysql> system wc -l /myload/user.txt23 /myload/user.txt
mysql>mysql> system【西斯屯】 vim /myload【my漏德】/user.txt-- mysql> system vim /myload/user.txtroot x 0 0 root /root /bin/bashbin x 1 1 bin /bin /sbin/nologindaemon x 2 2 daemon /sbin /sbin/nologinadm x 3 4 adm /var/adm /sbin/nologinlp x 4 7 lp /var/spool/lpd /sbin/nologinsync x 5 0 sync /sbin /bin/syncshutdown x 6 0 shutdown /sbin /sbin/shutdownhalt x 7 0 halt /sbin /sbin/haltmail x 8 12 mail /var/spool/mail /sbin/nologinoperator x 11 0 operator /root /sbin/nologingames x 12 100 games /usr/games /sbin/nologinftp x 14 50 FTP User /var/ftp /sbin/nologinnobody x 65534 65534 Kernel Overflow User / /sbin/nologindbus x 81 81 System message bus / /sbin/nologinsystemd-coredump x 999 997 systemd Core Dumper / /sbin/nologinsystemd-resolve x 193 193 systemd Resolver / /sbin/nologinpolkitd x 998 995 User for polkitd / /sbin/nologinunbound x 997 994 Unbound DNS resolver /etc/unbound /sbin/nologintss x 59 59 Account used for TPM access /dev/null /sbin/nologinchrony x 996 993 /var/lib/chrony /sbin/nologinsshd x 74 74 Privilege-separated SSH /var/empty/sshd /sbin/nologintcpdump x 72 72 / /sbin/nologinmysql x 27 27 MySQL Server /var/lib/mysql /sbin/nologin四、用户管理
当前任务环节
flowchart LR subgraph BottomRow[数据导入导出与用户管理] direction LR A[数据导入导出] --> B[用户管理] end classDef highlight stroke:#f00,stroke-width:2px; class B highlight;4.1 问题
- 允许所有主机使用root连接数据库服务,对所有库和所有表有完全权限、密码为123qqq…A
- 允许192.168.90.0/24网段主机使用jam连接数据库服务,仅对gamedb库有完全权限、密码为moershi
- 允许在本机使用jamadmin用户连接数据库服务器,仅对moershi库有查询、插入、更新、删除记录的权限,密码为NSD123456…a
- 允许192.168.90.51主机使用yaya用户连接数据库服务,仅对moershi库有查询权限,密码为moershi1
- 给yaya用户追加,插入记录的权限
- 撤销jam用户删库、删表、删记录的权限
- 删除jamadmin用户
4.2 方案
授权是在数据库服务器里添加用户并设置权限及密码;重复执行grant【古亮普】命令时如果库名和用户名不变时,是追加权限。授权步骤如下:
授权信息保存在mysql库的如下表里:
- user表 保存已有的授权用户及用户对所有库的权限
- db表 保存已有授权用户对某一个库的访问权限
- tables【忒-部s】_priv【破略夫】表 记录已有授权用户对某一张表的访问权限
- columns【科勒姆 s】_priv【破略夫】表 记录已有授权用户对某一个表头的访问权限
在192.168.90.50 数据库服务器练习用户授权
在192.168.90.51 数据库服务器测试
通过模板机克隆一台机器,修改主机名和IP地址
[root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.51/24 autoconnect【奥特欧 坑聂特】 yes#[root@mha ~]# nmcli connection modify ens160 ipv4.addresses 192.168.90.51/24 autoconnect yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160#[root@mha ~]# nmcli connection up ens160[root@mysql51 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql51#[root@mha ~]# hostnamectl set-hostname mysql51安装mysql-server服务软件
[root@mysql51 ~]# yum -y install【因-斯多】 mysql-server【涩·沃】#[root@mysql51 ~]# yum -y install mysql-server
#启动服务[root@mysql51 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld#[root@mysql51 ~]# systemctl start mysqld
#设置开机自启[root@mysql51 ~]# systemctl【西斯屯-ctl】 enable【ing 内 步】 mysqld#[root@mysql51 ~]# systemctl enable mysqld4.3 步骤
实现此案例需要按照如下步骤进行。
步骤一:在192.168.90.50 数据库服务器做如下授权练习
命令操作如下所示:
-- 数据库管理员登陆[root@mysql51 ~]# mysql -uroot -pNSD123456...a1)允许所有主机使用root连接数据库服务,对所有库和所有表有完全权限、密码为123qqq…A
mysql> create【克瑞特】 user root@"%" identified【爱-丹-提伐】 by【拜】 "123qqq...A"; -- 创建用户-- mysql> create user root@"%" identified by "123qqq...A";Query OK, 0 rows affected (0.08 sec)
mysql> grant【古亮普】 all【ò】 on【昂】 *.* to root@"%" ; -- 授予权限-- mysql> grant all on *.* to root@"%";Query OK, 0 rows affected (0.13 sec)在 MySQL 中,使用 GRANT 语句来分配权限。其核心语法结构如下:
GRANT 权限列表 ON 数据库对象 TO '用户名'@'主机名' [IDENTIFIED BY '密码'];| 权限类别 | 具体权限 | 说明 |
|---|---|---|
| 数据定义 (DDL) | CREATE, ALTER, INDEX, REFERENCES | 允许创建、修改、删除表;创建和删除索引;创建外键 。 |
| 数据操作 (DML) | SELECT, INSERT, UPDATE | 允许对数据进行查询、插入和更新 。注意:输出中不包含 DELETE 权限,因此该用户不能删除数据行。 |
| 存储程序与高级对象 | CREATE ROUTINE, ALTER ROUTINE, EXECUTE, EVENT, TRIGGER | 允许创建、修改和执行存储过程和函数;创建和管理事件(定时任务);创建和管理触发器 。 |
| 视图管理 | CREATE VIEW, SHOW VIEW | 允许创建和查看视图的定义 。 |
| 其他操作 | CREATE TEMPORARY TABLES, LOCK TABLES | 允许在操作时创建临时表,并显式锁定表 。 |
| 基本连接 | USAGE | 仅表示该用户账户存在,并允许其连接数据库。默认情况下,此权限不授予任何数据库操作权限 。 |
-
权限列表:指定要授予的具体操作权限。对于记录的增删改查,主要涉及以下四种: -
SELECT:允许查询(检索)数据。 -INSERT:允许插入(添加)新记录。 -UPDATE:允许更新(修改)现有记录。 -DELETE:允许删除记录。 -
数据库对象:定义权限的作用范围,使用
数据库名.表名的格式指定。 -mydb.mytable:授权针对mydb数据库下的mytable表。 -mydb.*:授权针对mydb数据库下的所有表(这是最常用的场景)。 -*.*:授权针对服务器上所有数据库的所有表(通常仅限管理员用户)。 -
用户与主机:指定被授权的用户及其允许连接的主机,格式为
'用户名'@'主机名'。 -'user1'@'localhost':仅允许用户user1从数据库服务器本机连接。 -'user1'@'%':允许用户user1从任何远程主机连接。%在这里是一个通配符。 -
密码设置(可选):在
GRANT语句中直接指定或修改用户的密码。更推荐的做法是先使用CREATE USER语句明确创建用户。
-
授予特定数据库的所有表权限 假设想让用户
report_user可以从任何主机连接,并拥有对数据库samp_db中所有表进行增删改查的权限,可以使用以下命令:sql GRANT SELECT, INSERT, UPDATE, DELETE ON samp_db.* TO 'report_user'@'%'; -
创建用户并授权(完整步骤) 这是一个更清晰、安全的做法,将创建用户和授权分步进行:
sql -- 1. 创建用户 CREATE USER 'dev_user'@'localhost' IDENTIFIED BY 'secure_password'; -- 2. 授予特定权限(例如,对test_db数据库的所有表) GRANT SELECT, INSERT, UPDATE, DELETE ON test_db.* TO 'dev_user'@'localhost'; -- 3. 使权限设置立即生效 FLUSH PRIVILEGES;执行FLUSH PRIVILEGES;命令是为了让服务器重新加载权限表,确保新的权限设置立即生效。 -
查看用户权限 授权完成后,可以验证权限是否已正确分配:
sql SHOW GRANTS FOR 'dev_user'@'localhost'; -
撤销权限 如果需要收回某些权限,可以使用
REVOKE【瑞 - 沃克】语句。例如,撤销dev_user对test_db的删除权限:sql REVOKE【瑞 - 沃克】 DELETE ON test_db.* FROM 'dev_user'@'localhost'; FLUSH PRIVILEGES;
2)允许192.168.90.0/24网段主机使用jam连接数据库服务,仅对gamedb库有完全权限、密码为moershi
mysql> create【克瑞特】 user jam@"192.168.90.0/24" identified【爱-丹-提伐】 by【拜】 "moershi"; -- 创建用户-- mysql> create user jam@"192.168.88.0/24" identified by "moershi";Query OK, 0 rows affected (0.06 sec)
mysql> grant【古亮普】 all【ò】 on【昂】 gamedb.* to jam@"192.168.90.0/24"; -- 授予权限-- mysql> grant all on gamedb.* to jam@"192.168.88.0/24";Query OK, 0 rows affected (0.05 sec)3)允许在本机使用jamadmin用户连接数据库服务器,仅对moershi库有查询、插入、更新、删除记录的权限,密码为NSD123456…a
mysql> create【克瑞特】 user jamadmin@"localhost" identified【爱-丹-提伐】 by【拜】 "NSD123456...a"; -- 创建用户-- mysql> create user jamadmin@"localhost" identified by "NSD123456...a";Query OK, 0 rows affected (0.05 sec)
mysql> grant【古亮普】 select【涩莱克特】 , insert【因涩特】 , update【阿普 dei 特】,delete【迪 利 特】 on【昂】 moershi.* to jamadmin@"localhost"; -- 授予权限-- mysql> grant select,insert,update,delete on moershi.* to jamadmin@"localhost";Query OK, 0 rows affected (0.06 sec)4)允许192.168.90.51主机使用yaya用户连接数据库服务,仅对moershi库有查询权限,密码为moershi1
mysql> create【克瑞特】 user yaya@"192.168.90.51" identified【爱-丹-提伐】 by【拜】 "moershi1" ; -- 创建用户-- mysql> create user yaya@"192.168.88.40" identified by "moershi";Query OK, 0 rows affected (0.10 sec)
mysql> grant【古亮普】 select【涩莱克特】 on【昂】 moershi.* to yaya@"192.168.90.51"; -- 授予权限-- mysql> grant select on moershi.* to yaya@"192.168.88.40";Query OK, 0 rows affected (0.07 sec)5)给yaya用户追加,插入记录的权限
mysql> grant【古亮普】 insert【因涩特】 on【昂】 moershi.* to yaya@"192.168.90.51";-- mysql> grant insert on moershi.* to yaya@"192.168.88.40";Query OK, 0 rows affected (0.05 sec)6)查看添加的用户
-- 添加的用户保存在 mysql库的user表里mysql> select【涩莱克特】 host,user from【弗乱】 mysql.user;-- mysql> select user,host from mysql.user;+-----------------+------------------+| host | user |+-----------------+------------------+| % | root || 192.168.90.0/24 | jam || 192.168.90.51 | yaya || localhost | mysql.infoschema || localhost | mysql.session || localhost | mysql.sys || localhost | jamadmin || localhost | root |+-----------------+------------------+8 rows in set (0.00 sec)
-- 查看已有用户的访问权限mysql> show【瘦】 grants【哥亮特s】 for【fò】 yaya@"192.168.90.51";-- mysql> show grants for yaya@"192.168.88.40";-- +---------------------------------------------------------------+-- | Grants for yaya@192.168.88.40 |-- +---------------------------------------------------------------+-- | GRANT USAGE ON *.* TO 'yaya'@'192.168.88.40' |-- | GRANT SELECT, INSERT ON `moershi`.* TO 'yaya'@'192.168.88.40' |-- +---------------------------------------------------------------+-- 2 rows in set (0.00 sec)
-- 用户对某一个库的访问权限保存在mysql库的db表里mysql> select【涩莱克特】 * from【弗乱】 mysql.db where【威尔】 db="moershi" and user="yaya" \G-- mysql> select * from mysql.db where db="moershi" and user="yaya" \G*************************** 1. row *************************** Host: 192.168.88.40 Db: moershi User: yaya Select_priv: Y Insert_priv: Y Update_priv: N Delete_priv: N Create_priv: N Drop_priv: N Grant_priv: N References_priv: N Index_priv: N Alter_priv: NCreate_tmp_table_priv: N Lock_tables_priv: N Create_view_priv: N Show_view_priv: N Create_routine_priv: N Alter_routine_priv: N Execute_priv: N Event_priv: N Trigger_priv: N1 row in set (0.00 sec)mysql>7)撤销jam用户删库、删表、删记录的权限
-- 先查看jam用户的权限-- mysql> show grants for jam@"192.168.88.0/24";-- +---------------------------------------------------------------+-- | Grants for jam@192.168.88.0/24 |-- +---------------------------------------------------------------+-- | GRANT USAGE ON *.* TO 'jam'@'192.168.88.0/24' |-- | GRANT ALL PRIVILEGES ON `gamedb`.* TO 'jam'@'192.168.88.0/24' |-- +---------------------------------------------------------------+-- 2 rows in set (0.01 sec)-- 撤销权限mysql> revoke【瑞 - 沃克】 delete【迪 利 特】,drop【卓-普】 on【昂】 gamedb.* from【弗乱】 jam@"192.168.90.0/24" ;-- mysql> revoke delete,drop on gamedb.* from jam@"192.168.88.0/24";
-- 查看撤销后jam用户的权限-- mysql> show grants for jam@"192.168.88.0/24";-- +-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+-- | Grants for jam@192.168.88.0/24 |-- +-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+-- | GRANT USAGE ON *.* TO 'jam'@'192.168.88.0/24' |-- | GRANT SELECT, INSERT, UPDATE, CREATE, REFERENCES, INDEX, ALTER, CREATE TEMPORARY TABLES, LOCK TABLES, EXECUTE, CREATE VIEW, SHOW VIEW, CREATE ROUTINE, ALTER ROUTINE, EVENT, TRIGGER ON `gamedb`.* TO 'jam'@'192.168.88.0/24' |-- +-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+-- 2 rows in set (0.00 sec)8)修改yaya用户的登陆密码为123456
mysql> set【赛特】 password【帕斯沃德】 for【fò】 yaya@"192.168.90.51"="123456" ;-- mysql> set password for yaya@"192.168.88.40"="123456";Query OK, 0 rows affected (0.05 sec)9)删除jamadmin用户
mysql> drop【卓-普】 user jamadmin@"localhost" ;-- mysql> drop user jamadmin@"localhost";Query OK, 0 rows affected (0.04 sec)步骤二:在192.168.90.51测试授权
命令格式 mysql -h数据库服务器ip地址 –u用户名 -p密码
1)在mysql51连接mysql50 (使用50 添加的yaya 用户)
[root@mysql51 ~]# mysql -h192.168.90.50 -uyaya -p123456#[root@mysql51 ~]# mysql -h 192.168.88.10 -uyaya -p123456mysql> show【瘦】 grants【哥亮特】; //查看权限-- mysql> show grants;-- +---------------------------------------------------------------+-- | Grants for yaya@192.168.88.40 |-- +---------------------------------------------------------------+-- | GRANT USAGE ON *.* TO 'yaya'@'192.168.88.40' |-- | GRANT SELECT, INSERT ON `moershi`.* TO 'yaya'@'192.168.88.40' |-- +---------------------------------------------------------------+-- 2 rows in set (0.00 sec)
mysql> select【涩莱克特】 user(); -- 查看登陆信息-- mysql> select user();-- +--------------------+-- | user() |-- +--------------------+-- | yaya@192.168.88.40 |-- +--------------------+-- 1 row in set (0.00 sec)
mysql> insert【因涩特】 into【因兔】 moershi.user(name,uid) values【挖柳斯】("jim",11); -- 插入数据权限内可以执行-- mysql> insert into moershi.user(name,uid) values("jim",11);Query OK, 1 row affected (0.06 sec)
mysql> delete【迪 利 特】 from【弗乱】 moershi.salary【晒了瑞】 ; -- 删表超出权限 报错-- mysql> delete from moershi.salary;-- ERROR 1142 (42000): DELETE command denied to user 'yaya'@'192.168.88.40' for table 'salary'五、作业
选择题
-
在 MySQL 里,若要创建一个新用户 ‘test_user’ 并指定其可从任意主机登录,使用的命令是( A ) A. CREATE USER ‘test_user’@’%’ IDENTIFIED BY ‘password’; B. CREATE USER ‘test_user’@‘localhost’ IDENTIFIED BY ‘password’; C. CREATE USER ‘test_user’ IDENTIFIED BY ‘password’; D. ADD USER ‘test_user’@’%’ IDENTIFIED BY ‘password’;
-
下列哪种情况最适合使用
LOAD DATA INFILE进行数据导入?( C ) A. 导入从网页爬取的不规则数据 B. 把 Excel 文件中的数据导入 MySQL C. 从 MySQL 导出的数据文件重新导入数据库 D. 导入图片数据到 MySQL
LOAD DATA INFILE最适合处理格式规整的文本文件MySQL 导出的数据文件(如使用 SELECT ... INTO OUTFILE导出的)格式规整,最适合用此命令重新导入-
想要撤销用户 ‘user1’ 对 ‘db1’ 数据库下 ‘table1’ 表的所有权限,正确的 SQL 语句是( A ) A. REVOKE ALL PRIVILEGES ON db1.table1 FROM ‘user1’@’%’; B. REMOVE ALL PRIVILEGES ON db1.table1 FROM ‘user1’@’%’; C. DELETE ALL PRIVILEGES ON db1.table1 FROM ‘user1’@’%’; D. CANCEL ALL PRIVILEGES ON db1.table1 FROM ‘user1’@’%’;
-
若要查看当前 MySQL 服务器上所有用户,应执行的命令是( B ) A. SHOW USERS; B. SELECT * FROM mysql.user; C. SHOW ALL USERS; D. LIST USERS;
-
执行数据导出时,若使用
SELECT ... INTO OUTFILE语句,对导出文件所在目录的要求是( C ) A. 必须是 MySQL 安装目录 B. 必须是系统临时目录 C. 该目录必须是 MySQL 进程有写入权限的目录 D. 该目录必须是用户主目录
简答题
- 阐述 MySQL 中用户管理的重要性以及主要的管理内容。
在 MySQL 中,实施有效的用户管理是保障数据库安全的核心环节。
- 重要性:如果所有操作都使用拥有最高权限的
root账户,会带来极大的安全隐患。一旦此账户泄露,攻击者可能完全控制数据库。通过用户管理,可以实现权限分离(不同用户只能访问其职责范围内的数据)、安全控制(防止误操作或恶意操作)和审计追踪(记录谁在何时做了什么)。 - 主要管理内容:用户管理主要涉及用户账户的创建、修改、删除以及权限的授予与回收。具体操作包括使用
CREATE USER创建用户(需指定用户名、允许登录的主机及密码),使用DROP USER删除用户(必须同时指定用户名和主机名),以及使用ALTER USER或SET PASSWORD修改用户密码。所有用户信息都存储在mysql系统数据库的user表中。
- 说明
LOAD DATA INFILE和SELECT ... INTO OUTFILE在数据导入导出方面的区别与联系。
LOAD DATA INFILE 和 SELECT ... INTO OUTFILE 是 MySQL 中用于高效数据导入和导出的两个互补命令。
- 功能区别:
SELECT ... INTO OUTFILE主要用于将数据库查询结果导出到服务器主机上的指定格式文件中。而LOAD DATA INFILE则是其逆操作,用于将格式化的数据文件从服务器主机快速导入到数据库表中,执行效率通常远高于逐条INSERT语句。使用LOCAL关键字时,LOAD DATA LOCAL INFILE可以从客户端主机读取文件。 - 语法联系:这两个命令在指定数据格式时使用相似的子句,可以定义字段和行的处理方式,例如
FIELDS TERMINATED BY(字段分隔符)、LINES TERMINATED BY(行终止符)等。这意味着可以方便地使用SELECT ... INTO OUTFILE导出数据后,再用LOAD DATA INFILE按相同格式将其导入。
- 当在数据导入过程中遇到数据格式不匹配的问题,你会采取哪些解决办法?
在使用 LOAD DATA INFILE 导入数据时,如果遇到数据格式不匹配(如字段不对应、分隔符错误等),可以通过以下方式解决:
- 明确指定格式选项:在
LOAD DATA INFILE语句中,通过FIELDS TERMINATED BY、ENCLOSED BY、ESCAPED BY以及LINES TERMINATED BY等子句,确保指定的格式与源文件的实际格式完全匹配。 - 忽略文件标题行:如果数据文件包含标题行,可以使用
IGNORE number LINES子句跳过文件开头指定行数的内容。 - 指定列映射:如果文件中的列顺序与数据库表中的列顺序不一致,可以在
LOAD DATA INFILE语句末尾的(col_name1, col_name2, ...)部分明确指定列的顺序映射。 - 字符集处理:如果文件编码与数据库字符集不匹配,可能产生乱码。可以使用
CHARACTER SET子句指定输入文件的正确字符集。 - 数据转换:
LOAD DATA INFILE支持在导入时通过SET子句对数据进行简单转换或计算,例如SET id=id+5。
- 描述如何对 MySQL 用户权限进行精细管理,以保障数据库安全。
为保障数据库安全,对用户权限进行精细化管理至关重要,核心原则是最小权限原则,即只授予用户完成其工作所必需的最小权限。
- 权限层级:MySQL 的权限可以在不同层级进行设置,包括全局层级(所有数据库,如
*.*)、数据库层级(指定数据库的所有对象,如mydb.*)、表层级(特定表)、列层级(表的特定列)甚至存储过程层级。例如,可以只授予某个用户对员工表的姓名和部门列有SELECT权限,而无权查看薪资列。 - 使用角色:可以创建角色,将一组常用的权限授予角色,然后再将角色授予用户,这极大地简化了权限管理。
- 授权与回收:使用
GRANT语句授予权限,使用REVOKE语句回收权限。授权后通常需要执行FLUSH PRIVILEGES;命令使新权限立即生效(在某些情况下 MySQL 会自动刷新)。 - 网络限制:创建用户时,应通过
'用户名'@'主机名'的格式限制用户只能从特定的 IP 地址或网段登录数据库,例如'app_user'@'192.168.1.%'。 - 定期审计:定期检查用户权限,及时回收不必要的权限。可以使用
SHOW GRANTS FOR 'username'@'hostname';命令查看特定用户的权限。
- 简述在数据导出时,设置不同字段和行分隔符的作用及方法。
在数据导出时,通过 SELECT ... INTO OUTFILE 语句设置字段和行分隔符,主要是为了控制导出文件的格式,使其易于被其他程序(如 Excel、其他数据库系统或自定义脚本)正确解析和读取。
- 作用:
- 字段分隔符:定义了文件中每个字段(列)之间的分隔符号,默认为制表符
\t。常用符号有逗号 (,) 用于生成 CSV 文件。 - 行分隔符:定义了文件中每条记录(行)之间的分隔符号,默认为换行符
\n。在不同操作系统中可能有所不同,例如在 Windows 系统中可能需要设置为\r\n。
- 字段分隔符:定义了文件中每个字段(列)之间的分隔符号,默认为制表符
- 设置方法:在
SELECT ... INTO OUTFILE语句中使用FIELDS和LINES子句进行定义。通过合理设置这些分隔符和包围字符,可以确保导出的数据格式规整,避免因数据本身包含分隔符而导致解析错误。SELECT * FROM your_tableINTO OUTFILE '/path/to/export/file.csv'FIELDS TERMINATED BY ',' OPTIONALLY ENCLOSED BY '"' -- 字段由逗号分隔,并用双引号包围LINES TERMINATED BY '\n'; -- 行以换行符结束
操作题
- 创建一个名为 ‘new_db’ 的数据库,接着创建用户 ‘admin_user’ 并赋予其对 ‘new_db’ 数据库的所有权限,然后创建用户 ‘guest_user’ 仅赋予对 ‘new_db’ 中 ‘table1’ 表的查询权限。
实战案例:MySQL 用户权限管理
这是一个完整的MySQL用户权限管理实战示例,展示如何创建数据库、用户,并分配不同级别的权限。
-- 数据库创建mysql> create【克瑞特】 database【得塔-贝斯】 new_db【牛-滴比】;-- mysql> create database new_db;Query OK, 1 row affected (6.379 sec)
-- admin_user 用户创建mysql> create【克瑞特】 user【右瑟】 admin_user【admin-右瑟】@"%" identified【爱-丹-提伐】 by【拜】 "admin_user";-- mysql> create user admin_user@"%" identified by "admin_user";Query OK, 0 rows affected (7.111 sec)
-- admin_user 用户赋予权限mysql> grant【古亮普】 all【ò】 on【昂】 new_db【牛-滴比】.* to admin_user【admin-右瑟】@"%";-- mysql> grant all on new_db.* to admin_user@"%";Query OK, 0 rows affected (0.680 sec)
-- guest_user 用户创建mysql> create【克瑞特】 user【右瑟】 guest_user【盖斯特-右瑟】@"%" identified【爱-丹-提伐】 by【拜】 "guest_user【盖斯特-右瑟】";-- mysql> create user guest_user@"%" identified by "guest_user";Query OK, 0 rows affected (0.224 sec)
-- 创建new_db.table1mysql> create【克瑞特】 table【忒-部】 new_db【牛-滴比】.table1【忒-部-万】(id int【因特】);-- mysql> create table new_db.table1(id int);Query OK, 0 rows affected (2.602 sec)
-- guest_user 用户赋予权限mysql> grant【古亮普】 select【涩莱克特】 on【昂】 new_db【牛-滴比】.table1【忒-部-万】 to guest_user【盖斯特-右瑟】@"%";-- mysql> grant select on new_db.table1 to guest_user@"%";Query OK, 0 rows affected (0.295 sec)权限验证
检查创建的用户和权限:
-- 查看用户列表mysql> select【涩莱克特】 user【右瑟】, host【厚斯特】 from【弗乱】 mysql.user【右瑟】 where【威尔】 user【右瑟】 like【赖特】 '%admin%' or user【右瑟】 like【赖特】 '%guest%';-- mysql> select user, host from mysql.user where user like '%admin%' or user like '%guest%';+-------------+------+| user | host |+-------------+------+| admin_user | % || guest_user | % |+-------------+------+2 rows in set (0.00 sec)
-- 查看 admin_user 权限mysql> show【瘦】 grants【古亮普 s】 for【fó】 admin_user【admin-右瑟】@"%";-- mysql> show grants for admin_user@"%";+-------------------------------------------------------------+| Grants for admin_user@% |+-------------------------------------------------------------+| GRANT USAGE ON *.* TO 'admin_user'@'%' || GRANT ALL PRIVILEGES ON `new_db`.* TO 'admin_user'@'%' |+-------------------------------------------------------------+
-- 查看 guest_user 权限mysql> show【瘦】 grants【古亮普 s】 for【fó】 guest_user【盖斯特-右瑟】@"%";-- mysql> show grants for guest_user@"%";+-------------------------------------------------------------+| Grants for guest_user@% |+-------------------------------------------------------------+| GRANT USAGE ON *.* TO 'guest_user'@'%' || GRANT SELECT ON `new_db`.`table1` TO 'guest_user'@'%' |+-------------------------------------------------------------+功能说明:
- admin_user:拥有对
new_db数据库的完全权限(包括创建表、插入、更新、删除等所有操作) - guest_user:仅拥有对
new_db.table1表的查询权限(只能查看数据,不能修改) - 权限级别:展示了从数据库级别到表级别的权限控制
- 安全实践:体现了最小权限原则,只为用户分配完成工作所需的最小权限
mysql> — guest_user 用户创建 mysql> create user guest_user@”%” identified by “guest_user”; Query OK, 0 rows affected (0.224 sec)
mysql> — 创建new_db.table1 mysql> create table new_db.table1(id int); Query OK, 0 rows affected (2.602 sec)
mysql> — guest_user 用户赋予查询权限 mysql> grant select on new_db.table1 to guest_user@”%”; Query OK, 0 rows affected (0.295 sec)
2. 从 'employees' 表中导出员工的每一列信息到一个 TXT 文件,要求使用逗号作为字段分隔符,换行符作为行分隔符。之后将这个 TXT 文件中的数据导入到新创建的 'employees_backup' 表。```sqlmysql>-- 导出moershi.employeesmysql> select * from moershi.employees into outfile "/myload/employees.txt" fields terminated by "," lines terminated by "\n";Query OK, 136 rows affected (0.200 sec)
mysql>-- 创建new_db.employees_backupmysql> create table new_db.employees_backup like moershi.employees;Query OK, 0 rows affected (3.269 sec)
mysql> -- 导入mysql> load data infile "/myload/employees.txt" into table new_db.employees_backup fields terminated by "," lines terminated by "\n";Query OK, 136 rows affected (1.059 sec)Records: 136 Deleted: 0 Skipped: 0 Warnings: 0
mysql> select count(*) from new_db.employees_backup;+----------+| count(*) |+----------+| 136 |+----------+1 row in set (0.351 sec)- 对用户 ‘editor_user’ 的权限进行调整,撤销其对 ‘news’ 数据库下 ‘articles’ 表的删除权限,同时增加更新权限。
mysql> --创建数据库mysql> create database news;Query OK, 1 row affected (0.664 sec)
mysql>-- 创建表mysql> create table news.articles(id int,name varchar(9));Query OK, 0 rows affected (2.513 sec)
mysql>-- 创建用户mysql> create user editor_user@"%" identified by "editor_user";Query OK, 0 rows affected (1.115 sec)
mysql>-- 赋予权限mysql> grant all on news.articles to editor_user@"%";Query OK, 0 rows affected (0.571 sec)
mysql>-- 撤销权限mysql> revoke delete on news.articles from editor_user@"%";Query OK, 0 rows affected (0.438 sec)
mysql>-- 增加权限mysql> grant update on news.articles to editor_user@"%";Query OK, 0 rows affected (0.469 sec)- 先创建一个新用户 ‘temp_user’,仅赋予其对 ‘test_db’ 数据库下 ‘logs’ 表的插入权限,在完成数据插入任务后,删除该用户。
mysql> --创建数据库mysql> create database test_db;Query OK, 1 row affected (0.648 sec)
mysql> -- 创建表mysql> create table test_db.logs( -> id int, -> logs varchar(200));Query OK, 0 rows affected (1.589 sec)
mysql> 创建用户mysql> create user temp_user@"%" identified by "temp_user";Query OK, 0 rows affected (0.760 sec)
mysql> --赋予权限mysql> grant insert on test_db.logs to temp_user@"%";Query OK, 0 rows affected (0.676 sec)
mysql> --插入数据mysql> insert into test_db.logs values(1,"程序卡死");Query OK, 1 row affected (0.291 sec)
mysql> --删除用户mysql> drop user temp_user@"%";Query OK, 0 rows affected (0.693 sec)08:mysql之备份与恢复
今日工作任务路线图
flowchart LR subgraph BottomRow[mysql之备份与恢复] direction LR A[mysqldump<br/>备份与恢复] --> B[增量备份<br/>与恢复] --> C[差分备份<br/>与恢复] end classDef highlight stroke:#f00,stroke-width:2px; class E highlight;一、工作场景
在一家电商公司的运营过程中,数据库管理员小张日常负责 MySQL 数据库的维护。某天,开发团队要对数据库进行大规模的架构升级,为防止升级过程中出现数据丢失或损坏,小张决定对 MySQL 数据库进行备份。他使用 mysqldump【mysql-当普】 工具,将数据库中的数据和结构导出到一个 SQL 文件中,并把文件存储在多个安全的存储位置。然而,升级过程中出现了意外,数据库中的部分数据丢失。小张迅速行动,利用之前备份的 SQL 文件,使用 mysql 命令将数据恢复到升级前的状态,确保了公司业务的正常运行。
二、为什么学
学习 MySQL 备份与恢复意义重大。在实际工作里,数据是企业的核心资产,一旦数据库因系统故障、人为误操作、硬件损坏、黑客攻击等原因出现数据丢失或损坏,将给企业带来巨大损失。掌握 MySQL 备份与恢复技术,能在数据丢失时及时恢复,保障业务连续性。同时,在对数据库进行升级、迁移或维护时,提前备份可防止数据意外丢失。此外,学习此技术也是数据库管理员、运维工程师等相关岗位的基本要求,有助于提升个人职业技能,增强在职场上的竞争力。
三、mysqldump【mysql-当普】备份与恢复
当前任务环节
flowchart LR subgraph BottomRow[mysql之备份与恢复] direction LR A[mysqldump<br/>备份与恢复] --> B[增量备份<br/>与恢复] --> C[差分备份<br/>与恢复] end classDef highlight stroke:#f00,stroke-width:2px; class A highlight;热备份,备份和恢复数据库服务必须是运行的
3.1 备份数据
mysqldump【mysql-当普】 主要是把数据导出成一个sql脚本 可以针对某一个表或多个表 也可以针对某一个或多个库
| 参数 | 命令示例 | 备份范围 | 适用场景 |
|---|---|---|---|
| 无参数 | mysqldump 库名 表名 | 单个数据库的表的内容 | 日常单个数据表备份 |
| 无参数 | mysqldump 库名 表名 表名... | 数据库的多个表的内容 | 日常多个数据表备份 |
| 无参数 | mysqldump 库名 | 单个数据库的内容 | 日常单个数据库备份 |
-B | mysqldump -B 库名 | 单个数据库的完整结构+内容 | 数据库迁移 |
-B | mysqldump -B 库名 库名... | 多个数据库的完整结构+内容 | 数据库迁移 |
-A | mysqldump -A | 所有数据库的完整结构+内容 | 全服务器备份、灾难恢复 |
#备份1张表[root@mysql50 ~]# mysqldump【mysql-当普】 -uroot -pNSD123456...a moershi salary【晒了瑞】 > /bakdir/moershi_salary【晒了瑞】.sql#[root@mha ~]# mysqldump -uroot -p123 moershi salary > /root/moershi_salary.sql#mysqldump【mysql-当普】: [Warning] Using a password on the command line interface can be insecure.
#备份多张表[root@mysql50 ~]# mysqldump【mysql-当普】 -uroot -pNSD123456...a moershi employees【ing普洛伊s】 departments【迪帕踢门特】 > /bakdir/moershi_employees【ing普洛伊s】_deparments.sql#[root@mha ~]# mysqldump -uroot -p123 moershi employees departments > /root/moershi_employees_deparments.sql#mysqldump【mysql-当普】: [Warning] Using a password on the command line interface can be insecure.
#备份1个库[root@mysql50 ~]# mysqldump【mysql-当普】 -uroot -pNSD123456...a -B moershi > /bakdir/moershi.sql#[root@mha ~]# mysqldump -uroot -p123 -B moershi > /root/moershi.sql#mysqldump【mysql-当普】: [Warning] Using a password on the command line interface can be insecure.
#备份多个库[root@mysql50 ~]# mysqldump【mysql-当普】 -uroot -pNSD123456...a -B studb db1 > /bakdir/studb_db1.sql#[root@mha ~]# mysqldump -uroot -p123 -B studb db1 > /root/studb_db1.sql#mysqldump【mysql-当普】: [Warning] Using a password on the command line interface can be insecure.
#备份所有库[root@mysql50 ~]# mysqldump【mysql-当普】 -uroot -pNSD123456...a -A > /bakdir/allbak.sql#[root@mha ~]# mysqldump -uroot -p123 -A > /root/allbak.sql#mysqldump【mysql-当普】: [Warning] Using a password on the command line interface can be insecure.3.2 恢复数据
分析:
特点: mysqldump【mysql-当普】 备份和恢复数据时会锁表,锁表期间无法对表做写访问 mysqldump【mysql-当普】适合备份数据量比较小的数据或在数据库服务器访问量少的时候备份。
[root@mysql50 ~]# mysql -uroot -pNSD123456...a-- [root@mha ~]# mysql -uroot -p123-- 删除库mysql> drop【卓-普】 database【得塔-贝斯】 moershi;-- mysql> drop database moershi;-- Query OK, 6 rows affected (0.57 sec)mysql> exit【诶西特】Bye
-- 恢复数据[root@mysql50 ~]# mysql -uroot -pNSD123456...a < /bakdir/moershi.sql-- [root@mha ~]# mysql -uroot -p123 < /root/moershi.sql-- mysql: [Warning] Using a password on the command line interface can be insecure.
-- 登陆[root@mysql50 ~]# mysql -uroot -pNSD123456...a-- [root@mha ~]# mysql -uroot -p123
-- 进库mysql> use moershi;-- mysql> use moershi;
-- 看表mysql> show【瘦】 tables【忒-部s】;-- mysql> show tables;+------------------+| Tables_in_moershi |+------------------+| departments || employees || salary || stu4 || user || wage_grade |+------------------+6 rows in set (0.00 sec)
-- 删除表记录mysql> delete【迪利特】 from【弗乱】 salary【晒了瑞】;Query OK, 8055 rows affected (0.11 sec)mysql> exit【诶西特】Bye
-- 使用备份文件恢复数据[root@mysql50 ~]# mysql -uroot -pNSD123456...a moershi < /bakdir/moershi_salary【晒了瑞】.sql-- mysql: [Warning] Using a password on the command line interface can be insecure.
-- 登陆服务[root@mysql50 ~]# mysql -uroot -pNSD123456...a-- [root@mha ~]# mysql -uroot -p123
-- 查看行数mysql> select【涩莱克特】 count【kàn特】(*) from【弗乱】 moershi.salary【晒了瑞】;-- mysql> select count(*) from moershi.salary;+----------+| count(*) |+----------+| 8055 |+----------+1 row in set (0.00 sec)四、增量备份与恢复
当前任务环节
flowchart LR subgraph BottomRow[mysql之备份与恢复] direction LR A[mysqldump<br/>备份与恢复] --> B[增量备份<br/>与恢复] --> C[差分备份<br/>与恢复] end classDef highlight stroke:#f00,stroke-width:2px; class B highlight;4.1 准备2台数据库服务器
| 主机名 | IP地址 | 说明 |
|---|---|---|
| mysql50 | 192.168.90.50 | 用于备份数据库 |
| mysql51 | 192.168.90.51 | 用于恢复数据库 |
mysql51机器的IP配置和主机名
[root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.51/24 autoconnect【奥特欧 坑聂特】 yes#[root@mha ~]# nmcli connection modify eth0 ipv4.addresses 192.168.88.40/24 autoconnect yes
[root@localhost ~]# nmcli connection【肯耐申】 up【啊普】 ens160#[root@mha ~]# nmcli connection up eth1
[root@mysql51 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql51#[root@mha ~]# hostnamectl set-hostname mha增量备份和差异备份优缺点
增量备份
-
定义:增量备份只备份自上一次备份(无论是完全备份、增量备份还是差异备份)以来发生变化的数据。
-
工作原理:首先需要一个完整的备份(基础备份),然后每次增量备份都只备份相对于上一次备份后变化的数据。
-
优点:备份速度快,占用空间小,因为每次只备份变化的数据。
-
缺点:恢复数据时,需要先恢复完整备份,然后按照时间顺序依次恢复所有的增量备份,直到指定的时间点。恢复过程复杂且耗时,如果中间任何一个备份损坏,可能导致整个恢复链失效。
-
适用场景:数据量大,备份窗口短,但对恢复时间要求不高的场景。
当前的备份是基于上一次备份做增量的备份 一般第一次备份要完全备份 第一次:全量—>增加了a 第二次: 备份a--->增加了b 第三次: 备份b--->增加了c 第四次: 备份c--->增加了d
增量备份做数据恢复 全量<---备份a 全量<---备份b 全量<---备份c 最终 全量(abc)
差异备份
-
定义:差异备份备份自上一次完整备份以来所有发生变化的数据。
-
工作原理:首先需要一个完整备份,然后每次差异备份都会备份自上次完整备份以来所有变化的数据。因此,第二次差异备份会包含第一次差异备份的内容,第三次会包含第一次和第二次的内容,以此类推。
-
优点:恢复时只需要完整备份和最近一次的差异备份,恢复过程相对简单。
-
缺点:随着时间推移,差异备份的大小会越来越大,因为每次都要备份自完整备份以来的所有变化。备份时间可能会逐渐增加。
-
适用场景:数据量变化不大,且希望恢复过程相对简单的场景。
当前的备份是基于第一次备份做增量的备份 一般第一次备份要完全备份 第一次:全量—>增加了a 第二次: 备份a--->增加了b 第三次: 备份ab--->增加了c 第四次: 备份abc--->增加了d 全量<—备份abc 最终 全量(abc)
对比总结:
- 备份内容:增量备份只备份上一次备份后的变化,而差异备份备份自上次完整备份后的所有变化。
- 备份空间和速度:增量备份占用空间小,速度快;差异备份随着时间推移,占用空间和备份时间都会增加。
- 恢复过程:增量恢复需要完整备份和所有增量备份,步骤多,易出错;差异恢复只需要完整备份和最近一次差异备份,相对简单。
PERCONA【帕扣娜】 xtrabackup【xtra-拜克阿普】是一款强大的在线热备份工具,备份过程中不锁库表,适合生产环境。支持完全备份与恢复、增量备份与恢复、差异备份与恢复。
在192.168.90.50主机完成备份与恢复的练习 。
4.2 数据增量备份
安装软件(在mysql50 、MySQL51 两台主机都要安装)
#一、使用YUM下载方式,下载RPM包:[root@mysql50 ~]# yum -y install【因-斯多】 https://repo.percona.com/yum/percona-release-latest.noarch.rpm#[root@mha ~]# yum -y install https://repo.percona.com/yum/percona-release-latest.noarch.rpm
#二、启用percona【帕扣娜】库:[root@mysql50 ~]# percona【帕扣娜】-release【率利斯】 enable【ing 内 步】-only【欧利】 tools【兔斯】 release【率利斯】#[root@mha ~]# percona-release enable-only tools release
#三、依赖包下载[root@mysql50 ~]# yum -y install【因-斯多】 lz4 zstd#[root@mha ~]# yum -y install lz4 zstd
#四、安装percona【帕扣娜】-xtrabackup【xtra-拜克阿普】[root@mysql50 ~]# yum -y install【因-斯多】 percona【帕扣娜】-xtrabackup【xtra-拜克阿普】-80#[root@mha ~]# yum -y install percona-xtrabackup-80增量备份(在mysql50主机 完成增量备份练习)
—host:备份的主机IP
—user: 数据库的用户
—password【帕斯沃德】: 数据库的密码
—backup【拜克阿普】:启动备份过程,是最基本的备份启动选项
—target【塔géi特】-dir【迪尔】: 指定备份文件的存储目录
—datadir【得塔-迪尔】: 数据库文件目录
—incremental【因葵孟透】-basedir【贝斯迪尔】:指定增量备份的基础目录,即上一次备份的目录
周一完全备份(备份所有数据)
对数据做增量备份前,必须先有一次备份,也就是首次备份,通常是备份所有数据;比如每周周一完全备份,周二到周日增量备份。
#全量备份[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/fullbak【fò-拜克】 --datadir【得塔-迪尔】=/var/lib/mysql#[root@mha ~]# xtrabackup --host=127.0.0.1 --user=root --password=123 --backup --target-dir=/fullbak --datadir=/var/lib/mysql……230530 18:18:48 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24822878) to (24822898) was copied.230530 18:18:50 completed OK!
#插入新数据 (可以插入多行)mysql> insert【因涩特】 into【因兔】 moershi.salary【晒了瑞】(date,employee_id,basic【贝斯克】,bonus【波诺斯】) values【挖柳斯】("20250610",18,25000,8000);#mysql> insert into moershi.salary(date,employee_id,basic,bonus) values("20250610",18,25000,8000);#Query OK, 1 row affected (0.05 sec)周二增量备份(备份周一备份后新产生的数据)
[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/new2 --incremental【因葵孟透】-basedir【贝斯迪尔】=/fullbak【fò-拜克】 --datadir【得塔-迪尔】=/var/lib/mysql#[root@mha ~]# xtrabackup --host=127.0.0.1 --user=root --password=123 --backup --target-dir=/new2 --incremental-basedir=/fullbak --datadir=/var/lib/mysql…………230530 18:33:52 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24827173) to (24827183) was copied.230530 18:33:53 completed OK!
#插入新数据 (可以插入多行)mysql> insert【因涩特】 into【因兔】 moershi.salary【晒了瑞】(date,employee_id,basic【贝斯克】,bonus【波诺斯】) values【挖柳斯】("20250710",18,25000,8000);#mysql> insert into moershi.salary(date,employee_id,basic,bonus) values("20250710",18,25000,8000);#Query OK, 1 row affected (0.11 sec)周三增量备份(备份周二备份后新产生的数据)
[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/new3 --incremental【因葵孟透】-basedir【贝斯迪尔】=/new2 --datadir【得塔-迪尔】=/var/lib/mysql#[root@mha ~]# xtrabackup --host=127.0.0.1 --user=root --password=123 --backup --target-dir=/new3 --incremental-basedir=/fullbak --datadir=/var/lib/mysql…………230530 18:46:17 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24832526) to (24832536) was copied.230530 18:46:18 completed OK!
#插入新数据 (可以插入多行)mysql> insert【因涩特】 into【因兔】 moershi.salary【晒了瑞】(date,employee_id,basic【贝斯克】,bonus【波诺斯】) values【挖柳斯】("20250710",18,25000,8000);#mysql> insert into moershi.salary(date,employee_id,basic,bonus) values("20250710",18,25000,8000);#Query OK, 1 row affected (0.08 sec)周四增量备份(备份周三备份后新产生的数据)
[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/new4 --incremental【因葵孟透】-basedir【贝斯迪尔】=/new3 --datadir【得塔-迪尔】=/var/lib/mysql#[root@mha ~]# xtrabackup --host=127.0.0.1 --user=root --password=123 --backup --target-dir=/new4 --incremental-basedir=/fullbak --datadir=/var/lib/mysql…………230530 18:53:41 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24837561) to (24837571) was copied.230530 18:53:42 completed OK!
#插入新数据 (可以插入多行)mysql> insert【因涩特】 into【因兔】 moershi.salary【晒了瑞】(date,employee_id,basic【贝斯克】,bonus【波诺斯】) values【挖柳斯】("20250710",18,25000,8000);#mysql> insert into moershi.salary(date,employee_id,basic,bonus) values("20250710",18,25000,8000);#Query OK, 1 row affected (0.05 sec)周五增量备份(备份周四备份后新产生的数据)
[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/new5 --incremental【因葵孟透】-basedir【贝斯迪尔】=/new4 --datadir【得塔-迪尔】=/var/lib/mysql#[root@mha ~]# xtrabackup --host=127.0.0.1 --user=root --password=123 --backup --target-dir=/new5 --incremental-basedir=/fullbak --datadir=/var/lib/mysql…………230530 18:58:50 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24841645) to (24841655) was copied.230530 18:58:51 completed OK!
#插入新数据 (可以插入多行)mysql> insert【因涩特】 into【因兔】 moershi.salary【晒了瑞】(date,employee_id,basic【贝斯克】,bonus【波诺斯】) values【挖柳斯】("20250710",18,25000,8000);#mysql> insert into moershi.salary(date,employee_id,basic,bonus) values("20250710",18,25000,8000);#Query OK, 1 row affected (0.04 sec)周六增量备份(备份周五备份后新产生的数据)
[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/new6 --incremental【因葵孟透】-basedir【贝斯迪尔】=/new5 --datadir【得塔-迪尔】=/var/lib/mysql#[root@mha ~]# xtrabackup --host=127.0.0.1 --user=root --password=123 --backup --target-dir=/new6 --incremental-basedir=/fullbak --datadir=/var/lib/mysql…………230530 19:00:55 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24848404) to (24848414) was copied.230530 19:00:56 completed OK!
#插入新数据 (可以插入多行)mysql> insert【因涩特】 into【因兔】 moershi.salary【晒了瑞】(date,employee_id,basic【贝斯克】,bonus【波诺斯】) values【挖柳斯】("20250710",18,25000,8000);#mysql> insert into moershi.salary(date,employee_id,basic,bonus) values("20250710",18,25000,8000);#Query OK, 1 row affected (0.06 sec)周日增量备份(备份周六备份后新产生的数据)
[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/new7 --incremental【因葵孟透】-basedir【贝斯迪尔】=/new6 --datadir【得塔-迪尔】=/var/lib/mysql#[root@mha ~]# xtrabackup --host=127.0.0.1 --user=root --password=123 --backup --target-dir=/new7 --incremental-basedir=/fullbak --datadir=/var/lib/mysql…………230530 19:00:55 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24848404) to (24848414) was copied.230530 19:00:56 completed OK![root@mysql50 ~]#4.3 数据增量恢复
增量恢复数据步骤:
- 准备恢复数据
- 合并数据
- 清空数据库目录
- 拷贝数据
- 修改数据库目录所有者/组用户为mysql
- 重启数据库服务
具体操作如下:
MySQL51 拷贝 MySQL50 的备份文件到 本机的根目录下
[root@mysql51 ~]# scp –r root@192.168.90.50:/fullbak【fò-拜克】 /[root@mysql51 ~]# scp –r root@192.168.90.50:/new2 /[root@mysql51 ~]# scp –r root@192.168.90.50:/new3 /[root@mysql51 ~]# scp –r root@192.168.90.50:/new4 /[root@mysql51 ~]# scp –r root@192.168.90.50:/new5 /[root@mysql51 ~]# scp –r root@192.168.90.50:/new6 /[root@mysql51 ~]# scp –r root@192.168.90.50:/new7 /在MySQL51主机使用备份文件恢复数据
—prepare【普瑞-撇尔】:对备份数据进行预处理,回滚未提交的事务并同步已提交的事务至数据文件,使数据文件处于一致性状态,以便用于恢复
—apply-log-only【欧利】:在准备备份时使用,表示只应用重做日志(redo log),不回滚未提交的事务,常用于增量备份准备
—target【塔géi特】-dir【迪尔】:指定备份文件的存储目录
—incremental【因葵孟透】-dir【迪尔】:指定增量备份的存储目录
1)、准备恢复数据
[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --prepare【普瑞-撇尔】 --apply-log-only【欧利】 --target【塔géi特】-dir【迪尔】=/fullbak【fò-拜克】…………Log background threads are being closed...Shutdown completed; log sequence number 24822898Number of pools: 1250630 14:32:14 completed OK![root@mysql51 ~]#2)、合并数据
//将周二的增量数据拷贝到周一备份目录里,合并后周一的目录里存放的是周一 + 周二 的数据[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --prepare【普瑞-撇尔】 --apply-log-only【欧利】 --target【塔géi特】-dir【迪尔】=/fullbak【fò-拜克】 --incremental【因葵孟透】-dir【迪尔】=/new2…………250630 14:40:05 [00] Copying /new2/binlog.index to ./binlog.index250630 14:40:05 [00] ...done250630 14:40:05 completed OK![root@mysql51 ~]#//将周三的增量数据拷贝到周一备份目录里,合并后周一的目录里存放的是周一 + 周二 + 周三 的数据[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --prepare【普瑞-撇尔】 --apply-log-only【欧利】 --target【塔géi特】-dir【迪尔】=/fullbak【fò-拜克】 --incremental【因葵孟透】-dir【迪尔】=/new3…………250630 15:00:37 [00] Copying /new3/binlog.index to ./binlog.index250630 15:00:37 [00] ...done250630 15:00:37 completed OK![root@mysql51 ~]#//将周四的增量数据拷贝到周一备份目录里,合并后周一的目录里存放的是周一 + 周二 + 周三 +周四的数据[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --prepare【普瑞-撇尔】 --apply-log-only【欧利】 --target【塔géi特】-dir【迪尔】=/fullbak【fò-拜克】 --incremental【因葵孟透】-dir【迪尔】=/new4…………250630 15:00:37 [00] Copying /new4/binlog.index to ./binlog.index250630 15:00:37 [00] ...done250630 15:00:37 completed OK![root@mysql51 ~]#//将周五的增量数据拷贝到周一备份目录里,合并后周一的目录里存放的是周一 + 周二 + 周三 +周四+周五的数据[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --prepare【普瑞-撇尔】 --apply-log-only【欧利】 --target【塔géi特】-dir【迪尔】=/fullbak【fò-拜克】 --incremental【因葵孟透】-dir【迪尔】=/new5…………250630 15:00:37 [00] Copying /new5/binlog.index to ./binlog.index250630 15:00:37 [00] ...done250630 15:00:37 completed OK![root@mysql51 ~]#//将周六的增量数据拷贝到周一备份目录里,合并后周一的目录里存放的是周一 + 周二 + 周三 +周四+周五+周六的数据[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --prepare【普瑞-撇尔】 --apply-log-only【欧利】 --target【塔géi特】-dir【迪尔】=/fullbak【fò-拜克】 --incremental【因葵孟透】-dir【迪尔】=/new6…………250630 15:00:37 [00] Copying /new6/binlog.index to ./binlog.index250630 15:00:37 [00] ...done250630 15:00:37 completed OK![root@mysql51 ~]#//将周日的增量数据拷贝到周一备份目录里,合并后周一的目录里存放的是周一 + 周二 + 周三 +周四+周五+周六+周日的数据[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --prepare【普瑞-撇尔】 --apply-log-only【欧利】 --target【塔géi特】-dir【迪尔】=/fullbak【fò-拜克】 --incremental【因葵孟透】-dir【迪尔】=/new7…………250630 15:00:37 [00] Copying /new7/binlog.index to ./binlog.index250630 15:00:37 [00] ...done250630 15:00:37 completed OK![root@mysql51 ~]#
[root@mysql51 ~]# rm -rf /var/lib/mysql/*[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --prepare【普瑞-撇尔】 --target【塔géi特】-dir【迪尔】=/fullbak【fò-拜克】[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --copy-back --target【塔géi特】-dir【迪尔】=/fullbak【fò-拜克】[root@mysql51 ~]# chown -R mysql:mysql /var/lib/mysql6)重启数据库服务
[root@mysql51 ~]# systemctl restart mysqld7)连接服务查看数据
[root@mysql51 ~]# mysql -uroot -pNSD123456...amysql> select【涩莱克特】 count【kàn特】(*) from【弗乱】 moershi.salary【晒了瑞】 where date=20250710;+----------+| count(*) |+----------+| 75 |+----------+1 row in set (0.01 sec)mysql> select【涩莱克特】 count【kàn特】(*) from【弗乱】 moershi.salary【晒了瑞】 where not date=20250710;+----------+| count(*) |+----------+| 8067 |+----------+1 row in set (0.00 sec)五、差异备份与恢复
当前任务环节
flowchart LR subgraph BottomRow[mysql之备份与恢复] direction LR A[mysqldump<br/>备份与恢复] --> B[增量备份<br/>与恢复] --> C[差分备份<br/>与恢复] end classDef highlight stroke:#f00,stroke-width:2px; class C highlight;差异备份:备份完全备份后,新产生的数据。
PERCONA【帕扣娜】 xtrabackup【xtra-拜克阿普】是一款强大的在线热备份工具,备份过程中不锁库表,适合生产环境。支持差异备份与恢复。
在192.168.90.50主机完成差异备份
5.1 差异备份
差异备份
对数据做差异备份前,必须先有一次备份,也就是首次备份,通常是备份所有数据;比如每周周一完全备份,周二到周日差异备份。
//周一完全备份[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/allbak --datadir【得塔-迪尔】=/var/lib/mysql…………260630 17:10:02 [00] Writing /allbak/xtrabackup【xtra-拜克阿普】_info260630 17:10:02 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24881353) to (24881373) was copied.260630 17:10:03 completed OK![root@mysql50 ~]#//插入新数据 (可以插入多行)mysql> insert【因涩特】 into【因兔】 tarena.salary【晒了瑞】(date,employee_id,basic【贝斯克】,bonus【波诺斯】) values【挖柳斯】("20250810",18,25000,8000);周二差异备份,备份周一备份后新产生的数据
[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/dir2 --incremental【因葵孟透】-basedir【贝斯迪尔】=/allbak --datadir【得塔-迪尔】=/var/lib/mysql…………260630 17:23:56 [00] Writing /dir2/xtrabackup【xtra-拜克阿普】_info260630 17:23:56 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24886741) to (24886751) was copied.260630 17:23:58 completed OK![root@mysql50 ~]#//插入新数据 (可以插入多行)mysql> insert【因涩特】 into【因兔】 tarena.salary【晒了瑞】(date,employee_id,basic【贝斯克】,bonus【波诺斯】) values【挖柳斯】("20250810",18,25000,8000);周三差异备份,备份周一备份后新产生的数据
[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/dir3 --incremental【因葵孟透】-basedir【贝斯迪尔】=/allbak --datadir【得塔-迪尔】=/var/lib/mysql…………260630 17:27:10 [00] Writing /dir3/xtrabackup【xtra-拜克阿普】_info260630 17:27:10 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24892043) to (24892063) was copied.260630 17:27:11 completed OK![root@mysql50 ~]#//插入新数据 (可以插入多行)mysql> insert【因涩特】 into【因兔】 tarena.salary【晒了瑞】(date,employee_id,basic【贝斯克】,bonus【波诺斯】) values【挖柳斯】("20250810",18,25000,8000);周四差异备份,备份周一备份后新产生的数据
[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/dir4 --incremental【因葵孟透】-basedir【贝斯迪尔】=/allbak --datadir【得塔-迪尔】=/var/lib/mysql…………230531 17:31:00 [00] Writing /dir4/xtrabackup【xtra-拜克阿普】_info230531 17:31:00 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24900560) to (24900580) was copied.230531 17:31:01 completed OK![root@mysql50 ~]#//插入新数据 (可以插入多行)mysql> insert【因涩特】 into【因兔】 tarena.salary【晒了瑞】(date,employee_id,basic【贝斯克】,bonus【波诺斯】) values【挖柳斯】("20250810",18,25000,8000);周五差异备份,备份周一备份后新产生的数据
[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/dir5 --incremental【因葵孟透】-basedir【贝斯迪尔】=/allbak --datadir【得塔-迪尔】=/var/lib/mysql…………230531 17:32:38 [00] Writing /dir5/xtrabackup【xtra-拜克阿普】_info230531 17:32:38 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24906902) to (24906912) was copied.230531 17:32:39 completed OK![root@mysql50 ~]#//插入新数据 (可以插入多行)mysql> insert【因涩特】 into【因兔】 tarena.salary【晒了瑞】(date,employee_id,basic【贝斯克】,bonus【波诺斯】) values【挖柳斯】("20250810",18,25000,8000);周六差异备份,备份周一备份后新产生的数据
[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/dir6 --incremental【因葵孟透】-basedir【贝斯迪尔】=/allbak --datadir【得塔-迪尔】=/var/lib/mysql…………230531 17:41:01 [00] Writing /dir6/xtrabackup【xtra-拜克阿普】_info230531 17:41:01 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24914729) to (24914739) was copied.230531 17:41:02 completed OK!
[root@mysql50 ~]#-- 插入新数据 (可以插入多行)mysql> insert【因涩特】 into【因兔】 tarena.salary【晒了瑞】(date,employee_id,basic【贝斯克】,bonus【波诺斯】) values【挖柳斯】("20250810",18,25000,8000);周日差异,备份备份周一备份后新产生的数据
[root@mysql50 ~]# xtrabackup【xtra-拜克阿普】 --host=127.0.0.1 --user=root --password【帕斯沃德】=NSD123456...a --backup【拜克阿普】 --target【塔géi特】-dir【迪尔】=/dir7 --incremental【因葵孟透】-basedir【贝斯迪尔】=/allbak --datadir【得塔-迪尔】=/var/lib/mysql…………230531 17:43:16 [00] Writing /dir7/xtrabackup【xtra-拜克阿普】_info230531 17:43:16 [00] ...donextrabackup【xtra-拜克阿普】: Transaction log of lsn (24920772) to (24920782) was copied.230531 17:43:17 completed OK![root@mysql50 ~]#5.2 差异恢复
差异恢复数据步骤:
- 准备恢复数据
- 合并数据
- 清空数据库目录
- 拷贝数据
- 修改数据库目录所有者/组用户为mysql
- 重启数据库服务
具体操作如下:
MySQL51 拷贝 MySQL50 的备份文件到 本机的根目录下
[root@mysql51 ~]# scp –r root@192.168.90.50:/allbak /[root@mysql51 ~]# scp –r root@192.168.90.50:/dir7 /在MySQL51主机使用备份文件恢复数据
1)、准备恢复数据
[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --prepare【普瑞-撇尔】 --apply-log-only【欧利】 --target【塔géi特】-dir【迪尔】=/allbak…………Log background threads are being closed...Shutdown completed; log sequence number 24881373Number of pools: 1230531 17:59:06 completed OK![root@mysql51 ~]#2)、合并数据
//将周日的差异备份与周一的完全备份合并,因为周日的差异备份包扩周二+周日的所有数据[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --prepare【普瑞-撇尔】 --apply-log-only【欧利】 --target【塔géi特】-dir【迪尔】=/allbak --incremental【因葵孟透】-dir【迪尔】=/dir7…………230531 18:05:08 [00] Copying /dir7/binlog.000029 to ./binlog.000029230531 18:05:08 [00] ...done230531 18:05:08 [00] Copying /dir7/binlog.index to ./binlog.index230531 18:05:08 [00] ...done230531 18:05:08 completed OK!
[root@mysql51 ~]#[root@mysql51 ~]# rm -rf /var/lib/mysql/*[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --prepare【普瑞-撇尔】 --target【塔géi特】-dir【迪尔】=/allbak[root@mysql51 ~]# xtrabackup【xtra-拜克阿普】 --copy-back --target【塔géi特】-dir【迪尔】=/allbak[root@mysql51 ~]# chown -R mysql:mysql /var/lib/mysql3)重启数据库服务
[root@mysql51 ~]# systemctl restart mysqld4)连接服务查看数据
[root@mysql51 ~]# mysql -uroot -pNSD123456...amysql> select【涩莱克特】 count【kàn特】(*) from【弗乱】 tarena.salary【晒了瑞】 where date=20250810;+----------+| count(*) |+----------+| 75 |+----------+1 row in set (0.01 sec)
mysql> select【涩莱克特】 count【kàn特】(*) from【弗乱】 tarena.salary【晒了瑞】 where not date=20250810;+----------+| count(*) |+----------+| 8067 |+----------+1 row in set (0.00 sec)全量备份
### 全量备份步骤 以下是使用 `xtrabackup` 进行全量备份的命令: [root@mha ~]# xtrabackup --backup --target-dir=/path/to/backup
#- `--backup`:表示执行备份操作。 #- `--target-dir`:指定备份文件的存储目录。 备份完成后,需要对备份进行准备,以确保备份数据处于一致状态:
[root@mha ~]# xtrabackup --prepare --target-dir=/path/to/backup
#- `--prepare`:对备份数据进行准备,应用事务日志。
### 恢复步骤 #### 1. 停止 MySQL 服务 在恢复备份之前,需要停止正在运行的 MySQL 服务,以避免数据冲突。 [root@mha ~]# sudo systemctl stop mysql
#### 2. 清空 MySQL 数据目录 为了确保恢复的数据是完整的,需要清空 MySQL 数据目录中的现有数据。 [root@mha ~]# sudo rm -rf /var/lib/mysql/*
#### 3. 恢复备份数据 将备份数据复制到 MySQL 数据目录。 [root@mha ~]# sudo xtrabackup --copy-back --target-dir=/path/to/backup
#- `--copy-back`:将备份数据复制回 MySQL 数据目录。
#### 4. 修改文件权限 恢复数据后,需要确保 MySQL 数据目录及其文件的权限正确。 [root@mha ~]# sudo chown -R mysql:mysql /var/lib/mysql
#### 5. 启动 MySQL 服务 完成上述步骤后,可以启动 MySQL 服务。 [root@mha ~]# sudo systemctl start mysql
#### 6. 验证恢复结果 可以登录 MySQL 并检查数据库和表是否已成功恢复。 [root@mha ~]# mysql -u root -p增量备份恢复
#准备恢复数据。使用 `--apply-log-only`只应用重做日志,不回滚为后续增量备份应用做准备。因为在增量备份中,基础备份必须保持事务状态,以便后续的增量备份能够正确应用。如果提前回滚了未提交事务,那么增量备份应用时可能会丢失一些事务信息。 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/fullbak #合并增量数据,需要把所有的增量备份数据全部合并,不然会造成数据缺失 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/fullbak --incremental-dir=/new1 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/fullbak --incremental-dir=/new2 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/fullbak --incremental-dir=/new3 # 停止 MySQL 服务。在恢复备份之前,需要停止正在运行的 MySQL 服务,以避免数据冲突。 [root@mha ~]# sudo systemctl stop mysql # 清空 MySQL 数据目录。为了确保恢复的数据是完整的,需要清空 MySQL 数据目录中的现有数据。 [root@mha ~]# sudo rm -rf /var/lib/mysql/* # 最终准备预处理备份数据。应用重做日志(redo log)到数据文件,将数据文件前滚到备份结束时的状态,使备份数据处于一致状态,可以用于恢复。 [root@mha ~]# sudo xtrabackup --prepare --target-dir=/fullbak # 恢复备份数据。将备份数据复制到 MySQL 数据目录。 [root@mha ~]# sudo xtrabackup --copy-back --target-dir=/fullbak # 修改文件权限。恢复数据后,需要确保 MySQL 数据目录及其文件的权限正确。 [root@mha ~]# sudo chown -R mysql:mysql /var/lib/mysql # 启动 MySQL 服务。完成上述步骤后,可以启动 MySQL 服务。 [root@mha ~]# sudo systemctl start mysql # 验证恢复结果。可以登录 MySQL 并检查数据库和表是否已成功恢复。 [root@mha ~]# mysql -u root -p差异备份恢复
# 差异备份恢复步骤:
# 1. 准备基础全量备份(使用 --apply-log-only 保持事务状态) [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/fullbak # 原因:基础备份必须保持事务状态,以便后续的差异备份能够正确应用。 # 如果提前回滚了未提交事务,差异备份应用时可能会丢失事务信息。
# 2. 应用最后一次差异备份(直接完整准备,不使用 --apply-log-only) [root@mha ~]# sudo xtrabackup --prepare --target-dir=/fullbak --incremental-dir=/diff_backup # 原因:差异备份基于同一个全量备份,这是最后一个备份步骤,需要完成事务回滚,使数据达到一致状态。 # 不需要使用 --apply-log-only,因为后面没有更多的备份要应用。
# 3. 停止 MySQL 服务 [root@mha ~]# sudo systemctl stop mysql # 原因:在恢复备份之前,需要停止正在运行的 MySQL 服务,以避免数据冲突。
# 4. 备份并清空 MySQL 数据目录 [root@mha ~]# sudo mv /var/lib/mysql /var/lib/mysql_backup_$(date +%Y%m%d) [root@mha ~]# sudo mkdir /var/lib/mysql # 原因:为了确保恢复的数据是完整的,需要清空 MySQL 数据目录中的现有数据。
# 5. 恢复备份数据到 MySQL 数据目录 [root@mha ~]# sudo xtrabackup --copy-back --target-dir=/fullbak # 原因:将已准备好的备份数据复制到 MySQL 数据目录。
# 6. 修改文件权限 [root@mha ~]# sudo chown -R mysql:mysql /var/lib/mysql # 原因:恢复数据后,需要确保 MySQL 数据目录及其文件的权限正确。
# 7. 启动 MySQL 服务 [root@mha ~]# sudo systemctl start mysql # 原因:完成上述步骤后,可以启动 MySQL 服务。
# 8. 验证恢复结果 [root@mha ~]# mysql -u root -p -e "SHOW DATABASES;" # 原因:验证数据库和表是否已成功恢复。备份完整性验证
# 1. 准备备份 # 在验证之前,需要对备份进行准备操作,以应用事务日志,使备份数据处于一致状态。此步骤适用于全量备份和差异备份。
[root@mha ~]# xtrabackup --prepare --target-dir=/path/to/backup # - `--prepare`:该参数用于对备份数据进行准备操作。 # - `--target-dir`:指定备份文件所在的目录。
# 2. 检查备份元数据文件 # 备份完成后,XtraBackup 会生成一个名为 `xtrabackup_info` 的元数据文件,该文件包含了备份的相关信息,如备份类型、开始时间、结束时间等。你可以查看这个文件来初步验证备份的基本信息是否正确。
[root@mha ~]# cat /path/to/backup/xtrabackup_info # 查看输出内容,确认备份类型为差异备份(`incremental`),并且各项时间信息和其他元数据是否合理。
# 3. 检查备份文件的完整性 # 可以使用 `xtrabackup --stats` 命令来检查备份文件中的数据页和事务日志的完整性。
[root@mha ~]# xtrabackup --stats --target-dir=/path/to/backup
# - `--stats`:该参数用于显示备份文件的统计信息。 # - `--target-dir`:指定备份文件所在的目录。 # 如果备份文件完整,命令执行后会输出详细的统计信息,包括数据页的数量、事务日志的大小等。如果备份文件存在损坏,该命令可能会报错。
# 4. 模拟恢复操作 # 模拟恢复操作是验证备份完整性的最可靠方法。虽然不会真正覆盖现有的 MySQL 数据目录,但可以检查备份数据是否能够正确恢复。
# 停止 MySQL 服务(如果正在运行) [root@mha ~]# sudo systemctl stop mysql
# 创建一个临时目录用于模拟恢复 [root@mha ~]# mkdir /tmp/restore-test
# 执行模拟恢复操作 [root@mha ~]# xtrabackup --copy-back --target-dir=/path/to/backup --datadir=/tmp/restore-test # - `--copy-back`:将备份数据复制到指定的数据目录。 # - `--target-dir`:指定备份文件所在的目录。 # - `--datadir`:指定模拟恢复的数据目录。 # 如果模拟恢复过程中没有报错,说明备份文件可以正常恢复,完整性得到验证。恢复完成后,你可以查看临时目录中的文件是否与预期一致。
# 5. 清理临时目录 # 模拟恢复验证完成后,清理临时目录。 [root@mha ~]# rm -rf /tmp/restore-test
# 6. 启动 MySQL 服务 # 如果之前停止了 MySQL 服务,现在可以启动它。 [root@mha ~]# sudo systemctl start mysql
# 通过以上步骤,你可以全面验证 Percona XtraBackup 差异备份文件的完整性,确保在需要恢复数据时能够顺利进行。备份方案案例
以下是一个完整的 MySQL 备份与恢复方案,包含使用 mysqldump 进行定期全量备份、Percona XtraBackup 进行日常增量和差异备份,以及在数据丢失时的恢复方法。
1. 环境准备
- 安装
mysqldump:mysqldump是 MySQL 自带的备份工具,通常在安装 MySQL 时会一并安装。 - 安装
Percona XtraBackup:根据你的操作系统,按照 Percona 官方文档进行安装。例如,在 Ubuntu 上可以使用以下命令:
wget https://repo.percona.com/apt/percona-release_latest.$(lsb_release -sc)_all.debsudo dpkg -i percona-release_latest.$(lsb_release -sc)_all.debsudo apt-get updatesudo apt-get install percona-xtrabackup-802. 备份方案
2.1 使用 mysqldump 进行定期全量备份
mysqldump 适合进行全量备份,特别是对于较小的数据库。
脚本示例(full_backup.sh):
#!/bin/bash
# 数据库连接信息DB_USER="your_username"DB_PASSWORD="your_password"DB_NAME="your_database_name"BACKUP_DIR="/path/to/backup"
# 创建备份目录mkdir -p $BACKUP_DIR
# 生成备份文件名BACKUP_FILE="$BACKUP_DIR/$(date +%Y%m%d)_full_backup.sql"
# 执行全量备份mysqldump -u$DB_USER -p$DB_PASSWORD $DB_NAME > $BACKUP_FILE
# 检查备份是否成功if [ $? -eq 0 ]; then echo "Full backup completed successfully."else echo "Full backup failed."fi定时任务:使用 crontab 每周执行一次全量备份。
0 2 * * 0 /path/to/full_backup.sh2.2 使用 Percona XtraBackup 进行日常增量和差异备份
全量备份脚本(full_xtrabackup.sh):
#!/bin/bash
# 数据库连接信息DB_USER="your_username"DB_PASSWORD="your_password"BACKUP_DIR="/path/to/backup/xtrabackup"
# 创建备份目录mkdir -p $BACKUP_DIR
# 生成备份文件名FULL_BACKUP_DIR="$BACKUP_DIR/$(date +%Y%m%d)_full"mkdir -p $FULL_BACKUP_DIR
# 执行全量备份xtrabackup --user=$DB_USER --password=$DB_PASSWORD --backup --target-dir=$FULL_BACKUP_DIR
# 检查备份是否成功if [ $? -eq 0 ]; then echo "Full XtraBackup completed successfully."else echo "Full XtraBackup failed."fi增量备份脚本(incremental_backup.sh):
#!/bin/bash
# 数据库连接信息DB_USER="your_username"DB_PASSWORD="your_password"BACKUP_DIR="/path/to/backup/xtrabackup"
# 获取最新的全量备份目录LAST_FULL_BACKUP=$(ls -d $BACKUP_DIR/*_full | tail -n 1)
# 生成增量备份目录INCREMENTAL_BACKUP_DIR="$BACKUP_DIR/$(date +%Y%m%d)_incremental"mkdir -p $INCREMENTAL_BACKUP_DIR
# 执行增量备份xtrabackup --user=$DB_USER --password=$DB_PASSWORD --backup --target-dir=$INCREMENTAL_BACKUP_DIR --incremental-basedir=$LAST_FULL_BACKUP
# 检查备份是否成功if [ $? -eq 0 ]; then echo "Incremental backup completed successfully."else echo "Incremental backup failed."fi定时任务:每周执行一次全量备份,每天执行一次增量备份。
0 2 * * 0 /path/to/full_xtrabackup.sh0 3 * * 1-6 /path/to/incremental_backup.sh3. 恢复方案
3.1 使用 mysqldump 恢复数据
mysql -u your_username -p your_password your_database_name < /path/to/backup/20240101_full_backup.sql3.2 使用 Percona XtraBackup 恢复数据
步骤 1:准备全量备份
xtrabackup --prepare --target-dir=/path/to/backup/xtrabackup/20240101_full步骤 2:应用增量备份
xtrabackup --prepare --target-dir=/path/to/backup/xtrabackup/20240101_full --incremental-dir=/path/to/backup/xtrabackup/20240102_incremental步骤 3:停止 MySQL 服务
sudo systemctl stop mysql步骤 4:恢复备份数据
sudo rm -rf /var/lib/mysql/*sudo xtrabackup --copy-back --target-dir=/path/to/backup/xtrabackup/20240101_fullsudo chown -R mysql:mysql /var/lib/mysql步骤 5:启动 MySQL 服务
sudo systemctl start mysql六、作业
1 选择题
-
以下哪种备份方式能在备份时不锁表,从而不影响 MySQL 数据库的正常读写操作? B A. mysqldump 全量备份 B. PERCONA Xtrabackup 全量备份 C. mysqldump 增量备份 D. 以上都不能
-
使用 PERCONA Xtrabackup 进行增量备份时,基于的基础备份是?A A. 上一次的全量备份 B. 上一次的增量备份 C. 上一次的差异备份 D. 任意一次备份
-
当使用 mysqldump 备份数据库时,若要备份所有数据库,应使用以下哪个参数? A A. —all-databases B. —database-all C. —full-databases D. —every-database
-
PERCONA Xtrabackup 的差异备份恢复时,依赖于?A A. 最新的全量备份和后续的差异备份 B. 最新的增量备份和后续的差异备份 C. 最早的全量备份和所有后续备份 D. 任意一次全量备份和差异备份
-
若要使用 PERCONA Xtrabackup 进行增量备份,需要记录上一次备份的什么信息? C A. 备份文件大小 B. 备份文件位置 C. 备份的 LSN(日志序列号) D. 备份的时间戳
2 简答题
- 简述 mysqldump、PERCONA Xtrabackup 增量备份和差异备份的优缺点。
答: mysqldump: 优点:灵活,可以针对单表或多表和单数据库或多数据进行备份还原 缺点:备份和恢复数据时会锁表,锁表期间无法对表做写访问。只适合备份数据量比较小的数据或在数据库服务器访问量少的时候备份。
PERCONA Xtrabackup 增量备份: 优点:备份速度快,占用空间小,因为每次只备份变化的数据。 缺点:恢复数据时,需要先恢复完整备份,然后按照时间顺序依次恢复所有的增量备份,直到指定的时间点。恢复过程复杂且耗时,如果中间任何一个备份损坏,可能导致整个恢复链失效。
PERCONA Xtrabackup 差异备份: 优点:恢复时只需要完整备份和最近一次的差异备份,恢复过程相对简单。 缺点:随着时间推移,差异备份的大小会越来越大,因为每次都要备份自完整备份以来的所有变化。备份时间可能会逐渐增加。- 阐述在什么业务场景下适合使用 PERCONA Xtrabackup 的增量备份,什么场景适合使用差异备份。
答: 增量备份: 数据量大,备份窗口短,但对恢复时间要求不高的场景。
差异备份: 数据量变化不大,且希望恢复过程相对简单的场景。- 说明在进行 MySQL 数据库恢复时,全量备份、增量备份和差异备份的恢复顺序及原因。 答: 全量备份恢复步骤:
# 停止 MySQL 服务。在恢复备份之前,需要停止正在运行的 MySQL 服务,以避免数据冲突。 [root@mha ~]# sudo systemctl stop mysql # 清空 MySQL 数据目录。为了确保恢复的数据是完整的,需要清空 MySQL 数据目录中的现有数据。 [root@mha ~]# sudo rm -rf /var/lib/mysql/* # 预处理备份数据。应用重做日志(redo log)到数据文件,将数据文件前滚到备份结束时的状态,使备份数据处于一致状态,可以用于恢复。 [root@mha ~]# sudo xtrabackup --prepare --target-dir=/path/to/backup # 恢复备份数据。将备份数据复制到 MySQL 数据目录。 [root@mha ~]# sudo xtrabackup --copy-back --target-dir=/path/to/backup # 修改文件权限。恢复数据后,需要确保 MySQL 数据目录及其文件的权限正确。 [root@mha ~]# sudo chown -R mysql:mysql /var/lib/mysql # 启动 MySQL 服务。完成上述步骤后,可以启动 MySQL 服务。 [root@mha ~]# sudo systemctl start mysql # 验证恢复结果。可以登录 MySQL 并检查数据库和表是否已成功恢复。 [root@mha ~]# mysql -u root -p增量备份恢复步骤: #准备恢复数据。使用 `--apply-log-only`只应用重做日志,不回滚为后续增量备份应用做准备。因为在增量备份中,基础备份必须保持事务状态,以便后续的增量备份能够正确应用。如果提前回滚了未提交事务,那么增量备份应用时可能会丢失一些事务信息。 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/fullbak #合并增量数据,需要把所有的增量备份数据全部合并,不然会造成数据缺失 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/fullbak --incremental-dir=/new1 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/fullbak --incremental-dir=/new2 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/fullbak --incremental-dir=/new3 # 停止 MySQL 服务。在恢复备份之前,需要停止正在运行的 MySQL 服务,以避免数据冲突。 [root@mha ~]# sudo systemctl stop mysql # 清空 MySQL 数据目录。为了确保恢复的数据是完整的,需要清空 MySQL 数据目录中的现有数据。 [root@mha ~]# sudo rm -rf /var/lib/mysql/* # 最终准备预处理备份数据。应用重做日志(redo log)到数据文件,将数据文件前滚到备份结束时的状态,使备份数据处于一致状态,可以用于恢复。 [root@mha ~]# sudo xtrabackup --prepare --target-dir=/fullbak # 恢复备份数据。将备份数据复制到 MySQL 数据目录。 [root@mha ~]# sudo xtrabackup --copy-back --target-dir=/fullbak # 修改文件权限。恢复数据后,需要确保 MySQL 数据目录及其文件的权限正确。 [root@mha ~]# sudo chown -R mysql:mysql /var/lib/mysql # 启动 MySQL 服务。完成上述步骤后,可以启动 MySQL 服务。 [root@mha ~]# sudo systemctl start mysql # 验证恢复结果。可以登录 MySQL 并检查数据库和表是否已成功恢复。 [root@mha ~]# mysql -u root -p差异备份恢复步骤: #准备恢复数据。使用 `--apply-log-only`只应用重做日志,不回滚为后续增量备份应用做准备。因为在增量备份中,基础备份必须保持事务状态,以便后续的增量备份能够正确应用。如果提前回滚了未提交事务,那么增量备份应用时可能会丢失一些事务信息。 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/fullbak #合并差异数据,只需要把全量数据和最后一次的差异数据合并,但暂不完成最终一致性 [root@mha ~]# sudo xtrabackup --prepare --target-dir=/fullbak --incremental-dir=/dir7 # 停止 MySQL 服务。在恢复备份之前,需要停止正在运行的 MySQL 服务,以避免数据冲突。 [root@mha ~]# sudo systemctl stop mysql # 清空 MySQL 数据目录。为了确保恢复的数据是完整的,需要清空 MySQL 数据目录中的现有数据。 [root@mha ~]# sudo rm -rf /var/lib/mysql/* # 最终准备预处理备份数据。应用重做日志(redo log)到数据文件,将数据文件前滚到备份结束时的状态,使备份数据处于一致状态,可以用于恢复。 [root@mha ~]# sudo xtrabackup --prepare --target-dir=/fullbak # 恢复备份数据。将备份数据复制到 MySQL 数据目录。 [root@mha ~]# sudo xtrabackup --copy-back --target-dir=/fullbak # 修改文件权限。恢复数据后,需要确保 MySQL 数据目录及其文件的权限正确。 [root@mha ~]# sudo chown -R mysql:mysql /var/lib/mysql # 启动 MySQL 服务。完成上述步骤后,可以启动 MySQL 服务。 [root@mha ~]# sudo systemctl start mysql # 验证恢复结果。可以登录 MySQL 并检查数据库和表是否已成功恢复。 [root@mha ~]# mysql -u root -p- 比较 mysqldump 和 PERCONA Xtrabackup 在备份和恢复过程中对数据库性能的影响。
答: mysqldump: 在备份和恢复数据时会通过锁表保证一致性,影响写操作,锁表期间无法对表做写访问 PERCONA Xtrabackup: 利用InnoDB的MVCC机制,实现热备份,几乎不影响业务3 操作题
- 请写出使用 mysqldump 对指定一个数据库进行全量备份,并将备份文件存储到“/backup/sales_full_backup.sql”的完整命令。
[root@mha ~]# mysqldump -uroot -p123 -B moershi > /backup/sales_full_backup.sql mysqldump: [Warning] Using a password on the command line interface can be insecure. [root@mha ~]# ls /backup sales_full_backup.sql- 假设已经有一个 PERCONA Xtrabackup 的全量备份,之后数据库有了新的数据更新,写出进行一次增量备份的操作步骤和相应命令。
[root@mha ~]# xtrabackup --host=127.0.0.1 --user=root --password=123 --backup --target-dir=/增量备份保存路径 --incremenntal-basedir=/全量备份保存路径 --datadir=/mysql数据路径- 若数据库因磁盘故障丢失部分数据,现有一个全量备份和若干个 PERCONA Xtrabackup 的差异备份文件,请详细描述恢复数据库的操作过程和命令。
1.准备恢复数据,预处理只应用重做日志,不回滚为后续备份应用做准备。 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/全量备份数据
2.合并差异数据,只需要把一个全量备份数据和最后一次的差异备份数据合并,但暂不完成最终一致性 [root@mha ~]# sudo xtrabackup --prepare --target-dir=/全量备份数据 --incremental-dir=/差异备份数据
3.停止 MySQL 服务。在恢复备份之前,需要停止正在运行的 MySQL 服务,以避免数据冲突。 [root@mha ~]# sudo systemctl stop mysql
4.清空 MySQL 数据目录。为了确保恢复的数据是完整的,需要清空 MySQL 数据目录中的现有数据。 [root@mha ~]# sudo rm -rf /var/lib/mysql/*
5.最终准备预处理备份数据。应用重做日志(redo log)到数据文件,将数据文件前滚到备份结束时的状态,使备份数据处于一致状态,可以用于恢复。 [root@mha ~]# sudo xtrabackup --prepare --target-dir=/全量备份数据
6.恢复备份数据。将备份数据复制到 MySQL 数据目录。 [root@mha ~]# sudo xtrabackup --copy-back --target-dir=/全量备份数据
7.修改文件权限。恢复数据后,需要确保 MySQL 数据目录及其文件的权限正确。 [root@mha ~]# sudo chown -R mysql:mysql /var/lib/mysql
8.启动 MySQL 服务。完成上述步骤后,可以启动 MySQL 服务。 [root@mha ~]# sudo systemctl start mysql
9.验证恢复结果。可以登录 MySQL 并检查数据库和表是否已成功恢复。 [root@mha ~]# mysql -u root -p- 使用 PERCONA Xtrabackup 进行差异备份时,如何验证备份文件的完整性?写出具体步骤和命令。
1. 准备备份 在验证之前,需要对备份进行准备操作,以应用事务日志,使备份数据处于一致状态。
[root@mha ~]# xtrabackup --prepare --target-dir=/path/to/backup
2. 检查备份元数据文件 备份完成后,XtraBackup 会生成一个名为 `xtrabackup_info` 的元数据文件,该文件包含了备份的相关信息,如备份类型、开始时间、结束时间等。可以查看这个文件来初步验证备份的基本信息是否正确。
[root@mha ~]# cat /path/to/backup/xtrabackup_info
查看输出内容,确认备份类型为差异备份(`incremental`),并且各项时间信息和其他元数据是否合理。
3. 检查备份文件的完整性 可以使用 `xtrabackup --stats` 命令来检查备份文件中的数据页和事务日志的完整性。
[root@mha ~]# xtrabackup --stats --target-dir=/path/to/backup
如果备份文件完整,命令执行后会输出详细的统计信息,包括数据页的数量、事务日志的大小等。如果备份文件存在损坏,该命令可能会报错。- 请设计一个完整的 MySQL 备份与恢复方案,包括使用 mysqldump 进行定期全量备份、PERCONA Xtrabackup 进行日常增量和差异备份,并描述在数据丢失时如何利用这些备份进行恢复。
一。备份方案1 使用 `crontab` 和 `mysqldump` 进行定期全量备份0 2 * * 0 /bin/mysqldump -uroot -p123 -A > /backup/sql/all_$(date +%Y-%m-%d_%H-%M-%S).sql
2 使用 `Percona XtraBackup` 进行日常增量和差异备份
全量备份脚本#!/bin/bash
# 数据库连接信息DB_USER="root"DB_PASSWORD="123"BACKUP_DIR="/fullbak"
# 创建备份目录mkdir -p $BACKUP_DIR
# 生成备份文件名FULL_BACKUP_DIR="$BACKUP_DIR/$(date +%Y%m%d)_full"mkdir -p $FULL_BACKUP_DIR
# 执行全量备份xtrabackup --host=127.0.0.1 --user=$DB_USER --password=$DB_PASSWORD --backup --target-dir=$FULL_BACKUP_DIR --datadir=/var/lib/mysql
# 检查备份是否成功if [ $? -eq 0 ]; then echo "Full XtraBackup completed successfully."else echo "Full XtraBackup failed."fi
增量备份脚本#!/bin/bash
# 数据库连接信息DB_USER="root"DB_PASSWORD="123"BACKUP_DIR="/fullbak"
# 获取最新的全量备份目录LAST_FULL_BACKUP=$(ls -d $BACKUP_DIR/*_full | tail -n 1)
# 生成增量备份目录INCREMENTAL_BACKUP_DIR="$BACKUP_DIR/$(date +%Y%m%d)_incremental"mkdir -p $INCREMENTAL_BACKUP_DIR
# 执行增量备份xtrabackup --host=127.0.0.1 --user=$DB_USER --password=$DB_PASSWORD --backup --target-dir=$INCREMENTAL_BACKUP_DIR --incremental-basedir=$LAST_FULL_BACKUP --datadir=/var/lib/mysql
# 检查备份是否成功if [ $? -eq 0 ]; then echo "Incremental backup completed successfully."else echo "Incremental backup failed."fi
定时任务:每周执行一次全量备份,每天执行一次增量备份。0 2 * * 0 /全量备份脚本0 3 * * 1-6 /增量备份脚本
二. 恢复方案
1 使用 `mysqldump` 恢复数据 mysql -uroot -p123 -A < /backup/sql/all_指定恢复时间版本.sql
2 使用 `Percona XtraBackup` 恢复数据
#准备恢复数据。 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/全量备份路径 #合并增量数据 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/全量备份路径 --incremental-dir=/增量备份路径1 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/全量备份路径 --incremental-dir=/增量备份路径2 [root@mha ~]# sudo xtrabackup --prepare --apply-log-only --target-dir=/全量备份路径 --incremental-dir=/增量备份路径3 # 停止 MySQL 服务。 [root@mha ~]# sudo systemctl stop mysql # 清空 MySQL 数据目录。 [root@mha ~]# sudo rm -rf /var/lib/mysql/* # 最终准备预处理备份数据。 [root@mha ~]# sudo xtrabackup --prepare --target-dir=/全量备份路径 # 恢复备份数据。 [root@mha ~]# sudo xtrabackup --copy-back --target-dir=/全量备份路径 # 修改文件权限。 [root@mha ~]# sudo chown -R mysql:mysql /var/lib/mysql # 启动 MySQL 服务。 [root@mha ~]# sudo systemctl start mysql # 验证恢复结果。 [root@mha ~]# mysql -u root -p作业的详细检查
1 选择题
- 第 1 题:答案正确。
PERCONA Xtrabackup全量备份利用 InnoDB 的 MVCC 机制实现热备份,备份时不锁表,不影响数据库正常读写操作;而mysqldump备份时会锁表。 - 第 2 题:答案正确。
PERCONA Xtrabackup进行增量备份时,基于上一次的全量备份。 - 第 3 题:答案正确。
--all - databases是mysqldump用于备份所有数据库的参数。 - 第 4 题:答案正确。
PERCONA Xtrabackup的差异备份恢复时,依赖于最新的全量备份和后续的差异备份。 - 第 5 题:答案错误。若要使用
PERCONA Xtrabackup进行增量备份,需要记录上一次备份的 LSN(日志序列号),而不是备份文件位置。所以正确答案选 C。
2 简答题
- 第 1 题:回答准确,清晰阐述了
mysqldump、PERCONA Xtrabackup增量备份和差异备份的优缺点。 - 第 2 题:回答合理,增量备份适合数据量大、备份窗口短且对恢复时间要求不高的场景;差异备份适合数据量变化不大且希望恢复过程相对简单的场景。
- 第 3 题:
- 回答内容整体正确,但存在一个小问题,在增量备份和差异备份准备恢复数据的注释中,提到“因为在增量备份中,基础备份必须保持事务状态,以便后续的增量备份能够正确应用”,这里应该是为了后续的增量或差异备份能够正确应用,表述不够严谨。
- 另外,在代码中路径使用
/fullbak、/new1等应该是示例,实际操作需要替换为真实路径。
- 第 4 题:回答正确,准确比较了
mysqldump和PERCONA Xtrabackup在备份和恢复过程中对数据库性能的影响。
3 操作题
- 第 1 题:
- 命令基本正确,但需要注意的是,使用
-p后面直接跟密码会有安全风险,实际操作中建议不直接写密码,而是在提示时输入。同时,-B选项用于指定数据库,这里moershi应该是你要备份的数据库名,如果需要备份sales数据库,应该将moershi替换为sales。
- 命令基本正确,但需要注意的是,使用
- 第 2 题:
- 命令存在拼写错误,
--incremenntal - basefir应该为--incremental - basedir。正确的命令为:
- 命令存在拼写错误,
[root@mha ~]# xtrabackup --host=127.0.0.1 --user=root --password=123 --backup --target-dir=/增量备份保存路径 --incremental-basedir=/全量备份保存路径 --datadir=/mysql数据路径- 同样,路径需要替换为实际路径。- 第 3 题:回答正确,详细描述了使用全量备份和差异备份恢复数据库的操作过程和命令。
- 第 4 题:回答正确,给出了验证
PERCONA Xtrabackup差异备份文件完整性的具体步骤和命令。 - 第 5 题:
- 备份方案:
- 使用
crontab和mysqldump进行定期全量备份的命令基本正确,但密码使用方式存在安全风险,建议使用更安全的方式存储密码。 Percona XtraBackup进行全量、增量备份脚本和定时任务设置思路正确,但路径需要替换为实际路径。
- 使用
- 恢复方案:
- 使用
mysqldump恢复数据的命令中,$(date +%Y - %m - %d_%H - %M - %S)会获取当前时间,应该指定具体的备份文件时间,而不是当前时间。 - 使用
Percona XtraBackup恢复数据的步骤正确,但路径需要替换为实际路径。
- 使用
- 备份方案:
总体来说,作业完成情况较好,但存在一些小错误和需要注意的安全问题,希望你能及时修改完善。
09:mysql之主从复制
今日工作任务路线图
一、工作场景
在一家电商公司,其业务涵盖商品展示、订单处理、用户管理等,数据库中存储着海量的商品信息、用户数据和交易记录。随着业务的快速发展,数据库的读写压力与日俱增。为了缓解数据库压力,提高系统的可用性和数据安全性,公司决定采用 MySQL 主从复制架构。
主数据库负责处理所有的写操作,如商品信息更新、订单创建等。从数据库则实时同步主数据库的数据,负责处理大量的读操作,如商品查询、用户信息展示等。通过这种方式,有效地分担了数据库的负载,提高了系统的响应速度。同时,当主数据库出现故障时,可以快速将业务切换到从数据库,保障业务的连续性。
二、为什么学
学习 MySQL 主从复制有诸多重要意义。在企业应用层面,随着业务增长,数据库面临读写压力大的问题,主从复制可将读操作分发到从库,减轻主库负担,提升系统性能和响应速度,保障业务流畅运行。在数据安全与备份方面,从库是主库数据的实时副本,当主库出现故障,可快速切换到从库继续服务,降低数据丢失风险,保证业务连续性。此外,掌握主从复制也是提升个人技术能力的关键一步,如今数据库技术广泛应用,精通此技术能增强职场竞争力,为从事数据库管理、开发等工作奠定坚实基础。
三、binlog【宾-劳格】日志
当前任务环节
binlog【宾-劳格】日志介绍:
- 也称做 二进制日志
- MySQL服务日志文件的一种
- 保存除查询之外的所有SQL命令m
- 可用于数据的备份和恢复
- 配置mysql主从同步的必要条件
- 准备新的数据库服务器如表-1,做binlog【宾-劳格】
| 主机名 | IP地址 | 说明 |
|---|---|---|
| mysql52 | 192.168.90.52 | 练习binlog【宾-劳格】日志 |
mysql52的IP配置和主机名
[root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.52/24 autoconnect【奥特欧 坑聂特】 yes#[root@slave2 ~]# nmcli connection modify ens160 ipv4.addresses 192.168.90.52/24 autoconnect yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160#[root@slave2 ~]# nmcli connection up ens160[root@mysql52 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql52#[root@slave2 ~]# hostnamectl set-hostname mysql523.1 查看正在使用的binlog【宾-劳格】日志文件
在新创建的数据库服务器做如下操作:
# 安装软件[root@mysql52 ~]# yum -y install【因-斯多】 mysql-server# [root@slave2 ~]# yum -y install mysql-server
# 启动服务[root@mysql52 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld# [root@slave2 ~]# systemctl status mysqld
# 连接服务[root@mysql52 ~]# mysql# [root@mysql52 ~]# mysql
# 查看日志文件mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】;# mysql> show master status;+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| binlog.000001 | 156 | | | |+----------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)
# 执行查询命令mysql> select【涩莱克特】 count【kàn特】(*) from【弗乱】 mysql.user;# mysql> select count(*) from mysql.user;+-------------------+| count【kàn特】(*) |+-------------------+| 4 |+-------------------+1 row in set (0.00 sec)
# 执行查询命令 日志偏移量不变mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】;# mysql> show master status;+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| binlog.000001 | 156 | | | |+----------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)
# 执行建库、建表命令mysql> create【克瑞特】 database【得塔-贝斯】 db1;# mysql> create database db1;Query OK, 1 row affected (0.07 sec)
mysql> create【克瑞特】 table【忒-部】 db1.user(name char【查尔】(10));# mysql> create table db1.user(name char(10));Query OK, 0 rows affected (0.52 sec)
# 执行写命令 日志偏移量改变mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】;# mysql> show master status;+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| binlog.000001 | 535 | | | |+----------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)
# 插入记录mysql> insert【因涩特】 into【因兔】 db1.user values【挖柳斯】("jim");# mysql> insert into db1.user values("jim");Query OK, 1 row affected (0.10 sec)
# 执行写命令 日志偏移量改变mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】;# mysql> show master status;+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| binlog.000001 | 809 | | | |+----------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)mysql>3.2 自定义日志目录和日志名
日志文件默认保存在/var/lib/mysql目录下,默认日志名binlog【宾-劳格】
[root@mysql52 ~]# vim /etc/my.cnf.d/mysql-server.cnf[mysqld]log-bin=/mylog/mysql52 #定义日志目录和日志文件名(手动添加):wq
[root@mysql52 ~]# mkdir【摸克跌儿】 /mylog 创建目录[root@mysql52 ~]# chown【吃-昂】 mysql /mylog 修改目录所有者mysql用户[root@mysql52 ~]# setenforce【赛特-因佛尔斯】 0 关闭selinux[root@mysql52 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld 重启服务[root@mysql52 ~]# ls /mylog/ 查看日志目录mysql52.000001 mysql52.index[root@mysql52 ~]# mysql 登陆服务
Mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】 ; 查看日志信息+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql52.000001 | 156 | | | |+----------------+----------+--------------+------------------+-------------------+3.3 手动创建新的日志文件
默认日志文件容量大于1G时会自动创建新的日志文件,在日志文件没写满时,执行的所有写命令都会保存到当前使用的日志文件里。
#刷新前查看mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】;+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql52.000001 | 156 | | | |+----------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)
mysql> flush【福 辣 徐】 logs【劳格斯】; #刷新日志Query OK, 0 rows affected (0.22 sec)
mysql> flush【福 辣 徐】 logs【劳格斯】; #刷新日志Query OK, 0 rows affected (0.16 sec)
mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】; #刷新一次创建一个新日志+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql52.000003 | 156 | | | |+----------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)
#只要服务重启就会创建新日志[root@mysql52 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld[root@mysql52 ~]# mysql 连接服务
Mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】; 查看日志+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql52.000004 | 156 | | | |+----------------+----------+--------------+------------------+-------------------+[root@mysql52 ~]#
#完全备份后创建新的日志文件,创建的日志个数和备份库的个数一致[root@mysql52 ~]# mysqldump【mysql-当普】 --flush【福 辣 徐】-logs【劳格斯】 mysql user > user.sql
[root@mysql52 ~]# mysql -e 'show【瘦】 master【马斯特】 status【 斯dèi 特斯】'+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql52.000005 | 156 | | | |+----------------+----------+--------------+------------------+-------------------+[root@mysql52 ~]# mysqldump【mysql-当普】 --flush【福 辣 徐】-logs【劳格斯】 -B mysql db1 > db_2.sql
[root@mysql52 ~]# mysql -e 'show【瘦】 master【马斯特】 status【 斯dèi 特斯】'+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql52.000007 | 156 | | | |+----------------+----------+--------------+------------------+-------------------+[root@mysql52 ~]#3.4 日志相关命令的使用
MySQL服务提供了管理日志的专属命令,具体练习如下:
#查看已有的日志文件mysql> show【瘦】 binary【拜讷瑞】 logs【劳格斯】;日志文件名 日志大小(字节) 加密(no/yes)+----------------+-----------+-----------+| Log_name | File_size | Encrypted |+----------------+-----------+-----------+| mysql52.000001 | 201 | No || mysql52.000002 | 201 | No || mysql52.000003 | 179 | No || mysql52.000004 | 201 | No || mysql52.000005 | 201 | No || mysql52.000006 | 201 | No || mysql52.000007 | 156 | No |+----------------+-----------+-----------+7 rows in set (0.00 sec)
#查看正在使用的日志mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】;+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql52.000007 | 156 | | | |+----------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)
#插入记录mysql> insert【因涩特】 into【因兔】 db1.user values【挖柳斯】("yaya");Query OK, 1 row affected (0.04 sec)
#查看日志文件内容mysql> show【瘦】 binlog【宾-劳格】 events【伊文茨】 in "mysql52.000007";Log_name: 日志文件名。Pos: 命令在日志文件中的起始位置。Event_type: 事件类型,例如 Query、Table_map、Write_rows 等。Server_id: 服务器 ID。End_log_pos:命令在文件中的结束位置,以字节为单位。Info:执行命令信息。+----------------+-----+----------------+-----------+-------------+--------------------------------------+| Log_name | Pos | Event_type | Server_id | End_log_pos | Info |+----------------+-----+----------------+-----------+-------------+--------------------------------------+| mysql52.000007 | 4 | Format_desc | 1 | 125 | Server ver: 8.0.26, Binlog ver: 4 || mysql52.000007 | 125 | Previous_gtids | 1 | 156 | || mysql52.000007 | 156 | Anonymous_Gtid | 1 | 235 | SET @@SESSION.GTID_NEXT= 'ANONYMOUS' || mysql52.000007 | 235 | Query | 1 | 306 | BEGIN || mysql52.000007 | 306 | Table_map | 1 | 359 | table_id: 108 (db1.user) || mysql52.000007 | 359 | Write_rows | 1 | 400 | table_id: 108 flags: STMT_END_F || mysql52.000007 | 400 | Xid | 1 | 431 | COMMIT /* xid=649 */ |+----------------+-----+----------------+-----------+-------------+--------------------------------------+7 rows in set (0.00 sec)
#删除日志文件名之前的所有日志文件mysql> purge【pò取】 master【马斯特】 logs【劳格斯】 to "mysql52.000004";Query OK, 0 rows affected (0.10 sec)
#查看已有的日志文件mysql> show【瘦】 binary【拜讷瑞】 logs【劳格斯】;+----------------+-----------+-----------+| Log_name | File_size | Encrypted |+----------------+-----------+-----------+| mysql52.000004 | 201 | No || mysql52.000005 | 201 | No || mysql52.000006 | 201 | No || mysql52.000007 | 431 | No |+----------------+-----------+-----------+4 rows in set (0.00 sec)
#删除所有日志文件,并重新创建日志文件mysql> reset【瑞 赛特】 master【马斯特】;Query OK, 0 rows affected (0.14 sec)
#查看已有的日志文件 ,仅有第1个文件了mysql> show【瘦】 binary【拜讷瑞】 logs【劳格斯】;+----------------+-----------+-----------+| Log_name | File_size | Encrypted |+----------------+-----------+-----------+| mysql52.000001 | 156 | No |+----------------+-----------+-----------+1 row in set (0.00 sec)3.5 使用日志恢复数据
把查看到的文件内容管道给连接mysql服务的命令执行
恢复数据命令:
mysqlbinlog【宾-劳格】 /目录/文件名 | mysql –uroot -p密码
1)在mysql52主机执行如下操:
#重置日志mysql> reset【瑞 赛特】 master【马斯特】;Query OK, 0 rows affected (0.09 sec)
#查看日志mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】;+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql52.000001 | 156 | | | |+----------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)
#建库、mysql> create【克瑞特】 database【得塔-贝斯】 gamedb;Query OK, 1 row affected (0.07 sec)
#建表mysql> create【克瑞特】 table【忒-部】 gamedb.t1(name char【查尔】(10),class【克拉斯】 char【查尔】(3));Query OK, 0 rows affected (0.55 sec)
#插入记录mysql> insert【因涩特】 into【因兔】 gamedb.t1 values【挖柳斯】 ("yaya","nsd");Query OK, 1 row affected (0.08 sec)
mysql> insert【因涩特】 into【因兔】 gamedb.t1 values【挖柳斯】 ("yaya","nsd");Query OK, 1 row affected (0.04 sec)
mysql> insert【因涩特】 into【因兔】 gamedb.t1 values【挖柳斯】 ("yaya","nsd");Query OK, 1 row affected (0.08 sec)
#查看表记录mysql> select【涩莱克特】 * from【弗乱】 gamedb.t1;+------+----------------+| name | class【克拉斯】 |+------+----------------+| yaya | nsd || yaya | nsd || yaya | nsd |+------+----------------+3 rows in set (0.00 sec)mysql> exit【诶西特】#把日志文件拷贝给恢复数据的服务器,比如 mysql50[root@mysql52 ~]# scp /mylog/mysql52.000001 root@192.168.90.50:/root/The authenticity of host '192.168.90.50 (192.168.90.50)' can't be established.ECDSA key fingerprint is SHA256:t7J3okFd0o+9zTmFCIetvDl6mxGCmc43VoD6C65zico.Are you sure you want to continue connecting (yes/no/[fingerprint])? Yes 同意Warning: Permanently added '192.168.90.50' (ECDSA) to the list of known hosts.root@192.168.90.50's password: mysql50的密码mysql52.000001 100% 1410 1.6MB/s 00:00[root@mysql52 ~]#2)在MySQL50 使用日志恢复数据
#查看日志[root@mysql50 ~]# ls /root/mysql52.000001/root/mysql52.000001
#执行日志恢复数据[root@mysql50 ~]# mysqlbinlog【mtsql宾-劳格】 /root/mysql52.000001 | mysql -uroot -pNSD123456...amysql: [Warning] Using a password on【昂】 the command line interface can be insecure.
#连接服务查看数据[root@mysql50 ~]# mysql -uroot -pNSD123456...a -e 'selectt【涩莱克特】 * from【弗乱】 gamedb.t1'mysql: [Warning] Using a password on【昂】 the command line interface can be insecure. +------+----------------+| name | class【克拉斯】 | +------+----------------+| yaya | nsd || yaya | nsd || yaya | nsd | +------+----------------+[root@mysql50 ~]#四、MySQL一主一从
当前任务环节
4.1 mysql主从复制原理
MySQL主从复制基于二进制日志(binlog【宾-劳格】)实现。主要分为三步: 首先,主库上执行更新操作时,会将变更记录到二进制日志日志里。 其次,从库的I/O线程会连接主库,请求主库发送二进制日志日志。主库的二进制日志转储线程将日志内容发送给从库I/O线程,I/O线程把接收的日志写入从库的中继日志(Relay Log)。 最后,从库的SQL线程读取中继日志中的事件,并在从库上重放,实现主从数据一致。
mysql主从复制原理
- 主库将数据变更(DDL和DML)记录到二进制日志(binlog)中。
- 从库的I/O线程向主库的log dump线程请求binlog。
- 主库的log dump线程将binlog事件发送给从库的I/O线程。
- 从库的I/O线程将接收到的事件写入中继日志(relay log)。
- 从库的SQL线程读取并解析relay log中的事件,在从库上执行这些事件,从而使从库与主库的数据保持同步。
准备两台服务器
| 主机名 | IP地址 | 说明 |
|---|---|---|
| mysql53 | 192.168.90.53 | master【马斯特】数据库 |
| mysql54 | 192.168.90.54 | slave【斯累夫】数据库 |
mysql53的IP配置和主机名
[root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.53/24 autoconnect【奥特欧 坑聂特】 yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160[root@mysql53 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql53mysql54的IP配置和主机名
[root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.54/24 autoconnect【奥特欧 坑聂特】 yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160[root@mysql54 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql544.2 配置为主数据库服务器
数据库服务器192.168.90.53配置为主数据库服务器
1)启用binlog【宾-劳格】日志
[root@mysql53 ~]# yum -y install【因-斯多】 mysql-server mysql[root@mysql53 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld[root@mysql53 ~]# vim /etc/my.cnf.d/mysql-server.cnf[mysqld]server-id=53log-bin=mysql53:wq[root@mysql53 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld2)用户授权
[root@mysql53 ~]# mysql
mysql> create【克瑞特】 user repluser@"%" identified【爱-丹-提伐】 WITH【威付】 mysql_native_password by "123qqq...A";Query OK, 0 rows affected (0.11 sec)
mysql> grant【古亮普】 replication【瑞普利K申】 slave【斯累夫】 on【昂】 *.* to repluser@"%";Query OK, 0 rows affected (0.09 sec)3)查看日志信息
mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】;+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql53.000001 | 667 | | | |+----------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)4.3 配置为从数据库服务
数据库服务器192.168.90.54配置为从数据库服务
1)指定server-id 并重启数据库服务
[root@mysql54 ~]# yum -y install【因-斯多】 mysql-server mysql[root@mysql54 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld[root@mysql54 ~]# vim /etc/my.cnf.d/mysql-server.cnf[mysqld]server-id=54:wq[root@mysql54 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld2)登陆服务指定主服务器信息
[root@mysql54 ~]# mysqlmysql> change【趁(chèn)吉】 master【马斯特】 to master【马斯特】_host="192.168.90.53" , master【马斯特】_user="repluser" , master【马斯特】_password="123qqq...A" ,master【马斯特】_log_file="mysql53.000001" , master【马斯特】_log_pos=667;Query OK, 0 rows affected, 8 warnings (0.34 sec)
mysql> start【s 达儿】 slave【斯累夫】 ; #启动slave【斯累夫】进程Query OK, 0 rows affected, 1 warning (0.04 sec)
mysql> show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】 \G #查看状态信息*************************** 1. row *************************** Slave【斯累夫】_IO_State: Waiting for source to send event master【马斯特】_Host: 192.168.90.53 master【马斯特】_User: repluser master【马斯特】_Port: 3306 Connect_Retry: 60 master【马斯特】_Log_File: mysql53.000001 Read_master【马斯特】_Log_Pos: 667 Relay_Log_File: mysql54-relay-bin.000002 Relay_Log_Pos: 322 Relay_master【马斯特】_Log_File: mysql53.000001 Slave【斯累夫】_IO_Running: Yes #IO线程 Slave【斯累夫】_SQL_Running: Yes #SQL线程 Replicate_Do_DB: Replicate_Ignore_DB: Replicate_Do_Table: Replicate_Ignore_Table: Replicate_Wild_Do_Table: Replicate_Wild_Ignore_Table: Last_Errno: 0 Last_Error: Skip_Counter: 0 Exec_master【马斯特】_Log_Pos: 667 Relay_Log_Space: 533 Until_Condition: None Until_Log_File: Until_Log_Pos: 0 master【马斯特】_SSL_Allowed: No master【马斯特】_SSL_CA_File: master【马斯特】_SSL_CA_Path: master【马斯特】_SSL_Cert: master【马斯特】_SSL_Cipher: master【马斯特】_SSL_Key: Seconds_Behind_master【马斯特】: 0master【马斯特】_SSL_Verify_Server_Cert: No Last_IO_Errno: 0 Last_IO_Error: Last_SQL_Errno: 0 Last_SQL_Error: Replicate_Ignore_Server_Ids: master【马斯特】_Server_Id: 53 master【马斯特】_UUID: 38c02165-005e-11ee-bd2d-525400007271 master【马斯特】_Info_File: mysql.slave【斯累夫】_master【马斯特】_info SQL_Delay: 0 SQL_Remaining_Delay: NULL Slave【斯累夫】_SQL_Running_State: Replica has read all【ò】 relay log; waiting for more updates master【马斯特】_Retry_Count: 86400 master【马斯特】_Bind: Last_IO_Error_Timestamp: Last_SQL_Error_Timestamp: master【马斯特】_SSL_Crl: master【马斯特】_SSL_Crlpath: Retrieved_Gtid_Set: Executed_Gtid_Set: Auto_Position: 0 Replicate_Rewrite_DB: Channel_Name: master【马斯特】_TLS_Version: master【马斯特】_public_key_path: Get_master【马斯特】_public_key: 0 Network_Namespace:1 row in set, 1 warning (0.00 sec)mysql>4.4 客户端192.168.90.50测试配置
1)在主服务器添加用户,给客户端连接使用
[root@mysql53 ~]# mysqlmysql> create【克瑞特】 user jam@"%" identified【爱-丹-提伐】 by "123456";Query OK, 0 rows affected (0.14 sec)
mysql> grant【古亮普】 all【ò】 on【昂】 gamedb.* to jam@"%" ;Query OK, 0 rows affected (0.12 sec)mysql>2)客户端连接主服务器存储数据
[root@mysql50 ~]# mysql -h192.168.90.53 -ujam -p123456mysql> create【克瑞特】 database【得塔-贝斯】 gamedb;Query OK, 1 row affected (0.24 sec)
mysql> create【克瑞特】 table【忒-部】 gamedb.user(name char【查尔】(10) , class【克拉斯】 char【查尔】(3));Query OK, 0 rows affected (1.71 sec)
mysql> insert【因涩特】 into【因兔】 gamedb.user values【挖柳斯】 ("yaya","nsd");Query OK, 1 row affected (0.14 sec)
mysql> select【涩莱克特】 * from【弗乱】 gamedb.user;+------+-------+| name | class【克拉斯】 |+------+-------+| yaya | nsd |+------+-------+1 row in set (0.01 sec)mysql>3)客户端连接从服务器查看数据
-e 命令行下执行数据库命令
[root@mysql50 ~]# mysql -h192.168.90.54 -ujam -p123456 –e ‘select【涩莱克特】 * from【弗乱】 gamedb.user’+------+-------+| name | class【克拉斯】 |+------+-------+| yaya | nsd |+------+-------+[root@mysql54 ~]#五、配置一主多从结构
当前任务环节
准备新的服务器
| 主机名 | IP地址 | 说明 |
|---|---|---|
| mysql55 | 192.168.90.55 | 从数据库 |
mysql55的IP配置和主机名
[root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.55/24 autoconnect【奥特欧 坑聂特】 yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160[root@mysql55 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql55
5.1 配置192.168.90.55从服务器
1)指定MySQL55主机的server-id 并重启数据库服务
root@mysql55 ~]# yum -y install【因-斯多】 mysql-server[root@mysql55 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld[root@mysql55 ~]# vim /etc/my.cnf.d/mysql-server.cnf[mysqld]server-id=55:wq[root@mysql55 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld2)确保与主服务器数据一致。
#在mysql53执行备份命令前查看日志名和偏移量 ,mysql55 在当前查看到的位置同步数据[root@mysql53 ~]# mysql -e 'show【瘦】 master【马斯特】 status【 斯dèi 特斯】'+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql53.000002 | 156 | | | |+----------------+----------+--------------+------------------+-------------------+[root@mysql53 ~]#
#在主服务器存做完全备份[root@mysql53 ~]# mysqldump【mysql-当普】 -B gamedb > /root/gamedb.sql
#主服务器把备份文件拷贝给从服务器mysql55[root@mysql53 ~]# scp /root/gamedb.sql root@192.168.90.55:/root/[root@mysql55 ~]# mysql < /root/gamedb.sql3)在MySQL55主机指定主服务器信息
[root@mysql55 ~]# mysql
mysql> change【趁(chèn)吉】 master【马斯特】 to master【马斯特】_host="192.168.90.53" , master【马斯特】_user="repluser" , master【马斯特】_password="123qqq...A" , master【马斯特】_log_file="mysql53.000002" , master【马斯特】_log_pos=156;Query OK, 0 rows affected, 8 warnings (0.44 sec)
注意:日志名和偏移量 要写 在mysql53主机执行完全备份之前查看到的日志名和偏移量
mysql> start【s 达儿】 slave【斯累夫】; #启动slave【斯累夫】进程Query OK, 0 rows affected, 1 warning (0.02 sec)
#查看状态信息mysql> show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】 \G*************************** 1. row *************************** Slave【斯累夫】_IO_State: Waiting for source to send event master【马斯特】_Host: 192.168.90.53 master【马斯特】_User: repluser master【马斯特】_Port: 3306 Connect_Retry: 60 master【马斯特】_Log_File: mysql53.000002 Read_master【马斯特】_Log_Pos: 156 Relay_Log_File: mysql55-relay-bin.000002 Relay_Log_Pos: 322 Relay_master【马斯特】_Log_File: mysql53.000002 Slave【斯累夫】_IO_Running: Yes #正常 Slave【斯累夫】_SQL_Running: Yes #正常 Replicate_Do_DB: Replicate_Ignore_DB: Replicate_Do_Table: Replicate_Ignore_Table: Replicate_Wild_Do_Table: Replicate_Wild_Ignore_Table: Last_Errno: 0 Last_Error: Skip_Counter: 0 Exec_master【马斯特】_Log_Pos: 156 Relay_Log_Space: 533 Until_Condition: None Until_Log_File: Until_Log_Pos: 0 master【马斯特】_SSL_Allowed: No master【马斯特】_SSL_CA_File: master【马斯特】_SSL_CA_Path: master【马斯特】_SSL_Cert: master【马斯特】_SSL_Cipher: master【马斯特】_SSL_Key: Seconds_Behind_master【马斯特】: 0master【马斯特】_SSL_Verify_Server_Cert: No Last_IO_Errno: 0 Last_IO_Error: Last_SQL_Errno: 0 Last_SQL_Error: Replicate_Ignore_Server_Ids: master【马斯特】_Server_Id: 53 master【马斯特】_UUID: 38c02165-005e-11ee-bd2d-525400007271 master【马斯特】_Info_File: mysql.slave【斯累夫】_master【马斯特】_info SQL_Delay: 0 SQL_Remaining_Delay: NULL Slave【斯累夫】_SQL_Running_State: Replica has read all【ò】 relay log; waiting for more updates master【马斯特】_Retry_Count: 86400 master【马斯特】_Bind: Last_IO_Error_Timestamp: Last_SQL_Error_Timestamp: master【马斯特】_SSL_Crl: master【马斯特】_SSL_Crlpath: Retrieved_Gtid_Set: Executed_Gtid_Set: Auto_Position: 0 Replicate_Rewrite_DB: Channel_Name: master【马斯特】_TLS_Version: master【马斯特】_public_key_path: Get_master【马斯特】_public_key: 0 Network_Namespace:1 row in set, 1 warning (0.00 sec)
#添加客户端访问时使用的用户mysql> create【克瑞特】 user jam@"%" identified【爱-丹-提伐】 by "123456";Query OK, 0 rows affected (0.08 sec)
mysql> grant【古亮普】 all【ò】 on【昂】 gamedb.* to jam@"%" ;Query OK, 0 rows affected (0.04 sec)Mysql>5.2 客户端测试配置
1)在mysql50 连接主服务器mysql53 存储数据
#连接主服务器存储数据[root@mysql50 ~]# mysql -h192.168.90.53 -ujam -p123456
mysql> insert【因涩特】 into【因兔】 gamedb.user values【挖柳斯】("tt","aid");Query OK, 1 row affected (0.14 sec)
mysql> insert【因涩特】 into【因兔】 gamedb.user values【挖柳斯】("mm","uid");Query OK, 1 row affected (0.13 sec)2)在client50 分别连接2个从服务器查看数据
#连接从服务器54查看数据[root@mysql50 ~]# mysql -h192.168.90.54 -ujam -p123456 -e 'select【涩莱克特】 * from【弗乱】 gamedb.user'mysql: [Warning] Using a password on【昂】 the command line interface can be insecure.+------+-------+| name | class【克拉斯】 |+------+-------+| yaya | nsd || tt | aid || mm | uid |+------+-------+
#连接从服务器55查看数据[root@mysql50 ~]# mysql -h192.168.90.55 -ujam -p123456 -e 'select【涩莱克特】 * from【弗乱】 gamedb.user'mysql: [Warning] Using a password on【昂】 the command line interface can be insecure.+------+-------+| name | class【克拉斯】 |+------+-------+| yaya | nsd || tt | aid || mm | uid |+------+-------+[root@mysql50 ~]#
#我 : 按照上面的方法设置主从同步,之后新加的数据会同步从库,那要是在设置主从之前的数据呢?也会同步吗?
#Doubao : 在设置 MySQL 主从同步时,设置同步之前主库已存在的数据是否会同步到从库,取决于具体的配置和操作步骤,下面为你详细分析不同情况:
设置主从同步之前的数据不会自动同步
如果只是简单地配置主从同步的连接信息(如设置从库的 CHANGE MASTER TO 语句),而没有做额外的数据初始化操作,那么设置主从同步之前主库上已存在的数据不会自动同步到从库。这是因为主从同步是基于二进制日志(binlog)来记录和同步主库上的更改操作,在配置主从同步时,从库会从指定的二进制日志文件和位置开始读取并应用主库的更改,而设置之前的历史数据并没有被包含在这个起始点之后的二进制日志中。
可以通过特定操作实现同步
为了让设置主从同步之前主库上的数据也能同步到从库,可以采取以下常见方法:
1. 使用 mysqldump 备份和恢复
- 步骤:
- 在主库上锁定表并进行备份:为了保证数据的一致性,在备份过程中需要锁定主库上的表,防止数据被修改。
# 登录主库,锁定所有表mysql -u root -p -e "FLUSH TABLES WITH READ LOCK;"# 记录当前二进制日志文件和位置mysql -u root -p -e "SHOW MASTER STATUS;"# 使用 mysqldump 备份主库数据mysqldump -u root -p --all-databases > master_backup.sql# 解锁主库上的表mysql -u root -p -e "UNLOCK TABLES;"2. **将备份文件传输到从库**:可以使用 `scp` 等工具将备份文件从主库复制到从库。scp master_backup.sql user@slave_ip:/path/to/destination3. **在从库上恢复备份数据**:登录从库,执行备份文件中的 SQL 语句。mysql -u root -p < master_backup.sql4. **配置从库连接主库**:使用之前记录的二进制日志文件和位置,配置从库连接主库。CHANGE MASTER TO MASTER_HOST='master_ip', MASTER_USER='replication_user', MASTER_PASSWORD='replication_password', MASTER_LOG_FILE='binlog_file_name', MASTER_LOG_POS=binlog_position;START SLAVE;2. 使用 rsync 复制数据文件(适用于 InnoDB 存储引擎)
- 步骤:
- 停止主库和从库的 MySQL 服务:为了避免数据冲突,需要先停止主库和从库的 MySQL 服务。
systemctl stop mysql2. **使用 `rsync` 复制主库的数据文件到从库**:确保主库和从库的数据目录结构一致。rsync -avz /var/lib/mysql/ user@slave_ip:/var/lib/mysql/3. **启动从库的 MySQL 服务**:启动从库的 MySQL 服务,并配置从库连接主库。systemctl start mysqlCHANGE MASTER TO MASTER_HOST='master_ip', MASTER_USER='replication_user', MASTER_PASSWORD='replication_password', MASTER_LOG_FILE='binlog_file_name', MASTER_LOG_POS=binlog_position;START SLAVE;通过以上方法,可以将设置主从同步之前主库上的数据同步到从库,实现主从库数据的一致性。
异步复制、半同步复制、完全同步复制
#我 : MySQL 主从复制采用异步复制是什么?有同步复制吗?区别和优缺点是什么?
#Doubao :
MySQL 主从复制中的异步复制
概念
在 MySQL 主从复制的异步复制模式下,主库在执行完客户端提交的事务后,会立即将结果返回给客户端,而不会等待从库接收并处理该事务的二进制日志(binlog)。主库会将事务的变更记录到二进制日志中,然后异步地将这些日志发送给从库,从库会在自己的线程中独立地接收和应用这些日志。
示例代码配置
-- 在主库上创建用于复制的用户CREATE USER 'repl_user'@'%' IDENTIFIED BY 'password';GRANT REPLICATION SLAVE ON *.* TO 'repl_user'@'%';FLUSH PRIVILEGES;
-- 查看主库的二进制日志信息SHOW MASTER STATUS;
-- 在从库上配置主从复制CHANGE MASTER TO MASTER_HOST='master_ip', MASTER_USER='repl_user', MASTER_PASSWORD='password', MASTER_LOG_FILE='master_binlog_file_name', MASTER_LOG_POS=master_binlog_position;
START SLAVE;MySQL 中的同步复制
概念
严格意义上,MySQL 原生的复制模式默认是异步复制,但 MySQL 也提供了半同步复制(Semi-synchronous Replication),可以看作是一种介于异步和完全同步之间的模式。在半同步复制中,主库在提交事务后,会等待至少一个从库确认已经接收到该事务的二进制日志后,才会向客户端返回操作成功的信息。
示例代码配置
-- 在主库和从库上都要安装半同步复制插件INSTALL PLUGIN rpl_semi_sync_master SONAME 'semisync_master.so';INSTALL PLUGIN rpl_semi_sync_slave SONAME 'semisync_slave.so';
-- 在主库上启用半同步复制SET GLOBAL rpl_semi_sync_master_enabled = 1;SET GLOBAL rpl_semi_sync_master_timeout = 10000; -- 设置超时时间
-- 在从库上启用半同步复制SET GLOBAL rpl_semi_sync_slave_enabled = 1;
-- 重启从库的复制线程STOP SLAVE IO_THREAD;START SLAVE IO_THREAD;区别
数据一致性
- 异步复制:主库和从库之间存在一定的数据延迟,因为主库不会等待从库接收和应用事务。在主库发生故障时,从库可能没有完全同步主库的最新数据。
- 半同步复制:在一定程度上保证了数据的一致性,因为主库会等待至少一个从库确认接收事务。但如果所有从库都出现问题,主库会在超时后自动切换回异步复制模式。
性能影响
- 异步复制:对主库的性能影响较小,因为主库不需要等待从库的响应,可以立即返回结果给客户端。
- 半同步复制:会对主库的性能产生一定的影响,因为主库需要等待从库的确认信息,增加了事务的提交时间。
优缺点
异步复制
- 优点:
- 性能高,主库可以快速响应客户端请求,不会因为从库的性能问题而受到影响。
- 配置简单,是 MySQL 默认的复制模式,不需要额外的插件和复杂的配置。
- 缺点:
- 数据一致性较差,在主库故障时可能会导致数据丢失。
半同步复制
- 优点:
- 提高了数据的一致性,减少了主库故障时数据丢失的风险。
- 缺点:
- 性能相对较低,因为主库需要等待从库的确认信息。
- 配置相对复杂,需要安装和启用半同步复制插件。
完全同步复制
除了半同步复制,还有一些第三方解决方案可以实现完全同步复制,即主库必须等待所有从库都成功应用事务后才会提交。但这种方式会对性能产生极大的影响,实际应用中较少使用。
binlog 的三种格式
| 格式 | 记录内容 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| **STATEMENT (SBR)** | 记录造成数据变更的SQL语句本身 | 日志量小,节省磁盘和网络I/O;易于查看和审计 | 可能引起主从不一致(如使用NOW(), UUID()等非确定性函数时) | 数据结构简单、SQL模式固定、更新量大但涉及行少的场景 |
| **ROW (RBR)** | 记录每一行数据如何被修改(如修改前/后的镜像) | 数据安全性和一致性最高,可可靠地复制任何变更 | 日志量可能非常大(特别是批量更新或表结构变更时) | 对数据一致性要求极高的场景(如金融业务),或使用了可能引起不一致的函数/存储过程时 |
| **MIXED (MBR)** | 智能混合使用STATEMENT和ROW模式 | 在安全性和性能间取得平衡;多数情况下日志量小,特定情况下自动转为ROW模式以保证安全 | 仍存在极小概率在混合模式下出现不一致 | 希望兼顾性能和数据安全性的通用业务场景,MySQL 5.7.7及以上版本默认采用此格式 |
#我 : . 列举 MySQL 主从复制中 binlog 的三种格式,并说明各自特点。
#Doubao :
在 MySQL 主从复制中,binlog(二进制日志)有三种格式,分别是 STATEMENT(语句级)、ROW(行级)和 MIXED(混合级),以下是它们各自的特点:
1. STATEMENT(语句级)
- 特点
- 日志记录方式:记录的是主库上执行的 SQL 语句。也就是说,主库在执行一条 SQL 语句后,会将该语句本身记录到 binlog 中,从库在复制时,会重新执行这些 SQL 语句来达到与主库数据一致的目的。
- 优点
- 日志量小:由于只记录 SQL 语句,相比于记录每行数据变化的 ROW 格式,日志量通常要小很多,这可以减少磁盘 I/O 和网络传输的压力,同时也能节省存储空间。
- 可读性高:SQL 语句本身是人类可读的,因此查看和分析 binlog 内容相对容易,便于进行故障排查和审计。
- 缺点
- 部分语句复制可能存在问题:一些依赖于主库当前环境的 SQL 语句,如
NOW()、UUID()等函数,在主从库上执行时可能会产生不同的结果,因为主从库的系统时间、随机数种子等可能不同。此外,一些存储过程、触发器等也可能因为主从库环境差异而导致复制不一致。 - 并发复制性能受限:在高并发场景下,由于从库需要重新执行 SQL 语句,可能会受到锁和并发控制的影响,导致复制性能下降。
- 部分语句复制可能存在问题:一些依赖于主库当前环境的 SQL 语句,如
2. ROW(行级)
- 特点
- 日志记录方式:记录的是每行数据的变化情况,即哪些行被插入、更新或删除,以及具体的变更内容。而不是像 STATEMENT 格式那样记录 SQL 语句。
- 优点
- 复制一致性高:由于记录的是实际的数据变更,不依赖于 SQL 语句的执行环境,因此可以保证主从库数据的高度一致性,避免了 STATEMENT 格式中因环境差异导致的复制问题。
- 并发复制性能好:从库可以并行地应用这些行级变更,而不需要像执行 SQL 语句那样考虑锁和并发控制,因此在高并发场景下,复制性能通常比 STATEMENT 格式要好。
- 缺点
- 日志量大:需要记录每行数据的变化,对于大规模的数据更新操作,日志量会非常大,这会增加磁盘 I/O 和网络传输的负担,同时也需要更多的存储空间。
- 可读性差:由于记录的是数据行的变化,而不是 SQL 语句,因此 binlog 的内容难以直接阅读和理解,不利于故障排查和审计。
3. MIXED(混合级)
- 特点
- 日志记录方式:结合了 STATEMENT 和 ROW 两种格式的优点。MySQL 会根据具体的 SQL 语句和执行情况,自动选择使用 STATEMENT 格式还是 ROW 格式来记录 binlog。
- 优点
- 灵活性高:对于大多数普通的 SQL 语句,会使用 STATEMENT 格式记录,以减少日志量;而对于那些可能导致复制不一致的 SQL 语句,如包含不确定函数的语句,则会使用 ROW 格式记录,以保证复制的一致性。
- 性能和一致性的平衡:在保证复制一致性的同时,尽可能地减少日志量,提高复制性能和效率。
- 缺点
- 难以预测日志格式:由于是自动选择日志格式,在某些情况下可能会让人难以预测具体使用的是哪种格式,增加了故障排查和管理的难度。
可以通过以下命令来查看和设置 binlog 的格式:
-- 查看当前 binlog 格式SHOW VARIABLES LIKE 'binlog_format';
-- 设置 binlog 格式为 STATEMENTSET GLOBAL binlog_format = 'STATEMENT';-- 设置 binlog 格式为 ROWSET GLOBAL binlog_format = 'ROW';-- 设置 binlog 格式为 MIXEDSET GLOBAL binlog_format = 'MIXED';需要注意的是,设置全局变量后,新的设置只会对新建立的会话生效,对于已经存在的会话,需要重新连接才能应用新的设置。
主库宕机如何保证业务
#我 : 主从复制中,若主库宕机,应如何进行故障切换以保证业务继续运行?
#Doubao : 在 MySQL 主从复制架构中,当主库宕机时,为了保证业务能够继续运行,需要进行故障切换。以下是详细的故障切换步骤和方法:
1. 确认主库宕机
首先要通过监控系统、日志或者手动检查等方式,确认主库确实已经无法正常工作。例如,可以尝试连接主库,查看是否能够正常响应查询请求;查看主库的系统日志和 MySQL 日志,确认是否有异常信息。
2. 选择新的主库
从多个从库中选择一个合适的从库作为新的主库,通常会考虑以下因素:
- 数据同步情况:选择与原主库数据最接近同步的从库,以减少数据丢失。可以通过查看从库的
SHOW SLAVE STATUS命令输出,比较Seconds_Behind_Master的值,选择该值最小的从库。 - 硬件资源:选择硬件配置较好、性能较高的从库,以确保新主库能够稳定运行。
3. 停止从库复制
在将选定的从库提升为新主库之前,需要先停止该从库的复制进程,避免后续出现数据冲突。在选定的从库上执行以下命令:
STOP SLAVE;4. 提升从库为新主库
将选定的从库设置为独立的主库,需要重置二进制日志和中继日志。在选定的从库上执行以下命令:
RESET MASTER;5. 配置其他从库指向新主库
将其他从库配置为连接到新的主库,继续进行复制。在每个从库上执行以下命令:
-- 停止当前的复制进程STOP SLAVE;-- 配置新主库的连接信息CHANGE MASTER TO MASTER_HOST='新主库的 IP 地址', MASTER_USER='复制用户', MASTER_PASSWORD='复制用户密码', MASTER_LOG_FILE='新主库当前的二进制日志文件名', MASTER_LOG_POS=新主库当前的二进制日志位置;-- 启动复制进程START SLAVE;可以通过 SHOW SLAVE STATUS 命令检查复制是否正常工作,确保 Slave_IO_Running 和 Slave_SQL_Running 都为 Yes。
6. 更新应用程序配置
将应用程序连接的数据库地址从原主库更新为新主库的地址,确保应用程序能够正常连接到新的主库。这可能需要修改应用程序的配置文件,并重新启动应用程序。
7. 恢复原主库
在故障切换完成后,可以对原主库进行故障排查和修复。修复完成后,将原主库配置为新主库的从库,继续进行复制。在原主库上执行以下命令:
-- 停止当前的复制进程STOP SLAVE;-- 重置二进制日志和中继日志RESET SLAVE ALL;-- 配置新主库的连接信息CHANGE MASTER TO MASTER_HOST='新主库的 IP 地址', MASTER_USER='复制用户', MASTER_PASSWORD='复制用户密码', MASTER_LOG_FILE='新主库当前的二进制日志文件名', MASTER_LOG_POS=新主库当前的二进制日志位置;-- 启动复制进程START SLAVE;自动化故障切换
为了提高故障切换的效率和准确性,可以使用一些自动化工具来实现故障切换,例如 MHA(Master High Availability)、PXC(Percona XtraDB Cluster)等。这些工具可以自动检测主库的故障,并在主库宕机时自动进行故障切换,减少人工干预的时间和错误。
[root@master /]# cat /usr/local/mysql/my.cnf[mysqld]basedir=/usr/local/mysql # MySQL安装目录datadir=/usr/local/mysql/data # 数据文件存储目录socket=/tmp/mysql.sock # 本地连接使用的socket文件port=3306 # 服务监听端口log_error=/usr/local/mysql/data/master.err # 指定错误日志文件的路径。错误日志记录了MySQL启动、运行和停止过程中的错误信息。log_bin=/usr/local/mysql/data/binlog # 指定二进制日志(binlog)文件的基本路径和名称。二进制日志记录了所有更改数据的SQL语句(或数据变更),用于主从复制和数据恢复。server_id=10 # 设置服务器的唯一标识符,在主从复制拓扑中,每个服务器必须有一个唯一的server_id。character_set_server=utf8mb4 # 设置服务器默认的字符集为utf8mb4,它支持更广泛的Unicode字符(如emoji表情)gtid_mode=on # 启用全局事务标识符(GTID)模式。GTID为每个事务分配一个全局唯一的标识符,简化了主从复制的管理log_slave_updates=1 # 允许从库将其从主库接收到的更新记录到自己的二进制日志中。这通常用于链式复制(例如,A->B->C)或备份从库enforce_gtid_consistency # 强制GTID一致性,确保只有能够安全记录GTID的事务才会被执行。这有助于保证复制的可靠性。# 复制核心参数log_bin=/usr/local/mysql/data/binlogrelay_log=/usr/local/mysql/data/relaylogserver_id=20#字符集character_set_server=utf8mb4# 可靠性参数relay_log_recovery = ONmaster_info_repository = TABLErelay_log_info_repository = TABLE#设置从库只读read_only=1#我 : 检查下面作业是否有问题
六、作业
选择题
- 在 MySQL 主从复制中,主服务器记录数据变更的二进制日志文件是( A )。 A. binlog B. relay-bin C. binlog.index D. relay-bin.log
- 若要开启 MySQL 主从复制,主从服务器的以下哪个参数必须不同( A )。 A. server-id B. log-bin C. sync-binlog D. relay-log
- MySQL 主从复制中,从服务器将接收到的主服务器 binlog 日志写入的文件是( B )。 A. binlog B. relay log C. binlog.index D. relay-bin.log
- 主从复制中,主库执行写操作后,以下哪个线程负责把 binlog 的内容发送到从库( A )。 A. binlog dump thread B. I/O 线程 C. SQL 线程 D. log dump 线程
- MySQL 主从复制采用异步复制时,可能出现的问题是( A )。 A. 数据丢失 B. 性能严重下降 C. 无法实现复制 D. 主从服务器无法连接
简答题
-
简述 MySQL 主从复制的基本原理。 答:
- 主库将数据变更(DDL和DML)记录到二进制日志(binlog)中。
- 从库的I/O线程向主库的binlog dump线程请求binlog。
- 主库的binlog dump线程将binlog事件发送给从库的I/O线程。
- 从库的I/O线程将接收到的事件写入中继日志(relay log)。
- 从库的SQL线程读取并解析relay log中的事件,在从库上执行这些事件,从而使从库与主库的数据保持同步。
-
列举 MySQL 主从复制中 binlog 的三种格式,并说明各自特点。 答: binlog的三种格式,
STATEMENT(语句级)、ROW(行级)和MIXED(混合级)STATEMENT(语句级):日志量小、可读性高ROW(行级):复制一致性高、并发复制性能好MIXED(混合级):灵活性高、性能和一致性的平衡 -
主从复制中,若主库宕机,应如何进行故障切换以保证业务继续运行? 答: 1、确认主库宕机之后,第一时间选择一个从库作为新主库以承接服务 2、停止新主库上的从库配置改为主库,同事配置其它从库指向新主库 3、更新业务服务的数据库配置指向新主库
操作题
- 请详细描述搭建一主一从 MySQL 主从复制环境的步骤,包括主从服务器的配置、用户创建、同步启动等。
# 清理mariadb[root@master ~]# rpm -qa | grep mariadb | xargs rpm -e --nodeps# 基本环境安装[root@master ~]# yum install -y libaio-devel numactl wget# 下载安装官方源[root@master ~]# wget https://dev.mysql.com/get/mysql80-community-release-el7-3.noarch.rpm[root@master ~]# rpm -ivh mysql80-community-release-el7-3.noarch.rpm# 下载并导入 MySQL 官方 GPG 密钥[root@master ~]# rpm --import https://repo.mysql.com/RPM-GPG-KEY-mysql-2023[root@master ~]# yum repolist enabled | grep mysqlmysql-connectors-community/x86_64 MySQL Connectors Community 293mysql-tools-community/x86_64 MySQL Tools Community 118mysql80-community/x86_64 MySQL 8.0 Community Server 598[root@master ~]#
# 主从安装mysql服务[root@master ~]# yum install -y mysql-community-serverLoaded plugins: fastestmirrorLoading mirror speeds from cached hostfileResolving Dependencies--> Running transaction check---> Package mysql-community-server.x86_64 0:8.0.44-1.el7 will be installed--> Processing Dependency: mysql-community-common(x86-64) = 8.0.44-1.el7 for package: mysql-community-server-8.0.44-1.el7.x86_64--> Processing Dependency: mysql-community-icu-data-files = 8.0.44-1.el7 for package: mysql-community-server-8.0.44-1.el7.x86_64--> Processing Dependency: mysql-community-client(x86-64) >= 8.0.11 for package: mysql-community-server-8.0.44-1.el7.x86_64
# 配置主库,指定server_id和开启binlog日记[root@master ~]# grep -vE "#" /etc/my.cnf[mysqld]datadir=/var/lib/mysqlsocket=/var/lib/mysql/mysql.sock
log-error=/var/log/mysqld.logpid-file=/var/run/mysqld/mysqld.pid
server_id=10log_bin=/var/lib/mysql/binlog
#启动和添加开机启动mysql服务[root@master /]# systemctl enable mysqld[root@master /]# systemctl status mysqld
[root@master /]# mysql -uroot -p........# 第一次登陆需先修改默认密码mysql> alter user 'root'@'localhost' IDENTIFIED BY 'mysql123!';Query OK, 0 rows affected (0.01 sec)
# 创建用户同步的repluser账号密码replusermysql> create user repluser@"%" identified WITH mysql_native_password by "repluser";Query OK, 0 rows affected (0.09 sec)# 给repluser用户赋权mysql> grant replication slave on *.* to repluser@"%";Query OK, 0 rows affected (0.05 sec)# 查询binlog名称和偏移量mysql> show master status;+---------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+---------------+----------+--------------+------------------+-------------------+| binlog.000002 | 1307 | | | |+---------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)
# 从库安装mysql服务# 清理mariadb[root@slave1 ~]# rpm -qa | grep mariadb | xargs rpm -e --nodeps# 基本环境安装[root@slave1 ~]# yum install -y libaio-devel numactl wget# 下载安装官方源[root@slave1 ~]# wget https://dev.mysql.com/get/mysql80-community-release-el7-3.noarch.rpm[root@slave1 ~]# rpm -ivh mysql80-community-release-el7-3.noarch.rpm# 下载并导入 MySQL 官方 GPG 密钥[root@slave1 ~]# rpm --import https://repo.mysql.com/RPM-GPG-KEY-mysql-2023[root@slave1 ~]# yum repolist enabled | grep mysqlmysql-connectors-community/x86_64 MySQL Connectors Community 293mysql-tools-community/x86_64 MySQL Tools Community 118mysql80-community/x86_64 MySQL 8.0 Community Server 598[root@slave1 ~]#
# 主从安装mysql服务[root@slave1 ~]# yum install -y mysql-community-serverLoaded plugins: fastestmirrorLoading mirror speeds from cached hostfileResolving Dependencies--> Running transaction check---> Package mysql-community-server.x86_64 0:8.0.44-1.el7 will be installed--> Processing Dependency: mysql-community-common(x86-64) = 8.0.44-1.el7 for package: mysql-community-server-8.0.44-1.el7.x86_64--> Processing Dependency: mysql-community-icu-data-files = 8.0.44-1.el7 for package: mysql-community-server-8.0.44-1.el7.x86_64--> Processing Dependency: mysql-community-client(x86-64) >= 8.0.11 for package: mysql-community-server-8.0.44-1.el7.x86_64
# 配置从库,指定server_id和开启binlog日记[root@slave1 ~]# vim /etc/my.cnf[root@slave1 ~]# grep -vE "#" /etc/my.cnf
[mysqld]
datadir=/var/lib/mysqlsocket=/var/lib/mysql/mysql.sock
log-error=/var/log/mysqld.logpid-file=/var/run/mysqld/mysqld.pid
server_id=20log_bin=/var/lib/mysql/binlogrelay_log=/var/lib/mysql/relaylog
[root@slave1 ~]# systemctl enable mysqld[root@slave1 ~]# systemctl start mysqld
# 从库配置# 修改默认密码mysql> alter user 'root'@'localhost' IDENTIFIED BY 'Mysql123!';Query OK, 0 rows affected (0.01 sec)
# 配置 MySQL 主从复制mysql> change master to master_host="192.168.99.10" , master_user="repluser" , master_password="repluser" ,master_log_file="binlog.000002" , master_log_pos=1307;Query OK, 0 rows affected, 8 warnings (0.06 sec)
# 启动slave进程mysql> start slave ;Query OK, 0 rows affected, 1 warning (0.32 sec)
# 同步查看状态信息mysql> show slave status \G*************************** 1. row *************************** Slave_IO_State: Waiting for source to send event Master_Host: 192.168.99.10 Master_User: repluser Master_Port: 3306 Connect_Retry: 60 Master_Log_File: binlog.000002 Read_Master_Log_Pos: 1307 Relay_Log_File: relaylog.000002 Relay_Log_Pos: 323 Relay_Master_Log_File: binlog.000002 Slave_IO_Running: Yes Slave_SQL_Running: Yes Replicate_Do_DB:
# 测试
# 在主服务器创建text数据库mysql> create database text;Query OK, 1 row affected (0.06 sec)
# 从库查看是否同步mysql> show databases;+--------------------+| Database |+--------------------+| information_schema || mysql || performance_schema || sys || text |+--------------------+5 rows in set (0.06 sec)- 假设已有一主多从的 MySQL 主从复制环境,现在需要新增一个从服务器,写出具体操作步骤。
# 查看主库当前binlog和偏移量mysql> show master status;+---------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+---------------+----------+--------------+------------------+-------------------+| binlog.000002 | 1492 | | | |+---------------+----------+--------------+------------------+-------------------+1 row in set (0.04 sec)
# 从库安装mysql服务# 清理mariadb[root@slave1 ~]# rpm -qa | grep mariadb | xargs rpm -e --nodeps# 基本环境安装[root@slave1 ~]# yum install -y libaio-devel numactl wget# 下载安装官方源[root@slave1 ~]# wget https://dev.mysql.com/get/mysql80-community-release-el7-3.noarch.rpm[root@slave1 ~]# rpm -ivh mysql80-community-release-el7-3.noarch.rpm# 下载并导入 MySQL 官方 GPG 密钥[root@slave1 ~]# rpm --import https://repo.mysql.com/RPM-GPG-KEY-mysql-2023[root@slave1 ~]# yum repolist enabled | grep mysqlmysql-connectors-community/x86_64 MySQL Connectors Community 293mysql-tools-community/x86_64 MySQL Tools Community 118mysql80-community/x86_64 MySQL 8.0 Community Server 598[root@slave1 ~]#
# 主从安装mysql服务[root@slave1 ~]# yum install -y mysql-community-serverLoaded plugins: fastestmirrorLoading mirror speeds from cached hostfileResolving Dependencies--> Running transaction check---> Package mysql-community-server.x86_64 0:8.0.44-1.el7 will be installed--> Processing Dependency: mysql-community-common(x86-64) = 8.0.44-1.el7 for package: mysql-community-server-8.0.44-1.el7.x86_64--> Processing Dependency: mysql-community-icu-data-files = 8.0.44-1.el7 for package: mysql-community-server-8.0.44-1.el7.x86_64--> Processing Dependency: mysql-community-client(x86-64) >= 8.0.11 for package: mysql-community-server-8.0.44-1.el7.x86_64
# 配置从库,指定server_id和开启binlog日记[root@slave1 ~]# vim /etc/my.cnf[root@slave1 ~]# grep -vE "#" /etc/my.cnf
[mysqld]
datadir=/var/lib/mysqlsocket=/var/lib/mysql/mysql.sock
log-error=/var/log/mysqld.logpid-file=/var/run/mysqld/mysqld.pid
server_id=30log_bin=/var/lib/mysql/binlogrelay_log=/var/lib/mysql/relaylog
[root@slave1 ~]# systemctl enable mysqld[root@slave1 ~]# systemctl start mysqld
# 从库配置# 修改默认密码mysql> alter user 'root'@'localhost' IDENTIFIED BY 'Mysql123!';Query OK, 0 rows affected (0.01 sec)
# 配置 MySQL 主从复制mysql> change master to master_host="192.168.99.10" , master_user="repluser" , master_password="repluser" ,master_log_file="binlog.000002" , master_log_pos=1492;Query OK, 0 rows affected, 8 warnings (0.04 sec)
# 启动slave进程mysql> start slave;Query OK, 0 rows affected, 1 warning (0.63 sec)
# 同步查看状态信息mysql> show slave status \G*************************** 1. row *************************** Slave_IO_State: Waiting for source to send event Master_Host: 192.168.99.10 Master_User: repluser Master_Port: 3306 Connect_Retry: 60 Master_Log_File: binlog.000002 Read_Master_Log_Pos: 1492 Relay_Log_File: relaylog.000002 Relay_Log_Pos: 323 Relay_Master_Log_File: binlog.000002 Slave_IO_Running: Yes Slave_SQL_Running: Yes
# 测试
# 在主服务器创建text数据库mysql> create database text2;Query OK, 1 row affected (0.09 sec)
# 从库1 查看是否同步mysql> show databases;+--------------------+| Database |+--------------------+| information_schema || mysql || performance_schema || sys || text || text2 |+--------------------+6 rows in set (0.12 sec)
# 新增从库2 查看是否同步mysql> show databases;+--------------------+| Database |+--------------------+| information_schema || mysql || performance_schema || sys || text2 |+--------------------+5 rows in set (0.02 sec)#Doubao : 以下是对这份作业的详细检查分析:
选择题
所有选择题答案均正确,对 MySQL 主从复制的基本概念掌握较好。
- 第 1 题:主服务器记录数据变更的二进制日志文件是
binlog,选项 A 正确。 - 第 2 题:在 MySQL 主从复制中,主从服务器的
server-id必须不同,用于唯一标识每个服务器,选项 A 正确。 - 第 3 题:从服务器将接收到的主服务器
binlog日志写入relay log,选项 B 正确。 - 第 4 题:主库执行写操作后,
binlog dump thread负责把binlog的内容发送到从库,选项 A 正确。 - 第 5 题:MySQL 主从复制采用异步复制时,主库不等待从库确认,可能出现数据丢失的问题,选项 A 正确。
简答题
1. 简述 MySQL 主从复制的基本原理
答案准确完整,清晰地阐述了 MySQL 主从复制的基本流程,包括主库记录 binlog、从库请求和接收 binlog、写入中继日志以及执行事件等步骤。
2. 列举 MySQL 主从复制中 binlog 的三种格式,并说明各自特点
答案基本正确,但不够详细。对于每种格式的优缺点可以进一步展开说明,例如:
STATEMENT(语句级):日志量小、可读性高,但部分依赖主库环境的 SQL 语句(如含NOW()、UUID()等函数)可能导致主从复制不一致,在高并发场景下并发复制性能受限。ROW(行级):复制一致性高、并发复制性能好,但日志量大,可读性差,对于大规模数据更新操作会增加磁盘 I/O 和网络传输负担。MIXED(混合级):灵活性高、性能和一致性的平衡,会根据具体 SQL 语句自动选择STATEMENT或ROW格式,但难以预测具体使用的日志格式,增加了故障排查和管理难度。
3. 主从复制中,若主库宕机,应如何进行故障切换以保证业务继续运行
答案步骤不够详细,可能会导致实际操作时出现问题。可以补充以下内容:
- 确认主库宕机:通过监控系统、日志或者手动检查等方式,确认主库确实无法正常工作。
- 选择新的主库:考虑数据同步情况(查看
Seconds_Behind_Master)和硬件资源,选择合适的从库作为新主库。 - 停止从库复制:在选定的从库上执行
STOP SLAVE命令。 - 提升从库为新主库:执行
RESET MASTER命令。 - 配置其他从库指向新主库:在每个从库上执行
CHANGE MASTER TO命令,更新主库连接信息,然后执行START SLAVE命令。 - 更新应用程序配置:将应用程序连接的数据库地址从原主库更新为新主库的地址。
- 恢复原主库:对原主库进行故障排查和修复,修复完成后将其配置为新主库的从库。
操作题
1. 请详细描述搭建一主一从 MySQL 主从复制环境的步骤,包括主从服务器的配置、用户创建、同步启动等
整体步骤基本正确,但存在一些小问题:
- 数据库名拼写错误:在测试部分创建数据库时,写成了
text,推测可能是想写test。 - 缺少权限刷新:在主库创建用户并赋权后,应执行
FLUSH PRIVILEGES命令使权限生效。 - 日志记录:在安装和配置过程中,应检查命令执行结果,确保没有报错,并且可以记录关键步骤的日志,方便后续排查问题。
2. 假设已有一主多从的 MySQL 主从复制环境,现在需要新增一个从服务器,写出具体操作步骤
整体步骤基本正确,同样存在以下问题:
- 数据库名拼写错误:同第一题,测试部分创建数据库写成
text2,可能是test2。 - 缺少权限刷新:在主库创建用户并赋权后,应执行
FLUSH PRIVILEGES命令使权限生效。 - 日志记录:在安装和配置过程中,应检查命令执行结果,确保没有报错,并且可以记录关键步骤的日志,方便后续排查问题。
综上所述,作业对 MySQL 主从复制的基本概念和操作有较好的理解,但在一些细节和完整性方面还有提升空间。
10:mysql之读写分离
今日工作任务路线图
一、工作场景
MySQL读写分离在多种工作场景中优势明显。在高并发读场景里,如电商平台商品浏览、社交媒体内容加载,大量读请求可由从库处理,减轻主库压力,提升系统响应速度 。对于数据实时性要求低的报表生成、数据分析场景,允许主从短暂延迟,能充分发挥读写分离的优势 。在容灾与备份方面,从库可作为主库实时备份,主库故障时能快速切换,保障业务持续运行 。另外,全球分布式架构中,将读操作路由到离用户近的从库,可减少网络延迟。
二、为什么学
学习 MySQL 读写分离很有必要。在高并发场景下,数据库面临大量读写请求,读写分离可将读操作分配到从库,有效减轻主库压力,提升系统整体性能与响应速度。对于有海量数据处理需求的企业,能提升业务处理效率。它还能增强系统的可扩展性,可通过增加从库数量来应对不断增长的读请求。在数据备份与恢复方面,从库可充当主库的实时副本,一旦主库出现故障,能快速恢复数据,保障业务连续性。掌握这一技术,有助于提升数据库管理和运维能力。
三、准备环境
当前任务环节
3.1 准备新的虚拟机
| 主机名 | IP地址 | 说明 |
|---|---|---|
| mysql56 | 192.168.90.56 | master【马斯特】数据库 |
| mysql57 | 192.168.90.57 | slave【斯累夫】数据库 |
| mycat58 | 192.168.90.58 | 读写分离服务 |
mysql56配置IP地址和主机名
[root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.56/24 autoconnect【奥特欧 坑聂特】 yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160[root@mysql56 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql56mysql57配置IP地址和主机名
[root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.57/24 autoconnect【奥特欧 坑聂特】 yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160[root@mysql57 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql57mycat58配置IP地址和主机名
[root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.58/24 autoconnect【奥特欧 坑聂特】 yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160[root@mycat ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mycat583.2 读写分离原理
Mycat【麦-凯特】 读写分离原理基于对 MySQL 主从复制的利用。 Mycat【麦-凯特】 作为中间件,介于应用程序和 MySQL 数据库之间。 当应用程序发起 SQL 请求时,Mycat【麦-凯特】 会根据 SQL 语句类型进行判断。对于读操作,如 SELECT【涩莱克特】 语句,Mycat【麦-凯特】 将请求路由到从库处理,从库可有多台,能实现负载均衡,以此减轻主库读压力。而对于写操作,如 INSERT【因涩特】、UPDATE【阿普 dei 特】、DELETE【迪 利 特】 语句,Mycat【麦-凯特】 会将请求转发到主库,确保数据写入的一致性。 主库数据更新后,通过 MySQL 主从复制机制同步到从库,保证数据的实时性和准确性。
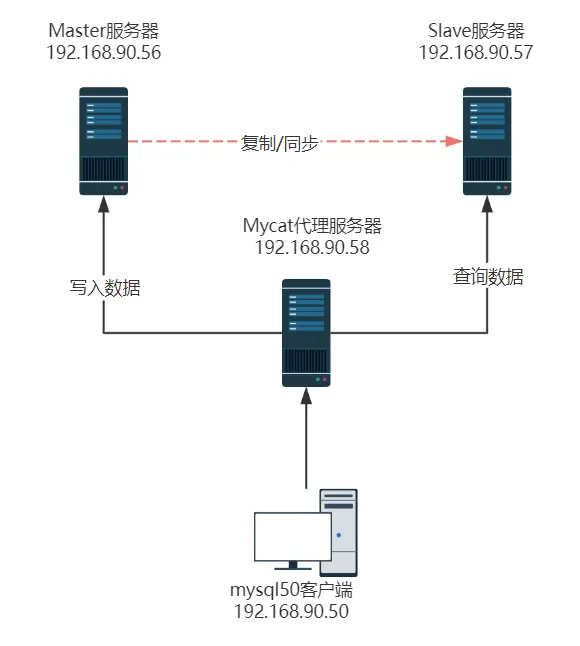
四、搭建一主一从结构
当前任务环节
因为数据的查询和存储分别访问不同的数据库服务器,所以要通过主从同步来保证负责读访问的服务与负责写访问的服务器数据一致。
4.1 配置主数据库服务器
[root@mysql56 ~]# yum -y install【因-斯多】 mysql-server mysql[root@mysql56 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld
# 启用binlog日志[root@mysql56 ~]# vim /etc/my.cnf.d/mysql-server.cnf# [root@mysql56 ~]# vim /etc/my.cnf[mysqld]server-id=56log-bin=mysql56:wq
[root@mysql56 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld# [root@mysql56 ~]# systemctl restart mysqld
# 用户授权[root@mysql56 ~]# mysql# [root@mysql56 ~]# mysql -uroot -p123
mysql> create【克瑞特】 user repluser@"%" identified【爱-丹-提伐】 with【威付】 mysql_native_password by【拜】 "123qqq...A";# mysql> create user repluser@'%' identified with mysql_native_password by 'repluser';# Query OK, 0 rows affected (0.26 sec)
mysql> grant【古亮普】 replication【瑞普利K申】 slave【斯累夫】 on *.* to repluser@"%" ;# mysql> grant replication slave on *.* to repluser@'%';# Query OK, 0 rows affected (0.15 sec)
# 查看日志信息mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】;# mysql> show master status;# +----------------+----------+--------------+------------------+-------------------+# | File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |# +----------------+----------+--------------+------------------+-------------------+# | mysql56.000001 | 668 | | | |# +----------------+----------+--------------+------------------+-------------------+# 1 row in set (0.00 sec)4.2 配置从数据库服务器
# 指定server-id 并重启数据库服务[root@mysql57 ~]# yum -y install【因-斯多】 mysql-server mysql[root@mysql57 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld[root@mysql57 ~]# vim /etc/my.cnf.d/mysql-server.cnf# [root@mysql57 ~]# vim /etc/my.cnf[mysqld]server-id=57:wq
[root@mysql57 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld# [root@mysql57 ~]# systemctl restart mysqld
# 管理员登陆,指定主服务器信息[root@mysql57 ~]# mysql# [root@mysql57 ~]# mysql -uroot -p123
mysql> change【趁(chèn)吉】 master【马斯特】 to master【马斯特】_host="192.168.90.56", master【马斯特】_user="repluser", master【马斯特】_password="123qqq...A", master【马斯特】_log_file="mysql56.000001",master【马斯特】_log_pos=667;# mysql> change master to master_host='192.168.88.10',master_user='repluser',master_password='repluser',master_log_file="mysql56.000001",master_log_pos=668;# Query OK, 0 rows affected, 8 warnings (9.74 sec)
# 启动slave【斯累夫】进程mysql> start【s 达儿】 slave【斯累夫】;# mysql> start slave;# Query OK, 0 rows affected, 1 warning (0.95 sec)
# 查看状态信息mysql> show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】 \G# mysql> show slave status \G*************************** 1. row *************************** Slave_IO_State: Waiting for source to send event Master_Host: 192.168.90.56 Master_User: repluser Master_Port: 3306 Connect_Retry: 60 Master_Log_File: mysql56.000001 Read_Master_Log_Pos: 667 Relay_Log_File: mysql57-relay-bin.000002 Relay_Log_Pos: 322 Relay_Master_Log_File: mysql56.000001 Slave_IO_Running: Yes //IO线程 Slave_SQL_Running: Yes //SQL线程 Replicate_Do_DB: Replicate_Ignore_DB: Replicate_Do_Table: Replicate_Ignore_Table: Replicate_Wild_Do_Table: Replicate_Wild_Ignore_Table: Last_Errno: 0 Last_Error: Skip_Counter: 0 Exec_Master_Log_Pos: 667 Relay_Log_Space: 533 Until_Condition: None Until_Log_File: Until_Log_Pos: 0 Master_SSL_Allowed: No Master_SSL_CA_File: Master_SSL_CA_Path: Master_SSL_Cert: Master_SSL_Cipher: Master_SSL_Key: Seconds_Behind_Master: 0Master_SSL_Verify_Server_Cert: No Last_IO_Errno: 0 Last_IO_Error: Last_SQL_Errno: 0 Last_SQL_Error: Replicate_Ignore_Server_Ids: Master_Server_Id: 56 Master_UUID: e0ab8dc4-0109-11ee-87e7-525400ad7ed3 Master_Info_File: mysql.slave_master_info SQL_Delay: 0 SQL_Remaining_Delay: NULL Slave_SQL_Running_State: Replica has read all relay log; waiting for more updates【阿普 dei 特s】 Master_Retry_Count: 86400 Master_Bind: Last_IO_Error_Timestamp: Last_SQL_Error_Timestamp: Master_SSL_Crl: Master_SSL_Crlpath: Retrieved_Gtid_Set: Executed_Gtid_Set: Auto_Position: 0 Replicate_Rewrite_DB: Channel_Name: Master_TLS_Version: Master_public_key_path: Get_master_public_key: 0 Network_Namespace:1 row in set, 1 warning (0.00 sec)五、配置mycat【麦-凯特】服务器
当前任务环节

5.1 拷贝软件到mycat【麦-凯特】58主机
mycat2-1.21-release-jar-with-dependencies.jar
mycat2**-install-**template-1.21.zip
5.2 安装mycat【麦-凯特】软件
# 安装jdk[root@mycat58 upload]# yum -y install【因-斯多】 java-1.8.0-openjdk.x86_64# [root@mycat58 ~]# yum -y install java-1.8.0-openjdk.x86_64# 安装解压命令[root@mycat58 upload]# which【维曲】 unzip || yum -y install【因-斯多】 unzip# [root@mycat58 ~]# which unzip || yum -y install unzip# 安装mycat[root@mycat58 upload]# unzip mycat2-install-template-1.21.zip# [root@mycat58 ~]# unzip mycat2-install-template-1.21.zip[root@mycat58 upload]# mv mycat【麦-凯特】 /usr/local/# [root@mycat58 ~]# mv mycat /usr/local/# 安装依赖[root@mycat58 upload]# cp mycat2-1.21-release-jar-with-dependencies.jar /usr/local/mycat/lib/# [root@mycat58 ~]# cp mycat2-1.21-release-jar-with-dependencies.jar /usr/local/mycat/lib/# 修改权限[root@mycat58 upload]# chmod -R 777 /usr/local/mycat/# [root@mycat58 ~]# chmod -R 777 /usr/local/mycat/5.3 配置mycat【麦-凯特】密码
定义客户端连接mycat【麦-凯特】服务使用用户及密码:
[root@mycat58 ~]# vim /usr/local/mycat/conf/users/root.user.json{ "dialect":"mysql", "ip":null, "password":"654321", 密码 "transactionType":"proxy", "username":"mycat" 用户名}mycat【麦-凯特】连接本机数据库配置
[root@mycat58 ~]# vim /usr/local/mycat/conf/datasources/prototypeDs.datasource.json{ "dbType":"mysql", "idleTimeout":60000, "initSqls":[], "initSqlsGetConnection":true, "instanceType":"READ_WRITE", "maxCon":1000, "maxConnectTimeout":3000, "maxRetryCount":5, "minCon":1, "name":"prototypeDs", "password":"123456", 密码 "type":"JDBC", "url":"jdbc:mysql://localhost:3306/mysql?useUnicode=true&serverTimezone=Asia/Shanghai&characterEncoding=UTF-8", 连接本机的数据库服务 "user":"jam", 用户名 "weight":0}5.4 mycat58主机mysql安装
# 安装软件[root@mycat58 ~]# yum -y install【因-斯多】 mysql-server mysql# 启动服务[root@mycat58 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld# 连接服务[root@mycat58 ~]# mysql# [root@mycat58 ~]# mysql -uroot -p123
# 创建jam用户mysql> create【克瑞特】 user jam@"%" identified【爱-丹-提伐】 by【拜】 "123456";# mysql> create user jam@'%' identified by '123456';# Query OK, 0 rows affected (0.52 sec)
# 授予权限mysql> grant【古亮普】 all on *.* to jam@"%" ;# mysql> grant all on *.* to jam@'%';# Query OK, 0 rows affected (1.14 sec)
# 断开连接mysql> exit【诶西特】# mysql> exitBye[root@mycat58 ~]#5.5 mycat【麦-凯特】服务启动和连接
启动mycat【麦-凯特】服务
[root@mycat58 ~]# /usr/local/mycat/bin/mycat help# [root@mycat58 ~]# /usr/local/mycat/bin/mycat helpUsage: /usr/local/mycat/bin/mycat { console | start【s 达儿】 | stop | restart【 率 s 达r】 | status【 斯dèi 特斯】 | dump }
[root@mycat58 ~]# /usr/local/mycat/bin/mycat start# [root@mycat58 ~]# /usr/local/mycat/bin/mycat start# Starting mycat2...
# 半分钟左右 能看到端口[root@mycat58 ~]# netstat -utnlp | grep 8066# [root@mycat58 ~]# netstat -tunlp | grep 8066# tcp6 0 0 :::8066 :::* LISTEN 30687/java连接mycat【麦-凯特】服务
[root@mycat58 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321# [root@mycat58 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321
mysql> show【瘦】 databases;# mysql> show databases;+--------------------+| `Database` |+--------------------+| information_schema || mysql || performance_schema |+--------------------+3 rows in set (0.11 sec)Mysql>六、配置读写分离
当前任务环节
6.1 添加数据源
添加数据源:连接mycat【麦-凯特】服务后做如下操作
# 连接mycat【麦-凯特】服务[root@mycat58 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321# [root@mycat58 ~]# mysql -h 127.0.0.1 -P8066 -umycat -p654321
# 添加mysql56数据库服务器MySQL> /*+ mycat:createdatasource{"name":"whost56", "url":"jdbc:mysql://192.168.90.56:3306","user":"jama","password":"123456"}*/;# mysql> /*+ mycat:createdatasource{"name":"whost56", "url":"jdbc:mysql://192.168.88.10:3306","user":"jama","password":"123456"}*/;# Query OK, 0 rows affected (0.86 sec)
# 添加mysql57数据库服务器Mysql>/*+ mycat:createdatasource{"name":"rhost57", "url":"jdbc:mysql://192.168.90.57:3306","user":"jama","password":"123456"}*/;# mysql> /*+ mycat:createdatasource{"name":"rhost57", "url":"jdbc:mysql://192.168.88.20:3306","user":"jama","password":"123456"}*/;# Query OK, 0 rows affected (0.06 sec)
# 查看数据源mysql> /*+mycat:showDataSources{}*/ \G# mysql> /*+mycat:showDataSources{}*/ \G*************************** 1. row *************************** NAME: whost56 USERNAME: jama PASSWORD: 123456 MAX_CON: 1000 MIN_CON: 1 EXIST_CON: 0 USE_CON: 0 MAX_RETRY_COUNT: 5 MAX_CONNECT_TIMEOUT: 30000 DB_TYPE: mysql URL: jdbc:mysql://192.168.90.56:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true WEIGHT: 0 INIT_SQL:INIT_SQL_GET_CONNECTION: true INSTANCE_TYPE: READ_WRITE IDLE_TIMEOUT: 60000 DRIVER: { CreateTime:"2023-06-02 17:01:14", ActiveCount:0, PoolingCount:0, CreateCount:0, DestroyCount:0, CloseCount:0, ConnectCount:0, Connections:[ ]} TYPE: JDBC IS_MYSQL: true*************************** 2. row *************************** NAME: rhost57 USERNAME: jama PASSWORD: 123456 MAX_CON: 1000 MIN_CON: 1 EXIST_CON: 0 USE_CON: 0 MAX_RETRY_COUNT: 5 MAX_CONNECT_TIMEOUT: 30000 DB_TYPE: mysql URL: jdbc:mysql://192.168.90.57:3306?useUnicode=true&serverTimezone=Asia/Shanghai&characterEncoding=UTF-8&autoReconnect=true WEIGHT: 0 INIT_SQL:INIT_SQL_GET_CONNECTION: true INSTANCE_TYPE: READ_WRITE IDLE_TIMEOUT: 60000 DRIVER: { CreateTime:"2023-06-02 17:01:14", ActiveCount:0, PoolingCount:0, CreateCount:0, DestroyCount:0, CloseCount:0, ConnectCount:0, Connections:[ ]} TYPE: JDBC IS_MYSQL: true*************************** 3. row *************************** NAME: prototypeDs USERNAME: jam PASSWORD: 123456 MAX_CON: 1000 MIN_CON: 1 EXIST_CON: 0 USE_CON: 0 MAX_RETRY_COUNT: 5 MAX_CONNECT_TIMEOUT: 3000 DB_TYPE: mysql URL: jdbc:mysql://localhost:3306/mysql?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true WEIGHT: 0 INIT_SQL:INIT_SQL_GET_CONNECTION: true INSTANCE_TYPE: READ_WRITE IDLE_TIMEOUT: 60000 DRIVER: { CreateTime:"2023-06-02 17:01:14", ActiveCount:0, PoolingCount:0, CreateCount:0, DestroyCount:0, CloseCount:0, ConnectCount:0, Connections:[ ]} TYPE: JDBC IS_MYSQL: true3 rows in set (0.00 sec)mysql>
# 添加的数据源以文件的形式保存在安装目录下[root@mycat58 conf]# ls /usr/local/mycat/conf/datasources/# [root@mycat58 ~]# ls /usr/local/mycat/conf/datasources/# prototypeDs.datasource.json rhost57.datasource.json whost56.datasource.json
[root@mycat58 conf]#6.2 配置数据库服务器添加jama用户
# 在master【马斯特】服务器添加[root@mysql56 ~]# mysql
mysql> create【克瑞特】 user jama@"%" identified【爱-丹-提伐】 by【拜】 "123456";# mysql> create user jama@"%" identified by "123456";# Query OK, 0 rows affected (0.24 sec)
mysql> grant【古亮普】 all on *.* to jama@"%";# mysql> grant all on *.* to jama@"%";# Query OK, 0 rows affected (0.19 sec)
mysql> exit【诶西特】[root@mysql56 ~]#
# 在slave【斯累夫】服务器查看是否同步成功[root@mysql57 ~]# mysql -e 'select【涩莱克特】 user , host from【弗乱】 mysql.user where user="jama"'+------+------+| user | host |+------+------+| jama | % |+------+------+[root@mysql57 ~]#6.3 创建集群
创建集群,连接mycat【麦-凯特】服务后做如下配置:
[root@mycat58 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321
# 创建集群mysql>/*!mycat:createcluster{"name":"rwcluster","masters":["whost56"],"replicas":["rhost57"]}*/ ;
# 查看集群信息mysql> /*+ mycat:showClusters{}*/ \G*************************** 1. row *************************** NAME: rwcluster SWITCH_TYPE: SWITCHMAX_REQUEST_COUNT: 2000 TYPE: BALANCE_ALL WRITE_DS: whost56 READ_DS: whost56,rhost57 WRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1 READ_L: io.mycat.plug.loadBalance.BalanceRandom$1 AVAILABLE: true*************************** 2. row *************************** NAME: prototype SWITCH_TYPE: SWITCHMAX_REQUEST_COUNT: 200 TYPE: BALANCE_ALL WRITE_DS: prototypeDs READ_DS: prototypeDs WRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1 READ_L: io.mycat.plug.loadBalance.BalanceRandom$1 AVAILABLE: true2 rows in set (0.00 sec)mysql>
# 创建的集群以文件的形式保存在目录下[root@mycat58 conf]# ls /usr/local/mycat/conf/clusters/prototype.cluster.json rwcluster.cluster.json[root@mycat58 conf]#6.4 指定主机角色
# 修改master【马斯特】角色主机仅负责写访问[root@mycat58 ~]# vim /usr/local/mycat/conf/datasources/whost56.datasource.json{ "dbType":"mysql", "idleTimeout":60000, "initSqls":[], "initSqlsGetConnection":true, "instanceType":"WRITE", 仅负责写访问 "logAbandoned":true, "maxCon":1000, "maxConnectTimeout":30000, "maxRetryCount":5, "minCon":1, "name":"whost56", "password":"123456", "queryTimeout":0, "removeAbandoned":false, "removeAbandonedTimeoutSecond":180, "type":"JDBC", "url":"jdbc:mysql://192.168.90.56:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true", "user":"jama", "weight":0}:wq
# 修改slave【斯累夫】角色主机仅负责读访问[root@mycat58 ~]# vim /usr/local/mycat/conf/datasources/rhost57.datasource.json{ "dbType":"mysql", "idleTimeout":60000, "initSqls":[], "initSqlsGetConnection":true, "instanceType":"READ",仅负责读访问 "logAbandoned":true, "maxCon":1000, "maxConnectTimeout":30000, "maxRetryCount":5, "minCon":1, "name":"rhost57", "password":"123456", "queryTimeout":0, "removeAbandoned":false, "removeAbandonedTimeoutSecond":180, "type":"JDBC", "url":"jdbc:mysql://192.168.90.57:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true", "user":"jama", "weight":0}6.5 修改读策略
readBalanceType参数值 | 负载均衡策略说明 | 行为描述 |
|---|---|---|
| BALANCE_ALL_READ | 在所有从库(Replicas)间均衡 | 所有的 SELECT查询请求会在 replicas列表配置的所有从库上进行负载均衡。写节点(masters)不参与读流量的分担。 |
| BALANCE_ALL (如果支持) | 在所有节点(主和从)间均衡 | 读请求会随机地在所有数据库节点(包括写节点 masters和读节点 replicas)上进行分发。这种模式允许主库也承担一部分读压力。 |
| BALANCE_MASTER (如果支持) | 仅从主库读取 | 所有读请求都会发往配置的写节点(masters)。这通常用于需要强一致性读的场景,或者尚未配置从库的情况。 |
[root@mycat58 ~]# vim /usr/local/mycat/conf/clusters/rwcluster.cluster.json{ "clusterType":"MASTER_SLAVE", "heartbeat":{ "heartbeatTimeout":1000, "maxRetryCount":3, "minSwitchTimeInterval":300, "showLog":false, "slaveThreshold":0.0 }, "masters":[ "whost56" ], "maxCon":2000, "name":"rwcluster", "readBalanceType":"BALANCE_ALL_READ",# _READ将查询语句分发到从数据库节点 "replicas":[ "rhost57" ], "switchType":"SWITCH"}:wq
# 重启mycat【麦-凯特】服务[root@mycat58 ~]# /usr/local/mycat/bin/mycat restartStopping mycat2...Stopped mycat2.Starting mycat2...
[root@mycat58 ~]#七、测试读写分离
当前任务环节
7.1 指定testdb库存储数据使用的集群
具体操作如下:
[root@mycat58 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321
mysql> create【克瑞特】 database testdb;# mysql> create database testdb;# Query OK, 0 rows affected (0.54 sec)
mysql> exit【诶西特】
# 指定testdb库存储数据使用的集群[root@mycat58 ~]# vim /usr/local/mycat/conf/schemas/testdb.schema.json{ "customTables":{}, "globalTables":{}, "normalProcedures":{}, "normalTables":{}, "schemaName":"testdb", "targetName":"rwcluster", 添加此行,之前创建的集群名rwcluster "shardingTables":{}, "views":{}}:wq
[root@mycat58 ~]# /usr/local/mycat/bin/mycat restartStopping mycat2...Stopped mycat2.Starting mycat2...
[root@mycat58 ~]#
# 连接mycat【麦-凯特】服务建表插入记录[root@client50 ~]# mysql -h192.168.90.58 -P8066 -umycat -p654321
mysql> create【克瑞特】 table【忒-部】 testdb.user (name varchar【瓦儿-查儿】(10) , password varchar【瓦儿-查儿】(10));# mysql> create table testdb.user (name varchar(10), password varchar(10));# Query OK, 0 rows affected (3.65 sec)
mysql> insert【因涩特】 into【因兔】 testdb.user values【挖柳斯】("yaya","123456");# mysql> insert into testdb.user values("yaya","123456");# Query OK, 1 row affected (0.28 sec)
mysql> select【涩莱克特】 * from【弗乱】 testdb.user;# mysql> select * from testdb.user;# +------+----------+# | name | password |# +------+----------+# | yaya | 123456 |# +------+----------+# 1 row in set (0.01 sec)7.2 测试读写分离
# 在从服务器本机插入记录,数据仅在从服务器有,主服务器没有[root@mysql57 ~]# mysql -e 'insert【因涩特】 into【因兔】 testdb.user values【挖柳斯】 ("yayaA","654321")'# [root@mysql57 ~]# mysql -uroot -p123 -e 'insert into testdb.user values("yayaA","654321")'# mysql: [Warning] Using a password on the command line interface can be insecure.
[root@mysql57 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 testdb.user'# [root@mysql57 ~]# mysql -uroot -p123 -e 'select * from testdb.user'# mysql: [Warning] Using a password on the command line interface can be insecure.# +-------+----------+# | name | password |# +-------+----------+# | yaya | 123456 |# | yayaA | 654321 |# +-------+----------+
# 主服务器数据不变,日志偏移量不不变[root@mysql56 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 testdb.user'# [root@mysql56 ~]# mysql -uroot -p123 -e 'select * from testdb.user'# mysql: [Warning] Using a password on the command line interface can be insecure.# +------+----------+# | name | password |# +------+----------+# | yaya | 123456 |# +------+----------+
[root@mysql56 ~]# mysql -e 'show【瘦】 master【马斯特】 status【 斯dèi 特斯】'# [root@mysql56 ~]# mysql -uroot -p123 -e 'show master status'# mysql: [Warning] Using a password on the command line interface can be insecure.# +----------------+----------+--------------+------------------+-------------------+# | File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |# +----------------+----------+--------------+------------------+-------------------+# | mysql56.000002 | 1910 | | | |# +----------------+----------+--------------+------------------+-------------------+
# 客户端连接mycat【麦-凯特】服务读/写数据[root@client50 ~]# mysql -h192.168.90.58 -P8066 -umycat -p654321# [root@mycat58 ~]# mysql -h 127.0.0.1 -P8066 -umycat -p654321
# 查看到的是2条记录的行mysql> select【涩莱克特】 * from【弗乱】 testdb.user;# mysql> select * from testdb.user;# +-------+----------+# | name | password |# +-------+----------+# | yaya | 123456 |# | yayaA | 654321 |# +-------+----------+# 2 rows in set (1.34 sec)
# 插入记录mysql> insert【因涩特】 into【因兔】 testdb.user values【挖柳斯】("yayaB","123456");# mysql> insert into testdb.user values("yayaB","123456");# Query OK, 1 row affected (0.14 sec)
mysql> select【涩莱克特】 * from【弗乱】 testdb.user;# mysql> select * from testdb.user;# +-------+----------+# | name | password |# +-------+----------+# | yaya | 123456 |# | yayaB | 123456 |# +-------+----------+# 2 rows in set (0.00 sec)
# 在主服务器查看数据和日志偏移量[root@mysql56 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 testdb.user'# [root@mysql56 ~]# mysql -uroot -p123 -e 'select * from testdb.user'# mysql: [Warning] Using a password on the command line interface can be insecure.# +-------+----------+# | name | password |# +-------+----------+# | yaya | 123456 |# | yayaB | 123456 |# +-------+----------+
[root@mysql56 ~]# mysql -e 'show【瘦】 master【马斯特】 status【 斯dèi 特斯】'# [root@mysql56 ~]# mysql -uroot -p123 -e 'show master status'# mysql: [Warning] Using a password on the command line interface can be insecure.# +----------------+----------+--------------+------------------+-------------------+# | File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |# +----------------+----------+--------------+------------------+-------------------+# | mysql56.000002 | 2203 | | | |# +----------------+----------+--------------+------------------+-------------------+
# 客户端连接mycat【麦-凯特】服务查看到的是3条记录[root@client50 ~]# mysql -h192.168.90.58 -P8066 -umycat -p654321 -e 'select【涩莱克特】 * from【弗乱】 testdb.user'# [root@mycat58 mycat]# mysql -h192.168.88.30 -P8066 -umycat -p654321 -e 'select * from testdb.user'# mysql: [Warning] Using a password on the command line interface can be insecure.# +-------+----------+# | name | password |# +-------+----------+# | yaya | 123456 |# | yayaA | 654321 |# +-------+----------+MyCat 核心配置文件功能总结
| 配置文件 | 核心功能 |
|---|---|
| server.xml | 系统级配置(账户、密码、逻辑库、序列、连接参数) |
| schema.xml | 逻辑库-物理库映射、表配置、分片规则关联、数据节点/主机配置 |
| rule.xml | 分片规则定义与参数配置 |
| dataHost.xml(可选) | 独立配置数据主机(部分版本将 DataHost 配置拆分到该文件,默认在 schema.xml 中) |
MySQL 读写分离的原理与优势
一、核心原理
MySQL 读写分离基于 主从复制 机制,通过中间件(如 MyCat、ProxySQL、MaxScale)实现请求分流,核心逻辑如下:
- 架构基础:部署1台主库(Master)和1+台从库(Slave),主库负责写操作,从库仅负责读操作;
- 数据同步:主库执行写操作(INSERT/UPDATE/DELETE)后,通过二进制日志(binlog)将数据变更同步到所有从库,保障主从数据一致性;
- 请求路由:应用程序的SQL请求统一发送至中间件,中间件根据SQL类型分流:
- 写请求(含事务类读请求)直接路由到主库,确保数据写入的原子性和一致性;
- 读请求(SELECT)分发到任意从库,支持多从库负载均衡;
- 故障兼容:中间件实时监测主从节点状态,自动剔除故障从库,主库故障时可配合主从切换机制保障业务连续性。
二、核心优势
- 提升并发承载能力:读操作(占业务请求80%以上)分流至多从库,主库专注处理写操作,避免读写冲突排队,系统整体并发量显著提升;
- 减轻主库负载压力:主库无需承担大量读请求的CPU、IO资源消耗,降低主库因负载过高导致的卡顿、超时风险;
- 高可用与容错:从库故障仅影响部分读业务,主库故障可快速切换读请求至从库,避免单点故障导致系统瘫痪;
- 优化响应速度:从库可就近部署(异地多活),降低网络延迟;且从库可关闭写日志、优化索引,专项提升读性能;
- 灵活横向扩展:读压力增长时,无需升级主库硬件,仅需新增从库节点接入集群,扩展成本低、效率高;
- 简化维护与数据安全:从库可作为灾备节点,主库数据丢失时可从从库恢复;报表统计、数据备份等非核心操作可在从库执行,不影响主库业务。
Mycat 在 MySQL 读写分离中的核心作用
Mycat 作为开源分布式数据库中间件,是 MySQL 读写分离架构的 核心枢纽,其核心价值是屏蔽底层主从集群复杂度,实现请求智能分流、数据一致性保障和高可用调度,让应用无需感知主从架构即可享受读写分离带来的性能提升。具体作用如下:
一、请求路由:读写操作智能分流(核心功能)
Mycat 是应用与 MySQL 集群之间的“流量分发器”,实现读写请求的精准拆分:
- SQL 类型识别:自动解析应用发送的 SQL 语句,区分读操作(SELECT、SHOW 等)和写操作(INSERT、UPDATE、DELETE、DDL 等);
- 路由规则执行:
- 写请求(含事务类读请求,如
SELECT ... FOR UPDATE)强制路由到 主库,确保数据写入的原子性和一致性,避免写操作分散导致的数据冲突; - 读请求默认路由到 从库,并支持多从库负载均衡(如轮询、加权轮询、一致性哈希等算法),将读压力均匀分摊到多个从库,减轻主库负担;
- 写请求(含事务类读请求,如
- 灵活路由扩展:支持自定义路由规则(如指定某类查询走特定从库、分库分表场景下的联合路由),适配复杂业务需求。
二、数据一致性保障:解决主从同步延迟问题
MySQL 主从复制存在天然的同步延迟(毫秒级到秒级),可能导致“主库写入数据后,从库未及时同步,读请求获取旧数据”的问题。Mycat 提供多种机制保障数据一致性:
- 强制走主库策略:支持通过 SQL 注解(如
/*MASTER*/ SELECT * FROM table)或配置规则,让关键读请求(如刚写入后需立即查询的场景)强制路由到主库,避免延迟导致的数据不一致; - 延迟判断机制:可配置从库同步延迟阈值(如 1 秒),Mycat 实时监测主从延迟,若从库延迟超过阈值,自动将读请求切换到其他低延迟从库或主库,确保读取数据的时效性;
- 事务一致性控制:事务内的所有操作(无论读写)均路由到主库,避免事务跨主从执行导致的隔离级别失效或数据不一致。
三、负载均衡:提升集群并发处理能力
针对多从库架构,Mycat 提供成熟的负载均衡策略,最大化利用从库资源:
- 读负载均衡:将海量读请求均匀分发到多个从库,避免单台从库过载,提升整体读并发能力(如 3 台从库可承载 3 倍于单从库的读请求);
- 权重配置支持:可根据从库硬件性能(CPU、内存、IO)配置权重(如高性能从库权重设为 3,普通从库设为 1),让资源更优的从库承担更多请求;
- 动态负载调整:支持在线新增/下线从库节点,Mycat 自动感知节点变化并调整负载分发策略,无需重启应用或中间件。
四、高可用调度:避免单点故障,保障业务连续性
Mycat 实时监测主从节点状态,提供故障自动切换和容错能力,提升集群可用性:
- 节点健康检查:通过心跳检测(如定期执行
SELECT 1)监测主从库是否存活,若发现节点故障(如从库宕机、主库离线),自动将其从集群中剔除,避免请求路由到故障节点导致的业务报错; - 主从切换支持:配合 MGR(MySQL Group Replication)或第三方高可用工具(如 Keepalived),主库故障时,Mycat 可自动识别新主库并切换路由规则,写请求无缝迁移到新主库,读请求继续由正常从库处理,实现业务“无感知”恢复;
- 故障恢复自动接入:当故障节点修复后,Mycat 可自动检测并将其重新纳入集群,恢复负载均衡,无需人工干预。
五、透明接入:降低应用改造成本
Mycat 对应用完全透明,无需修改应用代码即可实现读写分离:
- 协议兼容:完全兼容 MySQL 协议,应用可像连接普通 MySQL 数据库一样连接 Mycat(仅需修改数据库连接地址为 Mycat 服务地址,端口为 Mycat 监听端口),无需调整 SQL 语法或数据库驱动;
- 逻辑库抽象:Mycat 将底层多个主从库抽象为一个“逻辑库”,应用仅需面向逻辑库开发,无需关心底层主从节点的数量、地址和部署架构,降低架构复杂度和运维成本。
六、辅助功能:强化读写分离架构的稳定性与可维护性
- 权限集中管理:在 Mycat 层面统一配置应用访问权限(如某应用仅允许读从库、某账户仅允许写主库),无需在每个 MySQL 节点单独配置,简化权限管理;
- SQL 拦截与过滤:支持拦截非法 SQL(如高风险 DDL、慢查询)或不符合规则的请求(如写请求路由到从库),避免恶意操作或误操作破坏集群稳定性;
- 监控与审计:提供完善的日志(如路由日志、错误日志、访问日志)和监控指标(如请求量、路由命中率、节点状态),方便运维人员排查问题、优化性能;
- 分库分表兼容:Mycat 不仅支持读写分离,还可与分库分表功能结合,实现“读写分离+分库分表”的复杂架构,满足海量数据存储和高并发访问的场景(如电商订单库)。
总结
Mycat 在 MySQL 读写分离架构中的核心作用是 “承上启下”:向上屏蔽底层主从集群的复杂性,让应用无需改造即可享受读写分离的性能红利;向下通过智能路由、负载均衡、高可用调度和一致性保障,最大化发挥主从集群的资源价值,解决“主库负载高、读并发不足、单点故障”等核心问题,是中小型企业实现 MySQL 高可用、高并发架构的优选中间件。
Mycat 在 MySQL 读写分离中的核心作用(简洁版)
-
读写请求智能分流
自动解析 SQL 类型,写操作(INSERT/UPDATE/DELETE)路由到主库保证数据一致,读操作(SELECT)分发到从库,避免主库读压力过载。 -
保障数据一致与读负载均衡
通过“关键读请求强制走主库”解决主从同步延迟问题;支持多从库按权重分摊读请求,最大化利用从库资源,提升读并发能力。 -
透明接入与高可用兜底
应用无需改代码,仅需将连接地址指向 Mycat(兼容 MySQL 协议);实时监测主从节点状态,故障节点自动剔除,主库故障时配合切换保障业务不中断。
Mycat 读写分离 schema.xml 核心配置项及作用(简洁版)
1. **<schema> 标签** - 核心属性:`name`(逻辑库名称)、`checkSQLschema`(是否校验SQL库名) - 作用:定义应用访问的**逻辑库**,关联底层数据节点,屏蔽物理库集群复杂度。
2. **<table> 标签** - 核心属性:`name`(逻辑表名)、`dataNode`(关联的数据节点)、`primaryKey`(主键)、`autoIncrement`(是否自增) - 作用:映射逻辑表与物理表,指定表所属数据节点,配置主键和自增规则(读写分离场景中主要用于关联数据节点)。
3. **<dataNode> 标签** - 核心属性:`name`(数据节点名称)、`dataHost`(关联的数据主机)、`database`(物理库名称) - 作用:关联**数据主机**与**物理库**,是逻辑表到物理库的中间映射。
4. **<dataHost> 标签**(读写分离核心配置) - 核心属性:`name`(数据主机名称)、`balance`(读负载均衡策略)、`writeType`(写路由规则)、`switchType`(主从切换策略) - 作用:配置主从库集群信息,控制读负载分发、写请求路由、主从故障切换。
5. **<writeHost> 标签** - 核心属性:`host`(主机标识)、`url`(主库地址:端口)、`user`(数据库用户名)、`password`(密码) - 作用:定义**主库**连接信息,接收所有写请求(INSERT/UPDATE/DELETE)。
6. **<readHost> 标签** - 核心属性:`host`(主机标识)、`url`(从库地址:端口)、`user`(数据库用户名)、`password`(密码) - 作用:定义**从库**连接信息,接收读请求(SELECT),配合 `balance` 实现负载均衡。
7. **关键属性补充** - `balance="1"`:开启读负载均衡(主从库均参与读); - `writeType="0"`:写请求路由到第一个 <writeHost>(主库); - `switchType="1"`:主库故障时自动切换到备用主库/从库。Mycat balance 属性(负载均衡策略)取值含义与适用场景
balance 是 Mycat schema.xml 中 <dataHost> 标签的核心属性,专门控制 读请求的负载均衡规则,取值仅支持 0、1、2、3 四种,不同取值对应不同的集群架构和业务需求,具体如下:
1. balance=“0”:关闭读负载均衡
- 含义:不开启读负载分发,所有读请求(SELECT)均路由到当前活跃的
writeHost(主库),从库(readHost)不参与读请求处理。 - 适用场景:
- 从库未部署(仅单主库架构);
- 主从同步延迟极高(如跨地域主从,延迟秒级以上),读从库会导致数据不一致;
- 业务需要 强一致性读(如刚写入数据后立即查询、核心交易查询),必须读主库。
2. balance=“1”:主从库混合读负载(推荐默认)
- 含义:开启读负载均衡,读请求分发到所有
readHost(从库)和 备用writeHost(备用主库);当前活跃的主库(默认writeHost)不参与读请求,仅负责写操作。 - 适用场景:
- 典型主从架构(1主多从 + 1备用主库),需最大化利用从库和备用主库资源;
- 读请求占比高(如电商商品查询、新闻列表、用户信息查询),需分摊主库读压力;
- 大多数中小型业务的默认选择,兼顾性能和数据一致性(配合主从同步延迟阈值使用)。
3. balance=“2”:全节点读负载(不分主从)
- 含义:不区分主库(
writeHost)和从库(readHost),所有可用的writeHost(主库、备用主库)和readHost(从库)均参与读负载,读请求随机分发到所有节点。 - 适用场景:
- 主库硬件配置充足(CPU/内存/IO 资源未饱和),允许承担部分读请求;
- 备用主库长期闲置,需利用其资源分担读压力;
- 读压力较大但未达到需要部署多从库的规模,适合中小型集群(如 1主1从 + 1备用主库)。
4. balance=“3”:仅从库读负载
- 含义:读请求仅分发到
readHost(从库),主库(writeHost)和备用主库完全不参与读负载 - 适用场景:
- 主库写压力极大(如高频插入/更新),需完全隔离读请求(主库仅负责写);
- 对读数据时效性有要求(需避免主从延迟导致的旧数据),如金融交易查询、订单状态查询;
- 多从库架构(1主多从),且从库性能均衡,适合中大型业务的读密集场景。
balance="3"是最常用的读写分离策略,特别适合读多写少的业务场景,它能有效降低主库压力,提升系统整体性能。
核心总结(快速选型)
balance 值 | 读请求负载策略 | 核心工作机制 | 最适用场景 |
|---|---|---|---|
| 0 | 不开启读写分离 | 所有读、写操作均发送至当前可用的主库 (writeHost)。 | 单点数据库、要求强一致性读、从库延迟不可接受。 |
| 1 | 主从库混合读负载 | 读请求在所有从库 (readHost) 及备用主库 (standby writeHost) 间负载均衡,当前主库不参与读。 | 双主双从等高可用架构,最大化利用从库和备用主库资源。 |
| 2 | 全节点随机读负载 | 所有读请求随机分发到配置内所有数据库节点(包括主库和从库)。 | 读压力大,且主库性能充足,允许主库分担读请求。 |
| 3 | 仅从库读负载 | 读请求只分发到当前主库对应的从库 (readHost) 上,主库完全不负担任何读压力。 | 一主多从架构,且希望严格分离读写、保障主库写性能的场景。 |
八、作业
1 选择题
1
- 在 Mycat 读写分离配置中,schema.xml 文件里 datahost 标签的 balance 属性值为 3 时,表示( D )。 A. 不开启读写分离机制,所有读操作都可发送到当前可用的 writeHost 上 B. 全部的 readHost 与备用的 writeHost 都参与 select 语句的负载均衡 C. 所有的读写操作都随机在 writeHost,readHost 上分发 D. 所有的读请求随机分发到 writeHost 对应的 readHost 上执行,writeHost 不负担读压力
2
- Mycat 的默认数据端口和管理端口分别是( A )。 A. 8066 和 9066 B. 9066 和 8066 C. 3306 和 8066 D. 8066 和 3306
3
- 在 Mycat 配置中,server.xml 文件主要用于( A )。 A. 配置 Mycat 所需要的服务器信息,如序列生成方式、逻辑数据库、访问账户和密码等 B. 配置逻辑数据库的映射、表、分片规则、数据结点及真实的数据库信息 C. 定义分片规则 D. 配置负载均衡策略
4
- 在 Mycat 读写分离配置前,需要确保( A )。 A. MySQL 主从复制已完成并正常运行 B. MySQL 版本为 8.0 C. Mycat 安装在 Windows 系统上 D. 所有数据库服务器的 server-id 相同
2 简答题
1
- 简述 MySQL 读写分离的原理和优势。
答:
核心原理
- 架构基础:部署1台主库(Master)和1+台从库(Slave),主库负责写操作,从库仅负责读操作;
- 数据同步:主库执行写操作(INSERT/UPDATE/DELETE)后,通过二进制日志(binlog)将数据变更同步到所有从库,保障主从数据一致性;
- 请求路由:应用程序的SQL请求统一发送至中间件,中间件根据SQL类型分流:
- 写请求(含事务类读请求)直接路由到主库,确保数据写入的原子性和一致性;
- 读请求(SELECT)分发到任意从库,支持多从库负载均衡;
- 故障兼容:中间件实时监测主从节点状态,自动剔除故障从库,主库故障时可配合主从切换机制保障业务连续性。
核心优势 1. 提升并发承载能力:读操作(占业务请求80%以上)分流至多从库,主库专注处理写操作,避免读写冲突排队,系统整体并发量显著提升; 2. 减轻主库负载压力:主库无需承担大量读请求的CPU、IO资源消耗,降低主库因负载过高导致的卡顿、超时风险; 3. 高可用与容错:从库故障仅影响部分读业务,主库故障可快速切换读请求至从库,避免单点故障导致系统瘫痪; 4. 优化响应速度:从库可就近部署(异地多活),降低网络延迟;且从库可关闭写日志、优化索引,专项提升读性能; 5. 灵活横向扩展:读压力增长时,无需升级主库硬件,仅需新增从库节点接入集群,扩展成本低、效率高; 6. 简化维护与数据安全:从库可作为灾备节点,主库数据丢失时可从从库恢复;报表统计、数据备份等非核心操作可在从库执行,不影响主库业务。
2
- 说明 Mycat 在 MySQL 读写分离中的作用。
答:
- 读写请求智能分流
自动解析 SQL 类型,写操作(INSERT/UPDATE/DELETE)路由到主库保证数据一致,读操作(SELECT)分发到从库,避免主库读压力过载。 - 保障数据一致与读负载均衡
通过“关键读请求强制走主库”解决主从同步延迟问题;支持多从库按权重分摊读请求,最大化利用从库资源,提升读并发能力。 - 透明接入与高可用兜底
应用无需改代码,仅需将连接地址指向 Mycat(兼容 MySQL 协议);实时监测主从节点状态,故障节点自动剔除,主库故障时配合切换保障业务不中断。
- 读写请求智能分流
3
-
列举 Mycat 读写分离配置中 schema.xml 文件的主要配置项及其作用。 答:
-
标签 - 核心属性:
name(逻辑库名称)、checkSQLschema(是否校验SQL库名) - 作用:定义应用访问的逻辑库,关联底层数据节点,屏蔽物理库集群复杂度。
- 核心属性:
-
标签
- 核心属性:
name(逻辑表名)、dataNode(关联的数据节点)、primaryKey(主键)、autoIncrement(是否自增) - 作用:映射逻辑表与物理表,指定表所属数据节点,配置主键和自增规则(读写分离场景中主要用于关联数据节点)。
- 核心属性:
-
标签 - 核心属性:
name(数据节点名称)、dataHost(关联的数据主机)、database(物理库名称) - 作用:关联数据主机与物理库,是逻辑表到物理库的中间映射。
- 核心属性:
-
标签 (读写分离核心配置)- 核心属性:
name(数据主机名称)、balance(读负载均衡策略)、writeType(写路由规则)、switchType(主从切换策略) - 作用:配置主从库集群信息,控制读负载分发、写请求路由、主从故障切换。
- 核心属性:
-
标签 - 核心属性:
host(主机标识)、url(主库地址:端口)、user(数据库用户名)、password(密码) - 作用:定义主库连接信息,接收所有写请求(INSERT/UPDATE/DELETE)。
- 核心属性:
-
标签 - 核心属性:
host(主机标识)、url(从库地址:端口)、user(数据库用户名)、password(密码) - 作用:定义从库连接信息,接收读请求(SELECT),配合
balance实现负载均衡。
- 核心属性:
-
关键属性补充
balance="1":开启读负载均衡(主从库均参与读);writeType="0":写请求路由到第一个(主库); switchType="1":主库故障时自动切换到备用主库/从库。
- 阐述 Mycat 读写分离中负载均衡策略 balance 属性不同取值的含义和适用场景。
答:
balance 取值 “0”,核心含义为“读请求仅走主库,从库不参与”,适用场景为单主库、强一致性读、主从延迟极高
balance 取值 “1”,核心含义为“读请求走从库+备用主库,主库只读不写”,适用场景为1主多从+备用主库、常规读写分离
balance 取值 “2”,核心含义为“所有主从节点均分担读请求”,适用场景为主库资源充足、读压力适中
balance 取值 “3”,核心含义为“读请求只分发到当前主库对应的从库 (
readHost) 上,主库完全不负担任何读压力。”,适用场景为一主多从架构,且希望严格分离读写、保障主库写性能的场景 - 请详细描述在 Linux 环境下使用 Mycat 实现 MySQL 一主一从读写分离的完整操作步骤,包括 MySQL 主从复制配置、Mycat 安装与配置、测试验证等。
- 假设已有一个 MySQL 双主双从的主从复制环境,现要使用 Mycat 实现读写分离,请写出 Mycat 的具体配置步骤和配置文件示例。
- 当 Mycat 服务启动失败,如何进行故障排查和解决,请给出详细的操作流程。
4
3 操作题
1
// **MySQL 主从复制配置**# 配置主库,指定server_id和开启binlog日记[root@master ~]# grep -vE "#" /etc/my.cnf[mysqld]server-id=56log-bin=mysql56# 重启服务[root@master /]# systemctl restart mysqld# 创建用户同步的repluser账号密码replusermysql> create user repluser@"%" identified WITH mysql_native_password by "repluser";Query OK, 0 rows affected (0.09 sec)# 给repluser用户赋权mysql> grant replication slave on *.* to repluser@"%";Query OK, 0 rows affected (0.05 sec)# 查询binlog名称和偏移量mysql> show master status;+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql56.000002 | 157 | | | |+----------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)// **从库安装mysql服务**# 配置从库,指定server_id和开启binlog日记[root@slave1 ~]# vim /etc/my.cnf[root@slave1 ~]# grep -vE "#" /etc/my.cnf[mysqld]server-id=57log_bin=/var/lib/mysql/binlogrelay_log=/var/lib/mysql/relaylog# 重启服务[root@slave1 ~]# systemctl restart mysqld# 从库配置# 修改默认密码[root@slave1 ~]# mysql -uroot -p123# 配置 MySQL 主从复制mysql> change master to master_host="192.168.88.10" , master_user="repluser" , master_password="repluser" ,master_log_file="mysql56.000002" , master_log_pos=157;Query OK, 0 rows affected, 8 warnings (0.06 sec)# 启动slave进程mysql> start slave;Query OK, 0 rows affected, 1 warning (0.32 sec)# 同步查看状态信息mysql> show slave status \G......Slave_IO_Running: YesSlave_SQL_Running: Yes......# 配置mycat服务jama用户# 在master 服务器添加mysql> create user jama@"%" identified by "123456";Query OK, 0 rows affected (0.24 sec)mysql> grant all on *.* to jama@"%";Query OK, 0 rows affected (0.19 sec)# 在slave 服务器查看是否同步成功[root@slave1 ~]# mysql -e 'select user , host from mysql.user where user="jama"'+------+------+| user | host |+------+------+| jama | % |+------+------+[root@slave1 ~]#// **Mycat 安装与配置、测试验证**# 安装mycat 软件和环境# 安装jdk64和unzip[root@mycat ~]# yum -y install java-1.8.0-openjdk.x86_64 unzip# 安装mycat[root@mycat ~]# unzip mycat2-install-template-1.21.zip[root@mycat ~]# mv mycat /usr/local/# 安装依赖[root@mycat ~]# cp mycat2-1.21-release-jar-with-dependencies.jar /usr/local/mycat/lib/[root@mycat ~]# chmod -R 777 /usr/local/mycat/# 配置mycat 密码# 定义客户端连接mycat 服务使用用户及密码:[root@mycat ~]# vim /usr/local/mycat/conf/users/root.user.json{"dialect":"mysql","ip":null,"password":"654321", # 密码"transactionType":"proxy","username":"mycat" # 用户名}# mycat【麦-凯特】连接本机数据库配置[root@mycat ~]# vim /usr/local/mycat/conf/datasources/prototypeDs.datasource.json{"dbType":"mysql","idleTimeout":60000,"initSqls":[],"initSqlsGetConnection":true,"instanceType":"READ_WRITE","maxCon":1000,"maxConnectTimeout":3000,"maxRetryCount":5,"minCon":1,"name":"prototypeDs","password":"123456", # 密码"type":"JDBC","url":"jdbc:mysql://localhost:3306/mysql?useUnicode=true&serverTimezone=Asia/Shanghai&characterEncoding=UTF-8", # 连接本机的数据库服务"user":"jam", # 用户名"weight":0}# mycat58主机mysql配置[root@mycat ~]# mysql -uroot -p123# 创建jam用户mysql> create user jam@'%' identified by '123456';Query OK, 0 rows affected (0.52 sec)# 授予权限mysql> grant all on *.* to jam@'%';Query OK, 0 rows affected (1.14 sec)# 断开连接mysql> exit# 启动mycat 服务[root@mycat ~]# /usr/local/mycat/bin/mycat startStarting mycat2...# 半分钟左右 能看到端口[root@mycat ~]# netstat -tunlp | grep -E "8066|9066"tcp6 0 0 :::8066 :::* LISTEN 18159/javatcp6 0 0 127.0.0.1:9066 :::* LISTEN 18159/java# 连接mycat 服务[root@mycat ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321mysql> show databases;+--------------------+| `Database` |+--------------------+| information_schema || mysql || performance_schema |+--------------------+3 rows in set (0.11 sec)# 配置读写分离# 添加数据源# 连接mycat 服务[root@mycat ~]# mysql -h 127.0.0.1 -P8066 -umycat -p654321# 添加mysql56数据库服务器mysql> /*+ mycat:createdatasource{"name":"whost56", "url":"jdbc:mysql://192.168.88.10:3306","user":"jama","password":"123456"}*/;Query OK, 0 rows affected (0.86 sec)# 添加mysql57数据库服务器mysql> /*+ mycat:createdatasource{"name":"rhost57", "url":"jdbc:mysql://192.168.88.20:3306","user":"jama","password":"123456"}*/;Query OK, 0 rows affected (0.06 sec)# 查看数据源mysql> /*+mycat:showDataSources{}*/ \G*************************** 1. row ***************************NAME: whost56USERNAME: jamaPASSWORD: 123456......DB_TYPE: mysqlURL: jdbc:mysql://192.168.88.10:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true......*************************** 2. row ***************************NAME: prototypeDsUSERNAME: jamPASSWORD: 123456......DB_TYPE: mysqlURL: jdbc:mysql://localhost:3306/mysql?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true......*************************** 3. row ***************************NAME: rhost57USERNAME: jamaPASSWORD: 123456......DB_TYPE: mysqlURL: jdbc:mysql://192.168.88.20:3306?useUnicode=true&serverTimezone=Asia/Shanghai&characterEncoding=UTF-8&autoReconnect=true......3 rows in set (0.01 sec)# 创建集群[root@mycat ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321# 创建集群mysql>/*!mycat:createcluster{"name":"rwcluster","masters":["whost56"],"replicas":["rhost57"]}*/ ;# 查看集群信息mysql> /*+ mycat:showClusters{}*/ \G*************************** 1. row ***************************NAME: rwclusterSWITCH_TYPE: SWITCHMAX_REQUEST_COUNT: 2000TYPE: BALANCE_ALLWRITE_DS: whost56READ_DS: whost56,rhost57WRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1READ_L: io.mycat.plug.loadBalance.BalanceRandom$1AVAILABLE: true*************************** 2. row ***************************NAME: prototypeSWITCH_TYPE: SWITCHMAX_REQUEST_COUNT: 200TYPE: BALANCE_ALLWRITE_DS: prototypeDsREAD_DS: prototypeDsWRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1READ_L: io.mycat.plug.loadBalance.BalanceRandom$1AVAILABLE: true2 rows in set (0.01 sec)# 指定主机角色# 修改master 角色主机仅负责写访问[root@mycat ~]# vim /usr/local/mycat/conf/datasources/whost56.datasource.json{"dbType":"mysql","idleTimeout":60000,"initSqls":[],"initSqlsGetConnection":true,"instanceType":"WRITE", 仅负责写访问"logAbandoned":true,"maxCon":1000,"maxConnectTimeout":30000,"maxRetryCount":5,"minCon":1,"name":"whost56","password":"123456","queryTimeout":0,"removeAbandoned":false,"removeAbandonedTimeoutSecond":180,"type":"JDBC","url":"jdbc:mysql://192.168.90.56:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true","user":"jama","weight":0}:wq# 修改slave 角色主机仅负责读访问[root@mycat ~]# vim /usr/local/mycat/conf/datasources/rhost57.datasource.json{"dbType":"mysql","idleTimeout":60000,"initSqls":[],"initSqlsGetConnection":true,"instanceType":"READ",仅负责读访问"logAbandoned":true,"maxCon":1000,"maxConnectTimeout":30000,"maxRetryCount":5,"minCon":1,"name":"rhost57","password":"123456","queryTimeout":0,"removeAbandoned":false,"removeAbandonedTimeoutSecond":180,"type":"JDBC","url":"jdbc:mysql://192.168.90.57:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true","user":"jama","weight":0}# 修改读策略[root@mycat ~]# vim /usr/local/mycat/conf/clusters/rwcluster.cluster.json{"clusterType":"MASTER_SLAVE","heartbeat":{"heartbeatTimeout":1000,"maxRetryCount":3,"minSwitchTimeInterval":300,"showLog":false,"slaveThreshold":0.0},"masters":["whost56"],"maxCon":2000,"name":"rwcluster","readBalanceType":"BALANCE_ALL_READ",# _READ将查询语句分发到从数据库节点"replicas":["rhost57"],"switchType":"SWITCH"}:wq# 重启mycat 服务[root@mycat ~]# /usr/local/mycat/bin/mycat restartStopping mycat2...Stopped mycat2.Starting mycat2...[root@mycat ~]#// **测试读写分离测试读写分离**# 指定testdb库存储数据使用的集群[root@mycat ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321mysql> create database testdb;Query OK, 0 rows affected (0.54 sec)mysql> exitBye# 指定testdb库存储数据使用的集群[root@mycat ~]# vim /usr/local/mycat/conf/schemas/testdb.schema.json{"customTables":{},"globalTables":{},"normalProcedures":{},"normalTables":{},"schemaName":"testdb","targetName":"rwcluster", 添加此行,之前创建的集群名rwcluster"shardingTables":{},"views":{}}:wq[root@mycat ~]# /usr/local/mycat/bin/mycat restartStopping mycat2...Stopped mycat2.Starting mycat2...# 连接mycat 服务建表插入记录[root@mycat ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321mysql> create table testdb.user (name varchar(10), password varchar(10));Query OK, 0 rows affected (3.52 sec)mysql> insert into testdb.user values("yaya","123456");Query OK, 1 row affected (0.39 sec)mysql> select * from testdb.user;+------+----------+| name | password |+------+----------+| yaya | 123456 |+------+----------+1 row in set (0.02 sec)# 测试读写分离# 在从服务器本机插入记录,数据仅在从服务器有,主服务器没有[root@slave1 ~]# mysql -uroot -p123 -e 'insert into testdb.user values("yayaA","654321")'mysql: [Warning] Using a password on the command line interface can be insecure.[root@slave1 ~]# mysql -uroot -p123 -e 'select * from testdb.user'mysql: [Warning] Using a password on the command line interface can be insecure.+-------+----------+| name | password |+-------+----------+| yaya | 123456 || yayaA | 654321 |+-------+----------+# 主服务器数据不变,日志偏移量不不变[root@master ~]# mysql -uroot -p123 -e 'select * from testdb.user'mysql: [Warning] Using a password on the command line interface can be insecure.+------+----------+| name | password |+------+----------+| yaya | 123456 |+------+----------+[root@master ~]# mysql -uroot -p123 -e 'show master status'mysql: [Warning] Using a password on the command line interface can be insecure.+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql56.000002 | 1503 | | | |+----------------+----------+--------------+------------------+-------------------+# 客户端连接mycat 服务读/写数据# 查看到的是2条记录的行mysql> select * from testdb.user;+-------+----------+| name | password |+-------+----------+| yaya | 123456 || yayaA | 654321 |+-------+----------+2 rows in set (1.34 sec)# 插入记录mysql> insert into testdb.user values("yayaB","123456");Query OK, 1 row affected (0.14 sec)mysql> select * from testdb.user;+-------+----------+| name | password |+-------+----------+| yaya | 123456 || yayaB | 123456 |+-------+----------+2 rows in set (0.00 sec)# 在主服务器查看数据和日志偏移量[root@master ~]# mysql -uroot -p123 -e 'select * from testdb.user'mysql: [Warning] Using a password on the command line interface can be insecure.+-------+----------+| name | password |+-------+----------+| yaya | 123456 || yayaB | 123456 |+-------+----------+[root@master ~]# mysql -uroot -p123 -e 'show master status'mysql: [Warning] Using a password on the command line interface can be insecure.+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql56.000002 | 1796 | | | |+----------------+----------+--------------+------------------+-------------------+# 客户端连接mycat 服务查看到的是3条记录mysql> select * from testdb.user;+-------+----------+| name | password |+-------+----------+| yaya | 123456 || yayaA | 654321 || yayaB | 123456 |+-------+----------+3 rows in set (0.00 sec)2
Terminal window # Mycat 核心配置步骤# 1:确认 Mycat 环境(已安装 JDK 1.8+,Mycat 已部署)# 2:配置 Mycat 数据源(4个节点,每个节点1个配置文件)# 2.1 主库1数据源:masterA.datasource.json[root@mycat ~]# vim /usr/local/mycat/conf/datasources/masterA.datasource.json{"dbType": "mysql","idleTimeout": 60000,"initSqls": [],"initSqlsGetConnection": true,"instanceType": "WRITE", # 主库:写角色"maxCon": 1000,"maxConnectTimeout": 30000,"maxRetryCount": 5,"minCon": 1,"name": "masterA", # 数据源名称(与拓扑标识一致)"password": "Mycat@123","type": "JDBC","url": "jdbc:mysql://192.168.90.61:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&allowMultiQueries=true","user": "mycat_user","weight": 1 # 写负载权重(双主权重相同,均分写请求)}# 2.2 主库2数据源:masterB.datasource.json[root@mycat ~]# vim /usr/local/mycat/conf/datasources/masterB.datasource.json{"dbType": "mysql","idleTimeout": 60000,"initSqls": [],"initSqlsGetConnection": true,"instanceType": "WRITE", # 主库:写角色(双主互备)"maxCon": 1000,"maxConnectTimeout": 30000,"maxRetryCount": 5,"minCon": 1,"name": "masterB", # 数据源名称"password": "Mycat@123","type": "JDBC","url": "jdbc:mysql://192.168.90.62:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&allowMultiQueries=true","user": "mycat_user","weight": 1 # 与主库1权重一致,实现写负载均衡}# 2.3 从库1数据源:slaveA.datasource.json[root@mycat ~]# vim /usr/local/mycat/conf/datasources/slaveA.datasource.json{"dbType": "mysql","idleTimeout": 60000,"initSqls": [],"initSqlsGetConnection": true,"instanceType": "READ", # 从库:读角色"maxCon": 1000,"maxConnectTimeout": 30000,"maxRetryCount": 5,"minCon": 1,"name": "slaveA", # 数据源名称"password": "Mycat@123","type": "JDBC","url": "jdbc:mysql://192.168.90.63:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&allowMultiQueries=true","user": "mycat_user","weight": 1 # 读负载权重(双从权重相同,均分读请求)}# 2.4 从库2数据源:slaveB.datasource.json[root@mycat ~]# vim /usr/local/mycat/conf/datasources/slaveB.datasource.json{"dbType": "mysql","idleTimeout": 60000,"initSqls": [],"initSqlsGetConnection": true,"instanceType": "READ", # 从库:读角色"maxCon": 1000,"maxConnectTimeout": 30000,"maxRetryCount": 5,"minCon": 1,"name": "slaveB", # 数据源名称"password": "Mycat@123","type": "JDBC","url": "jdbc:mysql://192.168.90.64:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&allowMultiQueries=true","user": "mycat_user","weight": 1 # 与从库1权重一致,实现读负载均衡}# 3:配置 Mycat 集群(核心:双主双从读写策略)[root@mycat ~]# vim /usr/local/mycat/conf/clusters/dual_master_dual_slave.cluster.json{"clusterType": "MASTER_SLAVE", # 集群类型:主从架构(支持双主)"heartbeat": { # 心跳检测(监测节点存活)"heartbeatTimeout": 1000,"maxRetryCount": 3,"minSwitchTimeInterval": 300, # 故障切换最小间隔(毫秒)"showLog": false,"slaveThreshold": 0.5 # 从库同步延迟阈值(秒),超过则剔除},"masters": ["masterA", "masterB"], # 双主数据源名称(写请求路由到这里)"maxCon": 4000, # 集群最大连接数(4个节点总和)"name": "dual_master_dual_slave", # 集群名称(后续关联逻辑库用)"readBalanceType": "BALANCE_ALL_READ", # 读负载策略:所有从库均分读请求"replicas": ["slaveA", "slaveB"], # 双从数据源名称(读请求路由到这里)"switchType": "SWITCH", # 故障切换策略:自动切换(主库故障时切换到备用主库)"writeBalanceType": "BALANCE_ALL_WRITE" # 写负载策略:双主均分写请求(核心!双主特色)}# 4:配置 Mycat 逻辑库(关联集群)[root@mycat mycat]# vim /usr/local/mycat/conf/schemas/business.schema.json{"customTables": {},"globalTables": {},"normalProcedures": {},"normalTables": {},"schemaName": "business", # 逻辑库名称(应用连接 Mycat 时使用)"targetName": "dual_master_dual_slave", # 关联上面创建的集群名称"shardingTables": {},"views": {}}# 5:配置 Mycat 访问用户(可选,若已配置可跳过)[root@mycat ~]# vim /usr/local/mycat/conf/users/mycat_user.user.json{"dialect": "mysql","ip": null, # 允许所有IP访问(生产环境可指定IP)"password": "Mycat@666", # 应用连接 Mycat 的密码"transactionType": "proxy","username": "mycat_app" # 应用连接 Mycat 的用户名}# **启动与验证**# 重启 Mycat 加载配置[root@mycat ~]# /usr/local/mycat/bin/mycat restart# 2.1 连接 Mycat 逻辑库[root@mycat ~]# mysql -h 127.0.0.1 -P 8066 -u mycat_app -pMycat@666mysql> -- 查看逻辑库mysql> show databases;mysql> -- 查看 Mycat 数据源状态mysql> /*+ mycat:showDataSources{}*/ \Gmysql> -- 查看集群状态mysql> /*+ mycat:showClusters{}*/ \G-- **验证读写分离效果**mysql> -- 写操作(插入数据,会路由到双主之一)mysql> use business;mysql> create table test_user (id int primary key auto_increment, name varchar(20));mysql> insert into test_user (name) values ("user1"), ("user2");# 直接连接 masterA 查看双主数据[root@mycat ~]# mysql -h 192.168.90.61 -u mycat_user -pMycat@123 -e "select * from business.test_user";# 直接连接 masterB 查看双主数据[root@mycat ~]# mysql -h 192.168.90.62 -u mycat_user -pMycat@123 -e "select * from business.test_user";# 查看双从数据[root@mycat ~]# mysql -h 192.168.90.63 -u mycat_user -pMycat@123 -e "select * from business.test_user";[root@mycat ~]# mysql -h 192.168.90.64 -u mycat_user -pMycat@123 -e "select * from business.test_user";Terminal window # Mycat 实现 MySQL 双主双从读写分离(配置步骤+文件示例)## 一、环境前提(已就绪)假设双主双从复制环境已搭建完成(**核心前提:双主互为主从,主从数据同步正常**),拓扑如下:| 节点角色 | IP地址 | 端口 | 数据库用户 | 密码 | 实例标识(Mycat中用) ||----------------|----------------|------|------------|--------|-----------------------|| 主库1(MasterA) | 192.168.90.61 | 3306 | mycat_user | Mycat@123 | masterA || 主库2(MasterB) | 192.168.90.62 | 3306 | mycat_user | Mycat@123 | masterB || 从库1(SlaveA) | 192.168.90.63 | 3306 | mycat_user | Mycat@123 | slaveA || 从库2(SlaveB) | 192.168.90.64 | 3306 | mycat_user | Mycat@123 | slaveB |### 双主双从复制要求- 双主已配置 **互为主从**(MasterA → MasterB 同步,MasterB → MasterA 同步),支持写负载或故障切换;- 每个主库对应从库同步正常(MasterA → SlaveA,MasterB → SlaveB),`Slave_IO_Running=Yes` 且 `Slave_SQL_Running=Yes`;- 所有节点已创建 Mycat 访问用户(`mycat_user`),并授予权限:`GRANT ALL ON *.* TO 'mycat_user'@'%' IDENTIFIED WITH mysql_native_password BY 'Mycat@123';`## 二、Mycat 核心配置步骤(基于 Mycat 2.x,与你之前版本一致)### 步骤1:确认 Mycat 环境(已安装 JDK 1.8+,Mycat 2.x 已部署)无需额外安装,仅需配置以下文件(路径:`/usr/local/mycat/conf/`)。### 步骤2:配置 Mycat 数据源(4个节点,每个节点1个配置文件)在 `conf/datasources/` 目录下,创建4个数据源配置文件(描述每个 MySQL 节点的连接信息)。#### 2.1 主库1数据源:masterA.datasource.json```json{"dbType": "mysql","idleTimeout": 60000,"initSqls": [],"initSqlsGetConnection": true,"instanceType": "WRITE", // 主库:写角色"maxCon": 1000,"maxConnectTimeout": 30000,"maxRetryCount": 5,"minCon": 1,"name": "masterA", // 数据源名称(与拓扑标识一致)"password": "Mycat@123","type": "JDBC","url": "jdbc:mysql://192.168.90.61:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&allowMultiQueries=true","user": "mycat_user","weight": 1 // 写负载权重(双主权重相同,均分写请求)}```#### 2.2 主库2数据源:masterB.datasource.json```json{"dbType": "mysql","idleTimeout": 60000,"initSqls": [],"initSqlsGetConnection": true,"instanceType": "WRITE", // 主库:写角色(双主互备)"maxCon": 1000,"maxConnectTimeout": 30000,"maxRetryCount": 5,"minCon": 1,"name": "masterB", // 数据源名称"password": "Mycat@123","type": "JDBC","url": "jdbc:mysql://192.168.90.62:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&allowMultiQueries=true","user": "mycat_user","weight": 1 // 与主库1权重一致,实现写负载均衡}```#### 2.3 从库1数据源:slaveA.datasource.json```json{"dbType": "mysql","idleTimeout": 60000,"initSqls": [],"initSqlsGetConnection": true,"instanceType": "READ", // 从库:读角色"maxCon": 1000,"maxConnectTimeout": 30000,"maxRetryCount": 5,"minCon": 1,"name": "slaveA", // 数据源名称"password": "Mycat@123","type": "JDBC","url": "jdbc:mysql://192.168.90.63:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&allowMultiQueries=true","user": "mycat_user","weight": 1 // 读负载权重(双从权重相同,均分读请求)}```#### 2.4 从库2数据源:slaveB.datasource.json```json{"dbType": "mysql","idleTimeout": 60000,"initSqls": [],"initSqlsGetConnection": true,"instanceType": "READ", // 从库:读角色"maxCon": 1000,"maxConnectTimeout": 30000,"maxRetryCount": 5,"minCon": 1,"name": "slaveB", // 数据源名称"password": "Mycat@123","type": "JDBC","url": "jdbc:mysql://192.168.90.64:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&allowMultiQueries=true","user": "mycat_user","weight": 1 // 与从库1权重一致,实现读负载均衡}```### 步骤3:配置 Mycat 集群(核心:双主双从读写策略)在 `conf/clusters/` 目录下,创建集群配置文件 `dual_master_dual_slave.cluster.json`,定义主从关系、负载策略、故障切换规则。```json{"clusterType": "MASTER_SLAVE", // 集群类型:主从架构(支持双主)"heartbeat": { // 心跳检测(监测节点存活)"heartbeatTimeout": 1000,"maxRetryCount": 3,"minSwitchTimeInterval": 300, // 故障切换最小间隔(秒)"showLog": false,"slaveThreshold": 0.5 // 从库同步延迟阈值(秒),超过则剔除},"masters": ["masterA", "masterB"], // 双主数据源名称(写请求路由到这里)"maxCon": 4000, // 集群最大连接数(4个节点总和)"name": "dual_master_dual_slave", // 集群名称(后续关联逻辑库用)"readBalanceType": "BALANCE_ALL_READ", // 读负载策略:所有从库均分读请求"replicas": ["slaveA", "slaveB"], // 双从数据源名称(读请求路由到这里)"switchType": "SWITCH", // 故障切换策略:自动切换(主库故障时切换到备用主库)"writeBalanceType": "BALANCE_ALL_WRITE" // 写负载策略:双主均分写请求(核心!双主特色)}```### 步骤4:配置 Mycat 逻辑库(关联集群)在 `conf/schemas/` 目录下,创建逻辑库配置文件(例如 `business.schema.json`),指定业务逻辑库与集群的关联。```json{"customTables": {},"globalTables": {},"normalProcedures": {},"normalTables": {},"schemaName": "business", // 逻辑库名称(应用连接 Mycat 时使用)"targetName": "dual_master_dual_slave", // 关联上面创建的集群名称"shardingTables": {},"views": {}}```### 步骤5:配置 Mycat 访问用户(可选,若已配置可跳过)在 `conf/users/` 目录下,创建用户配置文件 `mycat_user.user.json`,定义应用连接 Mycat 的账号密码。```json{"dialect": "mysql","ip": null, // 允许所有IP访问(生产环境可指定IP)"password": "Mycat@666", // 应用连接 Mycat 的密码"transactionType": "proxy","username": "mycat_app" // 应用连接 Mycat 的用户名}```## 三、关键配置说明(双主双从核心亮点)1. **双主写负载均衡**:通过 `writeBalanceType: "BALANCE_ALL_WRITE"` + 双主 `instanceType: "WRITE"`,写请求会均匀分发到两个主库,分摊写压力;2. **双从读负载均衡**:通过 `readBalanceType: "BALANCE_ALL_READ"` + 双从 `instanceType: "READ"`,读请求均匀分发到两个从库,最大化读性能;3. **故障自动切换**:- 主库故障(如 masterA 宕机):Mycat 通过心跳检测发现后,自动将写请求切换到 masterB,业务无感知;- 从库故障(如 slaveA 宕机):自动剔除故障从库,读请求仅分发到正常从库(slaveB),不影响业务;4. **同步延迟过滤**:`slaveThreshold: 0.5` 表示从库同步延迟超过 0.5 秒时,Mycat 会暂时剔除该从库,避免读旧数据。## 四、启动与验证### 1. 启动 Mycat```bash# 重启 Mycat 加载配置/usr/local/mycat/bin/mycat restart# 查看启动状态(确保 8066 端口监听)netstat -tunlp | grep 8066```### 2. 验证配置正确性#### 2.1 连接 Mycat 逻辑库```bashmysql -h 192.168.90.58 -P 8066 -u mycat_app -pMycat@666```#### 2.2 验证逻辑库与集群关联```sql-- 查看逻辑库show databases;-- 应输出:business(配置的逻辑库名称)-- 查看 Mycat 数据源状态(Mycat 2.x 专用命令)/*+ mycat:showDataSources{}*/ \G-- 应显示 4 个数据源(masterA、masterB、slaveA、slaveB),状态为 OK-- 查看集群状态/*+ mycat:showClusters{}*/ \G-- 应显示集群 dual_master_dual_slave,主从节点正常```#### 2.3 验证读写分离效果```sql-- 1. 写操作(插入数据,会路由到双主之一)use business;create table test_user (id int primary key auto_increment, name varchar(20));insert into test_user (name) values ("user1"), ("user2");-- 2. 查看双主数据(均应存在插入的数据,证明双主同步正常)-- 直接连接 masterA 查看mysql -h 192.168.90.61 -u mycat_user -pMycat@123 -e "select * from business.test_user";-- 直接连接 masterB 查看mysql -h 192.168.90.62 -u mycat_user -pMycat@123 -e "select * from business.test_user";-- 3. 查看双从数据(均应同步主库数据,证明主从同步正常)mysql -h 192.168.90.63 -u mycat_user -pMycat@123 -e "select * from business.test_user";mysql -h 192.168.90.64 -u mycat_user -pMycat@123 -e "select * from business.test_user";-- 4. 读操作(通过 Mycat 查询,会路由到双从之一)-- 多次执行,观察 Mycat 日志(conf/logs/mycat.log),确认读请求分流到 slaveA/slaveBselect * from test_user;```## 五、注意事项1. **双主复制前提**:必须确保双主互为主从配置正确(开启 GTID 模式最佳,避免同步冲突);2. **权限统一**:所有 MySQL 节点的 `mycat_user` 权限必须一致(至少拥有业务库的读写权限);3. **生产环境优化**:- 限制 Mycat 访问 IP(在用户配置文件中指定 `ip: "192.168.90.0/24"`);- 调整 `maxCon`(连接数)、`idleTimeout`(空闲超时)适配业务压力;- 开启 Mycat 日志审计,便于排查问题;4. **避免写冲突**:双主架构下,若同一表存在并发写,需确保表有主键(或唯一索引),避免同步报错。## 总结双主双从的 Mycat 配置核心是 **“数据源分角色(双主WRITE/双从READ)+ 集群配置写负载/读负载/故障切换”**,配置步骤与单主多从一致,仅需在集群中增加主库数据源、启用写负载策略即可。你的单主多从配置思路完全可复用,只需扩展数据源和调整集群参数,放心按此方案提交作业!3
Terminal window ### 一、检查启动状态与基础环境1. **查看启动状态与错误提示**- 用`/usr/local/mycat/bin/mycat status`查看运行状态。- 手动启动并观察报错:`/usr/local/mycat/bin/mycat start 2>&1 | grep -E "ERROR|Exception"`。- 若提示“command not found”,用`find / -name "mycat" 2>/dev/null`找正确路径。2. **验证 JDK 环境**- 检查版本:`java -version`。- 检查环境变量:`echo $JAVA_HOME`。- 未配置则临时配置:`export JAVA_HOME=/usr/lib/jvm/java - 1.8.0 - openjdk; export PATH=$PATH:$JAVA_HOME/bin`。- 永久配置:在`/etc/profile`添加配置并`source /etc/profile`。### 二、查看核心日志日志默认路径`/usr/local/mycat/conf/logs/`:1. **主日志 mycat.log**:`tail -100 /usr/local/mycat/conf/logs/mycat.log | grep -E "ERROR|WARN|Exception"`。2. **启动器日志 wrapper.log**:`tail -100 /usr/local/mycat/conf/logs/wrapper.log | grep -E "ERROR|FATAL"`。### 三、排查配置文件错误1. **检查语法**:用`jq`工具校验 JSON 格式配置文件。2. **检查关键参数**:核对`datasources`、`clusters`、`schemas`、`users`配置文件参数。### 四、排查端口占用问题Mycat 默认用 8066 和 9066 端口:1. 用`netstat -tunlp | grep`或`lsof -i:`检查端口占用。2. 停止占用进程或修改`/usr/local/mycat/conf/mycat.properties`中的端口。### 五、排查权限与目录访问问题1. 检查目录权限,不足则`chmod -R 755 /usr/local/mycat/`。2. 检查日志目录写入权限,可`chmod 777 /usr/local/mycat/conf/logs/`。3. 检查运行用户,必要时修改目录所有者。### 六、排查数据源连接问题1. 测试网络连通性:`telnet`或`nc`。2. 验证账号密码,检查账号存在性、权限和服务状态。3. 检查防火墙/安全组,放行 3306 端口。### 七、排查依赖与元数据问题(Mycat 2.x 特有)1. 检查原型库配置文件。2. 验证原型库连接。3. 检查依赖 jar 包,缺失则手动下载。### 八、极端情况:恢复默认配置,逐步测试1. 备份当前配置。2. 删除自定义配置。3. 恢复默认原型库配置。4. 启动 Mycat。5. 逐步添加自定义配置并测试。Terminal window # Mycat 服务启动失败:故障排查与解决完整操作流程Mycat 启动失败的核心原因集中在 **环境依赖、配置错误、端口占用、权限不足、数据源连接异常** 五类,排查需遵循“从基础到深入、从日志到配置”的逻辑,逐步定位问题。以下是详细操作流程(基于 Mycat 2.x,兼容 1.x 核心思路):## 一、第一步:检查启动状态与基础环境(快速排除低级问题)### 1. 查看 Mycat 启动状态与错误提示首先通过官方命令查看启动状态,获取直接报错信息:```bash# 1. 查看 Mycat 运行状态(Mycat 2.x 命令)/usr/local/mycat/bin/mycat status# 2. 尝试手动启动,观察实时报错(关键!直接输出启动失败原因)/usr/local/mycat/bin/mycat start 2>&1 | grep -E "ERROR|Exception"# 3. 若提示“command not found”,确认 Mycat 安装路径正确find / -name "mycat" 2>/dev/null # 找到正确路径(如 /opt/mycat),替换执行```#### 常见状态与初步判断:- 提示“not running”:服务未启动,需进一步查日志;- 提示“Invalid JAVA_HOME”:JDK 环境未配置;- 提示“Address already in use”:端口被占用;- 提示“Could not load configuration”:配置文件错误。### 2. 验证核心依赖:JDK 环境(Mycat 必需)Mycat 依赖 JDK 1.8+(1.x 支持 1.7,2.x 强制 1.8+),先确认环境:```bash# 1. 检查 JDK 版本java -version# 正常输出示例:openjdk version "1.8.0_382"(需 1.8+,低于则报错)# 2. 检查 JAVA_HOME 环境变量echo $JAVA_HOME# 正常输出示例:/usr/lib/jvm/java-1.8.0-openjdk# 3. 若未配置 JAVA_HOME,手动配置(临时生效)export JAVA_HOME=/usr/lib/jvm/java-1.8.0-openjdkexport PATH=$PATH:$JAVA_HOME/bin# 4. 永久配置(避免重启失效)echo 'export JAVA_HOME=/usr/lib/jvm/java-1.8.0-openjdk' >> /etc/profileecho 'export PATH=$PATH:$JAVA_HOME/bin' >> /etc/profilesource /etc/profile```#### 问题解决:- 无 JDK:执行 `yum -y install java-1.8.0-openjdk.x86_64`(CentOS)安装;- JDK 版本过低:卸载旧版本,重新安装 1.8+。## 二、第二步:查看核心日志(定位问题关键)Mycat 启动失败的详细原因会记录在日志中,优先查看以下 2 个核心日志文件(默认路径:`/usr/local/mycat/conf/logs/`):### 1. 主日志:mycat.log(记录配置加载、数据源连接、启动流程错误)```bash# 查看日志最后 100 行(聚焦最新错误)tail -100 /usr/local/mycat/conf/logs/mycat.log | grep -E "ERROR|WARN|Exception"# 若日志过大,搜索关键词定位grep -n "Failed to" /usr/local/mycat/conf/logs/mycat.log # 搜索失败相关记录```### 2. 启动器日志:wrapper.log(记录 JVM 启动、进程启动失败原因)```bashtail -100 /usr/local/mycat/conf/logs/wrapper.log | grep -E "ERROR|FATAL"```#### 日志常见错误与对应解决:| 日志错误关键词 | 问题原因 | 快速解决 ||-----------------------------|-----------------------------------|-----------------------------------|| Invalid JSON syntax | 配置文件(.json)语法错误 | 检查对应 JSON 文件的逗号、引号闭合 || Could not connect to datasource | 数据源(MySQL)连接失败 | 验证 MySQL 地址、账号密码、网络连通性 || Address already in use: 8066 | 8066/9066 端口被占用 | 查找并停止占用进程,或修改 Mycat 端口 || Permission denied | Mycat 目录/文件权限不足 | 赋予读写权限:chmod -R 755 /usr/local/mycat || Missing jar包名 | 依赖 jar 包缺失 | 从安装包复制缺失 jar 到 lib 目录 |## 三、第三步:排查配置文件错误(最常见原因)Mycat 启动时会加载 `datasources`(数据源)、`clusters`(集群)、`schemas`(逻辑库)、`users`(用户)四类核心配置文件,JSON 语法错误、参数配置错误是主要诱因。### 1. 检查配置文件语法(JSON 格式必须严格)Mycat 2.x 配置文件均为 JSON 格式,逗号、引号、大括号不闭合会直接导致启动失败,用 `jq` 工具验证:```bash# 1. 安装 jq 工具(JSON 语法校验)yum -y install jq# 2. 逐个校验核心配置文件(以 datasources 为例)# 校验数据源配置(所有 .datasource.json 文件)for file in /usr/local/mycat/conf/datasources/*.json; doecho "校验文件:$file"jq . $file # 语法错误会直接提示行号done# 3. 同理校验集群、逻辑库、用户配置for file in /usr/local/mycat/conf/clusters/*.json; do jq . $file; donefor file in /usr/local/mycat/conf/schemas/*.json; do jq . $file; donefor file in /usr/local/mycat/conf/users/*.json; do jq . $file; done```#### 语法错误示例与修复:- 错误:`{"name":"masterA", "password":"123"}`(末尾多逗号)- 修复:`{"name":"masterA", "password":"123"}`(删除末尾逗号)### 2. 检查关键配置参数(参数错误导致启动失败)重点核对以下核心参数(配置文件中最易出错):#### 2.1 数据源配置(datasources/*.json)```json{"url": "jdbc:mysql://192.168.90.61:3306?serverTimezone=Asia/Shanghai&useUnicode=true", // 确保 IP、端口正确"user": "mycat_user", // MySQL 账号存在且有权限"password": "Mycat@123", // 密码正确"instanceType": "WRITE", // 取值只能是 WRITE/READ/READ_WRITE(大小写敏感)"dbType": "mysql" // 不能写错(如写成 "mysql8" 无效)}```#### 2.2 集群配置(clusters/*.json)```json{"name": "dual_master_dual_slave","masters": ["masterA", "masterB"], // 数据源名称必须与 datasources 中一致"replicas": ["slaveA", "slaveB"], // 同上,不能拼写错误"clusterType": "MASTER_SLAVE", // 取值只能是 MASTER_SLAVE/SINGLE/CLUSTER"writeBalanceType": "BALANCE_ALL_WRITE" // 取值符合 Mycat 规则}```#### 2.3 逻辑库配置(schemas/*.json)```json{"schemaName": "business","targetName": "dual_master_dual_slave" // 集群名称必须与 clusters 中一致}```#### 2.4 用户配置(users/*.json)```json{"username": "mycat_app","password": "Mycat@666", // 不能包含特殊字符(如 @ 需转义,或直接用简单密码测试)"dialect": "mysql" // 不能写错}```## 四、第四步:排查端口占用问题Mycat 默认占用 2 个端口:- 8066:业务端口(应用连接 Mycat 用)- 9066:管理端口(Mycat 管理命令用)端口被占用会直接导致启动失败,排查流程:```bash# 1. 检查 8066 端口占用情况netstat -tunlp | grep 8066# 或用 lsof(更详细)lsof -i:8066# 2. 检查 9066 端口占用情况netstat -tunlp | grep 9066# 3. 若有占用进程,停止该进程(示例:PID 为 1234)kill -9 1234# 4. 若无法停止占用进程,修改 Mycat 端口(Mycat 2.x 配置)vi /usr/local/mycat/conf/mycat.properties# 修改以下参数(自定义未占用端口)server.port=8067 # 新业务端口manager.port=9067 # 新管理端口# 5. 重启 Mycat 测试/usr/local/mycat/bin/mycat restart```## 五、第五步:排查权限与目录访问问题Mycat 启动时需要读取配置文件、写入日志,权限不足会导致“Permission denied”错误:```bash# 1. 检查 Mycat 安装目录权限ls -ld /usr/local/mycat/# 正常权限:drwxr-xr-x(所有者、组有读写执行权限)# 2. 赋予完整权限(临时测试,生产环境可收紧)chmod -R 755 /usr/local/mycat/# 3. 检查日志目录写入权限(关键!日志写不进去会启动失败)ls -ld /usr/local/mycat/conf/logs/chmod 777 /usr/local/mycat/conf/logs/ # 临时赋予最大权限测试# 4. 检查运行用户(若用非 root 用户启动,需确保用户有目录权限)ps -ef | grep mycat # 查看运行用户chown -R mycat:mycat /usr/local/mycat/ # 若用 mycat 用户,修改目录所有者```## 六、第六步:排查数据源连接问题若数据源(MySQL 主从节点)配置错误或无法连通,Mycat 启动时会因“连接数据源失败”报错:```bash# 1. 手动测试 Mycat 到 MySQL 数据源的网络连通性(以 masterA 为例)telnet 192.168.90.61 3306# 或用 nc 命令nc -zv 192.168.90.61 3306# 正常输出:succeeded!(失败则检查防火墙/安全组)# 2. 手动验证 MySQL 账号密码正确性(用 Mycat 配置的账号)mysql -h 192.168.90.61 -u mycat_user -pMycat@123# 若登录失败,检查:# - MySQL 账号是否存在:SELECT user, host FROM mysql.user WHERE user='mycat_user';# - 账号权限是否足够:GRANT ALL ON *.* TO 'mycat_user'@'%' IDENTIFIED WITH mysql_native_password BY 'Mycat@123';# - MySQL 服务是否正常:systemctl status mysqld# 3. 检查 MySQL 防火墙/安全组(放行 3306 端口)firewall-cmd --zone=public --add-port=3306/tcp --permanentfirewall-cmd --reload```## 七、第七步:排查依赖与元数据问题(Mycat 2.x 特有)Mycat 2.x 依赖“原型库(prototypeDs)”存储元数据,原型库配置错误会导致启动失败:```bash# 1. 检查原型库配置文件cat /usr/local/mycat/conf/datasources/prototypeDs.datasource.json# 核心要求:原型库必须是可连接的 MySQL 实例(可复用主库/独立库)# 2. 验证原型库连接mysql -h 192.168.90.61 -u mycat_user -pMycat@123 # 原型库配置的账号密码# 3. 检查依赖 jar 包(缺失会导致类加载失败)ls /usr/local/mycat/lib/ | grep -E "mycat2|mysql-connector-java"# 若缺失 mysql-connector-java(MySQL 驱动),手动下载放入 lib 目录wget https://repo1.maven.org/maven2/mysql/mysql-connector-java/8.0.33/mysql-connector-java-8.0.33.jar -P /usr/local/mycat/lib/```## 八、第八步:极端情况:恢复默认配置,逐步测试若以上排查均无效,可能是配置文件错乱,可通过“恢复默认+逐步添加配置”定位问题:```bash# 1. 备份当前配置(避免丢失)cp -r /usr/local/mycat/conf /usr/local/mycat/conf_bak_$(date +%Y%m%d)# 2. 删除自定义配置(保留默认原型库和用户配置)rm -rf /usr/local/mycat/conf/datasources/*.jsonrm -rf /usr/local/mycat/conf/clusters/*.jsonrm -rf /usr/local/mycat/conf/schemas/*.json# 3. 恢复默认原型库配置(从安装包复制,或手动创建)cat > /usr/local/mycat/conf/datasources/prototypeDs.datasource.json << EOF{"dbType":"mysql","idleTimeout":60000,"initSqls":[],"initSqlsGetConnection":true,"instanceType":"READ_WRITE","maxCon":1000,"maxConnectTimeout":3000,"maxRetryCount":5,"minCon":1,"name":"prototypeDs","password":"Mycat@123","type":"JDBC","url":"jdbc:mysql://192.168.90.61:3306/mysql?serverTimezone=Asia/Shanghai","user":"mycat_user","weight":0}EOF# 4. 启动 Mycat(若能启动,说明默认配置正常,问题在自定义配置)/usr/local/mycat/bin/mycat start# 5. 逐步添加自定义配置(每次添加一个文件,重启测试)# 先添加一个数据源 → 启动测试# 再添加集群 → 启动测试# 最后添加逻辑库 → 启动测试# 定位到导致失败的具体配置文件,针对性修改```## 九、常见故障案例与快速解决| 故障现象 | 排查流程 | 解决方法 ||-----------------------------------|-----------------------------------|-----------------------------------|| 执行 mycat start 无反应,日志无输出 | 1. 检查 JAVA_HOME;2. 检查 wrapper.log | 配置 JAVA_HOME,或重新安装 Mycat 启动器 || 启动提示“数据源连接失败” | 1. telnet 测试 MySQL 端口;2. 验证账号密码 | 放行 3306 端口,重新创建 MySQL 账号并授权 || JSON 语法错误导致启动失败 | 用 jq 工具校验所有配置文件 | 修复逗号、引号、大括号闭合问题 || 8066 端口被占用 | netstat 查找占用进程 | 停止占用进程,或修改 Mycat 端口 || 权限不足“Permission denied” | 检查 Mycat 目录权限 | chmod -R 755 /usr/local/mycat |## 十、排查总结(核心逻辑)Mycat 启动失败排查遵循“**先基础(环境、端口、权限)→ 再日志(定位方向)→ 最后配置(精准修复)** ”的逻辑,90% 的问题集中在:1. JDK 环境未配置或版本过低;2. 配置文件(JSON)语法错误;3. 数据源(MySQL)连接失败(IP/端口/账号/防火墙);4. 8066/9066 端口被占用;5. Mycat 目录权限不足。按以上流程逐步排查,均可定位并解决问题。若仍失败,可提供 `mycat.log` 和 `wrapper.log` 中的错误关键词,进一步精准分析。11:mysql之分库分表
今日工作任务路线图
一、工作场景
某电商公司业务飞速发展,其订单数据库数据量急剧增长,查询和写入性能显著下降。数据库管理员经过分析,决定采用分库分表策略。首先,依据业务模块将订单数据库拆分为用户订单库、商品订单库等多个数据库。然后,在每个库内对订单表按照订单创建时间进行分表,例如每个月的数据存于一个独立表。分库分表完成后,开发人员对应用程序的数据库连接和查询语句进行相应修改。经过测试和优化,系统的查询和写入性能大幅提升,满足了业务持续发展的需求。
二、为什么学
学习 MySQL 分库分表具有重要的现实意义。在当今数字化时代,各行业数据量呈爆炸式增长,企业应用的数据存储和处理面临巨大挑战。当单一数据库无法承受数据压力时,分库分表能有效提升数据库的性能和可扩展性。
掌握分库分表技术,能让你在处理海量数据时更加游刃有余,提高系统响应速度和稳定性。对于求职者而言,这是一项极具竞争力的技能,可增加进入大厂的机会。同时,深入理解该技术,能让你对数据库架构设计有更深刻的认识,为日后的技术进阶打下坚实基础。
三、环境准备
当前任务环节
3.1 机器准备
克隆5台机器
主机名 IP地址 说明 mycat63 192.168.90.63 分库策略 mysql59 192.168.90.59 master【马斯特】服务器 mysql60 192.168.90.60 slave【斯累夫】服务器 mysql61 192.168.90.61 master【马斯特】服务器 mysql62 192.168.90.62 slave【斯累夫】服务器 mycat63配置IP地址和主机名
Terminal window [root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.63/24 autoconnect【奥特欧 坑聂特】 yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160[root@mycat63 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mycat63mysql59配置IP地址和主机名
Terminal window [root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.59/24 autoconnect【奥特欧 坑聂特】 yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160[root@mysql59 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql59mysql60配置IP地址和主机名
Terminal window [root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.6/24 autoconnect【奥特欧 坑聂特】 yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160[root@mysql60 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql60mysql61配置IP地址和主机名
Terminal window [root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.61/24 autoconnect【奥特欧 坑聂特】 yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160[root@mysql61 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql61mysql62配置IP地址和主机名
Terminal window [root@localhost ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.62/24 autoconnect【奥特欧 坑聂特】 yes[root@localhost ~]# nmcli connection【肯耐申】 up ens160[root@mysql62 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql62 -
3.2 mycat【麦-凯特】分库分表原理
Mycat【麦-凯特】是用于MySQL分库分表的数据库中间件,能实现数据库水平扩展。其原理核心在于拦截并分析SQL语句。它位于应用层和数据库间,接收应用请求后,先由SQL解析引擎解析SQL,判断是否需分库分表;再通过路由层依据分片规则和算法,决定将SQL发往哪个分片。例如按user_id取模拆分数据,Mycat【麦-凯特】解析查询语句后,会自动路由到对应数据库查询。最终,后端连接池管理数据库连接,处理结果后返回给用户,以此提升性能和可扩展性 。
<think></think>Mycat 的分库分表原理可以简单理解为:**通过中间件层对数据进行逻辑拆分,并按照规则路由到不同的物理数据库/表,从而实现对大规模数据的分布式存储和访问**。具体可以从以下几个核心层面来拆解:
### 1. **数据的逻辑拆分:从“一张大表”到“多张小表”**Mycat 首先将业务中的“大表”(比如千万级以上的订单表、用户表)在逻辑上拆分成多个“小表”,同时将存储这些小表的数据库也拆分成多个“分库”。- **逻辑表**:拆分前的大表在 Mycat 中被抽象为“逻辑表”(比如 `order` 表),客户端访问时只需要操作这个逻辑表,无需关心底层物理拆分。- **物理表**:逻辑表被拆分成的实际小表(比如 `order_001`、`order_002`),分布在不同的分库中。- **数据节点(DataNode)**:每个分库或分表所在的物理存储位置(通常对应某个 MySQL 实例的具体数据库),比如 `dn1` 对应 `db1` 库,`dn2` 对应 `db2` 库。
### 2. **分片规则:决定数据“去哪存、去哪查”**核心问题是“如何拆分”,Mycat 通过**分片规则**(Sharding Rule)来决定每条数据应该存到哪个分库或分表,以及查询时应该从哪个分库/分表获取数据。常见规则包括:- **范围分片**:按字段范围拆分(如订单表按时间:2023年数据存 `dn1`,2024年存 `dn2`)。- **哈希分片**:对字段(如用户 ID)做哈希计算,结果映射到不同分库(如 `user_id % 4` 决定存到 `dn0`~`dn3`)。- **枚举分片**:按固定值拆分(如按地区:北京用户存 `dn1`,上海用户存 `dn2`)。- **复合分片**:结合多种规则(如先按时间范围分库,再按用户 ID 哈希分表)。
这些规则配置在 Mycat 的 `schema.xml` 或分片规则文件中,Mycat 会根据规则自动路由数据。
### 3. **中间件的路由与整合:对客户端“透明”**Mycat 作为中间件,扮演“代理”角色,屏蔽了底层分库分表的复杂性,客户端(如应用程序)只需像访问单库单表一样操作 Mycat:- **SQL 解析**:客户端发送 SQL 到 Mycat(如 `select * from order where user_id=100`),Mycat 先解析 SQL,识别涉及的逻辑表、过滤条件(如 `user_id`)。- **规则匹配与路由**:根据解析结果和分片规则,计算数据所在的物理分库/分表(比如通过哈希规则确定 `user_id=100` 对应 `dn2` 库的 `order_002` 表)。- **转发执行**:Mycat 将 SQL 改写为针对物理表的语句(如 `select * from db2.order_002 where user_id=100`),转发到对应的 MySQL 实例执行。- **结果整合**:如果查询涉及多个分库/分表(如 `select count(*) from order`),Mycat 会并行查询所有相关节点,汇总结果后返回给客户端,让客户端感觉数据来自“一个库”。
### 4. **与底层数据库的交互:连接池与事务协调**- **连接池管理**:Mycat 维护与各分库的连接池,避免频繁创建/关闭连接,提高性能。- **事务支持**:对于跨分库的分布式事务,Mycat 可通过 XA 协议或本地消息表等方式协调,保证事务的一致性(如跨库转账时,要么都成功,要么都回滚)。
### 总结Mycat 分库分表的核心是“**逻辑抽象 + 规则路由 + 中间件代理**”:通过拆分大表减轻单库压力,通过规则明确数据位置,通过中间件屏蔽底层复杂性,让应用无需改动代码即可访问分布式数据。这也是它在高并发、大数据场景中常用的原因~
四、配置二主二从
当前任务环节
4.1 把MySQL60配置为MySQL59的从服务器
1)配置主服务器MySQL59
# 启用binlog日志[root@mysql59 ~]# yum –y install【因-斯多】 mysql-server mysql# [root@mysql59 ~]# yum -y install ./rpm/*[root@mysql59 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld# [root@mysql59 ~]# systemctl enable mysqld --now[root@mysql59 ~]# vim /etc/my.cnf.d/mysql-server.cnf# [root@mysql59 ~]# grep -vE "^\s*(#|$)" /etc/my.cnf# [mysqld]# server-id=59 # 增加这两项# log-bin=mysql59 # 增加这两项# datadir=/var/lib/mysql# socket=/var/lib/mysql/mysql.sock# log-error=/var/log/mysqld.log# pid-file=/var/run/mysqld/mysqld.pid
[root@mysql59 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld# [root@mysql59 ~]# systemctl restart mysqld
# 用户授权[root@mysql59 ~]# mysql
# 创建用户mysql> create【克瑞特】 user repluser@"%" identified【爱-丹-提伐】 by【拜】 "123qqq...A";# mysql> create user repluser@"%" identified by "123qqq...A";# Query OK, 0 rows affected (0.03 sec)
# 授予权限mysql> grant【古亮普】 replication【瑞普利K申】 slave【斯累夫】 on【昂】 *.* to repluser@"%";# mysql> grant replication slave on *.* to repluser@"%";# Query OK, 0 rows affected (0.02 sec)
# 查看日志信息mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】;# mysql> show master status;# +----------------+----------+--------------+------------------+-------------------+# | File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |# +----------------+----------+--------------+------------------+-------------------+# | mysql59.000002 | 6760 | | | |# +----------------+----------+--------------+------------------+-------------------+# 1 row in set (0.00 sec)2)配置slave【斯累夫】服务器MySQL60
# 指定server-id 并重启数据库服务[root@mysql60 ~]# yum –y install【因-斯多】 mysql-serv er mysql[root@mysql60 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld[root@mysql60 ~]# vim /etc/my.cnf.d/mysql-server.cnf# [root@mysql60 ~]# grep -vE "^\s*(#|$)" /etc/my.cnf# [mysqld]# server-id=60 # 增加这项# datadir=/var/lib/mysql# socket=/var/lib/mysql/mysql.sock# log-error=/var/log/mysqld.log# pid-file=/var/run/mysqld/mysqld.pid
[root@mysql60 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld# [root@mysql60 ~]# systemctl restart mysqld
# 登陆服务指定主服务器信息[root@mysql60 ~]# mysql
mysql> change【趁(chèn)吉】 master【马斯特】 to master【马斯特】_host="192.168.90.59" , master【马斯特】_user="repluser" , master【马斯特】_password="123qqq...A" ,master【马斯特】_log_file="mysql59.000001" , master【马斯特】_log_pos=667;mysql> change master to # master_host="192.168.88.59",master_user="repluser",master_password="123qqq...A",master_log_file="mysql59.000002",master_log_pos=6760;# Query OK, 0 rows affected, 8 warnings (0.13 sec)
# 启动slave【斯累夫】进程mysql> start【s 达儿】 slave【斯累夫】 ;# mysql> start slave;# Query OK, 0 rows affected, 1 warning (0.07 sec)
# 查看状态信息mysql> show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】 \G# [root@mysql60 ~]# mysql -uroot -p123 -e "show slave status \G" | grep -E "Slave_IO_Running|Slave_SQL_Running"# mysql: [Warning] Using a password on the command line interface can be insecure.# Slave_IO_Running: Yes # 这两个线程连接为YES表示同步设置成功# Slave_SQL_Running: Yes # 这两个线程连接为YES表示同步设置成功# Slave_SQL_Running_State: Replica has read all relay log; waiting for more updates4.2 把MySQL62配置为MySQL61的从服务器
1)配置主服务器MySQL61
# 启用binlog日志[root@mysql61 ~]# yum –y install【因-斯多】 mysql-server mysql[root@mysql61 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld[root@mysql61 ~]# vim /etc/my.cnf.d/mysql-server.cnf[root@mysql61 ~]# grep -vE "^\s*(#|$)" /etc/my.cnf# [mysqld]# server-id=61 # 增加这两项# log-bin=mysql61 # 增加这两项# datadir=/var/lib/mysql# socket=/var/lib/mysql/mysql.sock# log-error=/var/log/mysqld.log# pid-file=/var/run/mysqld/mysqld.pid
[root@mysql61 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld# [root@mysql61 ~]# systemctl restart mysqld
# 用户授权[root@mysql61 ~]# mysql
# 创建用户mysql> create【克瑞特】 user repluser@"%" identified【爱-丹-提伐】 by【拜】 "123qqq...A";# mysql> create user repluser@"%" identified by "123qqq...A";# Query OK, 0 rows affected (0.02 sec)
# 授予权限mysql> grant【古亮普】 replication【瑞普利K申】 slave【斯累夫】 on【昂】 *.* to repluser@"%";# mysql> grant replication slave on *.* to repluser@"%";# Query OK, 0 rows affected (0.03 sec)
# 查看日志信息mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】;# mysql> show master status;# +----------------+----------+--------------+------------------+-------------------+# | File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |# +----------------+----------+--------------+------------------+-------------------+# | mysql61.000001 | 697 | | | |# +----------------+----------+--------------+------------------+-------------------+# 1 row in set (0.00 sec)2)配置slave【斯累夫】服务器MySQL62
# 指定server-id 并重启数据库服务[root@mysql62 ~]# yum –y install【因-斯多】 mysql-server mysql[root@mysql62 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld[root@mysql62 ~]# vim /etc/my.cnf.d/mysql-server.cnf# [root@mysql62 ~]# grep -vE "^\s*(#|$)" /etc/my.cnf# [mysqld]# server-id=62# datadir=/var/lib/mysql# socket=/var/lib/mysql/mysql.sock# log-error=/var/log/mysqld.log# pid-file=/var/run/mysqld/mysqld.pid
[root@mysql62 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 mysqld# [root@mysql62 ~]# systemctl restart mysqld
# 登陆服务指定主服务器信息[root@mysql62 ~]# mysql
mysql> change【趁(chèn)吉】 master【马斯特】 to master【马斯特】_host="192.168.90.61" , master【马斯特】_user="repluser" , master【马斯特】_password="123qqq...A" ,master【马斯特】_log_file="mysql61.000001" , master【马斯特】_log_pos=667;# mysql> change master to master_host="192.168.88.61",master_user="repluser",master_password="123qqq...A",master_log_file="mysql61.000001",master_log_pos=697;# Query OK, 0 rows affected, 8 warnings (0.11 sec)
# 启动slave【斯累夫】进程mysql> start【s 达儿】 slave【斯累夫】 ;# mysql> start slave;# Query OK, 0 rows affected, 1 warning (0.10 sec)
# 查看状态信息mysql> show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】 \G# [root@mysql62 ~]# mysql -uroot -p123 -e "show slave status \G" | grep -E "Slave_IO_Running|Slave_SQL_Running"# Slave_IO_Running: Yes # IO线程# Slave_SQL_Running: Yes # SQL线程# .........五、配置为mycat【麦-凯特】服务器
当前任务环节
5.1 mycat【麦-凯特】安装部署
1)拷贝软件到mycat63主机
mycat2-1.21-release-jar-with-dependencies.jar
mycat2**-install-**template-1.21.zip
2)安装mycat【麦-凯特】软件
# 安装jdk[root@mycat63 ~]# yum -y install【因-斯多】 java-1.8.0-openjdk.x86_64# [root@mycat63 ~]# yum -y install java-1.8.0-openjdk.x86_64
# 安装mycat[root@mycat63 ~]# which unzip || yum -y install【因-斯多】 unzip# [root@mycat63 ~]# which unzip || yum -y install unzip
[root@mycat63 ~]# unzip mycat2-install-template-1.21.zip# [root@mycat63 ~]# unzip mycat2-install-template-1.21.zip
[root@mycat63 ~]# mv mycat /usr/local/# [root@mycat63 ~]# mv mycat /usr/local/
# 安装依赖[root@mycat63 ~]# cp mycat2-1.21-release-jar-with-dependencies.jar /usr/local/mycat/lib/# [root@mycat63 ~]# mv mycat2-1.21-release-jar-with-dependencies.jar /usr/local/mycat/lib/
# 修改权限[root@mycat63 ~]# chmod -R 777 /usr/local/mycat/# [root@mycat63 ~]# chmod -R 777 /usr/local/mycat/5.2 配置mycat【麦-凯特】登录账号密码
[root@mycat63 ~]# vim /usr/local/mycat/conf/users/root.user.json{ "dialect":"mysql", "ip":null, "password":"654321", "transactionType":"proxy", "username":"mycat"}5.3 配置mycat【麦-凯特】连接本机数据库
[root@mycat63 ~]# vim /usr/local/mycat/conf/datasources/prototypeDs.datasource.json{ "dbType":"mysql", "idleTimeout":60000, "initSqls":[], "initSqlsGetConnection":true, "instanceType":"READ_WRITE", "maxCon":1000, "maxConnectTimeout":3000, "maxRetryCount":5, "minCon":1, "name":"prototypeDs", "password":"123456", 密码 "type":"JDBC", "url":"jdbc:mysql://localhost:3306/mysql?useUnicode=true&serverTimezone=Asia/Shanghai&characterEncoding=UTF-8", 连接本机的数据库服务 "user":"jam", 用户名 "weight":0}5.4 安装mysql数据库配置账号
[root@mycat63 ~]# yum -y install【因-斯多】 mysql-server mysql[root@mycat63 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld
# 创建jam用户[root@mycat63 ~]# mysql
# 创建用户mysql> create【克瑞特】 user jam@"%" identified【爱-丹-提伐】 by【拜】 "123456";# mysql> create user jam@"%" identified by "123456";# Query OK, 0 rows affected (0.02 sec)
# 授予权限mysql> grant【古亮普】 all on【昂】 *.* to jam@"%" ;# mysql> grant all on *.* to jam@"%";# Query OK, 0 rows affected (0.17 sec)
mysql> exitBye[root@mycat63 ~]#六、mycat【麦-凯特】配置数据源
当前任务环节
6.1 启动mycat【麦-凯特】服务
[root@mycat63 ~]# /usr/local/mycat/bin/mycat helpUsage: /usr/local/mycat/bin/mycat { console | start | stop | restart | status | dump }
[root@mycat63 ~]# /usr/local/mycat/bin/mycat start【s 达儿】Starting mycat2...
# 半分钟左右 能看到端口[root@mycat63 ~]# netstat -utnlp | grep 8066tcp6 0 0 :::8066 :::* LISTEN 57015/java[root@mycat63 ~]#6.2 连接mycat【麦-凯特】服务器
[root@mycat63 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321
mysql> show【瘦】 databases;# mysql> show databases;# +--------------------+# | `Database` |# +--------------------+# | information_schema |# | mysql |# | performance_schema |# +--------------------+# 3 rows in set (0.20 sec)6.3 添加数据源
1)连接本机的mycat【麦-凯特】服务,添加数据源
[root@mycat63 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321
# 添加MySQL59MySQL> /*+ mycat:createdatasource{"name":"dw0", "url":"jdbc:mysql://192.168.90.59:3306","user":"jam","password":"123456"}*/;# mysql> /*+ mycat:createdatasource{"name":"dw0", "url":"jdbc:mysql://192.168.88.59:3306","user":"jam","password":"123456"}*/;# Query OK, 0 rows affected (0.02 sec)
# 添加MySQL60Mysql> /*+ mycat:createdatasource{"name":"dr0", "url":"jdbc:mysql://192.168.90.60:3306","user":"jam","password":"123456"}*/;# mysql> /*+ mycat:createdatasource{"name":"dr0", "url":"jdbc:mysql://192.168.88.60:3306","user":"jam","password":"123456"}*/;# Query OK, 0 rows affected (0.01 sec)
# 添加MySQL61Mysql> /*+ mycat:createdatasource{"name":"dw1", "url":"jdbc:mysql://192.168.90.61:3306","user":"jam","password":"123456"}*/;# mysql> /*+ mycat:createdatasource{"name":"dw1", "url":"jdbc:mysql://192.168.88.61:3306","user":"jam","password":"123456"}*/;# Query OK, 0 rows affected (0.01 sec)
# 添加MySQL62Mysql> /*+ mycat:createdatasource{"name":"dr1", "url":"jdbc:mysql://192.168.90.62:3306","user":"jam","password":"123456"}*/;# mysql> /*+ mycat:createdatasource{"name":"dr1", "url":"jdbc:mysql://192.168.88.62:3306","user":"jam","password":"123456"}*/;# Query OK, 0 rows affected (0.01 sec)2)查看存放目录
[root@mycat63 ~]# ls /usr/local/mycat/conf/datasources/dr0.datasource.json dr1.datasource.json dw0.datasource.json dw1.datasource.json prototypeDs.datasource.json3)查看数据信息
mysql> /*+mycat:showDataSources{}*/ \G*************************** 1. row *************************** NAME: dw0 USERNAME: jam PASSWORD: 123456 MAX_CON: 1000 MIN_CON: 1 EXIST_CON: 0 USE_CON: 0 MAX_RETRY_COUNT: 5 MAX_CONNECT_TIMEOUT: 30000 DB_TYPE: mysql URL: jdbc:mysql://192.168.90.59:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true WEIGHT: 0 INIT_SQL:INIT_SQL_GET_CONNECTION: true INSTANCE_TYPE: READ_WRITE IDLE_TIMEOUT: 60000 DRIVER: { CreateTime:"2025-05-08 16:10:26", ActiveCount:0, PoolingCount:0, CreateCount:0, DestroyCount:0, CloseCount:0, ConnectCount:0, Connections:[ ]} TYPE: JDBC IS_MYSQL: true*************************** 2. row *************************** NAME: dw1 USERNAME: jam PASSWORD: 123456 MAX_CON: 1000 MIN_CON: 1 EXIST_CON: 0 USE_CON: 0 MAX_RETRY_COUNT: 5 MAX_CONNECT_TIMEOUT: 30000 DB_TYPE: mysql URL: jdbc:mysql://192.168.90.61:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true WEIGHT: 0 INIT_SQL:INIT_SQL_GET_CONNECTION: true INSTANCE_TYPE: READ_WRITE IDLE_TIMEOUT: 60000 DRIVER: { CreateTime:"2025-05-08 16:10:26", ActiveCount:0, PoolingCount:0, CreateCount:0, DestroyCount:0, CloseCount:0, ConnectCount:0, Connections:[ ]} TYPE: JDBC IS_MYSQL: true*************************** 3. row *************************** NAME: dr0 USERNAME: jam PASSWORD: 123456 MAX_CON: 1000 MIN_CON: 1 EXIST_CON: 0 USE_CON: 0 MAX_RETRY_COUNT: 5 MAX_CONNECT_TIMEOUT: 30000 DB_TYPE: mysql URL: jdbc:mysql://192.168.90.61:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true WEIGHT: 0 INIT_SQL:INIT_SQL_GET_CONNECTION: true INSTANCE_TYPE: READ_WRITE IDLE_TIMEOUT: 60000 DRIVER: { CreateTime:"2025-05-08 16:10:26", ActiveCount:0, PoolingCount:0, CreateCount:0, DestroyCount:0, CloseCount:0, ConnectCount:0, Connections:[ ]} TYPE: JDBC IS_MYSQL: true*************************** 4. row *************************** NAME: dr1 USERNAME: jam PASSWORD: 123456 MAX_CON: 1000 MIN_CON: 1 EXIST_CON: 0 USE_CON: 0 MAX_RETRY_COUNT: 5 MAX_CONNECT_TIMEOUT: 30000 DB_TYPE: mysql URL: jdbc:mysql://192.168.90.62:3306?useUnicode=true&serverTimezone=Asia/Shanghai&characterEncoding=UTF-8&autoReconnect=true WEIGHT: 0 INIT_SQL:INIT_SQL_GET_CONNECTION: true INSTANCE_TYPE: READ_WRITE IDLE_TIMEOUT: 60000 DRIVER: { CreateTime:"2025-05-08 16:10:26", ActiveCount:0, PoolingCount:0, CreateCount:0, DestroyCount:0, CloseCount:0, ConnectCount:0, Connections:[ ]} TYPE: JDBC IS_MYSQL: true*************************** 5. row *************************** NAME: prototypeDs USERNAME: jam PASSWORD: 123456 MAX_CON: 1000 MIN_CON: 1 EXIST_CON: 0 USE_CON: 0 MAX_RETRY_COUNT: 5 MAX_CONNECT_TIMEOUT: 3000 DB_TYPE: mysql URL: jdbc:mysql://localhost:3306/mysql?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true WEIGHT: 0 INIT_SQL:INIT_SQL_GET_CONNECTION: true INSTANCE_TYPE: READ_WRITE IDLE_TIMEOUT: 60000 DRIVER: { CreateTime:"2025-05-08 16:10:26", ActiveCount:0, PoolingCount:0, CreateCount:0, DestroyCount:0, CloseCount:0, ConnectCount:0, Connections:[ ]} TYPE: JDBC IS_MYSQL: true5 rows in set (0.07 sec)mysql>6.4 配置数据库服务器
1)在主服务器添加jam用户
[root@mysql59 ~]# mysqlmysql> create【克瑞特】 user jam@"%" identified【爱-丹-提伐】 by【拜】 "123456";# mysql> create user jam@"%" identified by "123456";# Query OK, 0 rows affected (0.01 sec)Mysql> grant【古亮普】 all on【昂】 *.* to jam@"%";# mysql> grant all on *.* to jam@"%";# Query OK, 0 rows affected (0.07 sec)
[root@mysql61 ~]# mysqlmysql> create【克瑞特】 user jam@"%" identified【爱-丹-提伐】 by【拜】 "123456";# mysql> create user jam@"%" identified by "123456";# Query OK, 0 rows affected (0.02 sec)Mysql> grant【古亮普】 all on【昂】 *.* to jam@"%";# mysql> grant all on *.* to jam@"%";# Query OK, 0 rows affected (0.02 sec)2)在从服务器查看用户是否同步
[root@mysql60 ~]# mysql -e 'select【涩莱克特】 user from【弗乱】 mysql.user where【威尔】 user="jam"'# mysql> select user from mysql.user where user="jam";# +------+# | user |# +------+# | jam |# +------+# 1 row in set (0.00 sec)
[root@mysql62 ~]# mysql -e 'select【涩莱克特】 user from【弗乱】 mysql.user where【威尔】 user="jam"'# mysql> select user from mysql.user where user="jam";# +------+# | user |# +------+# | jam |# +------+# 1 row in set (0.00 sec)6.5 创建集群
1)连接本机的mycat【麦-凯特】服务,创建集群
[root@mycat63 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321mysql> /*!mycat:createcluster{"name":"c0","masters":["dw0"],"replicas":["dr0"]}*/;mysql> /*!mycat:createcluster{"name":"c1","masters":["dw1"],"replicas":["dr1"]}*/;2)创建的集群保存在mycat【麦-凯特】安装目录下
[root@MySQL63 ~]# ls /usr/local/mycat/conf/clusters/c0.cluster.json c1.cluster.json prototype.cluster.json3)查看集群信息
mysql> /*+ mycat:showClusters{}*/ \G*************************** 1. row *************************** NAME: prototype SWITCH_TYPE: SWITCHMAX_REQUEST_COUNT: 200 TYPE: BALANCE_ALL WRITE_DS: prototypeDs READ_DS: prototypeDs WRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1 READ_L: io.mycat.plug.loadBalance.BalanceRandom$1 AVAILABLE: true*************************** 2. row *************************** NAME: c0 SWITCH_TYPE: SWITCHMAX_REQUEST_COUNT: 2000 TYPE: BALANCE_ALL WRITE_DS: dw0 READ_DS: dw0,dr0 WRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1 READ_L: io.mycat.plug.loadBalance.BalanceRandom$1 AVAILABLE: true*************************** 3. row *************************** NAME: c1 SWITCH_TYPE: SWITCHMAX_REQUEST_COUNT: 2000 TYPE: BALANCE_ALL WRITE_DS: dw1 READ_DS: dw1,dr1 WRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1 READ_L: io.mycat.plug.loadBalance.BalanceRandom$1 AVAILABLE: true3 rows in set (0.03 sec)mysql>七、分库分表策略
当前任务环节
7.1 全局表
在客户端client50 连接mycat63 存储数据 ,验证mycat63的配置
全局表 数据会插入到两个库中,并且两个库中都有全部的数据。
//在mycat63 连接本机的mycat服务建库[root@mycat63 ~]# mysql -h127.0.0.1 -umycat -p654321 -P8066
mysql> create【克瑞特】 database moershi;# mysql> create database moershi;# Query OK, 0 rows affected (0.09 sec)
mysql> exitBye配置文件存放位置
[root@mycat63 ~]# ls /usr/local/mycat/conf/schemas/moershi.schema.json/usr/local/mycat/conf/schemas/moershi.schema.json创建全局表
broadcast【布落德卡斯特】:全局表关键字
broadcast 广播规则:建表时指定了 broadcast,这是 Mycat 的一种分片规则,意思是 “将操作广播到所有关联的数据节点”,建表语句会被广播到逻辑库关联的所有物理节点(主库 + 从库)。
# 客户端client50 连接mycat63主机的 建表存储数据[root@client50 ~]# mysql -h192.168.90.63 -umycat -p654321 -P8066
mysql> create【克瑞特】 table【忒-部】 moershi.dept(dept_id int【因特】 , dept_name char【查尔】(10),primary【普赖莫瑞】 key【kì】(dept_id)) default【迪-佛特】 charset【查赛特】 utf8 broadcast【布落德卡斯特】;# mysql> create table moershi.dept(# -> dept_id int,# -> dept_name char(10),# -> primary key(dept_id)# -> )default charset utf8 broadcast;# Query OK, 0 rows affected (1 min 0.20 sec)
# 插入记录mysql> insert【因涩特】 into【因兔】 moershi.dept values【挖柳斯】(1,"开发部"),(2,"运维部"),(3,"测试部");# mysql> insert into moershi.dept values(1,"开发部"),(2,"运维部"),(3,"测试部");# Query OK, 1 row affected (0.07 sec)
# 查看记录mysql> select【涩莱克特】 * from【弗乱】 moershi.dept;# mysql> select * from moershi.dept;# +---------+-----------+# | dept_id | dept_name |# +---------+-----------+# | 1 | 开发部 |# | 2 | 运维部 |# | 3 | 测试部 |# +---------+-----------+# 3 rows in set (0.00 sec)在4台数据库服务器查看
[root@mysql59 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 moershi.dept'# [root@mysql59 ~]# mysql -uroot -p123 -e "select * from moershi.dept"+---------+-----------+| dept_id | dept_name |+---------+-----------+| 1 | 开发部 || 2 | 运维部 || 3 | 测试部 |+---------+-----------+
[root@mysql60 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 moershi.dept'# m[root@mysql60 ~]# mysql -uroot -p123 -e "select * from moershi.dept"+---------+-----------+| dept_id | dept_name |+---------+-----------+| 1 | 开发部 || 2 | 运维部 || 3 | 测试部 |+---------+-----------+
[root@mysql61 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 moershi.dept'# [root@mysql61 ~]# mysql -uroot -p123 -e "select * from moershi.dept"+---------+-----------+| dept_id | dept_name |+---------+-----------+| 1 | 开发部 || 2 | 运维部 || 3 | 测试部 |+---------+-----------+
[root@mysql62 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 moershi.dept'# [root@mysql62 ~]# mysql -uroot -p123 -e "select * from moershi.dept"+---------+-----------+| dept_id | dept_name |+---------+-----------+| 1 | 开发部 || 2 | 运维部 || 3 | 测试部 |+---------+-----------+7.2 分片表
原理
Mycat 中分片表的原理和用法:
一句话总结:
“把一张大表的数据,按规则‘拆开’存到多个库、多个表里,查的时候 Mycat 自动帮你拼回来。”
举个生活例子:快递分拣中心
想象你开了一个超大快递公司(数据库),每天有 100 万件包裹(数据)。
- 如果所有包裹都堆在一个仓库(单库单表)→ 找起来慢、容易堵死。
- 于是你建了 2 个分拣中心(分库),每个中心再分 1 个货架区(分表)。
- 规则:按收件人手机号最后一位数字 % 2
- 偶数 → 送 1 号中心
- 奇数 → 送 2 号中心
这样:
- 每个中心只处理 50 万件,压力小;
- 要找“张三”的包裹?直接去他手机号对应的中心,不用跑遍全国!
对应回你的 SQL
CREATE TABLE moershi.employees ( employee_id INT PRIMARY KEY, -- ← 相当于“手机号” name CHAR(10), dept_id INT, mail VARCHAR(30))DEFAULT CHARSET utf8DBPARTITION BY MOD_HASH(employee_id) -- 按 employee_id 分“库”DBPARTITIONS 2 -- 拆成 2 个库(比如 59 和 61)TBPARTITION BY MOD_HASH(employee_id) -- 按 employee_id 分“表”TBPARTITIONS 1; -- 每个库里只建 1 张表(不分表)拆解说明:
| 关键词 | 作用 | 大白话 |
|---|---|---|
DBPARTITION BY | 分库规则 | 数据往哪个“物理服务器”存? |
DBPARTITIONS 2 | 分 2 个库 | 用 2 台 MySQL 机器(59 和 61) |
TBPARTITION BY | 分表规则 | 在一个库里,数据放哪张“物理表”? |
TBPARTITIONS 1 | 每库 1 张表 | 不分表,就叫 employees_0 或 employees_1 |
因为你
TBPARTITIONS=1,所以其实没分表,只分了库。
如果写TBPARTITIONS 12,那每个库里会有 12 张表(如employees_0,employees_1, …,employees_11)。
数据怎么存?怎么查?
插入数据:
INSERT INTO employees VALUES (1, '张三', ...); -- employee_id = 1- Mycat 计算:
1 % 2 = 1→ 存到 第 1 个库(比如 192.168.88.61) - 物理表名:
moershi_1.employees_0(Mycat 自动生成)
INSERT INTO employees VALUES (2, '李四', ...); -- employee_id = 2-
2 % 2 = 0→ 存到 第 0 个库(比如 192.168.88.59) -
物理表名:
moershi_0.employees_0查询数据:
SELECT * FROM employees WHERE employee_id = 1;- Mycat 算出
1 % 2 = 1→ 只去 61 机器查,秒回!
SELECT * FROM employees; -- 没带条件- Mycat 会去 59 和 61 都查一遍,再把结果合并给你(慢!尽量避免)
什么时候用分片表?
| 场景 | 建议 |
|---|---|
| 表数据 > 500 万行 | ✅ 考虑分片 |
经常按 user_id/order_id 查询 | ✅ 用这个字段做分片键 |
| 需要 JOIN 其他表 | ✅ 让关联表用相同分片规则(ER 表) |
| 查询不带分片键 | ❌ 尽量避免(会全库扫描) |
注意事项(避坑指南)
- 分片键必须出现在 WHERE 条件里,否则 Mycat 会查所有库!
- 不要用
SELECT *无条件查询大表,性能爆炸。 - 分片后不能直接用自增主键(不同库可能重复),建议用雪花 ID。
- DDL(改表结构)要小心:需在所有物理表上同步执行。
总结(背下来!)
DBPARTITION= 分库(多台机器)TBPARTITION= 分表(一个库里多张表)MOD_HASH(id)= 按 id 取模,均匀分布- 分片键 = 你最常用来查数据的那个字段(如 user_id)
- Mycat 是“智能快递员”,自动投递和取件,你只管用逻辑表名!
实操
dbpartition【db-帕踢神】 定义分库使用的分片规则,
tbpartition【tb-帕踢神】 定义分表使用的分片规则。
mod【莫德】_hash【哈希】 分片规则,用employee【ing普洛伊】_id表头的值做取模计算
tbpartitions【tb-帕踢神s】 1 表的分片数量
dbpartitions【db-帕踢神s】 2 库的分片数量
# 连接mycat服务建表[root@client50 ~]# mysql -h192.168.90.63 -P8066 -umycat –p654321
create【克瑞特】 table【忒-部】 moershi.employees【ing普洛伊s】(employee【ing普洛伊】_id int【因特】 primary【普赖莫瑞】 key【kì】,name char【查尔】(10),dept_id int【因特】 ,mail varchar【瓦儿-查儿】(30)) default【迪-佛特】 charset【查赛特】 utf8dbpartition【db-帕踢神】 by【拜】 mod【莫德】_hash【哈希】(employee【ing普洛伊】_id) tbpartition【tb-帕踢神】 by【拜】 mod【莫德】_hash【哈希】(employee【ing普洛伊】_id)tbpartitions【tb-帕踢神s】 1 dbpartitions【db-帕踢神s】 2;
# mysql> create table moershi.employees(# -> employee_id int primary key,# -> name char(10),# -> dept_id int,# -> mail varchar(30)# -> )default charset utf8# -> dbpartition by mod_hash(employee_id) tbpartition by mod_hash(employee_id)# -> tbpartitions 1 dbpartitions 2;# Query OK, 1 row affected (1.24 sec)在4台数据库服务器查看表
[root@mysql59 ~]# mysql -e 'show【瘦】 databases'# [root@mysql59 ~]# mysql -uroot -p123 -e "show databases;"# mysql: [Warning] Using a password on the command line interface can be insecure.# +--------------------+# | Database |# +--------------------+# | information_schema |# | moershi |# | moershi_0 |# | mysql |# | performance_schema |# | sys |# +--------------------+
[root@mysql59 ~]# mysql -e 'use moershi_0 ; show【瘦】 tables【忒-部s】'# [root@mysql59 ~]# mysql -uroot -p123 -e "use moershi_0;show tables"# mysql: [Warning] Using a password on the command line interface can be insecure.# +---------------------+# | Tables_in_moershi_0 |# +---------------------+# | employees_0 |# +---------------------+
[root@mysql60 ~]# mysql -e 'show【瘦】 databases'# [root@mysql60 ~]# mysql -uroot -p123 -e "show databases;"# mysql: [Warning] Using a password on the command line interface can be insecure.# +--------------------+# | Database |# +--------------------+# | information_schema |# | moershi |# | moershi_0 |# | mysql |# | performance_schema |# | sys |# +--------------------+
[root@mysql60 ~]# mysql -e 'use moershi_0 ; show【瘦】 tables【忒-部s】'# [root@mysql60 ~]# mysql -uroot -p123 -e "use moershi_0;show tables"# mysql: [Warning] Using a password on the command line interface can be insecure.# +---------------------+# | Tables_in_moershi_0 |# +---------------------+# | employees_0 |# +---------------------+
[root@mysql61 ~]# mysql -e 'show【瘦】 databases'# [root@mysql61 ~]# mysql -uroot -p123 -e "show databases;"# mysql: [Warning] Using a password on the command line interface can be insecure.# +--------------------+# | Database |# +--------------------+# | information_schema |# | moershi |# | moershi_1 |# | mysql |# | performance_schema |# | sys |# +--------------------+
[root@mysql61 ~]# mysql -e 'use moershi_1;show【瘦】 tables【忒-部s】'# [root@mysql61 ~]# mysql -uroot -p123 -e "use moershi_1;show tables"# mysql: [Warning] Using a password on the command line interface can be insecure.# +---------------------+# | Tables_in_moershi_1 |# +---------------------+# | employees_1 |# +---------------------+
[root@mysql62 ~]# mysql -e 'show【瘦】 databases'# [root@mysql62 ~]# mysql -uroot -p123 -e "show databases;"# mysql: [Warning] Using a password on the command line interface can be insecure.# +--------------------+# | Database |# +--------------------+# | information_schema |# | moershi |# | moershi_1 |# | mysql |# | performance_schema |# | sys |# +--------------------+
[root@mysql62 ~]# mysql -e 'use moershi_1;show【瘦】 tables【忒-部s】'# [root@mysql62 ~]# mysql -uroot -p123 -e "use moershi_1;show tables"# mysql: [Warning] Using a password on the command line interface can be insecure.# +---------------------+# | Tables_in_moershi_1 |# +---------------------+# | employees_1 |# +---------------------+存储数据
[root@client50 ~]# mysql -h192.168.90.63 -P8066 -umycat –p654321
mysql> insert【因涩特】 into【因兔】 moershi.employees【ing普洛伊s】 values【挖柳斯】 (9,"a","1","a@163.com");# mysql> insert into moershi.employees values(9,"a","1","a@163.com");# Query OK, 1 row affected (0.04 sec)
mysql> insert【因涩特】 into【因兔】 moershi.employees【ing普洛伊s】 values【挖柳斯】 (8,"B","3","B@QQ.com");# mysql> insert into moershi.employees values(8,"B","3","B@QQ.com");# Query OK, 1 row affected (0.02 sec)
mysql> insert【因涩特】 into【因兔】 moershi.employees【ing普洛伊s】 values【挖柳斯】 (7,"C","2","c@QQ.com");# mysql> insert into moershi.employees values(7,"C","2","c@QQ.com");# Query OK, 1 row affected (0.02 sec)
mysql> insert【因涩特】 into【因兔】 moershi.employees【ing普洛伊s】 values【挖柳斯】 (6,"C","2","c@QQ.com");# mysql> insert into moershi.employees values(6,"C","2","c@QQ.com");# Query OK, 1 row affected (0.01 sec)
mysql> select【涩莱克特】 * from【弗乱】 moershi.employees【ing普洛伊s】;# mysql> select * from moershi.employees;# +-------------+------+---------+-----------+# | employee_id | name | dept_id | mail |# +-------------+------+---------+-----------+# | 6 | C | 2 | c@QQ.com |# | 8 | B | 3 | B@QQ.com |# | 7 | C | 2 | c@QQ.com |# | 9 | a | 1 | a@163.com |# +-------------+------+---------+-----------+# 4 rows in set (1.53 sec)在数据库服务器本机查看数据
[root@mysql59 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 moershi_0.employees【ing普洛伊s】_0'# [root@mysql59 ~]# mysql -uroot -p123 -e "select * from moershi_0.employees_0"# mysql: [Warning] Using a password on the command line interface can be insecure.# +-------------+------+---------+----------+# | employee_id | name | dept_id | mail |# +-------------+------+---------+----------+# | 6 | C | 2 | c@QQ.com |# | 8 | B | 3 | B@QQ.com |# +-------------+------+---------+----------+
[root@mysql60 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 moershi_0.employees【ing普洛伊s】_0'# [root@mysql60 ~]# mysql -uroot -p123 -e "select * from moershi_0.employees_0"# mysql: [Warning] Using a password on the command line interface can be insecure.# +-------------+------+---------+----------+# | employee_id | name | dept_id | mail |# +-------------+------+---------+----------+# | 6 | C | 2 | c@QQ.com |# | 8 | B | 3 | B@QQ.com |# +-------------+------+---------+----------+
[root@mysql61 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 moershi_1.employees【ing普洛伊s】_1'# [root@mysql61 ~]# mysql -uroot -p123 -e "select * from moershi_1.employees_1"# mysql: [Warning] Using a password on the command line interface can be insecure.# +-------------+------+---------+-----------+# | employee_id | name | dept_id | mail |# +-------------+------+---------+-----------+# | 7 | C | 2 | c@QQ.com |# | 9 | a | 1 | a@163.com |# +-------------+------+---------+-----------+
[root@mysql62 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 moershi_1.employees【ing普洛伊s】_1'# [root@mysql62 ~]# mysql -uroot -p123 -e "select * from moershi_1.employees_1"# mysql: [Warning] Using a password on the command line interface can be insecure.# +-------------+------+---------+-----------+# | employee_id | name | dept_id | mail |# +-------------+------+---------+-----------+# | 7 | C | 2 | c@QQ.com |# | 9 | a | 1 | a@163.com |# +-------------+------+---------+-----------+7.3 ER表(关联表)
ER表,称为关联表,表示数据逻辑上有关联性的两个或多个表,例如工资表和员工表。对于关联表,通常希望他们能够有相同的分片规则,这样在进行关联查询时,能够快速定位到同一个数据分片中。MyCat2中对于关联表,不需要有过多的声明,他可以根据分片规则自行判断。
ER表原理
ER 关联表(Entity-Relationship Sharding Table)是 分布式数据库中间件(如 Mycat、ShardingSphere 等)中用于优化跨表 JOIN 查询的核心机制。它的核心思想是:
“让有关联关系的数据,落在同一个物理分片上。”
这样,即使执行 JOIN 操作,也能在单个数据库节点内完成,避免跨库 JOIN 带来的性能灾难。
一、为什么需要 ER 表?
在分库分表架构中:
- 表 A 按
user_id分片 → 数据分散在 db0、db1、db2… - 表 B 也按
user_id分片 → 相同user_id的数据也在同一分片
✅ 如果你查询:
SELECT * FROM orders oJOIN order_items oi ON o.order_id = oi.order_idWHERE o.user_id = 100;- 若
orders和order_items是 ER 表(同分片规则),Mycat 能确定:
所有相关数据都在同一个分片(比如 db1) → 直接下发 SQL 到 db1 执行 JOIN。 - 若不是 ER 表,Mycat 只能:
- 分别查
orders和order_items(可能在不同库) - 在内存中做合并(广播 + 内存计算)
- 性能极差,且结果可能不完整
- 分别查
二、ER 表的核心原理
1. 相同的分片规则(Sharding Rule)
两表必须满足:
| 条件 | 说明 |
|---|---|
| 分片键相同 | 如都用 employee_id |
| 分片算法相同 | 如都用 MOD_HASH(employee_id) |
| 分片数量一致 | 如都是 2 个库 |
| 分片拓扑对齐 | 数据节点列表完全一致 |
→ 这样才能保证:任意一条记录的关联数据,必然在同一物理节点。
2. 主外键逻辑匹配
- 主表(如
employees):employee_id是主键 - 子表(如
salary):employee_id是主键或外键(Mycat 不强制外键约束,但逻辑上需一致)
📌 Mycat 2.x 不要求数据库有真实外键,但字段名和分片语义必须一致。
3. 自动路由优化
当 Mycat 解析到:
SELECT ... FROM employees e JOIN salary s ON e.employee_id = s.employee_id它会:
- 提取
WHERE或ON中的分片键值(如employee_id = 1); - 计算该值应落在哪个分片(如
1 % 2 = 1→ db1); - 将整个 JOIN 查询直接下发到 db1 执行;
- 返回结果,全程无跨库操作。
三、Mycat 2.x 中 ER 表的实现方式
自动识别(无需配置)
Mycat 2.x 采用 “规则匹配 + 元数据推导”:
- 当你创建第二张表时,Mycat 对比已有表的分片规则;
- 如果完全匹配 → 自动归入同一个
groupId(即 ER 组); - 通过命令可查看:
/*+ mycat:showErGroup{} */;分组标识(groupId)
- 同一个
groupId内的所有表,被视为 强关联 ER 表; - Mycat 在路由时,会优先尝试将它们的查询合并到同一分片。
四、ER 表 vs 广播表 vs 普通分片表
| 类型 | 特点 | 适用场景 |
|---|---|---|
| ER 表 | 多表按相同规则分片,数据共置 | 主子表(订单/订单项)、一对多关联 |
| 广播表 | 全量复制到所有分片 | 小表(字典表、配置表),频繁 JOIN |
| 普通分片表 | 独立分片,无关联 | 无关联的大表(日志、流水) |
实际系统中常组合使用:
employees(分片表)dept(广播表)salary(ER 表,关联 employees)
五、示例:ER 表工作流程
表结构
-- 主表CREATE TABLE employees ( employee_id INT PRIMARY KEY, name CHAR(10)) DBPARTITIONS 2 DBPARTITION BY MOD_HASH(employee_id);
-- 子表(ER 表)CREATE TABLE salary ( employee_id INT PRIMARY KEY, basic INT) DBPARTITIONS 2 DBPARTITION BY MOD_HASH(employee_id);插入数据
INSERT INTO employees VALUES (1, '张三');INSERT INTO salary VALUES (1, 8000);employee_id=1→1 % 2 = 1→ 都写入 db1
查询
SELECT e.name, s.basicFROM employees e JOIN salary s ON e.employee_id = s.employee_idWHERE e.employee_id = 1;- Mycat 计算:
1 % 2 = 1→ 下发到 db1 - db1 执行原生 JOIN → 返回结果
✅ 高效、准确、无跨库
六、注意事项
-
分片键必须出现在 JOIN 条件中
-- ✅ 能识别 ERON e.employee_id = s.employee_id-- ❌ 无法识别(字段不同)ON e.id = s.emp_id -
不支持复杂表达式
-- ❌ Mycat 可能无法解析ON e.employee_id + 100 = s.employee_id -
动态扩容会影响 ER 关系
从 2 库扩到 4 库时,需确保所有 ER 表同步 rehash,否则数据错位。
总结:ER 表的本质
ER 表 = 数据共置(Data Co-location) + 路由协同(Routing Coordination)
通过强制关联数据落在同一分片,使得分布式数据库能像单机一样高效执行 JOIN,是分库分表架构中保持查询能力的关键设计。
在 Mycat 2.x 中,这一机制已高度自动化,你只需保证分片规则一致,即可享受 ER 优化带来的性能红利。
模拟实验
1)连接mycat服务建表
[root@client50 ~]# mysql -h192.168.90.63 -P8066 -umycat –p654321
mysql> create【克瑞特】 table【忒-部】 moershi.salary【晒了瑞】(employee【ing普洛伊】_id int【因特】 primary【普赖莫瑞】 key【kì】,p_date date , basic【贝斯克】 int【因特】 , bonus【波诺斯】 int【因特】) default【迪-佛特】 charset【查赛特】=utf8dbpartition【db-帕踢神】 by【拜】 mod【莫德】_hash【哈希】(employee【ing普洛伊】_id)tbpartition【tb-帕踢神】 by【拜】 mod【莫德】_hash【哈希】(employee【ing普洛伊】_id) tbpartitions【tb-帕踢神s】 1;
# mysql> create table moershi.salary (# -> employee_id int primary key,# -> p_date date , basic int,# -> bonus int# -> ) default charset=utf8# -> dbpartition by mod_hash(employee_id)# -> tbpartition by mod_hash(employee_id) tbpartitions 1;# Query OK, 1 row affected (0.27 sec)2)在MyCat2终端查看关联表关系。
[root@mycat63 ~]# mysql -h127.0.0.1 -P8066 -umycat –p654321mysql> /*+ mycat:showErGroup{}*/ ;+---------+------------+-----------+| groupId | schemaName | tableName |+---------+------------+-----------+| 0 | moershi | employees || 0 | moershi | salary【晒了瑞】 |+---------+------------+-----------+2 rows in set (0.00 sec)mysql>3)在2台主服务器查看表
[root@mysql59 ~]# mysql -e 'use moershi_0 ; show【瘦】 tables【忒-部s】'# [root@mysql59 ~]# mysql -uroot -p123 -e "use moershi_0;show tables"# mysql: [Warning] Using a password on the command line interface can be insecure.# +---------------------+# | Tables_in_moershi_0 |# +---------------------+# | employees_0 |# | salary_0 |# +---------------------+
[root@mysql61 ~]# mysql -e 'use moershi_1;show【瘦】 tables【忒-部s】'# [root@mysql61 ~]# mysql -uroot -p123 -e "use moershi_1;show tables"# mysql: [Warning] Using a password on the command line interface can be insecure.# +---------------------+# | Tables_in_moershi_1 |# +---------------------+# | employees_1 |# | salary_1 |# +---------------------+4)插入数据
[root@client50 ~]# mysql -h192.168.90.63 -P8066 -umycat –p654321
mysql> desc moershi.salary【晒了瑞】;# mysql> desc moershi.salary;# +-------------+------+------+-----+---------+-------+# | Field | Type | Null | Key | Default | Extra |# +-------------+------+------+-----+---------+-------+# | employee_id | int | NO | PRI | NULL | |# | p_date | date | YES | | NULL | |# | basic | int | YES | | NULL | |# | bonus | int | YES | | NULL | |# +-------------+------+------+-----+---------+-------+# 4 rows in set (0.02 sec)
mysql> insert【因涩特】 into【因兔】 moershi.salary【晒了瑞】 values【挖柳斯】(6,20230110,20000,2000);
mysql> insert【因涩特】 into【因兔】 moershi.salary【晒了瑞】 values【挖柳斯】(7,20230210,25000,2500);
mysql> insert【因涩特】 into【因兔】 moershi.salary【晒了瑞】 values【挖柳斯】(8,20230310,30000,3000);
mysql> insert【因涩特】 into【因兔】 moershi.salary【晒了瑞】 values【挖柳斯】(9,20230410,35000,3500);
# mysql> insert into moershi.salary values (6,20230110,20000,2000),(7,20230210,25000,2500),(8,20230310,30000,3000),(9,20230410,35000,3500);# Query OK, 4 rows affected (0.08 sec)
mysql> select【涩莱克特】 * from【弗乱】 moershi.salary【晒了瑞】;# mysql> select * from moershi.salary;# +-------------+------------+-------+-------+# | employee_id | p_date | basic | bonus |# +-------------+------------+-------+-------+# | 6 | 2023-01-10 | 20000 | 2000 |# | 8 | 2023-03-10 | 30000 | 3000 |# | 7 | 2023-02-10 | 25000 | 2500 |# | 9 | 2023-04-10 | 35000 | 3500 |# +-------------+------------+-------+-------+# 4 rows in set (0.03 sec)5)在4台数据库服务器本机查看
[root@mysql59 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 moershi_0.employees【ing普洛伊s】_0'# [root@mysql59 ~]# mysql -uroot -p123 -e "select * from moershi_0.employees_0"# mysql: [Warning] Using a password on the command line interface can be insecure.# +-------------+------+---------+----------+# | employee_id | name | dept_id | mail |# +-------------+------+---------+----------+# | 6 | C | 2 | c@QQ.com |# | 8 | B | 3 | B@QQ.com |# +-------------+------+---------+----------+
[root@mysql60 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 moershi_0.salary【晒了瑞】_0'# [root@mysql60 ~]# mysql -uroot -p123 -e "select * from moershi_0.salary_0"# mysql: [Warning] Using a password on the command line interface can be insecure.# +-------------+------------+-------+-------+# | employee_id | p_date | basic | bonus |# +-------------+------------+-------+-------+# | 6 | 2023-01-10 | 20000 | 2000 |# | 8 | 2023-03-10 | 30000 | 3000 |# +-------------+------------+-------+-------+
[root@mysql61 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 moershi_1.employees【ing普洛伊s】_1'# [root@mysql61 ~]# mysql -uroot -p123 -e "select * from moershi_1.employees_1"# mysql: [Warning] Using a password on the command line interface can be insecure.# +-------------+------+---------+-----------+# | employee_id | name | dept_id | mail |# +-------------+------+---------+-----------+# | 7 | C | 2 | c@QQ.com |# | 9 | a | 1 | a@163.com |# +-------------+------+---------+-----------+
[root@mysql62 ~]# mysql -e 'select【涩莱克特】 * from【弗乱】 moershi_1.salary【晒了瑞】_1'# [root@mysql62 ~]# mysql -uroot -p123 -e "select * from moershi_1.salary_1"# mysql: [Warning] Using a password on the command line interface can be insecure.# +-------------+------------+-------+-------+# | employee_id | p_date | basic | bonus |# +-------------+------------+-------+-------+# | 7 | 2023-02-10 | 25000 | 2500 |# | 9 | 2023-04-10 | 35000 | 3500 |# +-------------+------------+-------+-------+分片配置说明
/usr/local/mycat/conf/schemas/user_order_db.schema.json
[root@mycat63 ~]# cat /usr/local/mycat/conf/schemas/user_order_db.schema.json{ // 自定义表(高级用法),此处为空 "customTables":{}, // 全局表(所有节点都存全量数据),此处为空 "globalTables":{}, "normalProcedures":{}, // 普通表(不分片,只在一个节点),此处为空 "normalTables":{}, // 逻辑库名称,应用程序连接时使用:use user_order_db; "schemaName":"user_order_db", // 指定该逻辑库绑定到哪个集群(必须是已存在的 cluster name) "targetName": "c0", // 分片表定义(重点!) "shardingTables": { // 逻辑表名:应用程序写 INSERT INTO user_order_db.order_info ... "order_info": { // 分片字段:按哪个字段计算分表(必须是 DATE 或 DATETIME 类型) "shardingKey": "order_create_date", // 分片算法类:Mycat2 内置的按日期分片函数 "shardingClass": "io.mycat.router.function.PartitionByDate", // 分片算法参数 "shardingProperties": { // 日期格式,必须与字段存储格式一致 "dateFormat": "yyyy-MM-dd", // 分片起始日期(用于计算偏移量) "sBeginDate": "2025-01-01", // 每个分片包含多少天(30 ≈ 1个月) "sPartionDay": "30", // 总共分多少个表(这里设12,对应12个月) "partitionCount": "12" }, // 表类型:SHARDING 表示分片表 "tableType": "SHARDING", // 物理表的基础名(Mycat2 会自动拼接后缀,如 order_info_0, order_info_1...) // 注意:实际物理表名需手动创建为 order_info_202501 等,但 Mycat2 默认用数字后缀 // 所以我们后面会通过“预建表 + 修改命名规则”或接受数字后缀 "tableName": "order_info" } }, // 视图定义,此处为空 "views":{}}八、作业
1 选择题
- Mycat 是用于 MySQL 分库分表的数据库中间件,以下关于 Mycat 分库分表原理的描述,错误的是( C ) A. Mycat 位于应用层和数据库之间,接收应用请求 B. SQL 解析引擎主要负责判断是否需要分库分表 C. 路由层根据分片规则和算法,将 SQL 语句发往所有数据库分片 D. 后端连接池管理数据库连接,处理结果后返回给用户
**A. Mycat 位于应用层和数据库之间,接收应用请求**✅ 正确。Mycat 是一个数据库中间件,部署在应用和数据库之间,对应用透明,接收来自应用的 SQL 请求,再转发到后端 MySQL 实例。
**B. SQL 解析引擎主要负责判断是否需要分库分表**✅ 基本正确。Mycat 的 SQL 解析模块会解析 SQL 语句,结合配置的 schema 和分片规则,判断该 SQL 是否涉及分片表,从而决定是否需要进行分库分表路由。
**C. 路由层根据分片规则和算法,将 SQL 语句发往所有数据库分片**⚠️ **此处有陷阱。**路由层确实根据分片规则(如取模、范围、一致性哈希等)决定 SQL 应该发往**哪些**分片,但**不是“所有”数据库分片**。- 对于带分片键的查询(如 WHERE user_id = 100),通常只路由到**一个或部分分片**。- 只有在**未带分片键**的查询(如全表扫描)时,才会广播到**所有分片**。
因此,说“将 SQL 语句发往所有数据库分片”是**以偏概全**,**不准确**。所以 **C 选项描述错误**。
**D. 后端连接池管理数据库连接,处理结果后返回给用户**✅ 正确。Mycat 使用连接池管理与后端 MySQL 的连接,执行 SQL 后收集结果,进行**结果合并**(如排序、分页、聚合等),然后返回给客户端。虽然“处理结果”主要是由**结果合并/处理模块**完成,但连接池配合执行并获取结果,整体流程描述不算错误。-
在配置 Mycat 数据源时,添加 MySQL59 作为数据源的语句是( A ) A.
/*+ mycat:createdatasource{"name":"dw0", "url":"jdbc:mysql://192.168.90.59:3306","user":"jam","password":"123456"}*/;B./*+ mycat:createdatasource{"name":"dw1", "url":"jdbc:mysql://192.168.90.61:3306","user":"jam","password":"123456"}*/;C./*+ mycat:createdatasource{"name":"dr0", "url":"jdbc:mysql://192.168.90.60:3306","user":"jam","password":"123456"}*/;D./*+ mycat:createdatasource{"name":"dr1", "url":"jdbc:mysql://192.168.90.62:3306","user":"jam","password":"123456"}*/; -
以下关于 Mycat 分库分表策略中全局表的描述,正确的是( C ) A. 全局表数据只会插入到一个库中 B. 全局表数据会插入到两个库中,但只有一个库有全部数据 C. 全局表数据会插入到两个库中,并且两个库中都有全部的数据 D. 全局表数据不会存储在任何数据库中
-
在配置 Mycat 登录账号密码时,修改的文件是( B ) A.
/usr/local/mycat/conf/datasources/prototypeDs.datasource.jsonB./usr/local/mycat/conf/users/root.user.jsonC./usr/local/mycat/conf/clusters/prototype.cluster.jsonD./usr/local/mycat/conf/schemas/moershi.schema.json -
对于 Mycat 中的 ER 表(关联表),以下说法错误的是( B ) A. ER 表表示数据逻辑上有关联性的两个或多个表 B. 在 MyCat2 中对于关联表,需要有过多的声明 C. 关联表通常希望有相同的分片规则,以便进行关联查询 D. 可以通过
/*+ mycat:showErGroup{}*/查看关联表关系
2 简答题
- 简述 Mycat 实现分库分表的整体流程。 答: 1、mycat作为中间层,链接双主双从或多主多从数据库。 2、应用层连接mycat数据库,执行创建插入命令,由SQL解析引擎解析SQL,判断是否需分库分表。 3、mycat服务对分片键值进行hash或其他算法计算,再依据分片规则和算法,决定将SQL发往不同分片。 4、后端连接池管理数据库连接,处理合并结果后返回给用户。
### 简述 Mycat 实现分库分表的整体流程:
1. **架构定位**:Mycat 作为数据库中间件,部署在应用层与后端 MySQL 集群(如主从、多主或多分片)之间,对应用透明,提供统一的逻辑数据库视图。 2. **接收请求**:应用通过 JDBC/MySQL 协议连接 Mycat,发送 SQL 语句(如 INSERT、SELECT 等)。 3. **SQL 解析**:Mycat 的 SQL 解析引擎对 SQL 进行词法和语法分析,识别操作的表、字段、条件等,并结合 `schema.xml`(Mycat 1.x)或 `schema.json`(Mycat 2.x)中的配置,判断该表是否为分片表。 4. **路由决策**: - 若为分片表,Mycat 提取 SQL 中的**分片键**(如 WHERE user_id = 100); - 根据预定义的**分片规则**(如取模、范围、一致性哈希等),计算目标分片(dataNode); - 若未带分片键,则可能广播到所有分片(全表扫描)。 1. **执行与结果合并**: - Mycat 通过后端连接池将 SQL 路由到一个或多个真实 MySQL 节点执行; - 收集各分片返回的结果,在 Mycat 内部进行**结果合并**(如排序、分页、聚合等); - 将最终结果返回给应用。 1. **全局表与 ER 表处理**(补充): - 全局表:写入时同步到所有分片,读取时任选一个分片; - ER 表:子表按父表分片键共置,确保关联查询在单分片内完成。- 请说明在配置 MySQL 二主二从时,主服务器和从服务器分别需要进行哪些关键配置步骤。 答: 1、主服务器配置文件添加唯一server-id、开启binlog选项 2、主服务数据库创建用于同步的账号和权限 3、从服务器添加唯一server-id 4、从数据库上绑定主服务器IP、同步账号密码、binlog信息、偏移量,start slave开启同步
### 2. 请说明在配置 MySQL 二主二从时,主服务器和从服务器分别需要进行哪些关键配置步骤。
#### 一、主服务器(Master)的关键配置步骤(每台主库都要独立配置):
1. 修改 MySQL 配置文件(如 `/etc/my.cnf` 或 `/etc/mysql/mysql.conf.d/mysqld.cnf`): - 设置唯一的 `server-id`(例如:主1设为 1,主2设为 2); - 开启二进制日志:`log-bin = mysql-bin`; - (推荐)设置 `binlog-format = ROW`(提高数据一致性); - 启用自动递增偏移,避免双主写入冲突:
auto-increment-increment = 2 # 每次自增步长为2 auto-increment-offset = 1 # 主1从1开始;主2设为2
- 可选:设置 `log-slave-updates = ON`(使主库能将接收到的 relay log 再写入自己的 binlog,用于级联复制); - 可选:设置 `replicate-same-server-id = 0`(防止环路)。
1. 创建用于复制的专用账号:
CREATE USER 'repl'@'%' IDENTIFIED BY 'repl_password'; GRANT REPLICATION SLAVE ON *.* TO 'repl'@'%'; FLUSH PRIVILEGES;
2. 记录当前 binlog 文件名和位置(Position):
FLUSH TABLES WITH READ LOCK; -- (可选,确保一致性) SHOW MASTER STATUS;
记录 `File` 和 `Position`,供从库配置使用。
---
#### 二、从服务器(Slave)的关键配置步骤(每个从库对应一个主库):
1. 修改 MySQL 配置文件: - 设置唯一的 `server-id`(如从1设为 3,从2设为 4); - 建议开启 `relay-log = mysql-relay-bin`(默认开启); - 若需级联或监控,可开启 `read_only = ON`(防止误写)。
1. 配置主从复制关系: 在从库执行:
CHANGE MASTER TO MASTER_HOST='主库IP', MASTER_USER='repl', MASTER_PASSWORD='repl_password', MASTER_LOG_FILE='mysql-bin.000001', -- 来自主库 SHOW MASTER STATUS MASTER_LOG_POS=154; -- 对应 Position
2. 启动复制线程:
START SLAVE;
1. 验证复制状态:
SHOW SLAVE STATUS\G
确保 `Slave_IO_Running: Yes` 且 `Slave_SQL_Running: Yes`,无错误。
---
#### 三、特别说明:二主互为主从(双主)配置
- 主1 是 主2 的从库,主2 也是 主1 的从库; - 因此,每台主服务器既要配置为 Master(提供 binlog),也要配置为 Slave(连接对方); - 必须通过 `auto-increment-offset` 和 `auto-increment-increment` 避免自增 ID 冲突; - 建议应用层写入只走一台主库(避免循环复制或数据冲突),或使用 Mycat 等中间件控制写入路由。- 解释 Mycat 分库分表策略中全局表、分片表和 ER 表的区别。 答: 全局表:数据会插入到分片库中,并且所有的分片库中都有全部的数据。 分片表:数据会根据分片规则和算法,分别写入不同的分片库。 ER 表: 作为分片表的子表,其数据按照父表的分片键进行共置存储,确保父子数据位于同一分片,从而支持高效关联查询。
### 建议修正后的答案: 全局表:在所有分片中都存储完整的全量数据,写入时同步到所有分片,用于支持本地 JOIN。 分片表:数据根据分片规则(如取模、范围等)水平拆分,不同记录存储在不同分片中。 ER 表:作为分片表的子表,其数据按照父表的分片键进行共置存储,确保父子数据位于同一分片,从而支持高效关联查询。
### 对比总结: | 类型 | 数据分布 | 写入方式 | 主要用途 | |----------|------------------------------|--------------------|------------------------------| | 全局表 | 所有分片都有完整副本 | 广播写入所有分片 | 小表、频繁 JOIN | | 分片表 | 数据分散在不同分片 | 按分片键路由写入 | 大表水平拆分 | | ER 表 | 与父表共置在同一分片 | 跟随父表位置写入 | 子表与父表本地关联 |
#### 1. 全局表(Global Table) - 定义:数据量小、变动少、需频繁与其他表关联的表(如字典表、配置表)。 - 存储方式:在所有分片(dataNode)中都保存完整的全量数据副本。 - 写入行为:插入/更新/删除操作会同步广播到所有分片,保证数据一致性。 - 查询优势:可与任意分片表在本地进行 JOIN,避免跨库关联。
#### 2. 分片表(Sharding Table / Partitioned Table) - 定义:数据量大、需要水平拆分的表。 - 存储方式:数据按分片规则(如取模、范围、哈希等)分散存储在不同分片中,每个分片只存一部分数据。 - 路由依据:依赖 SQL 中是否包含分片键(sharding key)。若包含,则精准路由;否则可能全分片扫描。 - 典型场景:用户表、订单表等。
#### 3. ER 表(E-R 关系表 / Child Table) - 定义:与另一张分片表存在父子关系的表(如订单明细表是订单表的子表)。 - 核心机制:子表采用与父表相同的分片规则,并以父表的分片键作为自己的分片依据,从而确保父子记录落在同一个分片。 - 目的:实现本地关联查询,避免跨分片 JOIN。 - 配置要求:需在 Mycat 配置中声明父子关系(如 Mycat1 的 `<childTable>`,Mycat2 的 `joinKey`/`parentKey`)。- 当使用 Mycat 进行分库分表时,如果遇到数据不一致的问题,可能的原因有哪些? 答: 1、检查mycat配置,包括不限于mycat配置的数据源、集群信息、分库分表规则。 2、检查是否有更新mycat配置,但没有重启服务或加载失败。 3、检查sql语句是否使用不当。 4、检查后端mysql主从配置和主从到mycat是否有延迟或网址不通,导致返回数据缺失。
### 一、Mycat 配置层面的问题 #### 1. 分片规则配置错误 - 分片字段(sharding key)与实际 SQL 中使用的字段不一致; - 分片算法(如取模、范围)配置错误,导致相同逻辑数据被路由到不同分片; - 多租户或 schema 配置混淆,写入了错误的逻辑库。 **数据源(DataSource)或集群(Cluster)配置错误**:指向了错误的 IP、端口、数据库名,或主从角色混淆
📌 示例:用户 ID 为 100 的记录本应落在分片 0,但因算法写错,被写入分片 1,后续按 ID 查询时无法命中。
#### 2. 全局表未正确配置 - 应设为全局表的字典表被误配为普通分片表,导致部分分片缺少数据; - 全局表写入时 Mycat 广播失败(如某个分片连接异常),造成副本不一致。
#### 3. ER 表关系未正确声明 - 子表未正确关联父表分片键,导致父子数据不在同一分片; - JOIN 查询时 Mycat 无法本地关联,转而执行跨分片合并,但合并逻辑出错或遗漏数据。
### 二、SQL 使用不当 #### 4. 未带分片键的查询(全表扫描) - 执行 `SELECT * FROM user WHERE name = '张三'`(name 非分片键); - Mycat 广播到所有分片,但某些分片因网络超时、连接池满等原因未返回结果,导致数据“看起来”缺失。
#### 5. 跨分片事务未正确处理 - Mycat 默认不支持分布式事务(除非集成 XA 或 Seata); - 应用开启事务后向多个分片写入,若部分分片失败而其他成功,造成部分提交,数据不一致。
#### 6. 自增主键冲突(尤其在双主或多写场景) - 多个 MySQL 实例使用相同 auto_increment 策略,导致主键重复; - 虽然 Mycat 可路由,但底层数据库插入失败或覆盖数据。
### 三、后端 MySQL 集群问题 #### 7. 主从复制延迟或中断 - Mycat 读写分离配置下,读请求路由到从库; - 若从库存在复制延迟,会读到旧数据,看似“不一致”; - 若 `Slave_IO_Running` 或 `Slave_SQL_Running` 为 No,则完全不同步。 - **主从延迟(Replication Lag)**:Mycat 配置了读写分离,读请求路由到从库,但从库尚未同步最新数据,返回旧值; - **主从同步中断**:`SHOW SLAVE STATUS` 显示 `Slave_IO_Running` 或 `Slave_SQL_Running` 为 `No`,导致从库数据长期不一致; - **网络不通或防火墙限制**:Mycat 无法连接某个分片(尤其是从库),在广播查询时跳过该节点,造成数据“看起来”缺失。
#### 8. MySQL 实例数据被绕过 Mycat 直接修改 - DBA 或应用直接连接后端 MySQL 修改数据; - Mycat 无感知,导致其元数据或缓存与实际数据不符。
#### 9. binlog 格式或 GTID 配置不一致 - 在高可用切换或级联复制中,若 binlog_format 不统一(如 MIXED vs ROW),可能导致复制异常。
### 四、Mycat 自身机制限制 #### 10. 结果合并(Merge)逻辑缺陷 - 对 `ORDER BY + LIMIT`、`GROUP BY`、`COUNT(*)` 等聚合操作,Mycat 需在内存中合并各分片结果; - 若分页偏移量大或数据分布不均,可能漏算或重复计算。
#### 11. 连接池或会话状态残留 - 某个分片连接异常断开后未重置,后续请求复用脏连接; - 临时表、会话变量等状态影响查询结果。
#### 12. Mycat 版本 Bug - 某些旧版本存在 SQL 解析错误、路由缓存失效等问题,导致错误路由。
### 五、运维与部署问题 #### 13. 配置未热加载或加载失败 - 修改 `schema.xml` 或 JSON 配置后未执行 `reload @@config`; - Mycat 仍在使用旧规则,导致新写入数据位置错误。
#### 14. 时间/时区不一致 - 各 MySQL 节点系统时间不同步,影响基于时间的分片规则(如按天分表); - 应用与数据库时区设置不一致,导致条件判断偏差。
### ✅ 排查建议 1. 确认是否真不一致:直接登录各分片 MySQL 查询原始数据; 2. 检查 Mycat 日志:`mycat.log` 中查看 SQL 路由目标、执行结果; 3. 验证分片规则:使用 `EXPLAIN` 或 `/*+ mycat:sql=...*/` 查看路由计划; 4. 监控主从状态:定期检查 `SHOW SLAVE STATUS`; 5. 避免直连后端库:所有 DML 必须通过 Mycat; 6. 测试边界场景:如无分片键查询、跨分片事务、大数据量分页等。
### 总结 数据不一致往往是 “配置 + 使用 + 运维” 多因素叠加的结果。 核心原则: 确保“写入路径可控、读取路径可预期、副本同步可靠”。 通过规范配置、合理设计分片策略、避免跨分片复杂操作,并加强监控,可大幅降低数据不一致风险。- 描述在 Mycat 中创建集群的步骤以及集群信息的查看方法。 答: 添加数据源:
mysql> /*+ mycat:createdatasource{"name":"主数据源名称", "url":"jdbc:mysql://IP:端口","user":"用户名","password":"密码"}*/;创建集群命令: mysql> /*!mycat:createcluster{"name":"集群名","masters":["主数据源名称"],"replicas":["从数据源名称"]}*/;查看集群命令: mysql> /*+ mycat:showClusters{}*/ \G #### 一、创建集群的步骤
1. **前提条件**: - 已通过 `createdatasource` 命令或配置文件预先定义好**主数据源(master)** 和**从数据源(replica)**; - Mycat 配置中已启用动态管理功能(如 `enableClusterManagement=true`)。
1. **使用 SQL Hint 动态创建集群**:
/*!mycat:createCluster{"name":"cluster1","masters":["ds_master"],"replicas":["ds_slave1","ds_slave2"]}*/;
- `name`:集群名称(如 `cluster1`); - `masters`:主数据源名称列表(通常一个,支持多主); - `replicas`:从数据源名称列表(可为空或多个); - **注意**: - 关键字是 `createCluster`(首字母大写 C),不是 `createcluster`; - 注释语法为 `/*!mycat:...*/`(非 `/*+ ... */`,后者用于查询类 hint); - 数据源名称必须与已存在的数据源(如 `prototypeDs.datasource.json` 中定义的 `name`)一致。
1. **验证集群是否生效**: - 可通过后续的 `showClusters` 查看; - 或在 `conf/clusters/` 目录下生成对应的 `.cluster.json` 文件(若启用了持久化)。
---
#### 二、查看集群信息的方法
执行以下 SQL 查看当前所有集群的配置信息:
/*+ mycat:showClusters{} */;
- 使用 `/*+ ... */` 语法(这是查询类 hint 的标准格式); - 返回结果为 JSON 格式,包含每个集群的名称、主库、从库等信息; - 在 MySQL 客户端中可加 `\G` 美化输出:
/*+ mycat:showClusters{} */\G3 操作题
- 请详细描述在 Linux 系统上安装和配置 Mycat 以实现 MySQL 分库分表的完整步骤,包括机器准备、Mycat 安装部署、登录账号密码配置、连接本机数据库配置等。
# 配置双主双从mysql服务 ## 安装mysql服务 [root@mysql59 ~]# yum -y install rpm/* [root@mysql60 ~]# yum -y install rpm/* [root@mysql61 ~]# yum -y install rpm/* [root@mysql62 ~]# yum -y install rpm/* [root@mycat63 ~]# yum -y install rpm/*
## mysql59主 -1 配置 [root@mysql59 ~]# vim /etc/my.cnf [root@mysql59 ~]# grep -vE "^\s*(#|$)" /etc/my.cnf [mysqld] server-id=59 log-bin=mysql59 skip-name-resolve datadir=/var/lib/mysql socket=/var/lib/mysql/mysql.sock log-error=/var/log/mysqld.log pid-file=/var/run/mysqld/mysqld.pid
[root@mysql59 ~]# systemctl restart mysqld [root@mysql59 ~]# cat /var/log/mysqld.log | grep "password" 2025-12-08T10:10:36.085359Z 6 [Note] [MY-010454] [Server] A temporary password is generated for root@localhost: Qoy.ifK+S8Dq [root@mysql59 ~]# mysql -uroot -p Enter password: mysql> # 创建同步账号 mysql> create user repluser@"%" identified by "repluser"; Query OK, 0 rows affected (0.03 sec) mysql> grant replication slave on *.* to repluser@"%"; Query OK, 0 rows affected (0.01 sec) mysql> show master status; +----------------+----------+--------------+------------------+-------------------+ | File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set | +----------------+----------+--------------+------------------+-------------------+ | mysql59.000001 | 157 | | | | +----------------+----------+--------------+------------------+-------------------+ 1 row in set (0.00 sec)
## mysql60从 -1 配置 [root@mysql60 ~]# vim /etc/my.cnf [root@mysql60 ~]# grep -vE "^\s*(#|$)" /etc/my.cnf [mysqld] server-id=60 datadir=/var/lib/mysql socket=/var/lib/mysql/mysql.sock log-error=/var/log/mysqld.log pid-file=/var/run/mysqld/mysqld.pid
[root@mysql60 ~]# systemctl restart mysqld [root@mysql60 ~]# cat /var/log/mysqld.log | grep "password" 2025-12-08T10:14:18.739995Z 6 [Note] [MY-010454] [Server] A temporary password is generated for root@localhost: c!EY*oQxd70x [root@mysql60 ~]# mysql -uroot -p Enter password: mysql> # 同步信息设置 mysql> change master to master_host="192.168.88.59",master_user="repluser",master_password="repluser",master_log_file="mysql59.000001",master_log_pos=157; Query OK, 0 rows affected, 8 warnings (0.07 sec)
mysql> start slave; Query OK, 0 rows affected, 1 warning (0.03 sec)
mysql> show slave status \G ........ Slave_IO_Running: Yes Slave_SQL_Running: Yes
## mysql61主 -2 配置 [root@mysql61 ~]# vim /etc/my.cnf [root@mysql61 ~]# grep -vE "^\s*(#|$)" /etc/my.cnf [mysqld] server-id=61 log-bin=mysql61 datadir=/var/lib/mysql socket=/var/lib/mysql/mysql.sock log-error=/var/log/mysqld.log pid-file=/var/run/mysqld/mysqld.pid
[root@mysql61 ~]# systemctl restart mysqld [root@mysql61 ~]# cat /var/log/mysqld.log | grep "password" 2025-12-08T10:14:14.653868Z 6 [Note] [MY-010454] [Server] A temporary password is generated for root@localhost: gfMx)wwS4q;O [root@mysql61 ~]# mysql -uroot -p Enter password: mysql> # 创建同步账号 mysql> create user repluser@"%" identified by "repluser"; Query OK, 0 rows affected (0.02 sec) mysql> grant replication slave on *.* to repluser@"%"; Query OK, 0 rows affected (0.01 sec) mysql> show master status; +----------------+----------+--------------+------------------+-------------------+ | File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set | +----------------+----------+--------------+------------------+-------------------+ | mysql61.000001 | 1335 | | | | +----------------+----------+--------------+------------------+-------------------+ 1 row in set (0.00 sec)
## mysql62从 -2 配置 [root@mysql62 ~]# vim /etc/my.cnf [root@mysql62 ~]# grep -vE "^\s*(#|$)" /etc/my.cnf [mysqld] server-id=62 datadir=/var/lib/mysql socket=/var/lib/mysql/mysql.sock log-error=/var/log/mysqld.log pid-file=/var/run/mysqld/mysqld.pid
[root@mysql62 ~]# systemctl restart mysqld [root@mysql62 ~]# cat /var/log/mysqld.log | grep "password" 2025-12-08T10:14:21.247397Z 6 [Note] [MY-010454] [Server] A temporary password is generated for root@localhost: <MZxFHKt!1ql [root@mysql62 ~]# mysql -uroot -p Enter password: mysql> # 同步信息设置 mysql> change master to master_host="192.168.88.61",master_user="repluser",master_password="repluser",master_log_file="mysql61.000001",master_log_pos=1335; Query OK, 0 rows affected, 8 warnings (0.06 sec) mysql> start slave; Query OK, 0 rows affected, 1 warning (0.03 sec) mysql> show slave status \G ....... Slave_IO_Running: Yes Slave_SQL_Running: Yes
# mycat服务部署 ## mycat环境 [root@mycat63 ~]# yum -y install java-1.8.0-openjdk.x86_64 &>/dev/null [root@mycat63 ~]# echo $? 0 [root@mycat63 ~]# unzip mycat2-install-template-1.21.zip &>/dev/null [root@mycat63 ~]# mv mycat /usr/local/ [root@mycat63 ~]# mv mycat2-1.21-release-jar-with-dependencies.jar /usr/local/mycat/lib/ [root@mycat63 ~]# chmod -R 777 /usr/local/mycat/
## 配置mycat 登录账号密码 [root@mycat63 ~]# vim /usr/local/mycat/conf/users/root.user.json [root@mycat63 ~]# cat /usr/local/mycat/conf/users/root.user.json { "dialect":"mysql", "ip":null, "password":"654321", "transactionType":"proxy", "username":"mycat" }
## 配置mycat 连接本机数据库 [root@mycat63 ~]# vim /usr/local/mycat/conf/datasources/prototypeDs.datasource.json [root@mycat63 ~]# cat /usr/local/mycat/conf/datasources/prototypeDs.datasource.json { "dbType":"mysql", "idleTimeout":60000, "initSqls":[], "initSqlsGetConnection":true, "instanceType":"READ_WRITE", "maxCon":1000, "maxConnectTimeout":3000, "maxRetryCount":5, "minCon":1, "name":"prototypeDs", "password":"123456", "type":"JDBC", "url":"jdbc:mysql://localhost:3306/mysql?useUnicode=true&serverTimezone=Asia/Shanghai&characterEncoding=UTF-8", "user":"jam", "weight":0 }
## 安装mysql数据库配置账号 [root@mycat63 ~]# systemctl restart mysqld [root@mycat63 ~]# cat /var/log/mysqld.log | grep "password" 2025-12-08T10:14:10.214571Z 6 [Note] [MY-010454] [Server] A temporary password is generated for root@localhost: %6aj01>iV#Bb [root@mycat63 ~]# mysql -uroot -p123 Enter password: mysql> # 创建jam用户 mysql> create user jam@"%" identified by "123456"; Query OK, 0 rows affected (0.02 sec) mysql> grant all on *.* to jam@"%"; Query OK, 0 rows affected (0.01 sec) mysql>
## mycat 配置数据源 [root@mycat63 ~]# /usr/local/mycat/bin/mycat start Starting mycat2... [root@mycat63 ~]# netstat -utnlp | grep 8066 tcp6 0 0 :::8066 :::* LISTEN 16588/java [root@mycat63 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321 mysql> /*+ mycat:createdatasource{"name":"dw0", "url":"jdbc:mysql://192.168.88.59:3306","user":"jam","password":"123456"}*/; Query OK, 0 rows affected (0.33 sec) mysql> /*+ mycat:createdatasource{"name":"dr0", "url":"jdbc:mysql://192.168.88.60:3306","user":"jam","password":"123456"}*/; Query OK, 0 rows affected (0.04 sec) mysql> /*+ mycat:createdatasource{"name":"dw1", "url":"jdbc:mysql://192.168.88.61:3306","user":"jam","password":"123456"}*/; Query OK, 0 rows affected (0.02 sec) mysql> /*+ mycat:createdatasource{"name":"dr1", "url":"jdbc:mysql://192.168.88.62:3306","user":"jam","password":"123456"}*/; Query OK, 0 rows affected (0.01 sec) mysql> /*+ mycat:showDataSources{}*/ \G *************************** 1. row *************************** NAME: dr1 USERNAME: jam PASSWORD: 123456 ...... DB_TYPE: mysql URL: jdbc:mysql://192.168.88.62:3306?useUnicode=true&serverTimezone=Asia/Shanghai&characterEncoding=UTF-8&autoReconnect=true ...... *************************** 2. row *************************** NAME: dr0 USERNAME: jam PASSWORD: 123456 ...... DB_TYPE: mysql URL: jdbc:mysql://192.168.88.60:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true ...... *************************** 3. row *************************** NAME: prototypeDs USERNAME: jam PASSWORD: 123456 ...... DB_TYPE: mysql URL: jdbc:mysql://localhost:3306/mysql?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true ...... *************************** 4. row *************************** NAME: dw1 USERNAME: jam PASSWORD: 123456 ...... DB_TYPE: mysql URL: jdbc:mysql://192.168.88.61:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true ...... *************************** 5. row *************************** NAME: dw0 USERNAME: jam PASSWORD: 123456 ...... DB_TYPE: mysql URL: jdbc:mysql://192.168.88.59:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true ......
## 在59和61双主服务器上添加mycat 连接使用的jam用户 mysql> create user jam@"%" identified by "123456"; Query OK, 0 rows affected (0.01 sec) mysql> grant all on *.* to jam@"%"; Query OK, 0 rows affected (0.01 sec)
## 创建集群 [root@mycat63 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321 mysql> # mycat63服务器 mysql> /*! mycat:createcluster{"name":"c0","masters":["dw0"],"replicas":["dr0"]}*/; Query OK, 0 rows affected (0.06 sec)
mysql> /*! mycat:createcluster{"name":"c1","masters":["dw1"],"replicas":["dr1"]}*/; Query OK, 0 rows affected (0.02 sec)
mysql> /*+ mycat:showClusters{}*/ \G *************************** 1. row *************************** NAME: prototype SWITCH_TYPE: SWITCH MAX_REQUEST_COUNT: 200 TYPE: BALANCE_ALL WRITE_DS: prototypeDs READ_DS: prototypeDs WRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1 READ_L: io.mycat.plug.loadBalance.BalanceRandom$1 AVAILABLE: true *************************** 2. row *************************** NAME: c0 SWITCH_TYPE: SWITCH MAX_REQUEST_COUNT: 2000 TYPE: BALANCE_ALL WRITE_DS: dw0 READ_DS: dw0,dr0 WRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1 READ_L: io.mycat.plug.loadBalance.BalanceRandom$1 AVAILABLE: true *************************** 3. row *************************** NAME: c1 SWITCH_TYPE: SWITCH MAX_REQUEST_COUNT: 2000 TYPE: BALANCE_ALL WRITE_DS: dw1 READ_DS: dw1,dr1 WRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1 READ_L: io.mycat.plug.loadBalance.BalanceRandom$1 AVAILABLE: true 3 rows in set (0.01 sec)
## mycat63 设置分片规则 [root@mycat63 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321 mysql> # 创建全局表 mysql> create database moershi; Query OK, 0 rows affected (0.05 sec)
mysql> create table moershi.dept( -> dept_id int, -> dept_name char(10), -> primary key(dept_id) -> )default charset utf8 broadcast; Query OK, 0 rows affected (1 min 0.14 sec)
mysql> insert into moershi.dept values(1,"开发部"),(2,"运维部"),(3,"测试部"); Query OK, 1 row affected (0.10 sec)
# 查看全局表 [root@mycat63 ~]# mysql -h 192.168.88.59 -ujam -p123456 -e "select * from moershi.dept;" +---------+-----------+ | dept_id | dept_name | +---------+-----------+ | 1 | 开发部 | | 2 | 运维部 | | 3 | 测试部 | +---------+-----------+ [root@mycat63 ~]# mysql -h 192.168.88.60 -ujam -p123456 -e "select * from moershi.dept;" +---------+-----------+ | dept_id | dept_name | +---------+-----------+ | 1 | 开发部 | | 2 | 运维部 | | 3 | 测试部 | +---------+-----------+ [root@mycat63 ~]# mysql -h 192.168.88.61 -ujam -p123456 -e "select * from moershi.dept;" +---------+-----------+ | dept_id | dept_name | +---------+-----------+ | 1 | 开发部 | | 2 | 运维部 | | 3 | 测试部 | +---------+-----------+ [root@mycat63 ~]# mysql -h 192.168.88.62 -ujam -p123456 -e "select * from moershi.dept;" +---------+-----------+ | dept_id | dept_name | +---------+-----------+ | 1 | 开发部 | | 2 | 运维部 | | 3 | 测试部 | +---------+-----------+
# mycat63 创建分片表 以“employee_id”为分片点 [root@mycat63 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321 mysql> create table moershi.employees( -> employee_id int primary key, -> name char(10), -> dept_id int, -> mail varchar(30) -> )default charset utf8 -> dbpartition by mod_hash(employee_id) tbpartition by mod_hash(employee_id) -> tbpartitions 1 dbpartitions 2; Query OK, 1 row affected (1.04 sec)
mysql> INSERT INTO moershi.employees VALUES (1, '张三', 1, 'zhangsan@example.com'),(2, '李四', 2, 'lisi@example.com'); Query OK, 2 rows affected (0.07 sec)
# 查看分片表 [root@mycat63 ~]# mysql -h 192.168.88.59 -ujam -p123456 -e "select * from moershi_0.employees_0;" +-------------+--------+---------+------------------+ | employee_id | name | dept_id | mail | +-------------+--------+---------+------------------+ | 2 | 李四 | 2 | lisi@example.com | +-------------+--------+---------+------------------+ [root@mycat63 ~]# mysql -h 192.168.88.60 -ujam -p123456 -e "select * from moershi_0.employees_0;" +-------------+--------+---------+------------------+ | employee_id | name | dept_id | mail | +-------------+--------+---------+------------------+ | 2 | 李四 | 2 | lisi@example.com | +-------------+--------+---------+------------------+ [root@mycat63 ~]# mysql -h 192.168.88.61 -ujam -p123456 -e "select * from moershi_1.employees_1;" +-------------+--------+---------+----------------------+ | employee_id | name | dept_id | mail | +-------------+--------+---------+----------------------+ | 1 | 张三 | 1 | zhangsan@example.com | +-------------+--------+---------+----------------------+ [root@mycat63 ~]# mysql -h 192.168.88.62 -ujam -p123456 -e "select * from moershi_1.employees_1;" +-------------+--------+---------+----------------------+ | employee_id | name | dept_id | mail | +-------------+--------+---------+----------------------+ | 1 | 张三 | 1 | zhangsan@example.com | +-------------+--------+---------+----------------------+
# 创建ER关联表
[root@mycat63 ~]# mysql -h127.0.0.1 -P8066 -umycat -p654321 mysql> create table moershi.salary ( -> employee_id int primary key, -> p_date date , basic int, -> bonus int -> ) default charset=utf8 -> dbpartition by mod_hash(employee_id) dbpartitions 2 -> tbpartition by mod_hash(employee_id) tbpartitions 1; Query OK, 0 rows affected (0.19 sec)
# 查看关联表关系 mysql> /*+ mycat:showErGroup{}*/ ; +---------+------------+-----------+ | groupId | schemaName | tableName | +---------+------------+-----------+ | 0 | moershi | employees | | 0 | moershi | salary | +---------+------------+-----------+ 2 rows in set (0.00 sec)
# 数据插入 mysql> insert into moershi.salary values (6,20230110,20000,2000),(7,20230210,25000,2500),(8,20230310,30000,3000),(9,20230410,35000,3500); Query OK, 4 rows affected (0.04 sec)
# 数据验证 [root@mycat63 ~]# mysql -h 192.168.88.59 -ujam -p123456 -e"select * from moershi_0.salary_0;" +-------------+------------+-------+-------+ | employee_id | p_date | basic | bonus | +-------------+------------+-------+-------+ | 6 | 2023-01-10 | 20000 | 2000 | | 8 | 2023-03-10 | 30000 | 3000 | +-------------+------------+-------+-------+ [root@mycat63 ~]# mysql -h 192.168.88.60 -ujam -p123456 -e"select * from moershi_0.salary_0;" +-------------+------------+-------+-------+ | employee_id | p_date | basic | bonus | +-------------+------------+-------+-------+ | 6 | 2023-01-10 | 20000 | 2000 | | 8 | 2023-03-10 | 30000 | 3000 | +-------------+------------+-------+-------+ [root@mycat63 ~]# mysql -h 192.168.88.61 -ujam -p123456 -e"select * from moershi_1.salary_1;" +-------------+------------+-------+-------+ | employee_id | p_date | basic | bonus | +-------------+------------+-------+-------+ | 7 | 2023-02-10 | 25000 | 2500 | | 9 | 2023-04-10 | 35000 | 3500 | +-------------+------------+-------+-------+ [root@mycat63 ~]# mysql -h 192.168.88.62 -ujam -p123456 -e"select * from moershi_1.salary_1;" +-------------+------------+-------+-------+ | employee_id | p_date | basic | bonus | +-------------+------------+-------+-------+ | 7 | 2023-02-10 | 25000 | 2500 | | 9 | 2023-04-10 | 35000 | 3500 | +-------------+------------+-------+-------+ [root@mycat63 ~]#2
- 已知一个电商系统的订单表数据量较大,需要使用 Mycat 进行分库分表。假设按照订单创建时间进行分表,每个月的数据存于一个独立表,同时按照业务模块将订单数据库拆分为用户订单库、商品订单库等多个数据库。请写出具体的分库分表配置步骤和 SQL 语句。
# 配置双主双从mysql服务## 安装mysql服务[root@mysql59 ~]# yum -y install rpm/*[root@mysql60 ~]# yum -y install rpm/*[root@mysql61 ~]# yum -y install rpm/*[root@mysql62 ~]# yum -y install rpm/*[root@mycat63 ~]# yum -y install rpm/*
## mysql59主 -1 配置[root@mysql59 ~]# vim /etc/my.cnf[root@mysql59 ~]# grep -vE "^\s*(#|$)" /etc/my.cnf[mysqld]server-id=59log-bin=mysql59skip-name-resolvedatadir=/var/lib/mysqlsocket=/var/lib/mysql/mysql.socklog-error=/var/log/mysqld.logpid-file=/var/run/mysqld/mysqld.pid
[root@mysql59 ~]# systemctl restart mysqld[root@mysql59 ~]# cat /var/log/mysqld.log | grep "password"2025-12-08T10:10:36.085359Z 6 [Note] [MY-010454] [Server] A temporary password is generated for root@localhost: Qoy.ifK+S8Dq[root@mysql59 ~]# mysql -uroot -pEnter password:mysql> # 创建同步账号mysql> create user repluser@"%" identified by "repluser";Query OK, 0 rows affected (0.03 sec)mysql> grant replication slave on *.* to repluser@"%";Query OK, 0 rows affected (0.01 sec)mysql> show master status;+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql59.000001 | 157 | | | |+----------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)
## mysql60从 -1 配置[root@mysql60 ~]# vim /etc/my.cnf[root@mysql60 ~]# grep -vE "^\s*(#|$)" /etc/my.cnf[mysqld]server-id=60datadir=/var/lib/mysqlsocket=/var/lib/mysql/mysql.socklog-error=/var/log/mysqld.logpid-file=/var/run/mysqld/mysqld.pid
[root@mysql60 ~]# systemctl restart mysqld[root@mysql60 ~]# cat /var/log/mysqld.log | grep "password"2025-12-08T10:14:18.739995Z 6 [Note] [MY-010454] [Server] A temporary password is generated for root@localhost: c!EY*oQxd70x[root@mysql60 ~]# mysql -uroot -pEnter password:mysql> # 同步信息设置mysql> change master to master_host="192.168.88.59",master_user="repluser",master_password="repluser",master_log_file="mysql59.000001",master_log_pos=157;Query OK, 0 rows affected, 8 warnings (0.07 sec)
mysql> start slave;Query OK, 0 rows affected, 1 warning (0.03 sec)
mysql> show slave status \G........ Slave_IO_Running: Yes Slave_SQL_Running: Yes
## mysql61主 -2 配置[root@mysql61 ~]# vim /etc/my.cnf[root@mysql61 ~]# grep -vE "^\s*(#|$)" /etc/my.cnf[mysqld]server-id=61log-bin=mysql61datadir=/var/lib/mysqlsocket=/var/lib/mysql/mysql.socklog-error=/var/log/mysqld.logpid-file=/var/run/mysqld/mysqld.pid
[root@mysql61 ~]# systemctl restart mysqld[root@mysql61 ~]# cat /var/log/mysqld.log | grep "password"2025-12-08T10:14:14.653868Z 6 [Note] [MY-010454] [Server] A temporary password is generated for root@localhost: gfMx)wwS4q;O[root@mysql61 ~]# mysql -uroot -pEnter password:mysql> # 创建同步账号mysql> create user repluser@"%" identified by "repluser";Query OK, 0 rows affected (0.02 sec)mysql> grant replication slave on *.* to repluser@"%";Query OK, 0 rows affected (0.01 sec)mysql> show master status;+----------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+----------------+----------+--------------+------------------+-------------------+| mysql61.000001 | 1335 | | | |+----------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)
## mysql62从 -2 配置[root@mysql62 ~]# vim /etc/my.cnf[root@mysql62 ~]# grep -vE "^\s*(#|$)" /etc/my.cnf[mysqld]server-id=62datadir=/var/lib/mysqlsocket=/var/lib/mysql/mysql.socklog-error=/var/log/mysqld.logpid-file=/var/run/mysqld/mysqld.pid
[root@mysql62 ~]# systemctl restart mysqld[root@mysql62 ~]# cat /var/log/mysqld.log | grep "password"2025-12-08T10:14:21.247397Z 6 [Note] [MY-010454] [Server] A temporary password is generated for root@localhost: <MZxFHKt!1ql[root@mysql62 ~]# mysql -uroot -pEnter password:mysql> # 同步信息设置mysql> change master to master_host="192.168.88.61",master_user="repluser",master_password="repluser",master_log_file="mysql61.000001",master_log_pos=1335;Query OK, 0 rows affected, 8 warnings (0.06 sec)mysql> start slave;Query OK, 0 rows affected, 1 warning (0.03 sec)mysql> show slave status \G....... Slave_IO_Running: Yes Slave_SQL_Running: Yes
# mycat服务部署## mycat环境[root@mycat63 ~]# yum -y install java-1.8.0-openjdk.x86_64 &>/dev/null[root@mycat63 ~]# echo $?0[root@mycat63 ~]# unzip mycat2-install-template-1.21.zip &>/dev/null[root@mycat63 ~]# cp -r mycat /usr/local/[root@mycat63 ~]# cp -r mycat2-1.21-release-jar-with-dependencies.jar /usr/local/mycat/lib/[root@mycat63 ~]# chmod -R 777 /usr/local/mycat/
## 配置mycat 登录账号密码[root@mycat63 ~]# vim /usr/local/mycat/conf/users/root.user.json[root@mycat63 ~]# cat /usr/local/mycat/conf/users/root.user.json{ "dialect":"mysql", "ip":null, "password":"123456", "transactionType":"proxy", "username":"mycat"}
## 配置mycat 连接本机数据库[root@mycat63 ~]# vim /usr/local/mycat/conf/datasources/prototypeDs.datasource.json[root@mycat63 ~]# cat /usr/local/mycat/conf/datasources/prototypeDs.datasource.json{ "dbType":"mysql", "idleTimeout":60000, "initSqls":[], "initSqlsGetConnection":true, "instanceType":"READ_WRITE", "maxCon":1000, "maxConnectTimeout":3000, "maxRetryCount":5, "minCon":1, "name":"prototypeDs", "password":"123456", "type":"JDBC", "url":"jdbc:mysql://localhost:3306/mysql?useUnicode=true&serverTimezone=Asia/Shanghai&characterEncoding=UTF-8", "user":"jam", "weight":0}
## 安装mysql数据库配置账号[root@mycat63 ~]# systemctl restart mysqld[root@mycat63 ~]# cat /var/log/mysqld.log | grep "password"2025-12-08T10:14:10.214571Z 6 [Note] [MY-010454] [Server] A temporary password is generated for root@localhost: %6aj01>iV#Bb[root@mycat63 ~]# mysql -uroot -p123Enter password:mysql> # 创建jam用户mysql> create user jam@"%" identified by "123456";Query OK, 0 rows affected (0.02 sec)mysql> grant all on *.* to jam@"%";Query OK, 0 rows affected (0.01 sec)mysql>
## mycat 配置数据源[root@mycat63 ~]# /usr/local/mycat/bin/mycat startStarting mycat2...[root@mycat63 ~]# netstat -utnlp | grep 8066tcp6 0 0 :::8066 :::* LISTEN 16588/java[root@mycat63 ~]# mysql -h 127.0.0.1 -P8066 -umycat -p123456mysql> /*+ mycat:createdatasource{"name":"dw0", "url":"jdbc:mysql://192.168.88.59:3306","user":"jam","password":"123456"}*/;Query OK, 0 rows affected (0.33 sec)mysql> /*+ mycat:createdatasource{"name":"dr0", "url":"jdbc:mysql://192.168.88.60:3306","user":"jam","password":"123456"}*/;Query OK, 0 rows affected (0.04 sec)mysql> /*+ mycat:createdatasource{"name":"dw1", "url":"jdbc:mysql://192.168.88.61:3306","user":"jam","password":"123456"}*/;Query OK, 0 rows affected (0.02 sec)mysql> /*+ mycat:createdatasource{"name":"dr1", "url":"jdbc:mysql://192.168.88.62:3306","user":"jam","password":"123456"}*/;Query OK, 0 rows affected (0.01 sec)mysql> /*+ mycat:showDataSources{}*/ \G*************************** 1. row *************************** NAME: dr1 USERNAME: jam PASSWORD: 123456 ...... DB_TYPE: mysql URL: jdbc:mysql://192.168.88.62:3306?useUnicode=true&serverTimezone=Asia/Shanghai&characterEncoding=UTF-8&autoReconnect=true......*************************** 2. row *************************** NAME: dr0 USERNAME: jam PASSWORD: 123456...... DB_TYPE: mysql URL: jdbc:mysql://192.168.88.60:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true......*************************** 3. row *************************** NAME: prototypeDs USERNAME: jam PASSWORD: 123456...... DB_TYPE: mysql URL: jdbc:mysql://localhost:3306/mysql?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true......*************************** 4. row *************************** NAME: dw1 USERNAME: jam PASSWORD: 123456...... DB_TYPE: mysql URL: jdbc:mysql://192.168.88.61:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true......*************************** 5. row *************************** NAME: dw0 USERNAME: jam PASSWORD: 123456...... DB_TYPE: mysql URL: jdbc:mysql://192.168.88.59:3306?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true......
## 在59和61双主服务器上添加mycat 连接使用的jam用户mysql> create user jam@"%" identified by "123456";Query OK, 0 rows affected (0.01 sec)mysql> grant all on *.* to jam@"%";Query OK, 0 rows affected (0.01 sec)
## 创建集群[root@mycat63 ~]# mysql -h127.0.0.1 -P8066 -umycat -p123456mysql> # mycat63服务器mysql> /*! mycat:createcluster{"name":"c0","masters":["dw0"],"replicas":["dr0"]}*/;Query OK, 0 rows affected (0.06 sec)
mysql> /*! mycat:createcluster{"name":"c1","masters":["dw1"],"replicas":["dr1"]}*/;Query OK, 0 rows affected (0.02 sec)
mysql> /*+ mycat:showClusters{}*/ \G*************************** 1. row *************************** NAME: prototype SWITCH_TYPE: SWITCHMAX_REQUEST_COUNT: 200 TYPE: BALANCE_ALL WRITE_DS: prototypeDs READ_DS: prototypeDs WRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1 READ_L: io.mycat.plug.loadBalance.BalanceRandom$1 AVAILABLE: true*************************** 2. row *************************** NAME: c0 SWITCH_TYPE: SWITCHMAX_REQUEST_COUNT: 2000 TYPE: BALANCE_ALL WRITE_DS: dw0 READ_DS: dr0 WRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1 READ_L: io.mycat.plug.loadBalance.BalanceRandom$1 AVAILABLE: true*************************** 3. row *************************** NAME: c1 SWITCH_TYPE: SWITCHMAX_REQUEST_COUNT: 2000 TYPE: BALANCE_ALL WRITE_DS: dw1 READ_DS: dr1 WRITE_L: io.mycat.plug.loadBalance.BalanceRandom$1 READ_L: io.mycat.plug.loadBalance.BalanceRandom$1 AVAILABLE: true3 rows in set (0.21 sec)
[root@mycat63 ~]# 读写分离设置[root@mycat63 ~]# sed -i 's/"READ_WRITE"/"READ"/g' /usr/local/mycat/conf/datasources/dr0.datasource.json[root@mycat63 ~]# sed -i 's/"READ_WRITE"/"READ"/g' /usr/local/mycat/conf/datasources/dr1.datasource.json[root@mycat63 ~]# sed -i 's/"READ_WRITE"/"WRITE"/g' /usr/local/mycat/conf/datasources/dw0.datasource.json[root@mycat63 ~]# sed -i 's/"READ_WRITE"/"WRITE"/g' /usr/local/mycat/conf/datasources/dw1.datasource.json[root@mycat63 ~]# grep -r "instanceType" /usr/local/mycat/conf/datasources/*/usr/local/mycat/conf/datasources/dr0.datasource.json: "instanceType":"READ",/usr/local/mycat/conf/datasources/dr1.datasource.json: "instanceType":"READ",/usr/local/mycat/conf/datasources/dw0.datasource.json: "instanceType":"WRITE",/usr/local/mycat/conf/datasources/dw1.datasource.json: "instanceType":"WRITE",/usr/local/mycat/conf/datasources/prototypeDs.datasource.json: "instanceType":"READ_WRITE",[root@mycat63 ~]# /usr/local/mycat/bin/mycat restartStopping mycat2...Stopped mycat2.Starting mycat2...[root@mycat63 ~]#
mysql> # 创建用户订单逻辑库mysql> create database user_order_db;Query OK, 0 rows affected (1.13 sec)
[root@mycat63 ~]# 指定 user_order_db 集群[root@mycat63 ~]# sed -i '/"schemaName":"user_order_db",/a \ "targetName":"c0,c1",' /usr/local/mycat/conf/schemas/user_order_db.schema.json[root@mycat63 ~]# cat /usr/local/mycat/conf/schemas/user_order_db.schema.json{ "customTables":{}, "globalTables":{}, "normalProcedures":{}, "normalTables":{}, "schemaName":"user_order_db", "targetName":"c0,c1", "shardingTables":{}, "views":{}}[root@mycat63 ~]# /usr/local/mycat/bin/mycat restartStopping mycat2...Stopped mycat2.Starting mycat2...[root@mycat63 ~]#
[root@mycat63 ~]# mysql -h127.0.0.1 -P8066 -umycat -p123456mysql> create table user_order_db.order_info ( -> order_id bigint primary key, -> user_id bigint, -> order_amount decimal(10,2), -> order_create_date date, -> order_status tinyint -> ) default charset utf8 -> dbpartition by YYYYMM(order_create_date) dbpartitions 1 -> tbpartition by YYYYMM(order_create_date) tbpartitions 12;Query OK, 0 rows affected (4.07 sec)
mysql> insert into user_order_db.order_info values (1, 1001, 100.00, '2026-12-01', 1),(2, 1002, 200.00, '2026-01-15', 1),(3, 1003, 300.00, '2026-02-20', 1),(1, 1001, 100.00, '2026-05-01', 1),(2, 1002, 200.00, '2026-04-15', 1),(3, 1003, 300.00, '2026-03-20', 1),(1, 1001, 100.00, '2026-08-01', 1),(2, 1002, 200.00, '2026-07-15', 1),(3, 1003, 300.00, '2026-06-20', 1),(1, 1001, 100.00, '2026-11-01', 1),(2, 1002, 200.00, '2026-10-15', 1),(3, 1003, 300.00, '2026-08-20', 1);Query OK, 12 rows affected (0.26 sec)
mysql> # 商品订单库mysql> create database product_order_db;Query OK, 12 rows affected (0.03 sec)
[root@mycat63 ~]# vim /usr/local/mycat/conf/schemas/product_order_db.schema.json[root@mycat63 ~]# cat /usr/local/mycat/conf/schemas/product_order_db.schema.json{ "customTables":{}, "globalTables":{}, "normalProcedures":{}, "normalTables":{}, "schemaName":"product_order_db", "targetName":"c0,c1", "shardingTables":{}, "views":{}}[root@mycat63 ~]# /usr/local/mycat/bin/mycat restartStopping mycat2...Stopped mycat2.Starting mycat2...[root@mycat63 ~]#
mysql> create table product_order_db.product_order_info ( -> product_order_id bigint primary key, -> order_id bigint, -> product_id bigint, -> product_num int, -> order_create_date date -> ) default charset utf8 -> dbpartition by YYYYMM(order_create_date) dbpartitions 2 -> tbpartition by YYYYMM(order_create_date) tbpartitions 12;Query OK, 0 rows affected (2.25 sec)3
- 现在需要在 Mycat 中添加一个新的 MySQL 数据源,并创建一个新的集群。请写出相应的操作步骤和 SQL 语句。 答: 添加数据源:
mysql> /*+ mycat:createdatasource{"name":"主数据源名称", "url":"jdbc:mysql://IP:端口","user":"用户名","password":"密码"}*/;mysql> /*+ mycat:createdatasource{"name":"从数据源名称", "url":"jdbc:mysql://IP:端口","user":"用户名","password":"密码"}*/;创建集群命令:mysql> /*!mycat:createcluster{"name":"集群名","masters":["主数据源名称"],"replicas":["从数据源名称"]}*/;验证集群:mysql> /*+ mycat:showClusters{} */\G————————————————————————————————————————————————————————————————————————————————
12:redis 数据类型
今日工作任务路线图
一、工作场景
1.1 电商平台场景
在电商平台中,会大量使用 Redis【瑞迪斯】 来提升性能和处理并发。用字符串类型缓存商品的基本信息,减轻数据库压力;用列表类型实现消息队列,处理订单任务;用散列类型存储商品的多维度属性,方便单独查询和修改;用集合类型实现商品标签系统,便于用户根据标签搜索商品;用有序集合类型实现商品销量排行榜。
1.2 社交平台场景
社交平台利用 Redis【瑞迪斯】 来实现各种功能。字符串类型用于存储用户的会话信息,保证用户登录状态一致;列表类型存储用户的动态历史记录,方便用户查看;散列类型存储用户的详细资料;集合类型存储用户的好友列表,实现共同好友推荐;有序集合类型实现用户活跃度排行榜。
二、为什么学
学习 Redis【瑞迪斯】 数据类型具有多方面重要意义。从性能上看,Redis【瑞迪斯】 作为基于内存的键值型 NoSQL 数据库,读写速度极快,官方数据显示读取速度达 110000 次/秒,写速度 81000 次/秒,掌握其数据类型能让我们在开发中充分利用这一优势,提升系统性能。
从应用场景来说,不同数据类型适用场景广泛。比如字符串类型可用于缓存、计数器、分布式锁等;列表类型能实现消息队列、排行榜、历史记录存储等;散列类型适合存储用户信息、商品属性等;集合类型可用于用户管理、唯一性检查等;有序集合类型能实现排行榜、分数统计等。学习这些数据类型,能让我们在面对各种业务需求时,选择合适的数据类型解决问题。
从就业角度看,Redis【瑞迪斯】 在互联网领域应用广泛,掌握 Redis【瑞迪斯】 数据类型及其应用,能增强我们在职场上的竞争力,为从事相关工作打下坚实基础。
三、搭建redis【瑞迪斯】 服务器
当前任务环节
3.1 什么是redis【瑞迪斯】
Redis【瑞迪斯】 即远程字典服务,是开源的基于内存的键值型NoSQL数据库,用C语言编写。它将数据存于内存,读写快,官方数据显示读取速度达110000次/秒,写速度81000次/秒 。支持字符串、哈希、列表、集合、有序集合等丰富数据结构,每种都有专门操作命令。提供RDB和AOF两种持久化机制,还支持主从复制、哨兵机制、集群模式等。采用单线程架构结合IO多路复用技术处理请求,避免多线程开销。广泛用于缓存、会话管理、排行榜等场景。
3.2 准备环境
克隆1台新虚拟机
| 主机名 | IP地址 | 说明 |
|---|---|---|
| redis64 | 192.168.90.64 | redis服务器 |
修改IP地址和主机名
[root@redis64 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis64[root@redis64 ~]# nmcli connection【肯耐申】 modify【莫迪fái】ens160 ipv4.addresses【额拽西斯】 192.168.90.64/24 autoconnect【奥特欧 坑聂特】 yes[root@redis64~]# nmcli connection【肯耐申】 up ens1603.3 安装和运行redis【瑞迪斯】
命令操作如下所示:
#安装redis【瑞迪斯】[root@redis64 ~]# yum -y install【因-斯多】 redis【瑞迪斯】
#查看redis【瑞迪斯】 版本[root@redis64 ~]# rpm -q redis【瑞迪斯】redis-6.2.18-1.el9_6.x86_64
#设置开机自启,并立即启动[root@redis64 ~]# systemctl【西斯屯-ctl】 enable【ing 内 步】 redis【瑞迪斯】 --now
#查看redis端口[root@redis64 ~]# netstat【劣 s 塔】 -antlup | grep【哥瑞普】 redis【瑞迪斯】tcp 0 0 127.0.0.1:6379 0.0.0.0:* LISTEN 34578/redis-servertcp6 0 0 ::1:6379 :::* LISTEN 34578/redis-server3.4 连接redis【瑞迪斯】 服务
命令操作如下所示:
#连接redis【瑞迪斯】[root@redis64 ~]# redis-cli
#检查能否正在访问127.0.0.1:6379> pingPONG
#断开连接127.0.0.1:6379> exit【诶西特】[root@redis64 ~]#完整的连接redis
#发现通过IP无法连接[root@redis64 ~]# redis-cli -h 192.168.90.64 -p 6379Could not connect to Redis at 192.168.90.64:6379: Connection refused修改redis【瑞迪斯】 配置文件,使得redis【瑞迪斯】 可以被任何机器连接
#修改前[root@redis64 ~]# vim /etc/redis/redis.conf 72 # IF YOU ARE SURE YOU WANT YOUR INSTANCE TO LISTEN TO ALL THE INTERFACES 73 # JUST COMMENT OUT THE FOLLOWING LINE. 74 # ~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~ 75 bind 127.0.0.1 -::1 #修改75行
#修改后[root@redis64 ~]# vim /etc/redis/redis.conf 72 # IF YOU ARE SURE YOU WANT YOUR INSTANCE TO LISTEN TO ALL THE INTERFACES 73 # JUST COMMENT OUT THE FOLLOWING LINE. 74 # ~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~ 75 bind 0.0.0.0
#修改配置文件后重启[root@redis64 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 redis【瑞迪斯】
#现在可以连接[root@redis64 ~]# redis-cli -h 192.168.90.64 -p 6379192.168.90.64:6379> pingPONG3.5 给redis【瑞迪斯】 设置密码
命令操作如下所示:
#修改903行[root@redis64 ~]# vim /etc/redis/redis.conf 900 # The requirepass is not compatable with aclfile option and the ACL LOAD 901 # command, these will cause requirepass to be ignored. 902 # 903 requirepass 123456
#修改后重启[root@redis64 ~]# systemctl【西斯屯-ctl】 restart【 率 s 达r】 redis【瑞迪斯】
#连接redis【瑞迪斯】[root@redis64 ~]# redis-cli
# 这时候操作失败127.0.0.1:6379> ping(error) NOAUTH Authentication required.
# 输入密码认证127.0.0.1:6379> auth 123456OK127.0.0.1:6379> pingPONG四、字符串类型(string【斯jǘn】 类型)
当前任务环节
4.1 应用场景
Redis【瑞迪斯】 字符串类型是最基本的数据类型,支持存储整数、浮点数和字符串,适用于多种应用场景,以下是一些常见的应用场景:
- 缓存:可存储用户名、密码、会话标识符等简短字符串,也能缓存数据库查询结果、网页内容、用户信息等常用数据,减轻数据库压力,提高访问速度。例如在商品系统中,用 Redis【瑞迪斯】 String【斯jǘn】 类型缓存商品的静态信息,商品信息更新时,同步更新或使缓存失效 。
- 计数器:利用 incr【因kuì儿】 和 decr【迪kuì儿】 命令实现计数功能,适用于统计网页访问量、点赞数、文章浏览量、商品库存数量等。比如在文章浏览量统计中,每次文章被访问,文章 ID 对应的浏览次数在 Redis【瑞迪斯】 中递增,还可定期将浏览次数同步到数据库用于历史数据分析 。
- 分布式锁:结合 setNX 命令,使用字符串实现简单的分布式锁,保证在分布式系统中的数据一致性和并发控制。例如在电商的秒杀活动或库存管理中,确保同一时间只有一个进程或线程可以修改共享资源,避免数据不一致 。
- 共享会话(Session【塞-神】):在分布式 Web 应用里,可集中管理用户的 Session【塞-神】 信息(如登录信息),确保用户无论访问哪台服务器都能保持一致的会话状态,避免因负载均衡到不同服务器而需重新登录。
- 手机验证码:存储短信验证码并设置过期时间,还可限制用户获取验证码的频率,例如限制每分钟获取不超过 5 次 。
4.2 设置单个值
设置单个值,命令格式:
set【赛特】 key【kì】 value【挖柳】
查看key【kì】 对应的值
get【脚(白话)特】 key【kì】
[root@redis64 ~]# redis-cli -h 192.168.90.64 -p 6379192.168.90.64:6379> auth 123456OK192.168.90.64:6379> set【赛特】 school【斯故】 moershiOK192.168.90.64:6379> get【脚(白话)特】 school【斯故】"moershi"4.4 设置多个值
设置多个值,命令格式:
mset key1 value【挖柳】1 key2 value【挖柳】2 key3 value【挖柳】3…
查看多个key【kì】 对应的值
mget key1 key2 key3
192.168.90.64:6379> mset name jam age 30 class yjs001OK192.168.90.64:6379> mget name age class1) "jam"2) "30"3) "yjs001"4.5 设置值的有效期
存储变量时 设置变量的有效期 px(毫秒) ex (秒)
192.168.90.64:6379> set【赛特】 name jam ex 10 #变量10秒过期OK192.168.90.64:6379> set【赛特】 class nsd px 10 #变量10毫秒过期OK192.168.90.64:6379>
# NX 不覆盖赋值192.168.90.64:6379> set【赛特】 name xiaohong NX(nil)192.168.90.64:6379> get【脚(白话)特】 name"jam"
# XX 覆盖赋值192.168.90.64:6379> set【赛特】 name yaya XXOK192.168.90.64:6379> get【脚(白话)特】 name"yaya"192.168.90.64:6379>set【赛特】 命令完整格式演示
set 名称 值 有效期类型 有效时间 是否覆盖 set gender girl ex 20 NX
192.168.90.64:6379> set【赛特】 gender girl ex 20 NXOK4.6 数字增减操作
incr【因kuì儿】 递增数字
- 递增数字:字符串类型可以存储任何形式的字符串,当存储的字符串是整数形式时,
Redis【瑞迪斯】 提供了一个实用的命令 incr【因kuì儿】,其作用是让当前键值递增,并返回递增后的值。
当要操作的键不存在时会默认键值为0,所以第一次递增后的结果是1。
# 创建变量192.168.90.64:6379> set【赛特】 num 1192.168.90.64:6379> incr【因kuì儿】 num #+1(integer) 2192.168.90.64:6379> incr【因kuì儿】 num #+1(integer) 3192.168.90.64:6379> get【脚(白话)特】 num"3"
# 复数递增数字 incrby192.168.90.64:6379> incrby【因kuì儿 by】 num 2 #+2(integer) 5192.168.90.64:6379> incrby【因kuì儿 by】 num 3 #+3(integer) 8decr【迪kuì儿】 递减数字
- 增加指定的整数
- 递减数字192.168.90.64:6379> decr【迪kuì儿】 num #-1(integer) 7
# 复数递减数字 decrby192.168.90.64:6379> decrby num 3 #(integer) 4append【额 篇的】 尾部追加值
- 向尾部追加值
append【额 篇的】通常指追加操作。在文件处理方面,可将数据添加到已有文件的末尾,而不是覆盖原内容。
# 创建变量hi192.168.90.64:6379> set【赛特】 hi HelloOK
# 因为字符串包含空格,需要使用引号192.168.90.64:6379> append【额 篇的】 hi " World"(integer) 11 # 返回值为hi的总长度
192.168.90.64:6379> get【脚(白话)特】 hi"Hello World"4.7 字符串处理
strlen【斯拽轮】 获取字符串长度
- 获取字符串长度
strlen【斯拽轮】是用于获取存储在指定键的字符串值的长度的命令
192.168.90.64:6379> strlen【斯拽轮】 hi(integer) 11- 中文字符返回字节数192.168.90.64:6379> set【赛特】 name 张三OK192.168.90.64:6379> strlen【斯拽轮】 name(integer) 6 # UTF-8编码的中文,由于“张”和“三”两个字的UTF-8编码的长度都是3,所以此例中会返回6。getrange 获取变量部分数据
getrange【脚(白话) cùn局】命令用于获取存储在指定键的字符串值的子字符串。它的核心用途是按指定的起始和结束位置提取字符串的一部分。
# 创建变量192.168.90.64:6379> set【赛特】 zfc ABCEFOK
# 输出变量值192.168.90.64:6379> get zfc"ABCEF"
# 输出第1个到第2个字符192.168.90.64:6379> getrange【脚(白话) cùn局】 zfc 0 1"AB"
# 输出第3个到第5个字符192.168.90.64:6379> getrange【脚(白话) cùn局】 zfc 2 4"CEF"
# 输出倒数第2个到第1个字符192.168.90.64:6379> getrange【脚(白话) cùn局】 zfc -2 -1"EF"192.168.90.64:6379>五、Key【kì】的操作
当前任务环节
5.1 keys 列出所有的key【kì】
192.168.90.64:6379> keys *1) "age"2) "classs"3) "name"4) "school【斯故】"
#keys 使用统配符查看变量, * 匹配所有变量名, ? 一个字符
# 变量名是3个字符192.168.90.64:6379> keys ???1) "age"
# 变量名是a 开头的192.168.90.64:6379> keys a*1) "age"
# 查看指定变量是否存在192.168.90.64:6379> keys gender(empty list or set) # 说明变量没有定义
192.168.90.64:6379> keys name1) "name"5.2 select【涩莱克特】 选择数据库
(redis【瑞迪斯】总共有15个库,从0到15)
# select【涩莱克特】 切换库 默认库编号 0-15
# 切换到 1号库里192.168.90.64:6379> select【涩莱克特】 1OK
# 查看数据没有数据192.168.90.64:6379[1]> keys *(empty list or set)192.168.90.64:6379[1]>192.168.90.64:6379[1]> select【涩莱克特】 0OK192.168.90.64:6379> select【涩莱克特】 16(error) ERR DB index is out of range
# move 命令 移动变量到其他库里192.168.90.64:6379> keys *1) "age"2) "classs"3) "name"4) "school【斯故】"5.3 move 把某个key【kì】移动到某个库中
move 命令 移动变量到其他库里
192.168.90.64:6379> keys *1) "age"2) "classs"3) "name"4) "school【斯故】"
# 把age 变量移动到1 号库里192.168.90.64:6379> move age 1(integer) 1192.168.90.64:6379> keys *1) "classs"2) "name"3) "school【斯故】"192.168.90.64:6379> select【涩莱克特】 1OK192.168.90.64:6379[1]> keys *1) "age"5.4 exists【伊贼谁斯】 判断一个key【kì】是否存在
#exists【伊贼谁斯】 检查变量是否存储 返回值1 变量存储 返回值是0 变量不存在192.168.90.64:6379[1]> select【涩莱克特】 0OK192.168.90.64:6379> EXISTS【伊贼谁斯】 name # 检查name变量是否存在(integer) 1192.168.90.64:6379> get【脚(白话)特】 name"plj"192.168.90.64:6379> set【赛特】 name bobOK192.168.90.64:6379> get【脚(白话)特】 name"bob"5.5 key【kì】的过期时间
expire【ī 斯 拜尔】 设置一个key【kì】的过期时间
ttl 查看一个剩余的过期时间
#EXPIRE【ī 斯 拜尔】 命令设置变量的过期时间 不设置变量永不过期#ttl 检查变量可以在内存里存多久192.168.90.64:6379> set【赛特】 sex girlOK192.168.90.64:6379> ttl sex(integer) -1 #表示永不过期
192.168.90.64:6379> EXPIRE【ī 斯 拜尔】 sex 15 #设置过期时间15 秒(integer) 1
192.168.90.64:6379> keys sex1) "sex"
192.168.90.64:6379> ttl sex(integer) 8 #还剩下8秒时间过期
192.168.90.64:6379> ttl sex(integer) -2 #表示已经过期被删除
192.168.90.64:6379> keys sex(empty list or set)衍生命令(高频扩展)
Redis针对过期时间提供了更灵活的衍生命令,补充EXPIRE的不足:
| 命令 | 功能 | 示例 |
|---|---|---|
PEXPIRE | 设置毫秒级过期时间(更高精度) | PEXPIRE user:session:100 1800000(30分钟) |
EXPIREAT | 设置Key在指定Unix时间戳(秒)过期 | EXPIREAT order:1001 1716643200(2024-05-26 00:00:00) |
PEXPIREAT | 设置Key在指定Unix时间戳(毫秒)过期 | PEXPIREAT order:1001 1716643200000 |
TTL | 查看Key剩余过期时间(秒,-1=永不过期,-2=已删除) | TTL user:session:100 |
PTTL | 查看Key剩余过期时间(毫秒) | PTTL user:session:100 |
PERSIST | 移除Key的过期时间(设为永不过期) | PERSIST user:session:100 |
5.6 type【泰 普】 查看某个key【kì】是属于哪个数据类型
#type【泰 普】 命令检查变量存储数据的类型#使用set【赛特】 mset命令存储的数据都字符类型。#数据的类型不同 管理的命令也不同#明天讲数据类型。
192.168.90.64:6379> set【赛特】 x 99OK192.168.90.64:6379> mset y 108OK192.168.90.64:6379> type【泰 普】 xstring192.168.90.64:6379> type【泰 普】 ystring5.7 del 删除一个key【kì】
#del 删除内存里的变量192.168.90.64:6379> keys *1) "y"2) "tea"3) "name"4) "school【斯故】"5) "x"6) "classs"192.168.90.64:6379> del tea y school【斯故】(integer) 3192.168.90.64:6379> keys *1) "name"2) "x"3) "classs"5.8 flushdb【福 辣 徐 db】 删除本库的所有的key【kì】
#flushdb【福 辣 徐 db】 删除当前所在库的所有数据192.168.90.64:6379> keys *1) "name"2) "x"3) "classs"192.168.90.64:6379> flushdb【福 辣 徐 db】OK192.168.90.64:6379> keys *(empty list or set)192.168.90.64:6379> SELECT【涩莱克特】 1OK192.168.90.64:6379[1]> keys *1) "age"5.9 flushall【福 辣 徐 ò】 删除所有库的key【kì】
192.168.90.64:6379[1]> flushall【福 辣 徐 ò】 #删除内存里的所有内存里所有数据 (慎用)六、列表类型(list【lì斯特】类型)
当前任务环节
6.1 应用场景
Redis【瑞迪斯】 列表类型是一种简单的数据结构,可用来实现队列、栈和日志记录等功能。其应用场景广泛,以下是一些常见的场景:
- 消息队列:适合实现生产者 - 消费者模式。生产者使用LPUSH【L 普斯】 命令将消息从列表左端插入,消费者使用BRPOP或RPOP【R 扑】命令从右端取出消息处理。如在微服务架构里,一个服务可将任务作为消息放入列表,另一个服务作为消费者取出任务执行。还能用于任务队列,像电商网站中,用户下单后将订单处理任务放入列表,后台工作进程取出任务进行库存更新、订单确认等操作,避免用户等待,提升体验。
- 排行榜:可用于时间序列排行榜,如在游戏里将玩家得分和时间戳作为元素放入列表,对列表排序可得不同时间段的玩家排行榜。也能实现动态排行榜,在直播平台中,观众送礼物增加主播人气值,人气值变化实时反映在排行榜上,通过快速插入新元素和删除旧元素实现榜单实时更新。
- 历史记录存储:可存储用户操作历史,如文档编辑系统中,用LPUSH【L 普斯】 命令将用户每次编辑操作记录插入列表,用LRANGE【L 轮局】 命令获取一定范围的历史记录,方便用户查看历史版本或撤销操作。还能用于系统日志记录,Web应用中,将用户登录日志、请求日志等存储在列表,便于进行日志查询和分析,故障排查时可快速获取相关日志信息。
- 栈和队列数据结构的实现:可作为栈使用,用LPUSH【L 普斯】 命令将元素插入列表头部,用LPOP【L 扑】 命令从头部弹出元素,实现后进先出的栈结构,用于一些算法实现。也能当作队列,用LPUSH【L 普斯】 命令将元素插入头部,用RPOP【R 扑】 命令从尾部弹出元素,实现先进先出的队列结构,如任务调度系统中,将任务按提交顺序放入队列,工作进程依次取出执行。
- 社交平台相关场景:如微信朋友圈点赞,按点赞顺序显示点赞好友信息,取消点赞时移除对应好友信息;Twitter、微博等社交平台中,个人用户的关注列表按关注顺序展示,粉丝列表将最近关注的粉丝列在前面。
- 待办事项与购物车:可以作为待办事项列表使用,用户添加待办事项时用LPUSH【L 普斯】 或RPUSH【R 普斯】插入列表,完成事项后用LPOP【L 扑】 或RPOP【R 扑】 移除。购物车也可使用列表实现,商品添加到购物车时插入列表,结算或移除商品时从列表移除 。
- 秒杀抢购:将商品ID作为key【kì】,商品数目作为value【挖柳】 存储在列表中,在秒杀场景中使用。
- 实时在线用户管理:可用于存储实时在线用户的列表,实现实时更新和查询在线用户信息。
- 日志记录:在Web应用中,将用户请求的URL和请求时间push到列表,并设置列表长度为一定值,查看日志时通过lrange【L 轮局】 命令获取之前请求过的URL和请求时间。
6.2 向列表左边增加元素
lpush【L 普斯】向列表左边增加元素
LPUSH【L 普斯】 命令用来向列表左边增加元素,返回值表示增加元素后列表的长度
lpush【L 普斯】是“left push”的缩写,用于将一个或多个值插入到列表的头部(左侧)
命令格式为LPUSH key value1 value2...
# 创建变量192.168.90.64:6379> lpush【L 普斯】 letter A B C(integer) 3
# 查看类型192.168.90.64:6379> type【泰 普】 letterlist【lì斯特】
# 头部追加元素192.168.90.64:6379> lpush【L 普斯】 letter d e(integer) 5lrange【L 轮局】取出列表所有元素
lrange【L 轮局】用于获取列表指定范围内的元素。它能按索引范围提取列表中的部分或全部元素。
命令格式为LRANGE key 开始 结束
# 起始下标为0,结束下标为-1192.168.90.64:6379> lrange【L 轮局】 letter 0 -11) "e"2) "d"3) "C"4) "B"5) "A"llen【L 轮】统计元素个数
llen【L 轮】是用于获取列表长度的命令。它返回存储在指定键的列表中的元素数量。
格式:有一个名为my_list的列表,执行LLEN my_list命令,就能知道my_list中有多少个元素。
192.168.90.64:6379> llen【L 轮】 letter(integer) 56.3 lindex索引元素
lindex【L 因戴克斯】命令用于获取列表中指定索引位置的元素。
通过下标输出单个元素 第1个元素下标用0表示 第2个元素下标用1表示
最后一个元素下标用-1表示
192.168.90.64:6379> lindex【L 因戴克斯】 letter 0"e"192.168.90.64:6379> lindex【L 因戴克斯】 letter 2"C"
# 最后1个192.168.90.64:6379> lindex【L 因戴克斯】 letter -1"A"
# 倒数第2个192.168.90.64:6379> lindex【L 因戴克斯】 letter -2"B"6.4 lset【L 赛特】修改元素
lset【L 赛特】用于设置列表中指定索引位置的元素值。
# 修改前查看192.168.90.64:6379> lrange【L 轮局】 letter 0 -11) "e"2) "d"3) "C"4) "B"5) "A"
# 修改第1元素192.168.90.64:6379> lset letter 0 EOK
# 修改最后1个元素192.168.90.64:6379> lset letter -1 aOK
# 修改后查看192.168.90.64:6379> lrange【L 轮局】 letter 0 -11) "E"2) "d"3) "C"4) "B"5) "a"6.5 弹出元素(删除元素)
lpop【L 扑】是“left pop”的缩写,用于从列表的头部(左侧)移除并返回一个元素。
rpop【R 扑】即“right pop”的缩写,用于从列表的尾部(右侧)移除并返回一个元素。
192.168.90.64:6379> lrange【L 轮局】 letter 0 -1 #修改前查看1) "E"2) "d"3) "C"4) "B"5) "a"192.168.90.64:6379> lpop【L 扑】 letter #弹出头部元素"E"192.168.90.64:6379> rpop【R 扑】 letter #弹出尾部元素"a"192.168.90.64:6379> lrange【L 轮局】 letter 0 -1 #修改后查看1) "d"2) "C"3) "B"6.6 尾部追加元素
rpush是“right push”的缩写,用于将一个或多个值插入到列表的尾部(右侧) 。
192.168.90.64:6379> rpush【R 普斯】 letter e f #尾部追加元素(integer) 5192.168.90.64:6379> lrange【L 轮局】 letter 0 -1 #追加后查看1) "d"2) "C"3) "B"4) "e"5) "f"6.7 插入元素
linsert【L 因涩特】用于在列表指定元素的前或后插入新元素。
before【B fò】表示在……之前。
after【啊夫特】 常用于表达在……之后。
192.168.90.64:6379> lrange【L 轮局】 letter 0 -1 #插入前查看1) "d"2) "C"3) "B"4) "e"5) "f"192.168.90.64:6379>192.168.90.64:6379> linsert【L 因涩特】 letter before【B fò】 C C2 #值C前插入C2(integer) 6192.168.90.64:6379> lrange【L 轮局】 letter 0 -1 #插入后查看1) "d"2) "C2"3) "C"4) "B"5) "e"6) "f"192.168.90.64:6379>192.168.90.64:6379> linsert【L 因涩特】 letter after【啊夫特】 C C3 #值C后插入C3(integer) 7192.168.90.64:6379> lrange【L 轮局】 letter 0 -1 #插入后查看1) "d"2) "C2"3) "C"4) "C3"5) "B"6) "e"7) "f"七、散列类型(hash【哈希】类型)
当前任务环节
7.1 应用场景
Redis【瑞迪斯】 散列类型是字符串字段和字符串值之间的映射,类似 Python 字典或 Java 的 HashMap,适合存储对象,且可像数据库更新记录一样只修改特定字段。其具体应用场景如下:
- 用户信息存储:每个用户对应一个 Hash【哈希】,以用户 ID 为键名,使用字段表示用户的属性,如姓名、年龄、生日等,而字段值则存储属性值。相比用普通的 key【kì】/value【挖柳】 结构存储,避免了序列化/反序列化的开销,且在修改其中一项信息时,无需把整个对象取回,也无需引入复杂的并发保护机制。
- 商品属性存储:可用于存储商品的多维度属性,如价格、库存、描述等。通过散列类型,能方便地对商品的各个属性进行单独的查询、修改和更新操作,提高数据处理的效率和灵活性。
- 配置管理:适用于动态更新配置字段的场景,无需反序列化整个对象。系统的配置信息可存储在散列中,当配置发生变化时,只需更新相应的字段即可,保证系统的配置信息能实时生效,且操作简单高效。
- 购物车:以用户 ID 为 key【kì】,商品 ID 为 field,商品数量为 value【挖柳】。用户向购物车中添加商品时,可通过操作散列类型来记录商品信息和数量;修改商品数量或删除商品时,也能方便地对散列中的对应字段进行更新或删除操作。
- 文章内容存储:对于文章的各种属性,如标题、作者、发布时间、内容摘要等,可以使用散列类型进行存储,以文章 ID 作为键名,各个属性作为字段和字段值,便于对文章信息进行管理和查询。
7.2 存储数据和获取数据
赋值与取值
hset【h 赛特】用于在哈希表(hash)中设置一个字段(field)的值。
hmset【hm 赛特】用于同时设置哈希表中的多个字段值。
hget【h 脚(白话)特】用于从哈希表中获取指定字段的值。
hmget【hm 脚(白话)特】用于从哈希表中获取一个或多个指定字段的值。
192.168.90.64:6379> hset【h 赛特】 user1 name bob #创建变量(integer) 1192.168.90.64:6379> type【泰 普】 user1 #查看类型hash192.168.90.64:6379>192.168.90.64:6379> hset【h 赛特】 user1 gender man #赋新值(integer) 1192.168.90.64:6379> hget【h 脚(白话)特】 user1 name #查看name列的值设置多个字段
192.168.90.64:6379> hmset【hm 赛特】 user1 email bob@qcjy.cn phone 13412345678OK192.168.90.64:6379> hmget【hm 脚(白话)特】 user1 email phone1) "bob@qcjy.cn"2) "13412345678"获取所有列名及对应的值
hgetall【h 脚(白话)特 ò】用于获取哈希表中所有的字段和值。
192.168.90.64:6379> hgetall【h 脚(白话)特 ò】 user11) "name"2) "bob"3) "gender"4) "male"5) "email"6) "bob@qcjy.cn"7) "phone"8) "13412345678"7.3 其他操作
hdel删除列
hdel【h 戴尔】用于删除哈希表中的一个或多个字段。
192.168.90.64:6379> hdel【h 戴尔】 user1 age(integer) 1只获取列名
hkeys【h kì s】用于获取哈希表中的所有字段名。
192.168.90.64:6379> hkeys【h kì s】 user11) "name"2) "gender"3) "email"4) "phone"5) "address"只获取值
hvals【h 瓦尔兹】命令用于获取哈希表中所有字段的值。
192.168.90.64:6379> hvals【h 瓦尔兹】 user11) "bob"2) "male"3) "bob@qcjy.cn"4) "13412345678"5) "beijing"获得列数量
hlen【h 轮】用于获取哈希表中字段的数量。
192.168.90.64:6379> hlen【h 轮】 user1(integer) 5八、集合类型
当前任务环节
8.1 应用场景
Redis【瑞迪斯】 集合类型是一种不允许重复元素的非线性结构,可用于存储和管理元素集合,其应用场景广泛,以下是一些常见的场景:
- 用户管理:在社交网络中可存储用户特征和记录,轻松检索用户 ID、用户名等信息;也能用于会员管理,保护和检索会员记录。
- 网站流量监控:将客户端 IP 等唯一标识添加到 Redis【瑞迪斯】 集合中,可有效跟踪网站流量,检测重复访客或恶意行为。
- 奖励管理:可以跟踪和管理奖励,方便对奖励信息进行添加、查询等操作。
- 排行榜:在搜索引擎、电影、游戏等场景中,可维护实时热门排行榜榜单。如在游戏里,可存储玩家得分或排名信息,通过集合操作实现排行榜的更新和查询。
- 标签系统:可用于存储每篇文章或商品的标签,方便根据标签进行分类和搜索。例如新闻网站可以为每篇新闻文章添加标签,用户可以根据标签快速找到感兴趣的文章。
- 社交应用:可存储用户的好友列表,通过求交集来找出共同的好友,实现共同兴趣的推荐;还能存储关注者信息,进行关注和取消关注的操作。
- 唯一性检查:集合中的元素具有唯一性,可用于检查元素是否已存在。如在注册系统中,检查用户名是否已被使用。
- 抽奖活动:将参与抽奖的用户 ID 存储在集合中,通过随机获取集合中的元素来实现抽奖功能,保证每个用户只有一次中奖机会。
- 点赞和共同关注:存储点赞用户的 ID 集合,判断某个用户是否点赞;也可通过集合操作找出多个用户的共同关注对象。
8.2 无序集合
无序集合中的每个元素都是不同的,且没有顺序
8.2.1 创建/追加/删除/查看
sadd用于向集合(set)中添加一个或多个成员。集合是一个无序且唯一的字符串集合。命令格式为SADD key member1 member2… 。
例如,执行SADD myset “apple” “banana”,就会将 “apple” 和 “banana” 添加到名为myset的集合中。当需要维护一个唯一值的集合,比如用户标签集合,使用sadd添加标签,可保证标签的唯一性。
srem【s 轮姆】命令用于移除集合中的一个或多个成员。集合是无序且元素唯一的结构。比如有集合my_set,执行命令SREM【s 轮姆】 my_set value1 value2,就会从my_set集合中移除value1和value2。这在管理集合数据,像用户兴趣标签集合,需要删除某些用户不再感兴趣的标签时非常有用。
smembers【s 门伯兹】用于获取集合中的所有成员。命令格式为SMEMBERS key。例如,执行SMEMBERS myset,会返回名为myset集合中的所有元素。当你需要查看集合内的所有数据,比如查看用户拥有的所有标签时,smembers就十分有用。
192.168.90.64:6379> sadd mylike film muisc game #创建(integer) 3192.168.90.64:6379> type【泰 普】 mylike #查看数据类型set192.168.90.64:6379> sadd mylike sleep game it #追加,自动删除重复的值(integer) 2192.168.90.64:6379> srem【s 轮姆】 mylike sleep game #删除成员(integer) 2192.168.90.64:6379> smembers【s 门伯兹】 mylike #查看成员1) "film"2) "it"3) "muisc"8.2.2 判断元素是否在集合中
sismember【sis 门伯】是一个用于判断指定成员是否存在于集合中的命令 。其命令格式为SISMEMBER key member。假设你有一个名为fruits的集合,执行SISMEMBER fruits "banana",若banana存在于fruits集合,该命令返回1;若不存在,则返回0 。
192.168.90.64:6379> sismember【sis 门伯】 mylike game #输出0表示不存在(integer) 0192.168.90.64:6379> sismember【sis 门伯】 mylike music #输出1表示存在(integer) 18.2.2.1输出成员个数
scard【s 卡德】用于获取集合中成员的数量。命令格式为SCARD key。例如,对于名为my_set的集合,执行SCARD my_set,就会返回该集合包含的元素个数。
192.168.90.64:6379> scard【s 卡德】 mylike(integer) 3192.168.90.64:6379>8.2.3 集合运算
192.168.90.64:6379> smembers mylike1) "film"2) "it"3) "muisc"192.168.90.64:6379> sadd helike film music game sleep(integer) 4192.168.90.64:6379>合集 sunion【s U凝】
sunion【s U凝】用于返回一个集合的并集,即多个集合中所有不同的元素组成的集合。命令格式为SUNION key1 key2...。例如,有集合set1包含元素a、b,集合set2包含元素b、c,执行SUNION set1 set2会返回包含a、b、c的集合。
#合集 重复的只显示一次192.168.90.64:6379> sunion【s U凝】 mylike helike1) "game"2) "it"3) "muisc"4) "film"5) "sleep"6) "music"192.168.90.64:6379>交集sinter【s 因特尔】
sinter【s 因特尔】用于返回多个集合的交集,即所有给定集合中都存在的元素组成的集合。命令格式为SINTER key1 key2... 。例如,集合set1包含a、b、c,集合set2包含b、c、d,执行SINTER set1 set2,返回的集合将包含b、c
#交集192.168.90.64:6379> sinter【s 因特尔】 mylike helike1) "film"192.168.90.64:6379>差集sdiff【s 迪夫】
sdiff【s 迪夫】用于返回给定集合之间的差集。命令格式为SDIFF key1 key2... 。以两个集合为例,sdiff会返回在key1集合中,但不在key2及后续集合中的所有元素。比如集合set1包含a、b、c,集合set2包含b、c,执行SDIFF set1 set2,返回的集合将只包含a 。
#差集: 用第1列的变量和第2列的变量比192.168.90.64:6379> sdiff【s 迪夫】 mylike helike1) "it"2) "muisc"192.168.90.64:6379> sdiff【s 迪夫】 helike mylike1) "game"2) "sleep"3) "music"192.168.90.64:6379>8.2.4 随机获得集合中的元素
srandmember【s 轮 门伯】用于从集合中随机返回一个或多个成员。命令格式为SRANDMEMBER key [count]。若不指定count,则随机返回一个成员;若指定count,且为正数,会返回指定数量不重复的成员(若集合元素不足,返回实际数量);若count为负数,会返回指定数量可能重复的成员。
# 在集合helike中随机取出两个不同元素。192.168.90.64:6379> srandmember【s 轮 门伯】 helike 21) "sleep"2) "music"192.168.90.64:6379> srandmember【s 轮 门伯】 helike 21) "game"2) "music"192.168.90.64:6379># 在集合helike中随机取出两个有可能相同元素。192.168.90.64:6379> srandmember【s 轮 门伯】 helike -21) "film"2) "music"192.168.90.64:6379> srandmember【s 轮 门伯】 helike -21) "music"2) "music"8.2.5 集合中随机弹出一个元素
spop【s 扑】用于从集合中随机移除并返回一个成员。命令格式为SPOP key。例如,对于名为my_set的集合,执行SPOP my_set,会从my_set集合里随机挑选一个元素并删除它,同时返回该元素。
192.168.90.64:6379> spop【s 扑】 helike #第1次弹出"music"192.168.90.64:6379> spop【s 扑】 helike #第2次弹出"game"192.168.90.64:6379> smembers【s 门伯兹】 helike #查看1) "film"2) "sleep"8.3 有序集合
8.3.1 zadd命令的返回值是新加入到集合中的元素个数
zadd用于向有序集合(Sorted Set)中添加一个或多个成员,同时为每个成员关联一个分数(score),有序集合会根据分数对成员进行排序。命令格式为ZADD key score1 member1 [score2 member2 ...] 。例如,执行ZADD myzset 10 "apple" 20 "banana",就会将“apple”和“banana”添加到名为myzset的有序集合中,“apple”的分数是10,“banana”的分数是20 。
zcard用于获取有序集合中的成员数量。命令格式为ZCARD key。例如,对于名为myzset的有序集合,执行ZCARD myzset,会返回myzset集合中的元素个数。
zrange用于返回有序集合中指定区间内的成员。有序集合成员按分数值递增(从小到大)顺序排列。命令格式为ZRANGE key start stop [WITHSCORES]。start和stop是元素的索引值,索引从0开始,负数表示从集合尾部开始计数, -1 代表最后一个元素。例如,执行ZRANGE myzset 0 2 WITHSCORES,会返回名为myzset的有序集合中索引0到2的成员及其分数
withscores是一个可选参数。当使用它时,命令在返回有序集合成员的同时,还会返回每个成员对应的分数。例如ZRANGE myzset 0 -1 WITHSCORES,会返回myzset有序集合中所有成员及其对应的分数。
192.168.90.64:6379> zadd scores 88 tom 90 jerry 75 bob 92 alice #创建变量(integer) 4192.168.90.64:6379> type【泰 普】 scores #查看类型zset192.168.90.64:6379> zcard【z 卡德】 scores #统计成员个数(integer) 4192.168.90.64:6379> zrange【z 轮局】 scores 0 -1 #输出成员名称1) "bob"2) "tom"3) "jerry"4) "alice"192.168.90.64:6379> zrange【z 轮局】 scores 0 -1 withscores【维s 科s】 #输出成员名称及对应的值1) "bob"2) "75"3) "tom"4) "88"5) "jerry"6) "90"7) "alice"8) "92"8.3.2 获得某个成员的值
192.168.90.64:6379> zscore【z s科】 scores tom"88"8.3.3 获得指定分数范围的元素
zrangebyscore用于返回有序集合中指定分数区间内的成员。命令格式为ZRANGEBYSCORE key min max [WITHSCORES] [LIMIT offset count] 。min和max是分数范围,比如执行ZRANGEBYSCORE myzset 80 100 WITHSCORES,会返回名为myzset的有序集合中分数在80(含)到100(含)之间的成员及其分数。WITHSCORES可选,用于显示成员对应的分数,LIMIT用于指定返回结果的偏移量和数量。
192.168.90.64:6379> zrangebyscore【z 轮局 拜 s科】 scores 80 90 WITHSCORES【维s 科s】1) "jerry"2) "85"3) "tom"4) "88"8.3.4 增加某个元素的分数
zincrby【z 因kuì儿 拜】用于为有序集合中的成员增加指定的分数。命令格式为ZINCRBY key increment member 。例如,执行ZINCRBY myzset 5 "player1",会将有序集合myzset中的成员“player1”的分数增加5 。
192.168.90.64:6379> zincrby【z 因kuì儿 拜】 scores 3 bob"78"192.168.90.64:6379> zscore【z s科】 scores bob"78"8.3.5 获得指定分数范围内的元素个数
zcount【z kàn特】用于统计有序集合中指定分数区间内成员的数量。命令格式为ZCOUNT key min max。比如执行ZCOUNT myzset 60 80,就会返回名为myzset的有序集合中分数在60(含)到80(含)之间的成员数量。
192.168.90.64:6379> zcount【z kàn特】 scores 80 90(integer) 28.3.6 删除元素
zrem【z 轮姆】用于从有序集合中移除一个或多个成员。命令格式为ZREM key member [member ...] 。例如,执行ZREM myzset "member1" "member2",会从名为myzset的有序集合中移除“member1”和“member2” 。
192.168.90.64:6379> zrem【z 轮姆】 scores bob(integer) 18.3.7 获得元素的排名
zrank【z 软克】用于获取有序集合中指定成员的排名。排名从0开始,是按分数从小到大排列的索引值。命令格式为ZRANK key member。例如,对于有序集合myzset,执行ZRANK myzset "member1",会返回“member1”在myzset集合中的排名。
zrevrank【z 瑞乌 软克】与zrank【z 软克】类似,但它是获取有序集合中指定成员按分数从大到小排列的排名。命令格式为ZREVRANK key member。例如,在名为myzset的有序集合里执行ZREVRANK myzset "member1",会返回“member1”在myzset集合中按分数降序排列的排名。
192.168.90.64:6379> zrank【z 软克】 scores tom # 获取tom的排名(integer) 1 # 升序排列,从0开始计数
192.168.90.64:6379> zrevrank【z 瑞乌 软克】 scores alice # 获取alice的排名(integer) 0 # 降序排列,从0开始计数九、作业
1 选择题
- Redis 集合类型中,以下哪个命令用于判断元素是否在集合中? B A. sunion B. sismember C. sinter D. sdiff
- 若要在 Redis 列表类型中从尾部追加元素,应使用以下哪个命令?C A. LPUSH B. RPOP C. RPUSH D. LPOP
- Redis 散列类型适合存储以下哪种数据? C A. 单一的字符串 B. 有序的元素列表 C. 具有多个属性的对象 D. 不允许重复的无序元素
2 填空题
- Redis 字符串类型中,使用__incr__命令可以让存储的整数值递增。
- 在 Redis 列表类型中,用__lpop__命令可以从列表头部弹出元素。
- Redis 集合类型中,用于获取两个集合交集的命令是__sinter__。
3 简答题
-
简述 Redis 散列类型在存储用户信息方面相较于普通 key/value 结构的优势。 答: 相比用普通的 key /value 结构存储, 散列类型存储每个用户对应一个 Hash,以用户 ID 为键名,使用字段表示用户的属性,如姓名、年龄、生日等,而字段值则存储属性值。避免了序列化/反序列化的开销,且在修改其中一项信息时,无需把整个对象取回,也无需引入复杂的并发保护机制。
-
请说明 Redis 列表类型可以实现哪些数据结构,以及对应的命令操作。 答:
1. 队列: 127.0.0.1:6379> lpush test3 1 2 3 4 #在列队头部插入元素 (integer) 7 127.0.0.1:6379> rpush test3 1 2 3 4 #在列队尾部插入元素 (integer) 11 127.0.0.1:6379> lpop test3 #移除并返回队列的第一个元素 "4" 127.0.0.1:6379> rpop test3 #移除并返回队列的最后一个元素 "4"
2. 栈:
127.0.0.1:6379> lpush test3 1 2 3 4 #列表左侧(头部) 插入元素 (integer) 4 127.0.0.1:6379> lpop test3 #列表左侧(头部) 移除并获取元素 "4"- 列举 Redis 集合类型的三个常见应用场景。 答: 社交应用 唯一性检查 抽奖活动
4 操作题
- 假设你已经连接到 Redis 服务,现在要创建一个散列类型的数据,键名为“product1”,包含字段“name”值为“手机”,“price”值为“3000”,“stock”值为“50”,请写出对应的 Redis 命令。
127.0.0.1:6379> hmset product1 name 手机 price 3000 stock 50OK127.0.0.1:6379> hmget product1 name price stock1) "\xe6\x89\x8b\xe6\x9c\xba"2) "3000"3) "50"127.0.0.1:6379>- 有一个 Redis 列表类型的数据“history_list”,请写出命令将元素“操作 1”插入到列表头部,并从列表尾部弹出一个元素。
127.0.0.1:6379> lpush history_list A B C(integer) 3127.0.0.1:6379> lrange history_list 0 -11) "C"2) "B"3) "A"127.0.0.1:6379> lpush history_list 操作1(integer) 4127.0.0.1:6379> lrange history_list 0 -11) "\xe6\x93\x8d\xe4\xbd\x9c1"2) "C"3) "B"4) "A"127.0.0.1:6379> rpop history_list"A"127.0.0.1:6379> lrange history_list 0 -11) "\xe6\x93\x8d\xe4\xbd\x9c1"2) "C"3) "B"127.0.0.1:6379>- 现有两个 Redis 集合“set1”包含元素“a”“b”“c”,“set2”包含元素“b”“c”“d”,请写出命令获取它们的并集、交集和差集。
127.0.0.1:6379> sadd set1 a b c(integer) 3127.0.0.1:6379> sadd set2 b c d(integer) 3127.0.0.1:6379> sunion set1 set2 #并集1) "b"2) "a"3) "d"4) "c"127.0.0.1:6379> sinter set1 set2 #交集1) "b"2) "c"127.0.0.1:6379> sdiff set1 set2 #差集1) "a"127.0.0.1:6379>13:redis集群高可用
今日工作任务路线图
一、工作场景
为确保 Redis 服务的高可用和数据持久化,运维团队开始一系列操作。首先,团队搭建了一主一从的 Redis 结构,将 redis67 配置为主服务器,redis68 作为从服务器,实现数据的实时同步和备份。接着,为进一步提高服务的可靠性,在 redis69 上配置了哨兵服务。在一次突发状况中,主服务器 redis67 出现故障,哨兵服务迅速响应,自动将从服务器 redis68 升级为主服务器,保障业务不受影响。当 redis67 恢复后,又自动成为新主服务器的从服务器,确保整个 Redis 服务的稳定运行。
二、为什么学
在当今数据量激增的时代,企业对数据存储和访问的效率与稳定性要求极高。从文档可知,Redis 若没有高可用机制,一旦主节点故障,业务会中断,数据也可能丢失。而 Redis 高可用方案,如主从复制、哨兵服务、集群部署等,能保障数据的自动备份与实时同步。像哨兵服务可自动监控节点状态,在主节点故障时快速实现故障转移,将从节点提升为主节点。集群部署则能实现数据的分布式存储,避免单点性能瓶颈,让 Redis 服务在各种复杂环境下稳定运行,确保业务的连续性。
三、Redis持久化
当前任务环节
3.1 使用RDB文件恢复数据
创建1台虚拟机
| 主机名 | IP地址 | 说明 |
|---|---|---|
| redis50 | 192.168.90.50 | redis服务器 |
配置服务器192.168.90.50
[root@redis50 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis50[root@redis50 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.50/24 autoconnect【奥特欧 坑聂特】 yes[root@redis50~]# nmcli connection【肯耐申】 up ens160
#配置DNS[root@redis50 ~]# vim /etc/resolv.confnameserver 192.168.90.2步骤一:设置存盘间隔为120秒且10个key改变数据自动存盘
查看 redis服务存储数据到硬盘的存盘频率
| 配置行 | 含义 | 作用 |
|---|---|---|
save 3600 1 | 如果 3600 秒(1 小时)内,至少有 1 个 key 被修改,则保存快照。 | 最宽松的持久化,防止长时间无备份 |
save 300 100 | 如果 300 秒(5 分钟)内,至少有 100 个 key 被修改,则保存快照。 | 中等频率,平衡性能与安全性 |
save 60 10000 | 如果 60 秒(1 分钟)内,至少有 10,000 个 key 被修改,则保存快照。 | 高频写入场景下的快速保护 |
[root@redis50 ~]# yum -y install【因-斯多】 redis
#修改之前[root@redis50 ~]# vim /etc/redis/redis.conf 383 # save 3600 1 384 # save 300 100 385 # save 60 10000
#修改之后[root@redis50 ~]# vim /etc/redis/redis.conf 383 # save 3600 1 384 save 120 10 385 # save 60 10000
#启动redis[root@redis50 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis
#目前还没有rdb文件[root@redis50 ~]# ls /var/lib/redis/在服务启动后,要在2分钟内存储大于等10个变量
#存上4个变量[root@redis50 ~]# redis-cli127.0.0.1:6379> mset a 1 b 2 c 3 d 4OK127.0.0.1:6379> exit
#还没有达到存储的条件,还没有rdb文件[root@redis50 ~]# ls /var/lib/redis/
#继续存上6个变量[root@redis50 ~]# redis-cli127.0.0.1:6379> mset x 1 y 2 z 3 k 6 i 7 z 9 f 22 zz 99 cc 66OK127.0.0.1:6379> exit
#达到条件,数据已经持久化到rdb文件中了[root@redis50 ~]# ls /var/lib/redis/dump.rdb步骤二:使用RDB文件恢复数据
#第1步:拷贝 dump.rdb 文件就是对数据的备份[root@redis50 ~]# cp /var/lib/redis/dump.rdb /opt/[root@redis50 ~]# ls /opt/dump.rdb
#第2步:清空数据[root@redis50 ~]# redis-cli127.0.0.1:6379> flushallOK127.0.0.1:6379> keys *(empty array)使用备份的dump.rdb文件恢复
#第1步 停止内存没有数据的redis服务[root@redis50 ~]# systemctl【西斯屯-ctl】 stop【 s 多】 redis
#第2步 把没有数据的dump.rdb文件删除[root@redis50 ~]# rm -rf /var/lib/redis/dump.rdb
#第3步 把备份dump.rdb文件拷贝到数据库目录下[root@redis50 ~]# cp /opt/dump.rdb /var/lib/redis/
#第4步 启动redis服务 并连接服务查看数据[root@redis50 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis[root@redis50 ~]# redis-cli127.0.0.1:6379> keys * 1) "x" 2) "a" 3) "y" 4) "cc" 5) "f" 6) "c" 7) "zz" 8) "z" 9) "d"10) "i"11) "k"12) "b"3.2 使用AOF文件恢复数据
操作步骤# 1. 在 A 节点(源)安全关闭 Redis(确保 AOF 完整)redis-cli -h A_host shutdown
# 2. 拷贝 AOF 文件到 B 节点scp /path/to/appendonly.aof user@B_host:/redis/data/
# 3. 在 B 节点(目标):# - 停止 Redis# - 备份/删除原有 AOF 和 RDB# - 放入新 AOF 文件# - 确保 redis.conf 中 appendonly yes# - 启动 Redis
redis-server /etc/redis.conf步骤一:启用AOF
命令操作如下所示:
[root@redis50 ~]# redis-cli
#启用aof文件127.0.0.1:6379> config set appendonly yesOK
#查看是否启用192.168.88.50:6379> config get appendonly1) "appendonly"2) "yes"
#保存配置127.0.0.1:6379> config rewriteOK127.0.0.1:6379> exit
#数据库目录多了.aof文件[root@redis50 ~]# ls /var/lib/redis/appendonly.aof dump.rdb
#查看文件行数[root@redis50 ~]# wc -l /var/lib/redis/appendonly.aof2 /var/lib/redis/appendonly.aof
#存放数据[root@redis50 ~]# redis-cli127.0.0.1:6379> mset x 1 y 2 z 3OK127.0.0.1:6379> keys * 1) "x" 2) "a" 3) "y" 4) "cc" 5) "f" 6) "c" 7) "zz" 8) "z" 9) "d"10) "i"11) "k"12) "b"127.0.0.1:6379> exit
#查看文件行数[root@redis50 ~]# wc -l /var/lib/redis/appendonly.aof22 /var/lib/redis/appendonly.aof步骤二:使用AOF文件恢复数据
1)备份aof文件
[root@redis50 ~]# cp /var/lib/redis/appendonly.aof /opt/[root@redis50 ~]# ls /opt/appendonly.aof dump.rdb2)清空数据
[root@redis50 ~]# redis-cli127.0.0.1:6379> flushallOK127.0.0.1:6379> exit3)恢复数据
[root@redis50 ~]# rm -rf /var/lib/redis/* [root@redis70 ~]# cp /opt/appendonly.aof /var/lib/redis/ [root@redis70 ~]# chown -R redis:redis /var/lib/redis [root@redis50 ~]# systemctl【西斯屯-ctl】 restart redis [root@redis50 ~]# redis-cli 127.0.0.1:6379> keys * 1) "x" 2) "a" 3) "y" 4) "cc" 5) "f" 6) "c" 7) "zz" 8) "z" 9) "d"10) "i"11) "k"12) "b"四、redis高可用集群
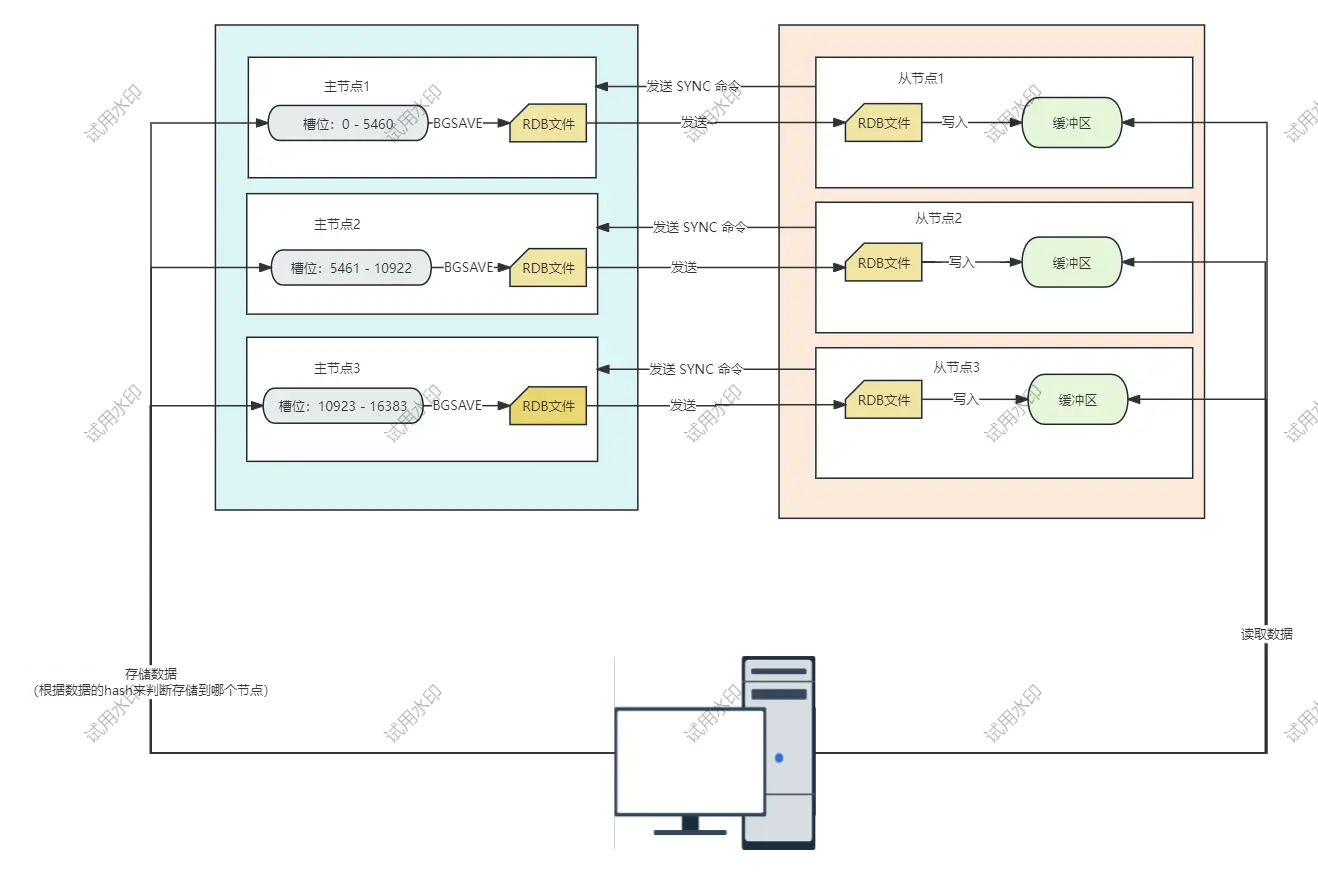
当前任务环节
4.1 准备环境
创建6台新虚拟机
| 主机名 | IP地址 | 说明 |
|---|---|---|
| redis51 | 192.168.90.51 | redis服务器 |
| redis52 | 192.168.90.52 | redis服务器 |
| redis53 | 192.168.90.53 | redis服务器 |
| redis54 | 192.168.90.54 | redis服务器 |
| redis55 | 192.168.90.55 | redis服务器 |
| redis56 | 192.168.90.56 | redis服务器 |
4.1.1 配置redis51
配置服务器192.168.90.51
[root@redis51 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis51[root@redis51 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.51/24 autoconnect【奥特欧 坑聂特】 yes[root@redis51~]# nmcli connection【肯耐申】 up ens160安装redis和配置
[root@redis51 ~]# yum -y install【因-斯多】 redis#修改4行配置[root@redis51 ~]# vim /etc/redis/redis.conf75 bind 0.0.0.01387 cluster-enabled yes #启用集群功能1395 cluster-config-file nodes-6379.conf #存储集群信息文件1401 cluster-node-timeout 5000 #集群中主机通信超时时间
[root@redis51 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis[root@redis51 ~]# netstat -utnlp | grep redis-servetcp 0 0 0.0.0.0:6379 0.0.0.0:* LISTEN 1793/redis-server 0tcp 0 0 0.0.0.0:16379 0.0.0.0:* LISTEN 1793/redis-server 04.1.1 配置redis52
配置服务器192.168.90.52
[root@redis52 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis52[root@redis52 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.52/24 autoconnect【奥特欧 坑聂特】 yes[root@redis52~]# nmcli connection【肯耐申】 up ens160安装redis和配置
[root@redis52 ~]# yum -y install【因-斯多】 redis#修改4行配置[root@redis52 ~]# vim /etc/redis/redis.conf75 bind 0.0.0.01387 cluster-enabled yes #启用集群功能1395 cluster-config-file nodes-6379.conf #存储集群信息文件1401 cluster-node-timeout 5000 #集群中主机通信超时时间
[root@redis52 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis[root@redis52 ~]# netstat -utnlp | grep redis-servetcp 0 0 0.0.0.0:6379 0.0.0.0:* LISTEN 1758/redis-server 0tcp 0 0 0.0.0.0:16379 0.0.0.0:* LISTEN 1758/redis-server 04.1.1 配置redis53
配置服务器192.168.90.53
[root@redis53 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis53[root@redis53 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.53/24 autoconnect【奥特欧 坑聂特】 yes[root@redis53~]# nmcli connection【肯耐申】 up ens160安装redis和配置
[root@redis53 ~]# yum -y install【因-斯多】 redis#修改4行配置[root@redis53 ~]# vim /etc/redis/redis.conf75 bind 0.0.0.01387 cluster-enabled yes #启用集群功能1395 cluster-config-file nodes-6379.conf #存储集群信息文件1401 cluster-node-timeout 5000 #集群中主机通信超时时间
[root@redis53 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis[root@redis53 ~]# netstat -utnlp | grep redis-servetcp 0 0 0.0.0.0:16379 0.0.0.0:* LISTEN 1785/redis-server 0tcp 0 0 0.0.0.0:6379 0.0.0.0:* LISTEN 1785/redis-server 04.1.1 配置redis54
配置服务器192.168.90.54
[root@redis54 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis54[root@redis54 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.54/24 autoconnect【奥特欧 坑聂特】 yes[root@redis54~]# nmcli connection【肯耐申】 up ens160安装redis和配置
[root@redis54 ~]# yum -y install【因-斯多】 redis#修改4行配置[root@redis54 ~]# vim /etc/redis/redis.conf75 bind 0.0.0.01387 cluster-enabled yes #启用集群功能1395 cluster-config-file nodes-6379.conf #存储集群信息文件1401 cluster-node-timeout 5000 #集群中主机通信超时时间
[root@redis54 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis[root@redis54 ~]# netstat -utnlp | grep redis-servetcp 0 0 0.0.0.0:6379 0.0.0.0:* LISTEN 1745/redis-server 0tcp 0 0 0.0.0.0:16379 0.0.0.0:* LISTEN 1745/redis-server 04.1.1 配置redis55
配置服务器192.168.90.55
[root@redis55 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis55[root@redis55 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.55/24 autoconnect【奥特欧 坑聂特】 yes[root@redis55~]# nmcli connection【肯耐申】 up ens160安装redis和配置
[root@redis55 ~]# yum -y install【因-斯多】 redis#修改4行配置[root@redis55 ~]# vim /etc/redis/redis.conf75 bind 0.0.0.01387 cluster-enabled yes #启用集群功能1395 cluster-config-file nodes-6379.conf #存储集群信息文件1401 cluster-node-timeout 5000 #集群中主机通信超时时间
[root@redis55 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis[root@redis55 ~]# netstat -utnlp | grep redis-servetcp 0 0 0.0.0.0:16379 0.0.0.0:* LISTEN 1778/redis-server 0tcp 0 0 0.0.0.0:6379 0.0.0.0:* LISTEN 1778/redis-server 04.1.1 配置redis56
配置服务器192.168.90.56
[root@redis56 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis56[root@redis56 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.56/24 autoconnect【奥特欧 坑聂特】 yes[root@redis56~]# nmcli connection【肯耐申】 up ens160安装redis和配置
[root@redis56 ~]# yum -y install【因-斯多】 redis#修改4行配置[root@redis56 ~]# vim /etc/redis/redis.conf75 bind 0.0.0.01387 cluster-enabled yes #启用集群功能1395 cluster-config-file nodes-6379.conf #存储集群信息文件1401 cluster-node-timeout 5000 #集群中主机通信超时时间
[root@redis56 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis[root@redis56 ~]# netstat -utnlp | grep redis-servetcp 0 0 0.0.0.0:16379 0.0.0.0:* LISTEN 1793/redis-server 0tcp 0 0 0.0.0.0:6379 0.0.0.0:* LISTEN 1793/redis-server 04.2 高可用集群原理
4.2.1 架构与节点连接
Redis Cluster 采用无中心结构,每个节点保存数据和整个集群状态,且每个节点都和其他所有节点连接。一组三主三从集群由 6 个 Redis 实例组成,其中 3 个为主节点,3 个为从节点,每个主节点至少对应一个从节点 。
4.2.2 分布式数据分片
- 哈希槽机制:Redis Cluster 将数据划分为 16384 个槽位,每个主节点负责部分槽位。例如,主节点 1 管理槽 0 - 5460,主节点 2 管理 5461 - 10922,主节点 3 管理 10923 - 16383 。当存储一个 key 时,会使用 CRC16 算法计算该 key 的哈希值,然后对 16384 取模,得到所属的槽位,进而将这个 key 分到对应槽位区间的节点上 。
- 自动负载均衡:数据按哈希值分配到不同节点,避免单点性能瓶颈。当新增节点时,还可以进行动态地、无中断地数据重新分片 。
分布式数据分片核心好处
- 水平扩展(Scalability)
-
突破单机性能瓶颈:数据和请求负载分散到多个节点,可线性提升吞吐量(QPS)和存储容量。
-
动态扩容/缩容:通过迁移槽位(如
redis-cli --cluster reshard),可在不停服的情况下增减节点。- 高可用性(High Availability)
-
自动故障转移:每个主节点可配置从节点(replica),主节点宕机时,从节点自动升主(由集群内部 Gossip 协议协调)。
-
无单点故障:即使部分节点失效,其余节点仍可提供服务(只要大多数主节点存活)。
- 数据分布均衡
- 确定性分片:
slot = CRC16(key) % 16384确保相同 key 总路由到同一节点,避免数据重复。 - 均匀分布:哈希算法使 key 在槽位间近似均匀分布,结合槽位均分到节点,实现负载均衡。
- 客户端智能路由
- MOVED 重定向:客户端首次访问错误节点时,返回正确节点地址,后续直接连接目标节点。
- 本地缓存槽位映射:客户端(如
redis-py-cluster)缓存slot → node映射,减少重定向开销。
- 简化运维
- 去中心化架构:无中心调度节点,所有节点对等通信(Gossip 协议),避免单点瓶颈。
- 自动发现与状态同步:节点通过
PING/PONG消息交换拓扑、故障信息,无需人工干预。
总结
Redis 集群的分片机制在 性能、容量、可用性 三者间取得平衡:
通过哈希槽实现数据分布式存储,既支持弹性扩展,又保障高可用,同时保持协议简洁高效,是 Redis 大规模部署的核心方案。
4.2.3 主从复制
主从节点的数据准实时一致,通过异步的主备复制保证。从节点启动时会连接主节点,发送 SYNC 命令。主节点接收到后,开始执行 BGSAVE 命令生成 RDB 文件,并使用缓冲区记录此后执行的所有写命令。主节点 BGSAVE 执行完后,向从节点发送快照文件,发送期间继续记录写命令。从节点收到快照文件后丢弃旧数据,载入快照。主节点快照发送完毕后,向从节点发送缓冲区中的写命令。之后主节点每执行一个写命令,都会向从节点发送相同的写命令 。
Redis 主从复制通过异步方式实现数据准实时同步,过程如下:
- 建立连接:从节点启动后,向主节点发起连接,并发送 PSYNC 命令(首次为 PSYNC ? -1)。
- 全量同步(必要时): 主节点收到首次 PSYNC 后,执行 BGSAVE 生成 RDB 快照; 同时将新写命令缓存在复制积压缓冲区(repl_backlog); RDB 生成后,主节点将其发送给从节点; 从节点清空本地数据,加载 RDB。
- 增量同步: 主节点将 RDB 生成期间及之后的写命令持续发送给从节点; 从节点执行这些命令,保持与主节点一致。
- 断线重连优化:
若网络闪断,从节点通过 PSYNC
请求部分重同步; 主节点若在 repl_backlog 中找到对应偏移量,则仅发送缺失命令,避免全量同步。
4.2.4读写分离
在 Redis 集群中,写操作只能由主节点处理;读操作既可以在主节点上进行,也可以在从节点上进行,以此分载主节点的读操作压力 。
4.3 创建集群
启用集群配置
# 1. 绑定所有接口(允许外部连接)bind 0.0.0.0
# 2. 禁用保护模式(因未设密码,有密码情况下可以设置为yes)protected-mode no
# 3. 监听端口port 6379
# 4. 不以守护进程方式运行(由 systemd 管理)daemonize no
# 5. 启用集群模式(核心!)cluster-enabled yes
# 6. 集群节点超时(毫秒),默认 15000,可调小测试用cluster-node-timeout 5000
# 7. 集群配置文件(自动生成,不要手动创建)cluster-config-file nodes-6379.conf说明:
1、在任意一台redis服务器上都可以执行创建集群的命令。
2、—cluster-replicas 1 给每个master服务器分配一台slave服务器,每个主至少要分配1台slave服务器,不然无法实现redis服务的高可用。
3、创建集群时,会自动创建主从角色,默认把主机列表中的前3台服务器创建为 Master角色的redis服务器,剩下的均配置为slave角色服务器。
4、创建集群时,会自动给master角色的主机分配hash槽 ,通过hash槽实现数据的分布式存储。
[root@redis51 ~]# redis-cli --cluster【克拉斯特】 create 192.168.90.51:6379 192.168.90.52:6379 192.168.90.53:6379 192.168.90.54:6379 192.168.90.55:6379 192.168.90.56:6379 --cluster-replicas 1>>> Creating cluster>>> Performing hash slots allocation on 6 nodes...Using 3 masters:192.168.90.51:6379192.168.90.52:6379192.168.90.53:6379Adding replica 192.168.90.55:6379 to 192.168.90.51:6379Adding replica 192.168.90.56:6379 to 192.168.90.52:6379Adding replica 192.168.90.54:6379 to 192.168.90.53:6379M: 0eb3b7aa0493a19189cba35b0c658202cc20884b 192.168.90.51:6379 slots:0-5460 (5461 slots) masterM: a9cb8ccd31bf3eb70433c00906c9f1a99b5e8441 192.168.90.52:6379 slots:5461-10922 (5462 slots) masterM: f2c1bdb78d8d224c3666fa6440bdf80ba563c581 192.168.90.53:6379 slots:10923-16383 (5461 slots) masterS: bdba77868965371680fa825badff59bf8ef95a81 192.168.90.54:6379 replicates f2c1bdb78d8d224c3666fa6440bdf80ba563c581S: 11510f42bfd9cf667bab5f31c01476d94984200a 192.168.90.55:6379 replicates 0eb3b7aa0493a19189cba35b0c658202cc20884bS: fe572ce003ee634c52adc4b42d92d15f847937d7 192.168.90.56:6379 replicates a9cb8ccd31bf3eb70433c00906c9f1a99b5e8441Can I set the above configuration? (type 'yes' to accept): yes #同意........[OK] All nodes agree about slots configuration.>>> Check for open slots...>>> Check slots coverage...[OK] All 16384 slots covered. //创建成功的提示4.4 查看集群信息
第一列:主服务器ip地址
第二列:主服务器ID
第三列:存储变量个数
第四列:hash槽个数 (hash槽的作用在集群存储工程过程里讲)
第五列:从服务器数量
[root@redis51 ~]# redis-cli --cluster【克拉斯特】 info【因否】 192.168.90.51:6379192.168.90.53:6379 (f2c1bdb7...) -> 0 keys | 5461 slots | 1 slaves.192.168.90.51:6379 (0eb3b7aa...) -> 0 keys | 5461 slots | 1 slaves.192.168.90.52:6379 (a9cb8ccd...) -> 0 keys | 5462 slots | 1 slaves.[OK] 0 keys in 3 masters.0.00 keys per slot on average.4.5 访问集群
[root@redis51 ~]# redis-cli -c -h 192.168.90.51 -p 6379192.168.90.51:6379> set school moershi-> Redirected to slot [8455] located at 192.168.90.52:6379OK192.168.90.52:6379> set teacher jam-> Redirected to slot [12541] located at 192.168.90.53:6379OK192.168.90.53:6379> set class NSD-> Redirected to slot [741] located at 192.168.90.51:6379OK192.168.90.51:6379>会发现3个变量被分别存储到集群中的3台master服务器上,实现了数据的分布式存储。当连接集群中的任意一台redis服务器存储数据时,会调用集群CRC16算法 得出此次存储变量使用的hash 槽,然后连接hash 槽 所在的master服务器存储变量。 在创建集群时会把默认的16384个槽平均的分配给集群中的3个master服务器。可以通过查看集群信息查看每个master服务器占用hash槽的个数。
[root@redis51 ~]# redis-cli --cluster【克拉斯特】 info【因否】 192.168.90.51:6379192.168.90.53:6379 (f2c1bdb7...) -> 0 keys | 5461 slots | 1 slaves.192.168.90.51:6379 (0eb3b7aa...) -> 0 keys | 5461 slots | 1 slaves.192.168.90.52:6379 (a9cb8ccd...) -> 0 keys | 5462 slots | 1 slaves.[OK] 0 keys in 3 masters.0.00 keys per slot on average.集群中slave角色的主机会自动同步master角色主机的数据,实现数据的自动备份,
分别连接集群中的3台slave服务器查看变量
[root@redis54 ~]# redis-cli -c -h 192.168.90.54 -p 6379192.168.90.54:6379> keys *1) "class"[root@redis55 ~]# redis-cli -c -h 192.168.90.55 -p 6379192.168.90.55:6379> keys *1) "school"[root@redis56 ~]# redis-cli -c -h 192.168.90.56 -p 6379192.168.90.56:6379> keys *1) "teacher"当master角色的服务器宕机时,对应的slave服务器会升级为master 并接手对应的hash槽,实现redis服务的高可用,例如停止host53主机的redis服务,对应的从会升级为master 。(当宕机的master恢复后 自动做当前主的从服务器)
#停止redis服务[root@redis53 ~]# systemctl【西斯屯-ctl】 stop【 s 多】 redis#查看集群信息[root@redis51 ~]#]# redis-cli --cluster【克拉斯特】 info【因否】 192.168.90.51:6379192.168.90.54:6379 (f2c1bdb7...) -> 1 keys | 5461 slots | 0 slaves.192.168.90.51:6379 (0eb3b7aa...) -> 1 keys | 5461 slots | 1 slaves.192.168.90.52:6379 (a9cb8ccd...) -> 1 keys | 5462 slots | 1 slaves.[OK] 0 keys in 3 masters.keys per slot on average.#启动redis服务[root@redis53 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis#查看集群信息[root@redis51 ~]#]# redis-cli --cluster【克拉斯特】 info【因否】 192.168.90.51:6379192.168.90.54:6379 (f2c1bdb7...) -> 1 keys | 5461 slots | 1 slaves.192.168.90.51:6379 (0eb3b7aa...) -> 1 keys | 5461 slots | 1 slaves.192.168.90.52:6379 (a9cb8ccd...) -> 1 keys | 5462 slots | 1 slaves.[OK] 0 keys in 3 masters.keys per slot on average.五、配置主从复制
当前任务环节
5.1 环境准备
准备3台新虚拟机
| 主机名 | 主机名 | 说明 |
|---|---|---|
| redis61 | 192.168.90.61 | redis服务器 |
| redis62 | 192.168.90.62 | redis服务器 |
| redis63 | 192.168.90.63 | redis服务器 |
配置服务器192.168.90.61
[root@redis61 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis61[root@redis61 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.61/24 autoconnect【奥特欧 坑聂特】 yes[root@redis61~]# nmcli connection【肯耐申】 up ens160配置服务器192.168.90.62
[root@redis62 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis62[root@redis62 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.62/24 autoconnect【奥特欧 坑聂特】 yes[root@redis62~]# nmcli connection【肯耐申】 up ens160配置服务器192.168.90.63
[root@redis63 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis63[root@redis63 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.63/24 autoconnect【奥特欧 坑聂特】 yes[root@redis63~]# nmcli connection【肯耐申】 up ens1605.2 配置一主一从结构
1)配置redis61为主服务器
[root@redis61 ~]# yum -y install【因-斯多】 redis[root@redis61 ~]# vim /etc/redis/redis.conf75 bind 0.0.0.0[root@redis61 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis[root@redis61 ~]# redis-cli127.0.0.1:6379> info【因否】 replication #查看主从关系信息# Replicationrole:master # 默认就是主服务器connected_slaves:0 #没有从服务器master_failover_state:no-failovermaster_replid:bd86b885e9e6b21e452696d472e2b2852c7fea72master_replid2:0000000000000000000000000000000000000000master_repl_offset:0second_repl_offset:-1repl_backlog_active:0repl_backlog_size:1048576repl_backlog_first_byte_offset:0repl_backlog_histlen:2)配置redids62为redis61的从服务器
[root@redis62 ~]# yum -y install【因-斯多】 redis[root@redis62 ~]# vim /etc/redis/redis.conf75 bind 0.0.0.0[root@redis62 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis[root@redis62 ~]# redis-cli127.0.0.1:6379> replicaof 192.168.90.61 6379 #指定主服务器ip和端口OK127.0.0.1:6379> config rewrite #永久保存配置OK127.0.0.1:6379> exit#查看文件末尾[root@redis62 ~]# tail -1 /etc/redis/redis.confreplicaof 192.168.90.61 6379[root@redis62 ~]# redis-cli127.0.0.1:6379> info【因否】 replication #查看主从关系信息# Replicationrole:slave #从角色master_host:192.168.90.61 #主服务器ip地址master_port:6379 #主服务器端口号master_link_status:up #与主服务器连接状态 (up 正常 down 连接失败)master_last_io_seconds_ago:0master_sync_in_progress:0slave_read_repl_offset:84slave_repl_offset:84slave_priority:100slave_read_only:1replica_announced:1connected_slaves:0master_failover_state:no-failovermaster_replid:f2fde7a2f3f7c6b3a20b1223b0c35ba55b245d0cmaster_replid2:0000000000000000000000000000000000000000master_repl_offset:84second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1repl_backlog_histlen:843)在主服务器redis61查看复制信息
127.0.0.1:6379> info【因否】 replication# Replicationrole:master #主角色connected_slaves:1 #一个从slave0:ip=192.168.90.62,port=6379,state=online,offset=98,lag=0 #从服务器信息master_failover_state:no-failovermaster_replid:f2fde7a2f3f7c6b3a20b1223b0c35ba55b245d0cmaster_replid2:0000000000000000000000000000000000000000master_repl_offset:98second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1repl_backlog_histlen:98127.0.0.1:6379> mset x 1 y 2 z 3 #存储数据OK127.0.0.1:6379> keys *1) "x"2) "z"3) "y"4)在从服务器查看是否同步数据
127.0.0.1:6379> keys *1) "x"2) "z"3) "y"5.3 配置一主多从结构
把redis63也配置为redis61的从服务器
1)配置redis63为redis61的从服务器
[root@redis63 ~]# yum -y install【因-斯多】 redis[root@redis63 ~]# vim /etc/redis/redis.conf75 bind 0.0.0.0[root@redis63 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis[root@redis63 ~]# redis-cli127.0.0.1:6379> replicaof 192.168.90.61 6379 #指定主服务器ip和端口OK127.0.0.1:6379> config rewrite #永久保存配置OK127.0.0.1:6379> exit#查看文件末尾[root@redis62 ~]# tail -1 /etc/redis/redis.confreplicaof 192.168.90.61 6379[root@redis63 ~]# redis-cli127.0.0.1:6379> info【因否】 replication# Replicationrole:slavemaster_host:192.168.90.61master_port:6379master_link_status:upmaster_last_io_seconds_ago:10master_sync_in_progress:0slave_read_repl_offset:1507slave_repl_offset:1507slave_priority:100slave_read_only:1replica_announced:1connected_slaves:0master_failover_state:no-failovermaster_replid:f2fde7a2f3f7c6b3a20b1223b0c35ba55b245d0cmaster_replid2:0000000000000000000000000000000000000000master_repl_offset:1507second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1466127.0.0.1:6379> keys *1) "y"2) "z"3) "x"在redis61 查看到有2台从服务器
127.0.0.1:6379> info【因否】 replication# Replicationrole:masterconnected_slaves:2 #2个从服务器slave0:ip=192.168.90.62,port=6379,state=online,offset=1591,lag=0 #从1slave1:ip=192.168.90.63,port=6379,state=online,offset=1591,lag=1 #从2master_failover_state:no-failovermaster_replid:f2fde7a2f3f7c6b3a20b1223b0c35ba55b245d0cmaster_replid2:0000000000000000000000000000000000000000master_repl_offset:1591second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1repl_backlog_histlen:15915.4 配置主从从结构
把redis63恢复为独立的redis服务器,然后配置为redis62的从服务器
1)配置redis63
127.0.0.1:6379> replicaof no one #恢复为独立的数据库服务器OK127.0.0.1:6379> replicaof 192.168.90.62 6379 #指定主服务器为62OK127.0.0.1:6379> config rewrite #保存配置OK127.0.0.1:6379> exit@查看是否保存[root@redis63 ~]# tail -1 /etc/redis/redis.confreplicaof 192.168.90.62 6379[root@redis63 ~]# redis-cli127.0.0.1:6379> info【因否】 replication #查看主从关系信息# Replicationrole:slave #从角色master_host:192.168.90.62 #主服务器IPmaster_port:6379 #主服务端口master_link_status:up #与主服务器连接状态master_last_io_seconds_ago:3master_sync_in_progress:0slave_read_repl_offset:2025slave_repl_offset:2025slave_priority:100slave_read_only:1replica_announced:1connected_slaves:0master_failover_state:no-failovermaster_replid:f2fde7a2f3f7c6b3a20b1223b0c35ba55b245d0cmaster_replid2:0000000000000000000000000000000000000000master_repl_offset:2025second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1956repl_backlog_histlen:702)在redis62查看复制信息
127.0.0.1:6379> info【因否】 replication# Replicationrole:slave #本身是从服务器master_host:192.168.90.61 #主服务器ipmaster_port:6379 #主服务器redis服务端口master_link_status:up #与主服务器连接状态master_last_io_seconds_ago:6master_sync_in_progress:0slave_read_repl_offset:2291slave_repl_offset:2291slave_priority:100slave_read_only:1replica_announced:1connected_slaves:1 #本身有一个从服务器slave0:ip=192.168.90.63,port=6379,state=online,offset=2291,lag=0 #从服务器信息master_failover_state:no-failovermaster_replid:f2fde7a2f3f7c6b3a20b1223b0c35ba55b245d0cmaster_replid2:0000000000000000000000000000000000000000master_repl_offset:2291second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1repl_backlog_histlen:22913)在redis61上查看信息
127.0.0.1:6379> info【因否】 replication# Replicationrole:masterconnected_slaves:1 #只有一个从了slave0:ip=192.168.90.62,port=6379,state=online,offset=2403,lag=0master_failover_state:no-failovermaster_replid:f2fde7a2f3f7c6b3a20b1223b0c35ba55b245d0cmaster_replid2:0000000000000000000000000000000000000000master_repl_offset:2403second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1repl_backlog_histlen:2403六、置带验证的主从复制
当前任务环节
基于案例1做如下配置:
- 配置主机redis61,redis服务连接密码为123456
- 主机redis62设置连接redis61的redis服务密码
给redis61主机的Redis服务设置连接密码,如果从服务器不指定连接密码无法同步数据。
6.1 配置主机redis61
redis服务连接密码为123456
命令操作如下所示:
[root@redis61 ~]# redis-cli127.0.0.1:6379> config get requirepass #查看密码,默认服务没有密码1) "requirepass"2) ""127.0.0.1:6379> config set requirepass 123456 #设置密码OK127.0.0.1:6379> auth 123456 #密码登录OK127.0.0.1:6379> config rewrite #保存配置OK127.0.0.1:6379> exit#保存到文件的的密码[root@redis61 ~]# grep "123456" /etc/redis/redis.confrequirepass "123456"#重启redis服务[root@redis61 ~]# systemctl【西斯屯-ctl】 restart redis[root@redis61 ~]# redis-cli127.0.0.1:6379> auth 123456OK127.0.0.1:6379> info【因否】 replication# Replicationrole:masterconnected_slaves:0 # 没有从服务器了 因为从没有输入连接密码连接不上主服务器master_failover_state:no-failovermaster_replid:7f7c394d93a5df791bbdfb207cdeaf1eb506358fmaster_replid2:0000000000000000000000000000000000000000master_repl_offset:0second_repl_offset:-1repl_backlog_active:0repl_backlog_size:1048576repl_backlog_first_byte_offset:0repl_backlog_histlen:06.2 主机redis62设置连接redis61的redis服务密码
命令操作如下所示:
#重启redis服务[root@redis62 ~]# systemctl【西斯屯-ctl】 restart redis[root@redis62 ~]# redis-cli127.0.0.1:6379> info【因否】 replication #查看主从关系信息# Replicationrole:slavemaster_host:192.168.90.61master_port:6379master_link_status:down #没设置密码 与master主机是断开状态master_last_io_seconds_ago:-1master_sync_in_progress:1slave_read_repl_offset:1slave_repl_offset:1master_sync_total_bytes:-1master_sync_read_bytes:0master_sync_left_bytes:-1master_sync_perc:-0.00master_sync_last_io_seconds_ago:0master_link_down_since_seconds:-1slave_priority:100slave_read_only:1replica_announced:1connected_slaves:0master_failover_state:no-failovermaster_replid:f2fde7a2f3f7c6b3a20b1223b0c35ba55b245d0cmaster_replid2:0000000000000000000000000000000000000000master_repl_offset:3383second_repl_offset:-1repl_backlog_active:0repl_backlog_size:1048576repl_backlog_first_byte_offset:0repl_backlog_histlen:0指定主服务器的密码
127.0.0.1:6379> config set masterauth 123456 #指定主服务器密码OK127.0.0.1:6379> config rewrite #保存配置OK127.0.0.1:6379> info【因否】 replication #查看主从信息# Replicationrole:slavemaster_host:192.168.90.61master_port:6379master_link_status:up #现在是启动状态master_last_io_seconds_ago:2master_sync_in_progress:0slave_read_repl_offset:28slave_repl_offset:28slave_priority:100slave_read_only:1replica_announced:1connected_slaves:1slave0:ip=192.168.90.63,port=6379,state=online,offset=28,lag=1master_failover_state:no-failovermaster_replid:a288cad0a8747569f147c06bb63237b2751a9fb4master_replid2:0000000000000000000000000000000000000000master_repl_offset:28second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1repl_backlog_histlen:283)在redis61上查看信息
[root@redis61 ~]# redis-cli127.0.0.1:6379> auth 123456OK127.0.0.1:6379> info【因否】 replication# Replicationrole:masterconnected_slaves:1slave0:ip=192.168.90.62,port=6379,state=online,offset=70,lag=1master_failover_state:no-failovermaster_replid:a288cad0a8747569f147c06bb63237b2751a9fb4master_replid2:0000000000000000000000000000000000000000master_repl_offset:70second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1repl_backlog_histlen:70七、哨兵服务
当前任务环节
7.1环境准备
准备3台新的虚拟机
| 主机名 | IP地址 | 说明 |
|---|---|---|
| redis67 | 192.168.90.67 | Master服务器 |
| redis68 | 192.168.90.68 | Slave服务器 |
| redis69 | 192.168.90.69 | 哨兵服务 |
说明:
1)可以使用一主一从或 一主多从 或 主从从 + 哨兵服务 做服务的高可用 和 数据自动备份
2)如果主从结构中的redis服务设置连接密码的话必须全每台数据库都要设置密码且密码要一样,要么全都不设置密码。
3)如果Redis服务有密码宕机的服务器启动服务后,要人为指定主服务器的连接密码。
配置服务器192.168.90.67
[root@redis67 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis67[root@redis67 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.67/24 autoconnect【奥特欧 坑聂特】 yes[root@redis67~]# nmcli connection【肯耐申】 up ens160配置服务器192.168.90.68
[root@redis68 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis68[root@redis68 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.68/24 autoconnect【奥特欧 坑聂特】 yes[root@redis68~]# nmcli connection【肯耐申】 up ens160配置服务器192.168.90.69
[root@redis69 ~]# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 redis69[root@redis69 ~]# nmcli connection【肯耐申】 modify【莫迪fái】 ens160 ipv4.addresses【额拽西斯】 192.168.90.69/24 autoconnect【奥特欧 坑聂特】 yes[root@redis69~]# nmcli connection【肯耐申】 up ens1607.2 哨兵服务的原理
Redis哨兵是一种分布式高可用解决方案,用于实现主从自动故障转移、集群监控以及充当配置中心自动更新客户端连接信息。其工作原理主要分为三个阶段:监控、共识和故障转移 。
- 监控(Monitoring):哨兵每秒向主/从节点发送PING命令,若节点超时(down-after-milliseconds,默认30s)无响应,该哨兵会将其标记为主观下线(SDOWN)。即单个哨兵认为实例不可用(PING无响应超过 down-after-milliseconds 配置) 。
- 共识(Agreement):哨兵集群通过Gossip协议交换节点状态。当多数哨兵(≥ quorum)都认为主节点下线时,会将其标记为客观下线(ODOWN)。也就是当足够数量(quorum配置)的哨兵都认为主节点不可用时,才判定主节点真正不可用 。
- 故障转移(Failover)
- 选举领导者哨兵:基于Raft协议进行选举。发现主节点ODOWN的哨兵发起选举,每个哨兵在每个配置纪元(epoch)仅投一票,最先获得多数票(≥ N/2 + 1)的哨兵当选为领导者哨兵来执行故障转移;若选举超时(默认100ms),则会重新发起选举 。
- 选择新主节点:从从节点中选出新主节点,选择规则依次基于优先级(slave-priority配置)、复制偏移量(选择数据最新的)、运行ID(选择较小的)。先排除已下线节点和replica-priority = 0的节点,然后选择优先级最高、复制偏移量最大、Run ID最小的节点 。
- 重新配置:领导者哨兵将选中的从节点提升为主节点(执行SLAVEOF NO ONE命令);通知其他从节点复制新的主节点(执行SLAVEOF new_master_ip port命令);当旧主节点恢复时,将其配置为新主节点的从节点 。
- 通知客户端:通过Redis的发布/订阅机制,将新主节点的IP和端口信息推送给客户端,让客户端更新配置,连接到新的主节点 。
7.3 配置主机redis67为master服务器
命令操作如下所示:
[root@redis67 ~]# yum -y install【因-斯多】 redis#替换掉75行[root@redis67 ~]# sed -i "75c bind 0.0.0.0" /etc/redis/redis.conf[root@redis67 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis[root@redis67 ~]# redis-cli127.0.0.1:6379> info【因否】 replication #查看主从关系信息# Replicationrole:master # 默认就是主服务器connected_slaves:0 #没有从服务器master_failover_state:no-failovermaster_replid:bd86b885e9e6b21e452696d472e2b2852c7fea72master_replid2:0000000000000000000000000000000000000000master_repl_offset:0second_repl_offset:-1repl_backlog_active:0repl_backlog_size:1048576repl_backlog_first_byte_offset:0repl_backlog_histlen:7.4 配置主机redis68为redis67的slave服务器
命令操作如下所示:
[root@redis68 ~]# yum -y install【因-斯多】 redis[root@redis68 ~]# sed -i "75c bind 0.0.0.0" /etc/redis/redis.conf[root@redis68 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis[root@redis68 ~]# redis-cli127.0.0.1:6379> replicaof 192.168.90.67 6379 #指定主服务器ip和端口OK127.0.0.1:6379> config rewrite #永久保存配置OK127.0.0.1:6379> exit#查看文件末尾[root@redis68 ~]# tail -1 /etc/redis/redis.confreplicaof 192.168.90.67 6379[root@redis62 ~]# redis-cli127.0.0.1:6379> info【因否】 replication #查看主从关系信息# Replicationrole:slave #从角色master_host:192.168.90.67 #主服务器ip地址master_port:6379 #主服务器端口号master_link_status:up #与主服务器连接状态 (up 正常 down 连接失败)master_last_io_seconds_ago:0master_sync_in_progress:0slave_read_repl_offset:84slave_repl_offset:84slave_priority:100slave_read_only:1replica_announced:1connected_slaves:0master_failover_state:no-failovermaster_replid:f2fde7a2f3f7c6b3a20b1223b0c35ba55b245d0cmaster_replid2:0000000000000000000000000000000000000000master_repl_offset:84second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1repl_backlog_histlen:847.5 配置主机redis69运行哨兵服务
- 安装redis软件,启动哨兵服务
[root@redis68 ~]# yum -y install【因-斯多】 redis#哨兵配置文件[root@redis69 ~]# vim /etc/redis/sentinel.conf15 bind 0.0.0.026 daemonize yes84 sentinel monitor mymaster 192.168.90.67 6379 1
#启动哨兵服务[root@redis69 ~]# systemctl【西斯屯-ctl】 start【s 达儿】 redis-sentinel#查看端口号[root@redis69 ~]# netstat -utnlp | grep 26379tcp 0 0 0.0.0.0:26379 0.0.0.0:* LISTEN 2179/redis-sentinel[root@redis69 ~]#2)查看日志获取监视信息
复制一个终端会话
[root@redis69 ~]# tail -f /var/log/redis/sentinel.log2179:X 23 Jun 2025 15:47:44.301 * Supervised by systemd. Please make sure you set appropriate values for TimeoutStartSec and TimeoutStopSec in your service unit.2179:X 23 Jun 2025 15:47:44.301 # oO0OoO0OoO0Oo Redis is starting oO0OoO0OoO0Oo2179:X 23 Jun 2025 15:47:44.301 # Redis version=6.2.18, bits=64, commit=00000000, modified=0, pid=2179, just started2179:X 23 Jun 2025 15:47:44.301 # Configuration loaded2179:X 23 Jun 2025 15:47:44.302 * monotonic clock: POSIX clock_gettime2179:X 23 Jun 2025 15:47:44.302 * Running mode=sentinel, port=26379.2179:X 23 Jun 2025 15:47:44.304 # Sentinel ID is 5ab8d490e1e7b600170a2a725b4679d25186b4d12179:X 23 Jun 2025 15:47:44.304 # +monitor master mymaster 192.168.90.67 6379 quorum 12179:X 23 Jun 2025 15:47:44.306 * +slave slave 192.168.90.68:6379 192.168.90.68 6379 @ mymaster 192.168.90.67 63797.6 测试配置
思路:停止master主机的redis 服务,原slave角色会升级为主,哨兵服务会自动监视新的master服务,宕机的master 主机恢复后自动配置为当前主的从服务器。
停止master主机的redis 服务
[root@redis67 ~]# systemctl【西斯屯-ctl】 stop【 s 多】 redis查看slave
原slave角色会升级为主
127.0.0.1:6379> info【因否】 replication# Replicationrole:slavemaster_host:192.168.90.67master_port:6379master_link_status:down #master宕机了master_last_io_seconds_ago:-1master_sync_in_progress:0slave_read_repl_offset:22602slave_repl_offset:22602master_link_down_since_seconds:27slave_priority:100slave_read_only:1replica_announced:1connected_slaves:0master_failover_state:no-failovermaster_replid:0f9c32408bfd386ab9c9ef00617298a969e89c73master_replid2:0000000000000000000000000000000000000000master_repl_offset:22602second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1
#重新登录[root@redis68 ~]# redis-cli127.0.0.1:6379> info【因否】 replication# Replicationrole:master #升级为masterconnected_slaves:0master_failover_state:no-failovermaster_replid:8289cfb1acb8573be217df886ac24732f2bdb6a9master_replid2:0f9c32408bfd386ab9c9ef00617298a969e89c73master_repl_offset:25586second_repl_offset:22603repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1哨兵服务会自动监视新的master服务
宕机的master 主机恢复后自动配置为当前主的从服务器。
[root@redis67 ~]# redis-cli127.0.0.1:6379> info【因否】 replicationError: Server closed the connection【肯耐申】127.0.0.1:6379> info【因否】 replication# Replicationrole:slave #变成从服务器master_host:192.168.90.68 #现在主服务器是192.168.90.68master_port:6379master_link_status:upmaster_last_io_seconds_ago:2master_sync_in_progress:0slave_read_repl_offset:41965slave_repl_offset:41965slave_priority:100slave_read_only:1replica_announced:1connected_slaves:0master_failover_state:no-failovermaster_replid:8289cfb1acb8573be217df886ac24732f2bdb6a9master_replid2:0000000000000000000000000000000000000000master_repl_offset:41965second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:41520repl_backlog_histlen:446八、作业
1 选择题
-
Redis 哨兵将主节点标记为客观下线(ODOWN)的条件是? B A. 单个哨兵认为主节点不可用 B. 多数哨兵(≥ quorum)都认为主节点下线 C. 主节点主动发出下线通知 D. 主节点超过 1 分钟无响应
-
Redis Cluster 采用的分布式数据分片机制是? A A. 哈希槽机制 B. 随机分配机制 C. 轮询机制 D. 顺序分配机制
-
在 Redis 主从复制中,从节点启动时会向主节点发送什么命令? A A. SYNC 命令 B. SAVE 命令 C. FLUSHALL 命令 D. info 命令
2 简答题
-
简述 Redis 哨兵服务的工作原理。 答:
- 监控(Monitoring):哨兵每秒向主/从节点发送PING命令,若节点超时(down-after-milliseconds,默认30s)无响应,该哨兵会将其标记为主观下线(SDOWN)。即单个哨兵认为实例不可用(PING无响应超过 down-after-milliseconds 配置) 。
- 共识(Agreement):哨兵集群通过Gossip协议交换节点状态。当多数哨兵(≥ quorum)都认为主节点下线时,会将其标记为客观下线(ODOWN)。也就是当足够数量(quorum配置)的哨兵都认为主节点不可用时,才判定主节点真正不可用 。
- 故障转移(Failover)
- 选举领导者哨兵:基于Raft协议进行选举。发现主节点ODOWN的哨兵发起选举,每个哨兵在每个配置纪元(epoch)仅投一票,最先获得多数票(≥ N/2 + 1)的哨兵当选为领导者哨兵来执行故障转移;若选举超时(默认100ms),则会重新发起选举 。
- 选择新主节点:从从节点中选出新主节点,选择规则依次基于优先级(slave-priority配置)、复制偏移量(选择数据最新的)、运行ID(选择较小的)。先排除已下线节点和replica-priority = 0的节点,然后选择优先级最高、复制偏移量最大、Run ID最小的节点 。
- 重新配置:领导者哨兵将选中的从节点提升为主节点(执行SLAVEOF NO ONE命令);通知其他从节点复制新的主节点(执行SLAVEOF new_master_ip port命令);当旧主节点恢复时,将其配置为新主节点的从节点 。
- 通知客户端:通过Redis的发布/订阅机制,将新主节点的IP和端口信息推送给客户端,让客户端更新配置,连接到新的主节点 。
-
说明 Redis 集群中分布式数据分片的好处。 答:
- 水平扩展:突破单机性能瓶颈,将数据和请求负载分散到多个节点,可线性提升吞吐量(QPS)和存储容量。动态扩容在通过迁移槽位(如 redis-cli —cluster reshard),可在不停服的情况下增减节点。
- 高可用性:自动故障转移,每个主节点可配置从节点(replica),主节点宕机时,从节点自动升主,主节点恢复自从加入新主节点的从节点。无单点故障,即使部分节点失效,其余节点仍可提供服务(只要大多数主节点存活)。
- 数据分布均衡:确定性分片,如slot = CRC16(key) % 16384 确保相同 key 总路由到同一节点,避免数据重复。均匀分布,哈希算法使 key 在槽位间近似均匀分布,结合槽位均分到节点,实现负载均衡。
-
请阐述 Redis 主从复制的过程。 答:
- 建立连接:从节点启动后,向主节点发起连接,并发送 PSYNC 命令(首次为 PSYNC ? -1)。
- 主节点收到首次 PSYNC 后,执行 BGSAVE 生成 RDB 快照,同时将新写命令缓存在复制积压缓冲区(repl_backlog),DB 生成后,主节点将其发送给从节点,从节点清空本地数据,加载 RDB。
3 操作题
- 请写出配置 Redis 一主一从结构的详细步骤。
[root@redis60 ~]# 主配置[root@redis60 ~]# systemctl start redis.service[root@redis60 ~]# redis-cli127.0.0.1:6379> config set protected-mode noOK127.0.0.1:6379> config rewriteOK127.0.0.1:6379> info replication# Replicationrole:masterconnected_slaves:0master_failover_state:no-failovermaster_replid:2aae21339753d355129c78fab17bd7a1c547aedfmaster_replid2:0000000000000000000000000000000000000000master_repl_offset:0second_repl_offset:-1repl_backlog_active:0repl_backlog_size:1048576repl_backlog_first_byte_offset:0repl_backlog_histlen:0
[root@redis61 ~]# 从配置[root@redis61 ~]# systemctl start redis.service[root@redis61 ~]# redis-cli127.0.0.1:6379> config set protected-mode noOK127.0.0.1:6379> config rewriteOK127.0.0.1:6379> replicaof 192.168.88.60 6379OK127.0.0.1:6379> config rewriteOK127.0.0.1:6379> info replication# Replicationrole:slavemaster_host:192.168.88.60master_port:6379master_link_status:upmaster_last_io_seconds_ago:9master_sync_in_progress:0slave_read_repl_offset:224slave_repl_offset:224replica_full_sync_buffer_size:0replica_full_sync_buffer_peak:0master_current_sync_attempts:160master_total_sync_attempts:160master_link_up_since_seconds:154total_disconnect_time_sec:0slave_priority:100slave_read_only:1replica_announced:1connected_slaves:0master_failover_state:no-failovermaster_replid:a321b83129695ff3cea398fd398097e9b99f63f5master_replid2:0000000000000000000000000000000000000000master_repl_offset:224second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:15repl_backlog_histlen:210127.0.0.1:6379>
127.0.0.1:6379> 主redis状态检查127.0.0.1:6379> info replication# Replicationrole:masterconnected_slaves:1slave0:ip=192.168.88.61,port=6379,state=online,offset=266,lag=1master_failover_state:no-failovermaster_replid:a321b83129695ff3cea398fd398097e9b99f63f5master_replid2:0000000000000000000000000000000000000000master_repl_offset:266second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1repl_backlog_histlen:266127.0.0.1:6379>
127.0.0.1:6379> 验证:主写入数据127.0.0.1:6379> mset a 1 b 2 c 3 d 4 e 5 f 6OK127.0.0.1:6379>
127.0.0.1:6379> 验证:从数据读取127.0.0.1:6379> keys *1) "a"2) "d"3) "f"4) "b"5) "c"6) "e"127.0.0.1:6379> mget a b c d e f1) "1"2) "2"3) "3"4) "4"5) "5"6) "6"127.0.0.1:6379>- 描述创建 Redis 高可用集群的具体操作过程。
# 集群配置
[root@redis59 ~]#[root@redis59 ~]# grep -vE "^\s*($|#)" /opt/redis/conf/redis.conf | grep -nE "bind|protected-mode|port|daemonize|cluster"1:bind 0.0.0.02:protected-mode no3:port 63797:daemonize no51:cluster-enabled yes52:cluster-config-file nodes-6379.conf53:cluster-node-timeout 5000[root@redis59 ~]# systemctl start redis.service
[root@redis60 ~]#[root@redis60 ~]# grep -vE "^\s*($|#)" /opt/redis/conf/redis.conf | grep -nE "bind|protected-mode|port|daemonize|cluster"1:bind 0.0.0.02:protected-mode no3:port 63797:daemonize no51:cluster-enabled yes52:cluster-config-file nodes-6379.conf53:cluster-node-timeout 5000[root@redis60 ~]# systemctl start redis.service
[root@redis61 ~]#[root@redis61 ~]# grep -vE "^\s*($|#)" /opt/redis/conf/redis.conf | grep -nE "bind|protected-mode|port|daemonize|cluster"1:bind 0.0.0.02:protected-mode no3:port 63797:daemonize no51:cluster-enabled yes52:cluster-config-file nodes-6379.conf53:cluster-node-timeout 5000[root@redis61 ~]# systemctl start redis.service
[root@redis62 ~]#[root@redis62 ~]# grep -vE "^\s*($|#)" /opt/redis/conf/redis.conf | grep -nE "bind|protected-mode|port|daemonize|cluster"1:bind 0.0.0.02:protected-mode no3:port 63797:daemonize no51:cluster-enabled yes52:cluster-config-file nodes-6379.conf53:cluster-node-timeout 5000[root@redis62 ~]# systemctl start redis.service
[root@redis63 ~]#[root@redis63 ~]# grep -vE "^\s*($|#)" /opt/redis/conf/redis.conf | grep -nE "bind|protected-mode|port|daemonize|cluster"1:bind 0.0.0.02:protected-mode no3:port 63797:daemonize no51:cluster-enabled yes52:cluster-config-file nodes-6379.conf53:cluster-node-timeout 5000[root@redis63 ~]# systemctl start redis.service
[root@redis64 ~]#[root@redis64 ~]# grep -vE "^\s*($|#)" /opt/redis/conf/redis.conf | grep -nE "bind|protected-mode|port|daemonize|cluster"1:bind 0.0.0.02:protected-mode no3:port 63797:daemonize no51:cluster-enabled yes52:cluster-config-file nodes-6379.conf53:cluster-node-timeout 5000[root@redis64 ~]# systemctl start redis.service
[root@redis59 ~]# 搭建集群[root@redis59 ~]# redis-cli --cluster create 192.168.88.59:6379 192.168.88.60:6379 192.168.88.61:6379 192.168.88.62:6379 192.168.88.63:6379 192.168.88.64:6379 --cluster-replicas 1>>> Performing hash slots allocation on 6 nodes...Master[0] -> Slots 0 - 5460Master[1] -> Slots 5461 - 10922Master[2] -> Slots 10923 - 16383Adding replica 192.168.88.63:6379 to 192.168.88.59:6379Adding replica 192.168.88.64:6379 to 192.168.88.60:6379Adding replica 192.168.88.62:6379 to 192.168.88.61:6379M: 4f75181056b5aefd90f2b1cc242e105f929ec5b4 192.168.88.59:6379 slots:[0-5460] (5461 slots) masterM: e92ce91b5b3b4587c5520482e7a825b050d02dee 192.168.88.60:6379 slots:[5461-10922] (5462 slots) masterM: 8f23c1c05cda60f570d70543c5ea3e5bf643c89c 192.168.88.61:6379 slots:[10923-16383] (5461 slots) masterS: fa61df96aea2f9a53427eae75fd0c82e4b916ffb 192.168.88.62:6379 replicates 8f23c1c05cda60f570d70543c5ea3e5bf643c89cS: 1ca6b10204e7df92340b5c8318416340d4c5ec6b 192.168.88.63:6379 replicates 4f75181056b5aefd90f2b1cc242e105f929ec5b4S: 0d342ee7810cadea394eb62a7da4e3a1f320f680 192.168.88.64:6379 replicates e92ce91b5b3b4587c5520482e7a825b050d02deeCan I set the above configuration? (type 'yes' to accept): yes>>> Nodes configuration updated>>> Assign a different config epoch to each node>>> Sending CLUSTER MEET messages to join the clusterWaiting for the cluster to join
>>> Performing Cluster Check (using node 192.168.88.59:6379)M: 4f75181056b5aefd90f2b1cc242e105f929ec5b4 192.168.88.59:6379 slots:[0-5460] (5461 slots) master 1 additional replica(s)M: e92ce91b5b3b4587c5520482e7a825b050d02dee 192.168.88.60:6379 slots:[5461-10922] (5462 slots) master 1 additional replica(s)M: 8f23c1c05cda60f570d70543c5ea3e5bf643c89c 192.168.88.61:6379 slots:[10923-16383] (5461 slots) master 1 additional replica(s)S: 0d342ee7810cadea394eb62a7da4e3a1f320f680 192.168.88.64:6379 slots: (0 slots) slave replicates e92ce91b5b3b4587c5520482e7a825b050d02deeS: fa61df96aea2f9a53427eae75fd0c82e4b916ffb 192.168.88.62:6379 slots: (0 slots) slave replicates 8f23c1c05cda60f570d70543c5ea3e5bf643c89cS: 1ca6b10204e7df92340b5c8318416340d4c5ec6b 192.168.88.63:6379 slots: (0 slots) slave replicates 4f75181056b5aefd90f2b1cc242e105f929ec5b4[OK] All nodes agree about slots configuration.>>> Check for open slots...>>> Check slots coverage...[OK] All 16384 slots covered.[root@redis59 ~]#
[root@redis59 ~]# 查看集群信息[root@redis59 ~]# redis-cli --cluster info 192.168.88.59:6379192.168.88.59:6379 (4f751810...) -> 0 keys | 5461 slots | 1 slaves.192.168.88.60:6379 (e92ce91b...) -> 0 keys | 5462 slots | 1 slaves.192.168.88.61:6379 (8f23c1c0...) -> 0 keys | 5461 slots | 1 slaves.[OK] 0 keys in 3 masters.0.00 keys per slot on average.[root@redis59 ~]#
[root@redis59 ~]# 访问集群验证数据[root@redis59 ~]# redis-cli -c -h 192.168.88.59 -p 6379192.168.88.59:6379> set a 1-> Redirected to slot [15495] located at 192.168.88.61:6379OK192.168.88.61:6379> set b 2-> Redirected to slot [3300] located at 192.168.88.59:6379OK192.168.88.59:6379> set c 3-> Redirected to slot [7365] located at 192.168.88.60:6379OK192.168.88.60:6379> get a-> Redirected to slot [15495] located at 192.168.88.61:6379"1"192.168.88.61:6379> get a"1"192.168.88.61:6379> get b-> Redirected to slot [3300] located at 192.168.88.59:6379"2"192.168.88.59:6379> get c-> Redirected to slot [7365] located at 192.168.88.60:6379"3"192.168.88.60:6379>- 说明如何使用 RDB 文件恢复 Redis 数据。
[root@redis59 ~]# grep -vE "^\s*($|#)" /opt/redis/conf/redis.conf | grep savesave 3600 1 120 10 60 10000stop-writes-on-bgsave-error yesrdb-save-incremental-fsync yes[root@redis59 ~]# systemctl start redis.service[root@redis59 ~]# ls /opt/redis/data/[root@redis59 ~]# redis-cli127.0.0.1:6379> keys *(empty array)127.0.0.1:6379> mset a 1 b 2 c 3 d 4 x 1 y 2 z 3 k 6 i 7 z 9 f 22 zz 99 cc 66OK127.0.0.1:6379> keys * 1) "c" 2) "d" 3) "k" 4) "a" 5) "cc" 6) "x" 7) "zz" 8) "f" 9) "y"10) "b"11) "i"12) "z"127.0.0.1:6379> exit[root@redis59 ~]# ls /opt/redis/data/dump.rdb[root@redis59 ~]#
# 在60服务器上恢复数据[root@redis60 ~]#[root@redis60 ~]# grep -vE "^\s*($|#)" /opt/redis/conf/redis.conf | grep savesave 3600 1 120 10 60 10000stop-writes-on-bgsave-error yesrdb-save-incremental-fsync yes[root@redis60 ~]# systemctl start redis.service[root@redis60 ~]# redis-cli127.0.0.1:6379> keys *(empty array)127.0.0.1:6379> exit[root@redis60 ~]# systemctl stop redis.service[root@redis60 ~]# ls /opt/redis/data/dump.rdb[root@redis60 ~]# rm -rf /opt/redis/data/dump.rdb[root@redis60 ~]# scp root@192.168.88.59:/opt/redis/data/dump.rdb /opt/redis/data/root@192.168.88.59's password:dump.rdb 100% 157 84.3KB/s 00:00[root@redis60 ~]# ll /opt/redis/data/总用量 4-rw-r--r-- 1 root root 157 1月 22 10:15 dump.rdb[root@redis60 ~]# systemctl start redis.service[root@redis60 ~]# redis-cli127.0.0.1:6379> keys * 1) "y" 2) "f" 3) "c" 4) "a" 5) "b" 6) "zz" 7) "z" 8) "i" 9) "cc"10) "x"11) "k"12) "d"127.0.0.1:6379>day01-MySQL介绍及安装
一、 Mysql概述
1、关系型数据库与非关系型数据库
RDBMS(relational【瑞-雷-审-呢欧】 database【得塔-贝斯】 management【脉-内吉-门特】 system【西斯屯】),关系型数据库管理系统 简单来说,关系型数据库,是指采用了二维表格来组织数据的数据库。
 在行业中,数据库一般分两种,关系型数据库和非关系型数据库。非关系型数据库 并不是通过二维表格来维护数据。而是通过key/value键值对来维护数据的。
2、常见的关系型数据库
Oracle【欧瑞扣】、 mysql、 DB2( IBM)、Sybase【赛-贝斯】、SQL server【涩·沃】( Microsoft微软)、 IBM Informix【因佛-麦克斯】 关系型数据的最大特点就是事务的一致性:所以对事务一致性的维护会占有很大的 开销
3、什么是事务
事务是由一条或多条sql语句组成; 在事务的操作中,这些sql语句要么都成功执行,要么都不执行,这就是一个事 务。
- 登陆ATM机,输入密码;
- 连接数据库,验证密码;
- 验证成功,获得用户信息,比如存款余额等;
- 用户输入需要转账的金额,按下确认键;
- 从后台数据库中减掉用户账户上的对应金额(update【阿普-得特】语句);
- 从后台数据库中给对方账户增加相应的金额(update【阿普-得特】语句);
- 确认,退卡,走人;
4、事务的特点(ACID)
- 原子性(Atomicity【艾特米涩替】): 事务中的全部操作在数据库中是不可分割的,要么全部完成,要么均不执行。
- 一致性(Consistency【肯西斯腾西】): 指事务必须使数据库从一个一致性状态变换到另一个一致性状态,也就是说一 个事务执行之前和执行之后都必须处于一致性状态,不能破坏关系数据的完整 性以及业务逻辑上的一致性。
- . 隔离性(Isolation【艾涩雷申】): 一个事务的执行不受其他事务的干扰,事务执行的中间结果对其他事务必须是 透明的。隔离性是当多个用户并发访问数据库时,比如操作同一张表时,数据 库为每一个用户开启的事务,不能被其他事务的操作所干扰,多个并发事务之 间要相互隔离。
- 持久性(Durability【杜若比勒替】): 持久性是指一个事务一旦被提交了,那么对数据库中的数据的改变就是永久性 的,即便是在数据库系统遇到故障的情况下也不会丢失提交事务的操作。对数据的一致性要求较高的,就是银行及支付系统类
5、 Mysql数据库概述
mysql是一种关系型数据库管理系统,由瑞典Mysql AB公司开发,目前属于Oracle【欧瑞扣】旗下,Mysql是C/S架构
6、 Mysql数据库版本
社区版: MySQL Community【肯谬尼替】 Editon【伊迪申】(GPL)
- 可以看做是企业版的广泛体验版,没有经过各个专有系统平台的压力测试和性 能测试
- 基于GPL协议发布,可以随意下载使用
- 没有任何官方技术支持服务。
企业版: Mysql Enterprise【恩特普莱兹】 Edition伊迪申(commercial【克默收】)
- 提供比较全面的高级功能、管理工具以及技术支持
- 安全性、稳定性、可扩展性比较好
集群版: Mysql Cluster【克拉斯特】 CGE(commercial【克默收】)
扩充:关于版本的命名方式如何去定义?
| 版本 | 说明 |
|---|---|
| α(Alpha【艾欧法】)版 | 内测版,内部交流或者专业测试人员测试用。 Bug 较多,普通用户最好不要安装。 |
| β( Beta【贝塔】)版 | 公测版,专业爱好者大规模测试用,存在一些缺 陷,该版本也不适合一般用户安装。 |
| γ ( Gamma【盖么】 )版 | 相当成熟的测试版,与即将发行的正式版相差无 几。 |
| Final【伐呢欧】 | 正式版本 |
| Free【弗瑞】 | 自由版本 |
| Release【瑞利斯】 | 发行版本 |
| Standard【斯丹德的】 | 标准版本 |
| Mini【米尼】 | 迷你精简版本,只有最基本的功能 |
| Upgrade【阿普格瑞德】 | 升级版本 |
| GA(GenerallyAvailable【珍若里-呃 维 勒 布(白话)】) | 开发团队认为该版本是稳定版,可以在较为关键的 场合使用。 |
| Retail【瑞忒欧】 | 零售版 |
7、获取MySQL软件
第一步:单机Downloads【当-漏的】下载
 第二步:找到社区版
 第三步:单击进入Mysql社区版下载页面
 第四步:选择合适的版本
①GLIBC【哥里布C】版本(相当于Windows中的绿色版)
 ②源码编译版本(需要源码编译三步走=>配置+编译+安装)
https://cdn.mysql.com/archives/mysql-5.7/mysql-5.7.44-linux-glibc【哥里布C】2.12-x86_64.tar.gz
二、 CentOS7.6操作系统最小化安装
1、虚拟机设置
第一步:选择自定义(根据需求设定服务器环境)
 默认
 第三步:选择操作系统类型
 第四步:设置虚拟机名称及路径(建议磁盘剩余空间大于等于20G)
 第五步:设置CPU核数
 第六步“设置MEM内存
 第七步:设置网络连接(NAT模式)
 剩下的全部默认,一路下一步,直至设置完成
2、安装Centos7.6最小化模式
第一步:加载光盘镜像
 第二步:启动虚拟机,安装CentOS7.6
 第三步:设置安装语言(必须选择全英文)
 第四步:设置服务器时间(Asia/Shanghai)
 第五步:软件选择,最小化然后必须要勾选开发工具*(主要是GCC编译器)
 第六步:自动分区
 第七步:设置网络连接为自动连接(开机后,自动连接网络)
 第八步:设置ROOT账户密码以及自定义用户
3、 Centos7.6操作系统最小化后续配置
①设置主机名称
#hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mysql#su②更改IP获取方式为静态设置
#vi /etc/sysconfig/network【孽特 - 沃克】-scripts【斯贵 普茨】/ifcfg-ens33TYPE="Ethernet"BOOTPROTO="none"IPADDR=192.168.20.111NETMASK=255.255.255.0GATEWAY=192.168.20.2DNS1=8.8.8.8DNS2=119.29.29.29NAME="ens33"DEVICE="ens33"ONBOOT="yes"
#vi /etc/hosts192.168.20.111 mysql.cn
## systemctl【西斯屯-ctl】 restart【 率 s 达r】 network【孽特 - 沃克】③关闭防火墙与SELinux
## systemctl【西斯屯-ctl】 stop【 s 多】 firewalld【fai 额 沃 得】## systemctl【西斯屯-ctl】 disable【滴 s 步】 firewalld【fai 额 沃 得】
#setenforce【赛特-因佛尔斯】 0#vim /etc/selinux/configSELINUX=disabled④配置公网YUM源(可以考虑腾讯)
# yum install【因-斯多】 wget -y# mv /etc/yum.repos.d/CentOS-Base.repo /etc/yum.repos.d/CentOS- Base.repo.backup# wget -O /etc/yum.repos.d/CentOS-Base.repohttp://mirrors.cloud.tencent.com/repo/centos7_base.repo
# yum clean【科林恩】 all【哦】# yum makecache⑤安装扩展软件
bash-completion自动补全、VIM编辑器、 net-tools网络工具包以 及ntpdate时间同步工具
# yum install【因-斯多】 bash-completion vim net-tools ntpdate -y⑥ntpdate时间同步
#ntpdate 120.25.108.114、拍摄快照:把Centos7.6最小化系统做模板
机
 建议:拍摄快照完成后,可以将这台机器关机,以后专门充当克隆用的母机!
三、 Mysql的安装
1、 Mysql的安装方式
二进制软件包安装 ①yum安装和rpm安装 ②glibc【哥里布C】版本安装(相当于Windows中的绿色软件) 命名: mysql-5.7.31-linux-glibc【哥里布C】2.12-x86_64.tar 依赖glibc【哥里布C】库,可以安装在通用的Linux系统下 源码包编译安装 命名: mysql-boost-5.7.31.tar,通用的Linux下都可以编译安装
2、三种安装方式的区别
| 安装 方式 | 优点 | 缺点 |
|---|---|---|
| rpm | 安装卸载简单 | 可定制性差 |
| glibc【哥里布C】 | 可定制性相比rpm包灵活些 | 安装相比rpm包复杂些,需要手动初 始化数据库 |
| 源码 安装 | 可定制性最强,根据需求和 功能定制 | 安装麻烦,需要手动初始化数据库 |
在企业中,数据库的安装很少使用rpm方式,大部分都是基于源码安装以及glibc【哥里布C】安 装
3、区分数据库与数据库实例
①什么是MySQL数据库?
数据库(database【得-塔-贝斯】): 操作系统或存储上的数据文件的集合。 mysql数据库中, 数据库文件可以是* .frm、.MYD、 .MYI、*.ibd等结尾的文件, 不同存储引擎文件 类型不同。
②什么是MySQL数据库实例?
数据库实例(instance【因-斯腾斯】): 由后台进程或者线程以及一个共享内存区组成。共享 内存可以被运行的后台线程所共享。 数据库实例才是真正操作数据库的。 注意: MySQL的后台守护程序mysqld是单进程多线程的工作模式。
③什么是MySQL数据库服务器?
数据库服务器(database【得-塔-贝斯】 server【涩·沃】):部署安装数据库实例的服务器。
④、数据库和数据库实例之间的关系是什么
通常情况下,数据库实例和数据库是一一对应的关系,也就是一个数据库实例对应 一个数据库; 但是,在集群环境中存在多个数据库实例共同使用一个数据库。
四、 MySQL的GLIBC【哥里布C】版本安装
1、获取MySQL GLIBC【哥里布C】版本
2、学会看官方文档
3、安装MySQL依赖库软件
第一步:克隆模板机,生成Mysql服务器 第二步:启动系统 第三步:更改主机名为mysql.aliyun.cn。然后重启网络 第四步:拍摄快照 第五步:安装依赖库libaio库
#yum install【因-斯多】 libaio -y4、上传软件包解压,了解目录结构
# tar -xf mysql-5.7.31-linux-glibc【哥里布C】2.12-x86_64.tar.gz# ls mysql-5.7.31-linux-glibc【哥里布C】2.12-x86_64解压完成后,目录结构如下图所示:
| 选项 | 值(自定义也可以采用默认形式) |
|---|---|
| 安装路径 | /mysql_3306 |
| 数据路径 | /mysql_3306/data |
| 端口号 | 3306 |
5、软件的安装(查看官方说明)
官方说明 要安装和使用Mysql二进制发现版,命令序列如下:
$> groupadd mysql$> useradd -r -g mysql -s /bin/false mysql$> rm -rf /etc/my.cnf$> cd /usr/local$> tar zxvf /path/to/mysql-VERSION-OS.tar.gz$> ln -s full-path-to-mysql-VERSION-OS mysql$> cd mysql$> mkdir mysql-files$> chown【吃-昂】 mysql:mysql mysql-files$> chmod【吃-默德】 750 mysql-files$> bin/mysqld --initialize【因 尼 舍 来斯】 --user=mysql$> bin/mysql_ssl_rsa_setup$> bin/mysqld_safe --user=mysql &# Next command is optional$> cp support【瑟破特】-files/mysql.server【涩·沃】 /etc/init.d/mysql.server【涩·沃】第一步:创建一个数据库专用账号mysql(其所属组也为mysql)
# useradd -r -s /sbin/nologin mysql# id mysql第二步:清空系统中的原有mariadb【玛瑞亚DB】的配置文件(/etc/my.cnf)
# rm -rf /etc/my.cnf第三步:把mysql解压后的压缩包移动到根目录下
# mv mysql-5.7.31-linux-glibc【哥里布C】2.12-x86_64 /mysql_3306第四步:创建一个mysql-files【伐欧兹】
# cd /mysql_3306# mkdir mysql-files第五步:更改mysql-files权限
# chown【吃-昂】 mysql:mysql mysql-files# chmod【吃-默德】 750 mysql-files第六步:初始化数据库
# bin/mysqld --initialize【因 尼 舍 来斯】 --user=mysql --basedir=/mysql_3306选项说明:--initialize【因 尼 舍 来斯】 初始化(真正开始干活)--user=mysql 以mysql用户的身份初始化数据库 ,产生文件都是mysql作为拥有者–basedir【贝斯-迪尔】=xxx mysql其安装目录 ,非常重要
运行完毕后 ,观察最后一行 ,保存root账号的密码 , 已备后期使用。2023-12-12T07:43:11.882980Z 1 [Note] A temporary password【帕斯沃德】 is generated for【fò】 root@localhost: s+=x(>uqe4eK第七步:设置安全加密连接(SL),数据传输会采用加密形式,适合敏感数据
# bin/mysql_ssl_rsa_setup --datadir=/mysql_3306/data第八步:启动数据库
# cp support【瑟破特】-files/mysql.server【涩·沃】 /etc/init.d/mysql_3306默认情况下,GBLIC版本的数据库要求安装到/usr/local/mysql目录,其 mysql.server【涩·沃】脚本中对应的目录也是/usr/local/mysql,这会导致mysql无法启动。 所以可以更改其basedir【贝斯德尔】以及datadir【得塔德尔】两个变量
#vim /etc/init.d/mysql_330646行basedir【贝斯德尔】=/mysql_330647行datadir【得塔德尔】=/mysql_3306/data第九步:启动Mysql数据库(不能使用# systemctl【西斯屯-ctl】
,只能使用service【瑟为斯】)
#service【瑟为斯】 mysql_3306 start【s 达儿】Starting【斯大-停】 MySQL.Logging【劳-京】 to '/mysql_3306/data/mysql.err'.. SUCCESS【涩赛斯】!特别说明:当MySQL启动成功后,其日志会自动写入到data数据目录中的主机名 称.err文件中,这个文件一定要多看,涉及MySQL无法启动、启动报错,其详细的 原因99%在.err文件中可以找到问题所在!
6、软件的安装常见问题答疑
问题1:为什么一定要删除/etc/my.cnf文件,不删除有何影响
答:/etc/my.cnf文件是操作系统为mariadb【玛瑞亚DB】软件预留的配置的文件,之所以一定要 删除这个文件,主要原因在于数据库在初始化时,首先在自己的安装目录下寻找有 没有my.cnf配置文件,如果有,会自动根据里面的配置信息进行初始化。如果找不 到,则到/etc目录下寻找my.cnf文件,如果有,依然会按照其内部的配置进行初始 化,但是由于/etc目录下的my.cnf文件是mariadb【玛瑞亚DB】的,这会导致我们的初始化如果 按照mariadb【玛瑞亚DB】的配置,会导致初始化失败。
问题2: mysql_files文件夹到底是干什么的
答:目前mysql-files没有什么用,但是你必须要创建,因为GLIBC【哥里布C】属于二进制软件 包,其很多配置已经默认了,包括mysql-files文件夹,如果没有这个文件夹可能导 致mysql无法启动。
问题3:到底怎么判断数据库是否初始化成功?
答:数据库的安装容易出错的地方就是初始化,一旦初始化失败了,数据库100% 启动报错。如何确认数据库是否初始化成功了呢?主要看安装目录下有没有生成一 个data的文件夹。
问题4:为什么一定要把mysql.server【涩·沃】放在/etc/init.d目录下,不放可不可以?
答:不放也可以,但是这个时候就不能使用service【瑟为斯】命令启动以及添加到开机启动项 了。只能通过bin/mysqld_safe脚本启动数据库。
问题5:为什么一定要改变/etc/init.d/mysql_3306中的basedir【贝斯德尔】与datadir【得塔德尔】?
答:GLIBC【哥里布C】版本属于二进制版本,默认已经配置了很多内容,包括默认的安装路 径/usr/local/mysql ,一旦你的mysql没有安装在这个目录下,则必须手工设置 basedir【贝斯德尔】以及datadir【得塔德尔】其位置,否则脚本无法启动mysql程序
问题6:如何让mysql自动启动
# chkconfig【切-坑菲格】 --list 查询系统中的所有开机启动项# chkconfig【切-坑菲格】 --add mysql_3306 必须与/etc/in it.d目录下的脚本名称一致# chkconfig【切-坑菲格】 mysql_3306 on 把2345四种模式全部开启( 3字符界面 ,5图形界面)7、 Mysql CLIBC版本后续配置
第一步:更改管理员root账户的密码
# bin/mysqladmin【麦斯Q-艾德敏】 -uroot password【帕斯-沃德】 '123' -pEnter password:输入刚刚初始化产生的临时密码# bin/mysql -uroot -p第二步:把mysql客户端命令添加到环境变量,以后随时可以访问
# echo 'export【e斯 破特】 PATH=$PATH:/mysql_3306/bin' >> /etc/profile【普若法欧】# source【索尔斯】 /etc/profile【普若法欧】第三步:手工定义MySQL的配置文件
#vim /mysql_3306/my.cnf[mysqld]basedir【贝斯德尔】=/mysql_3306datadir【得塔德尔】=/mysql_3306/datasocket=/tmp/mysql.sock选项说明:[mmysql] 代表针对服务器端进行配置 basedir 代表数据库的安装目录datadir 代表数据目录 ,以后专门用于存放数据文件的(核心目录)socket 代表套接字文件 ,专门为客户端与服务端连接提供的一个桥梁第四步:安全配置
[root@mysql ~]# mysql_secure_installation【因-斯多 雷申】 # 执行MySQL安全配置脚本
Securing the MySQL server【涩·沃】 deployment.
Enter password【帕斯沃德】 for【fò】 user root: # 输入当前root用户的密码(若未设置直接回车)
# 选项1:是否启用密码验证插件(用于检查密码强度)VALIDATE PASSWORD PLUGIN【普辣 京(白话)】 can be used to test passwordsand improve security. It checks the strength of passwordand allows the users to set【赛特】 only【欧利】 those passwords which aresecure enough. Would you like【赖特】 to setup VALIDATE PASSWORD plugin【普辣 京(白话)】?Press y|Y for【fò】 Yes, any other key for【fò】 No: y # 输入y启用(增强安全性)
# 选项2:选择密码验证策略级别There are three levels【列沃】 of password validation policy:LOW Length >= 8 # 低:仅要求密码长度≥8位MEDIUM Length >= 8, numeric, mixed case, and special characters # 中:长度≥8位且包含数字、大小写字母、特殊字符STRONG Length >= 8, numeric, mixed case, special characters and dictionary file # 高:在中级基础上增加字典检查(防止常见弱密码)Please enter 0 = LOW, 1 = MEDIUM and 2 = STRONG: 0 # 输入0选择低级策略
Using existing password for【fò】 root.Estimated strength of the password: 50
# 选项3:是否修改root用户密码Change the password for【fò】 root ? ((Press y|Y for【fò】 Yes, any other key for【fò】 No) : no # 输入no不修改现有密码(若需修改输入y) ... skipping.
# 选项4:是否删除匿名用户(默认存在,允许无账号登录)By default, a MySQL installation has an anonymous user,allowing anyone to log into【因兔】 MySQL without having to havea user account created for【fò】 them. This is intended only【欧利】 for【fò】testing, and to make the installation go a bit smoother.You should remove them before moving into【因兔】 a productionenvironment.Remove anonymous users? (Press y|Y for【fò】 Yes, any other key for【fò】 No) : y # 输入y删除(推荐,减少未授权访问风险)Success.
# 选项5:是否禁止root用户远程登录(仅允许本地登录)Normally, root should only【欧利】 be allowed to connect from【弗乱】'localhost'. This ensures that someone cannot guess atthe root password from【弗乱】 the network.Disallow root login remotely? (Press y|Y for Yes, any other key for No) : y # 输入y禁止(推荐,降低远程暴力破解风险)Success.
# 选项6:是否删除test【泰斯特】数据库(默认存在,供测试使用)By default, MySQL comes with a database named 'test' thatanyone can access. This is also intended only【欧利】 for【fò】 testing,and should be removed before moving into【因兔】 a productionenvironment.Remove test database and access to it? (Press y|Y for【fò】 Yes, any other key for【fò】 No) : y # 输入y删除(推荐,清理无用数据库) - Dropping test database...Success. - Removing privileges【P符类 杰 斯】 on test database...Success.
# 选项7:是否立即刷新权限表(使所有配置生效)Reloading the privilege tables will ensure that all【哦】 changesmade so far will take effect immediately.Reload【率漏德】 privilege tables now? (Press y|Y for【fò】 Yes, any other key for【fò】 No) : y # 输入y刷新(必须执行,否则配置不生效)Success.
All done! # 所有安全配置完成[root@mysql ~]#输入密码后,一个要求是否改密码,选择N不改,后续的一直按Y就可以了
五、 MySQL的源码安装
1、参考Mysql源码安装官方文档
源码安装三部曲:配置—>编译—>安装 安装须知
软件包
shell mysql-boost-5.7.31.tar.gz 可以在任意发行版的Linux下安装
安装需求
| 安装需求 | 具体配置 |
|---|---|
| 安装目录(basedir【贝斯德尔】) | /mysql_3307 |
| 数据目录(datadir【得塔德尔】) | /mysql_3307/data |
| 端口号 | 3307 |
| socket文件位置 | $basedir【贝斯德尔】/mysql.sock |
| 字符集 | utf8mb4 |
常用的配置选项
| 配置选项 | 描述 | 默认值 | 建议值 |
|---|---|---|---|
| CMAKE_INSTALL【因-斯多】_PREFIX | 安装基目录(basedir【贝斯德尔】) | /usr/local/mysql | 根据需求 |
| MYSQL_DATADIR【得塔德尔】 | 数据目录 (datadir【得塔德尔】) | $basedir【贝斯德尔】/data | 根据需求 |
| SYSCONFDIR | 默认配置 文件my.cnf路径 | /etc | |
| MYSQL_TCP_PORT【破特】 | TCP/IP端口 | 3306 | 非默认端口 |
| MYSQL_UNIX_ADDR | 套接字socket文 件路径 | /tmp/mysql.sock | $basedir【贝斯德尔】/ |
| DEFAULT_CHARSET | 默认字符集 | latin1 | utf8mb4 |
| DEFAULT_COLLATION | 默认校验 规则 | latin1_swedish_ci | utf8mb4_general_ci |
| WITH【威付】_EXTRA_CHARSETS | 扩展字符 集 | all【哦】 | all【哦】 |
| ENABLED【伊内部特】_LOCAL_INFILE | 是否启用 本地加载 外部数据 文件功能 | OFF | 建议开启 |
| WITH【威付】_SSL | SSL支持 类型 | system | 建议显式指定 |
| WITH【威付】_BOOST | Boost库 源代码的 位置 | Boost库是构建MySQL所必需的,建 议事先下载 |
存储引擎相关配置项 说明: 以下选项值均为布尔值,0或1;0代表不编译到服务器中, 1代表编译,建议都静态 编译到服务器中。 其他的存储引擎可以根据实际需求在安装时通过WITH【威付】_xxxx_STORAGE_ENGINE=1 的方式编译到服务器中。
| 配置选项 | 描述 |
|---|---|
| WITH【威付】_INNOBASE_STORAGE_ENGINE | 将InnoDB存储引擎插件构建为静 态模块编译到服务器中;建议编译 到服务器中 |
| WITH【威付】_PARTITION_STORAGE_ENGINE | 是否支持分区 |
| WITH【威付】_FEDERATED_STORAGE_ENGINE | 本地数据库是否可以访问远程 mysql数据 |
| WITH【威付】_BLACKHOLE_STORAGE_ENGINE | 黑洞存储引擎,接收数据,但不存 储,直接丢弃 |
| WITH【威付】_MYISAM【迈-艾塞姆】_STORAGE_ENGINE | 将MYISAM【迈-艾塞姆】存储引擎静态编译到服 务器中 |
2、 MySQL的源码编译安装
在安装之前建议拍摄一个快照
第一步:安装MySQL编译需要用到的依赖库
# yum groupinstall【格鲁普因-斯多】 -y "Development Tools"# yum -y install【因-斯多】 ncurses-devel cmake libaio-devel openssl-devel gcc gcc-c++ bison-devel bzip2-devel libcurl-devel第二步:上传软件到服务器端并解压
# tar -xf mysql-boost-5.7.31.tar.gz# cd mysql-5.7.31第三步:配置(基于cmake进行配置)
#vim myconfig.shcmake . \-DCMAKE_INSTALL【因-斯多】_PREFIX=/mysql_3307 \-DMYSQL_DATADIR=/mysql_3307/data \-DMYSQL_TCP_PORT【破特】=3307 \-DMYSQL_UNIX_ADDR=/mysql_3307/mysql.sock \-DWITH_INNOBASE_STORAGE_ENGINE=1 \-DWITH_PARTITION_STORAGE_ENGINE=1 \-DWITH_FEDERATED_STORAGE_ENGINE=1 \-DWITH_BLACKHOLE_STORAGE_ENGINE=1 \-DWITH_MYISAM_STORAGE_ENGINE=1 \-DENABLED_LOCAL_INFILE=1 \-DEXTRA_CHARSETS=all【哦】 \-DDEFAULT_CHARSET=utf8mb4 \-DDEFAULT_COLLATION=utf8mb4_general_ci \-DWITH_SSL=system \-DWITH_BOOST=boost
# chmod【吃-默德】 +x myconfig.sh# mkdir【摸克跌儿】 -p /mysql_3307/data# ./myconfig.sh
选项说明:-DCMAKE_INSTALL【因-斯多】_PREFIX:安装路径-DMYSQL_DATADIR:数据目录-DMYSQL_TCP_PORT【破特】:端口号-DMYSQL_UNIX_ADDR:套接字文件位置第四步:编译安装
# make -j2 && make install【因-斯多】选项说明:-j2:代表同时开启多个线程共同实现编译操作3、编译报错常见问题解析
问题1:没有boost导致安装失败
问题2:编译安装中途报错
 解决方案:只能重新编译一下
#rm -f CMake Cache.txt#make -j2 && make install【因-斯多】问题3:编译过程遇到了编译器问题
遇到下述报错
[root@mysql mysql-5.7.31]# ./myconfig.sh-- Running【乱宁】 cmake version 2.8.12.2-- Could NOT find Git (missing: GIT_EXECUTABLE)-- Configuring with【威付】 MAX_INDEXES = 64U-- The C compiler identification is unknown-- The CXX compiler identification is unknownCMake Error: your C compiler: "CMAKE_C_COMPILER-NOTFOUND" was not found. Please set CMAKE_C_COMPILER to a valid compiler path or name.CMake Error: your CXX compiler: "CMAKE_CXX_COMPILER-NOTFOUND" was not found. Please set CMAKE_CXX_COMPILER to a valid compiler path or name.-- CMAKE_GENERATOR: Unix MakefilesCMake Error at cmake/os/Linux.cmake:50 (MESSAGE): Unsupported compiler!Call Stack (most recent call first): CMakeLists.txt:198 (INCLUDE)
-- Configuring incomplete, errors occurred!See also "/root/mysql-5.7.31/CMakeFiles/CMakeOutput.log".See also "/root/mysql-5.7.31/CMakeFiles/CMakeError.log".完整解决方案 步骤1:安装编译工具链
# CentOS/RHEL:yum groupinstall【格鲁普因-斯多】 -y "Development Tools"yum install【因-斯多】 -y gcc gcc-c++ openssl-devel ncurses-devel
# Ubuntu/Debian:apt update【阿普 dei 特】apt install【因-斯多】 -y build-essential cmake libssl-dev libncurses5-dev步骤2:安装必需依赖包【正常执行这两个步骤就可以试试重新编译了】
# CentOS/RHEL:yum install【因-斯多】 -y ncurses-devel bison-devel bzip2-devel libcurl-devel
# Ubuntu/Debian:apt install【因-斯多】 -y libncurses5-dev bison bzip2 libcurl4-openssl-dev步骤3:验证GCC安装(重要)
gcc --version # 确认显示版本信息g++ --version # 确认显示版本信息# 预期输出示例:gcc (GCC) 4.8.5 20150623步骤4:下载Boost库(必需)
cd ~/mysql-5.7.31wget https://sourceforge.net/projects/boost/files/boost/1.59.0/boost_1_59_0.tar.gztar zxf boost_1_59_0.tar.gzln -s boost_1_59_0 boost步骤5:清理并重新配置
# 清理之前的错误配置rm -rf CMakeCache.txt CMakeFiles/
# 修改脚本为正确版本sed -i 's/myconfig.sh/myconfig.sh/g' myconfig.sh # 修正文件名特殊字符
# 重新运行配置(确保脚本名无特殊字符)./myconfig.sh4、 Mysql数据库的初始化
进入到安装目录/mysql_3307
#cd /mysql_3307第一步:创建mysql-files目录
# mkdir【摸克跌儿】 mysql-files# chown【吃-昂】 -R mysql:mysql /mysql_3307# chmod【吃-默德】 750 mysql-files第二步:数据库初始化操作
# useradd -M -s /sbin/nologin mysql# chown【吃-昂】 -R mysql:mysql /mysql_3307# bin/mysqld --initialize【因 尼 舍 来斯】 --user=mysql --basedir=/mysql_3307 --datadir=/mysql_3307/data2023-12-14T08:24:40.173591Z 1 [Note] A temporary password【帕斯沃德】 is generated for【fò】 root@localhost: Eq/rp?jc I2of第三步:拷贝mysql.server【涩·沃】脚本到/etc/init.d目录,然后启动数据库
# cp support【瑟破特】-files/mysql.server【涩·沃】 /etc/init.d/mysql_3307# service【瑟为斯】 mysql_3307 start【s 达儿】5、 MySQL源码编译安装后的后续配置
第一步:编写mysql配置文件, my.cnf
#vim /mysql_3307/my.cnf[mysqld]basedir=/mysql_3307datadir=/mysql_3307/datasocket=/mysql_3307/mysql.sock
#service【瑟为斯】 mysql_3307 restart【 率 s 达r】第二步:设置管理员密码
# bin/mysqladmin -uroot password【帕斯沃德】 '123' -p第三步:安全设置
# bin/mysql_secure_installation【因-斯多 雷申】输入密码后 ,不更改密码 ,一直Y第四步:添加mysql_3307到开机启动项
# chkconfig【切-坑菲格】 --add mysql_3307# chkconfig【切-坑菲格】 mysql_3307 on六、 Mysql常见问题解决方案
1、如何访问不同的数据库呢?
方法一:直接使用对应的客户端软件访问
[root@mysql ~]# /mysql_3306/bin/mysql -uroot -pEnter password【帕斯沃德】:Welcome to the MySQL monitor【魔尼特】. Commands end with【威付】 ; or \g. Your MySQL connection id is 3server【涩·沃】 version: 5.7.31 MySQL Community server【涩·沃】 (GPL)
[root@mysql ~]# /mysql_3307/bin/mysql -uroot -pEnter password【帕斯沃德】:Welcome to the MySQL monitor【魔尼特】. Commands end with【威付】 ; or \g. Your MySQL connection id is 3server【涩·沃】 version: 5.7.31 Source distribution方法二:定义别名的方式访问
[root@mysql ~]# alias mysql_3306="/mysql_3306/bin/mysql" [root@mysql ~]# alias mysql_3307="/mysql_3307/bin/mysql"[root@mysql ~]# mysql_3306 -uroot -pEnter password【帕斯沃德】:Welcome to the MySQL monitor【魔尼特】. Commands end with【威付】 ; or \g. Your MySQL connection id is 4server【涩·沃】 version: 5.7.31 MySQL Community server【涩·沃】 (GPL)
[root@mysql ~]# mysql_3307 -uroot -pEnter password【帕斯沃德】:Welcome to the MySQL monitor【魔尼特】. Commands end with【威付】 ; or \g. Your MySQL connection id is 4server【涩·沃】 version: 5.7.31 Source distribution方法三:拷贝相应命令到PATH可以识别的路径下并重命令
[root@mysql ~]# unalias mysql_3306 [root@mysql ~]# unalias mysql_3307[root@mysql ~]# cp /mysql_3306/bin/mysql /usr/bin/mysql_3306 [root@mysql ~]# cp /mysql_3307/bin/mysql /usr/bin/mysql_3307 [root@mysql ~]#[root@mysql ~]#[root@mysql ~]# which mysql_3306 /usr/bin/mysql_3306[root@mysql ~]# which mysql_3307 /usr/bin/mysql_3307深度思考:我们之所以能够连接到数据库的本质是什么? 答:套接字
2、 MySQL忘记密码的解决方案
①跳过授权表
②跳过授权表重启数据库
Ⅰ关闭数据库
[root@mysql ~]# mysqladmin shutdown -pEnter password【帕斯沃德】:[root@mysql ~]#Ⅱ 跳过授权表启动
# /mysql_3306/bin/mysqld --defaults-file=/mysql_3306/my.cnf --skip-grant【古亮普】-tables -- skip-networking=on --user=mysql &Ⅲ刷新授权表
[root@mysql ~]# mysql -uroot -pEnter password【帕斯沃德】: 什么都不要输入 ,直接回车即可Welcome to the MySQL monitor【魔尼特】. Commands end with【威付】 ; or \g. Your MySQL connection id is 2server【涩·沃】 version: 5.7.31 MySQL Community server【涩·沃】 (GPL)
mysql> flush【福 辣 徐】 privileges【P符类 杰 斯】;Query OK, 0 rows afected (0.00 sec)Ⅳ修改密码
mysql> alter【奥-特】 user 'root'@'localhost' identified by '123'; Query OK, 0 rows afected (0.00 sec)补充:如果未能成功,则使用一下语句修改密码
mysql> UPDATE【阿普 dei 特】 mysql.user SET【赛特】 authentication_string = PASSWORD【帕斯沃德】('MyNewPass') WHERE User = 'root' AND Host = 'localhost';mysql> FLUSH【福 辣 徐】 PRIVILEGES【P符类 杰 斯】;修改密码后,使用jobs+kill命令,停止正在允许的Mysqld进程。然后使用service【瑟为斯】启动服务
#jobs#kill %1#service【瑟为斯】 mysql_3306 start【s 达儿】3、 Unix和类Unix系统重置(了解)
①停止数据库
[root@node1 ~]# mysqladmin shutdown -pEnter password【帕斯沃德】:②编写创建密码语句到文件
# echo "ALTER【奥-特】 USER 'root'@'localhost' identified【爱-丹-提伐】 BY '123';" >> /mysql_3306/mysql.pass注意:该文件一定要对启动用户如mysql有所有权限# chown【吃-昂】 -R mysql. /mysql_3306③指定密码文件启动数据库
# mysqld --defaults-file=/mysql_3306/my.cnf --in it-file=/mysql_3306/mysql.pass -- user=mysql &④删除密码文件,并测试
# rm -f /mysql_3306/mysql.pass# mysql -uroot -pMysql5.7 源码安装实操手册
实验一:Mysql5.7 源码安装
-
实验目的:Mysql5.7 源码安装,掌握源码安装数据库的方法,生产中更适合使用源码安装的方式。
-
实验环境:centos7,内存建议 2G 及以上
-
实验步骤:
1.清理环境卸载 mariadb 数据库
yum -y remove mariadb* 2.创建数据库运行组和用户useradd -M -s /sbin/nologin mysql3.下载源码包(使用 rz -y 去 ftp 上传)
mysql 需要 boost 库文件,可以单独下载 boost也可以下载包含 boost 的 mysql 源码包mysql-boost-5.7.31.tar.gz4.解压(建议解压到/usr/local 目录下)
tar -axf mysql-boost-5.7.31.tar.gz -C /usr/local/5.准备源码安装的环境(工具及依赖包)
yum -y install【因-斯多】 ncurses ncurses-devel openssl-devel bison gcc gcc-c++ make cmake6.配置
先进入解压后的目录cmake . -DWITH_BOOST=./boost/boost_1_59_0/可以使用默认的配置项部分配置项在后续初始化的时候也可以指定7.编译安装
make -j 2 && make install【因-斯多】8.初始化
创建数据库的数据存放目录# mkdir【摸克跌儿】 /usr/local/mysql/data# chown【吃-昂】 -R mysql:mysql /usr/local/mysql/data# cd /usr/local/mysql# ./bin/mysqld --initialize【因 尼 舍 来斯】 --user=mysql --basedir=/usr/local/mysql --datadir=/usr/local/mysql/data*注意:初始化的时候会自动生成 root 的默认密码 root@localhost: 6%#Uidr/d1Xh
9.创建配置文件:/etc/my.cnf
[mysqld]basedir=/usr/local/mysql 安装目录datadir=/usr/local/mysql/data 数据存放目录注意:路径和配置时或者初始化时指定的一致10.启动服务(可以复制 server【涩·沃】 脚本)
cd /usr/local/mysqlcp support【瑟破特】-files/mysql.server【涩·沃】 /etc/init.d/mysqld //生成 mysql.server【涩·沃】 脚本service【瑟为斯】 mysqld start【s 达儿】 #启动 mysql 服务service【瑟为斯】 mysqld stop【 s 多】 #关闭 mysql 服务11.修改密码
第一次登录需要使用初始化生成的默认密码set password【帕斯沃德】=password【帕斯沃德】('123') #修改密码为 12312.添加环境变量:
# vi /etc/profile.d/mysql.shexport【e斯 破特】 PATH=$PATH:/usr/local/mysql/bin# source /etc/profile实验总结:
Mysql8.0 安装实操手册
实验一:Mysql8.0 安装
- 实验目的:Mysql8.0 安装,熟悉并使用新版本的数据库
- 实验环境:centos7,内存建议 2G 及以上
- 实验步骤:
#yum 安装 mysql8.0
1.安装mysql源
yum install【因-斯多】 -y https://repo.mysql.com/mysql80-community-release-el7-6.noarch.rpm#安装后会自动生成 mysql 官方的 yum 源会生成三个 yum 仓库配置文件只有一个默认是启用的 mysql-community.repo2.安装yum-utils
yum install【因-斯多】 -y yum-utils #这个是 yum 管理配置文件的工具3.导入秘钥
rpm --import https://repo.mysql.com/RPM-GPG-KEY-mysql-2022#导入密钥,如果把设置 gpgcheck=0,则不需要导入4.关闭 mysql5.7 的仓库标签,打开 mysql8.0 的标签
yum-config-manager【面尼杰额】 --enable【ing 内 步】 mysql80-community #等价 enable【ing 内 步】=1yum-config-manager【面尼杰额】 --disable【滴 s 步】 mysql57-community #等价 enable【ing 内 步】=05.安装客户端和服务端
yum install【因-斯多】 -y mysql-community-client【克莱恩特】 mysql-community-server【涩·沃】6.启动服务,修改临时密码(安装时会生成一个临时密码放在日志中)
cat /var/log/mysqld.logmysqladmin -uroot -p 日志中的临时密码 password【帕斯沃德】 'Aa123456!' 密码满足复杂要求:大小写、数字、符号7.用新密码登录即可
实验总结:
day02-Mysql基本SQL语句(上)
一、客户端工具的使用
1、客户端工具使用
shell mysql:mysql命令行工具 ,一般用来连接访问mysql数据库
| 选项 | 说明 |
|---|---|
| -u, —user=name | 指定登录用户名 |
| -p, —password【帕斯沃德】 | 指定登录密码(注意是小写p),一定要放到最后面 |
| -h, —host=name | 指定数据库的主机地址 |
| -P, —port【破特】=xxx | 指定数据库的端口号(大写P) |
| -S, —socket=name | 指定socket文件 |
| -e, —execute=name | 使用非交互式操作(在shell终端执行sql语句) |
案例:使用mysql客户端工具连接服务器端(用户名:root,密码:123)
# mysql -uroot -p123注意:以上连接方式虽然可以连接进入到Mysql,但是官方不建议直接把密码写入终端,建议-p然后直接回车,然后在终端中输入密码 案例:连接192.168.20.100服务器上的Mysql数据库(用户名:mq,密码:123)
# msyql -h 192.168.20.100 -P 3306 -umq -pEnter password【帕斯沃德】:123案例:根据不同的套接字连接不同的数据库
# mysql -S /mysql_3307/mysql.sock -uroot -p案例:在不进入MySQL内部的情况下,执行SQL语句,获取数据信息
# mysql -e "show【瘦】 databases;" -uroot -pEnter password【帕斯沃德】:123扩展了解
| 默认库 | 描述 |
|---|---|
| information【因弗梅申】_schema【斯基么】 | 1、对象信息数据库,提供对数据库元数据的访问,有关MySQL服务器的信息,例如数据库或表的名称,列的数据类型或访问权限等; 2、在INFORMATION【因弗梅申】_SCHEMA【斯基么】中,有数个只读表,它们实际上是视图,而不是基本表,因此你将无法看到与之相关的任何文件; 3、视图,是一个虚表,即视图所对应的数据不进行实际存储,数据库中只存储视图的定义,在对视图的数据进行操作时,系统根据视图的定义去操作与视图相关联的基本表 |
| mysql | 1、mysql数据库是系统数据库。它包含存储MySQL服务器运行时所需的信息的表。比如权限表、对象信息表、日志系统表、时区系统表、优化器系统表、杂项系统表等。 2、不可以删除,也不要轻易修改这个数据库里面的表息。 |
| performance_schema【斯基么】 | MySQL5.5开始新增一个数据库,主要用于收集数据库服务器性能;并且库里表的存储引擎均为PERFORMANCE_SCHEMA【斯基么】,而用户是不能创建存储引擎为PERFORMANCE_SCHEMA【斯基么】的表 |
| sys | 1、mysql5.7增加了sys 系统数据库,通过这个库可以快速的了解系统的元数据信息; 2、sys库方便DBA发现数据库的很多信息,解决性能瓶颈; 3、这个库是通过视图的形式把information【因弗梅申】_schema 和performance_schema结合起来,查询出更加令人容易理解的数据 |
2、客户端工具mysqladmin使用
mysqladmin:客户端管理mysql数据库工具
①常用选项
| 选项 | 描述 |
|---|---|
| -h, —host=name | 指定连接数据库主机 |
| -p, —password【帕斯沃德】 | 指定数据库密码 |
| -P, —port【破特】=# | 指定数据库端口 |
| -S, —socket=name | 指定数据库socket文件 |
| -u, —user=name | 指定连接数据库用户 |
②常用命令
| 命令 | 描述 |
|---|---|
| password【帕斯沃德】 [new-password【帕斯沃德】] | 更改密码 |
| reload【率漏德】 | 刷新授权表 |
| shutdown | 停止mysql服务 |
| status【 斯dèi 特斯】 | 简短查看数据库状态信息 |
| start【s 达儿】-slave 【斯累夫】 | 启动slave【斯累夫】 |
| stop【 s 多】-slave【斯累夫】 | 停止slave【斯累夫】 |
| variables【wèi 利 bóu 斯】 | 打印可用变量 |
| version | 查看当前mysql数据库的版本信息 |
案例:更改root账户的密码为root
#mysqladmin password【帕斯沃德】 '新密码' -pEnter password【帕斯沃德】: '旧密码'#mysqladmin password【帕斯沃德】 'root' -pEnter password【帕斯沃德】:123案例:更改密码后,建议刷新授权表(mysql > flush【福 辣 徐】 privileges【P符类 杰 斯】;)
#mysqladmin reload【率漏德】 -pEnter password【帕斯沃德】:123案例:停止mysql
#mysqladmin shutdown -pEnter password【帕斯沃德】:123案例:查看mysql状态:
#mysqladmin status【 斯dèi 特斯】 -pEnter password【帕斯沃德】:123案例:打印可用变量(mysql本身预置了很多变量信息)
#mysqladmin variables【wèi 利 bóu 斯】 -pEnter password【帕斯沃德】:123案例:查询mysql版本
#mysqladmin version -pEnter password【帕斯沃德】:123二、MySQL中的SQL语句
1、什么是SQL
SQL 是 Structure【斯抓克彻儿】 Query【亏儿瑞】 Language【兰哥威治】(结构化查询语言)的缩写,它是使用关系模型的数据库应用语言,由 IBM 在 20 世纪 70 年代开发出来,作为 IBM 关系数据库原型 System R 的原型关系语言,实现了关系数据库中的信息检索。 20 世纪 80 年代初,美国国家标准局(ANSI)开始着手制定 SQL 标准,最早的 ANSI 标准于1986 年完成,就被叫作 SQL-86。标准的出台使 SQL 作为标准关系数据库语言的地位得到了加强。SQL 标准目前已几经修改更趋完善。 正是由于 SQL 语言的标准化,所以大多数关系型数据库系统都支持 SQL 语言,它已经发展成为多种平台进行交互操作的底层会话语言。
2、SQL语句的分类
DDL(Data Definition【德菲尼申】 Languages【兰哥威治】)语句:
数据定义语言,这些语句定义了不同的数据段、数据库、表、列、索引等数据库对象的定义。常用的语句关键字主要包括 create【克瑞特】、drop【卓-普】、alter【奥-特】、rename【瑞-内姆】、truncate【创kí特】。
DML(Data Manipulation【么尼普雷申】 Language【兰哥威治】)语句:
数据操纵语句,用于添加、删除、更新和查询数据库记录,并检查数据完整性,常用的语句关键字主要包括 insert【因涩特】、delete【迪利特】、update【阿普 dei 特】等。
DCL(Data Control【肯错欧】 Language【兰哥威治】)语句:
数据控制语句,用于控制不同数据段直接的许可和访问级别的语句。这些语句定义了数据库、表、字段、用户的访问权限和安全级别。主要的语句关键字包括grant【古亮普】、revoke【瑞 - 沃克】 等。
DQL(Data Query【葵尔伊】 Language【兰哥威治】)语句:
数据查询语句,用于从一个或多个表中检索信息。主要的语句关键字包括select【涩莱克特】
3、MySQL中如何求帮助
①亘古不变的官方文档(软件作用)
官方文档(MySQL5.7)
②man文档(工作作用)
man文档可用对mysql的一些基本工具以及后台命令求帮助,比如:
[root@mysql ~]# man mysql[root@mysql ~]# man mysqld[root@mysql ~]# man mysqldump【mysql-当普】③MySQL的命令行求帮助(主要针对SQL语句求帮助)
mysql> help;mysql> ?mysql> help create【克瑞特】【克瑞诶特】 table;根据内容进行查找帮助mysql> ? contentsmysql> help contentsYou asked for【fò】 help about help category: "Contents"for【fò】 more information【因弗梅申】, type 'help <item>', where <item> is one of the followingcategories: Account Management Administration Compound Statements【斯忒特门特】 Contents Data DeŨ nition Data Manipulation Data Types Functions Geographic Features Help Metadata Language Structure Plugins【普辣 京(白话)】 Procedures Storage Engines Table Maintenance Transactions User-DeŨ ned Functions Utility寻求账户管理的帮助(一级一级的向内查询)mysql> ? Account ManagementYou asked for【fò】 help about help category: "Account Management"for【fò】 more information【因弗梅申】, type 'help <item>', where <item> is one of the followingtopics: ALTER【奥-特】 USER create【克瑞特】 USER DROP【卓-普】 USER grant【古亮普】 RENAME【瑞-内姆】 USER REVOKE【瑞 - 沃克】 set【赛特】 PASSWORD【帕斯沃德】mysql> ? create【克瑞特】 USER4、SQL语句的基本操作
MySQL的内部结构
我们平常所说的MySQL,主要指的是MySQL数据库管理软件
- 一个MYsql DBMS可用同时存放多个数据库,在理论上一个就对应一个数据库。如博客项目blog数据库、商城项目shop数据库、微信项目数据库。
- 一个数据库中还可以同时包含多个数据表,而数据表才是真正用于存放数据的位置。(类似与我们office软件中的Excel表格),在理论上一个功能旧对应一个数据表。在博客系统中的用户管理功能,就需要一个USER数据表,博客中的文章就需要一个article【阿尔提扣】数据表、博客中的评论就需要个message【脉-西之】数据表。
- 一个数据表又可以拆分为多个字段,每个字段就是一个属性。
- 一个数据表中除了字段外,还有很多行,每一行都是一条完整的数据(记录)。
数据库的操作
①创建数据库
创建命令 mysql> create【克瑞特】数据库标识 mysql> database 【得塔-贝斯】基本语法:
mysql> create【克瑞特】 database【得塔-贝斯】 数据库名称;特别注意,在Mysql中,当一条SQL语句编写完毕后,一定要使用分号进行结尾,否则系统认为这条语句还没有借宿。
案例:创建数据库的相关案例
常见db1库create【克瑞特】 database【得塔-贝斯】 db1;mysql> create database db1;Query OK, 1 row affected (0.00 sec)
创建db2库并指定默认字符集create【克瑞特】 database【得塔-贝斯】 db2 default【迪-佛特】 charset【查赛特】 gbk;#mysql> create database db2 default charset gbk;#Query OK, 1 row affected (0.00 sec)
如果不存在(if not【nuō 特】 exists【伊贼斯】)create【克瑞特】 database【得塔-贝斯】 if not【nuō 特】 exists【伊贼斯】 db1 default【迪-佛特】 character【k 尔特】 set【赛特】 utf8;说明:不能创建相同名字的数据库#mysql> create database if not exists db1 default character set utf8;#Query OK, 1 row affected, 1 warning (0.00 sec)扩展:编码格式,常见的gbk(中国的编码格式)与utf8(国际通用的编码格式)
ANSI 瑞典 256字符 (abcd、1234、传统字符) 国内汉字无法通过256个字符进行描述,所以国内开发了自己的编码格式gb2312, 升级gbk 中国台湾开发了一套自己的编码格式big5 很多项目并不仅仅只在本地使用,也可能支持多国语言,标准化组织开发了一套通用编码utf8,后来5.6版本以后进行了升级utf8mb4
编写SQL语句是一个比较细致的工作,不建议大家直接在终端中输入SQL语句,可以先把你要写的SQL语句写入一个记事本中,然后拷贝执行。
②查询已创建数据库
显示=>show 【瘦】数据库=>database【得塔-贝斯】基本语法: 显示所有数据库
mysql > show【瘦】 databases【得塔-贝斯】;#mysql> show databases;#+--------------------+#| Database |#+--------------------+#| information【因弗梅申】_schema【斯基么】 |#| db1 |#| mysql |#| performance_schema【斯基么】 |#| sys |#+--------------------+#5 rows in set (0.00 sec)案例:显示某个数据库的数据结构
mysql> show【瘦】 create【克瑞特】 database【得塔-贝斯】 db1;#mysql> show create database db1;#+----------+-----------------------------------------------------------------+#| Database | Create Database |#+----------+-----------------------------------------------------------------+#| db1 | CREATE DATABASE `db1` /*!40100 DEFAULT CHARACTER SET utf8mb4 */ |#+----------+-----------------------------------------------------------------+#1 row in set (0.00 sec)③修改数据库信息
在Mysql5以后的版本中,Mysql不支持更改数据库的名称。我们所谓的修改数据主要修改的是数据库的编码格式。
修改=>alter【奥-特】数据库=>database【得塔-贝斯】基本语法:
mysql > alter【奥-特】 database【得塔-贝斯】 数据库名称 default【迪-佛特】 charset【查赛特】=编码格式;案例:把db3数据库的编码格式更改为gbk
mysql> alter【奥-特】 database【得塔-贝斯】 db3 default【迪-佛特】 charset【查赛特】=gbk;#mysql> alter database db3 default charset =gbk;#Query OK, 1 row affected (0.00 sec)④删除数据库
删除=>drop【卓-普】数据库=>database【得塔-贝斯】基本语法:
mysql> drop【卓-普】 databse【得塔-贝斯】 数据库名称;案例:删除db3数据库
mysql> drop【卓-普】 database【得塔-贝斯】 db3;
#mysql> drop database db3;#Query OK, 0 rows affected (0.00 sec)5、数据表的基本操作
①数据表的创建
创建=> create【克瑞特】数据表=>table【忒-部】基本语法:
mysql create【克瑞特】 table【忒-部】 数据表名称( 字段1 字段类型 【字段约束】, 字段2 字段类型 【字段约束】, ...);案例:创建一个admin管理表,拥有3个字段(编号、用户名称、用户密码)
mysql> create【克瑞特】 database【得塔-贝斯】 db_fq;#Query OK, 1 row affected (0.00 sec)
mysql> use db_fq;#Database changeduse在Mysql中的含义代表选择,use + 数据库名称相当于选择指定的数据库。 而且user比较特殊,其选择结束后,其尾部可以不加分号,;但是强烈建议所有的SQL语句都要加分号,养成一个号习惯
mysql> create【克瑞特】 TABLE【忒-部】 tb_admin( id TINYINT【泰尼因特】, username【U斯-内姆】 VARCHAR【瓦儿-查儿】(20), password【帕斯沃德】 CHAR【查尔】(32))engine【 嗯(ing) 京(白话读音) 】= innodb【伊诺 DB】 DEFAULT【迪-佛特】 charset【查赛特】=utf8;
#mysql> create table tb_admin(# -> id TINYINT,# -> username VARCHAR(20),# -> password CHAR(32)# -> )engine= innodb DEFAULT charset=utf8;#Query OK, 0 rows affected (0.45 sec)#mysql>tinyint【泰尼因特】:微整形,1个字节,范围-128
127,无符号型,则表示0255 标准字符串类型可以使用char【查尔】与varchar【瓦儿-查儿】,char【查尔】代表固定长度的字段,varchar【瓦儿-查儿】代表变化长度的字段
案例:创建一个article【阿尔提扣】文章表,用有4个字段(编号、标题、作者、内容)
mysql>use db_fq;mysql>create【克瑞特】 table【忒-部】 tb_article【tb_阿尔提扣】( id int【因特】, title【泰-头】 varchar【瓦儿-查儿】(50), author【奥涩】 varchar【瓦儿-查儿】(20), content【肯-腾特】 text【泰斯特】)engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;
#mysql> create table tb_article (# -> id int,# -> title varchar(50),# -> author varchar(20),# -> content text# -> )engine=innodb default charset=utf8;#Query OK, 0 rows affected (0.60 sec)text【泰斯特】:文本类型,一般情况下,用varchar存储不了的字符串信息,都建议使用text【泰斯特】文本进行处理 varchar【瓦儿-查儿】存储的最大长度,理论值是65535个字符。但是实际上,有几个字符是用于存放内容的长度的,所以真正可以使用的不足65535个字符,另外varchar【瓦儿-查儿】类型存储的字符长度还和编码格式有关。1个GBK格式的占用2个字符长度,1个UTF8格式的占用3个字符长度。GBK=65532
65533/2,UTF8=6553265533/3
②查询已创建数据表
显示=>show【瘦】数据包=>table【忒-部】显示所有数据表(当前数据库)
mysql > use 数据库名称;mysql > show【瘦】 tables【忒-部s】;#mysql> show tables;#+-----------------+#| Tables_in_db_fq |#+-----------------+#| tb_admin |#| tb_article |#+-----------------+#2 rows in set (0.00 sec)显示数据表的创建过程(编码格式、字段等信息)
mysql > show【瘦】 create【克瑞特】 table【忒-部】 数据表名称;#mysql> show create table tb_admin;#+----------#+-----------------------------------------------------------------------------------------------------------------------------------------------------------+#| Table | Create Table |#+----------+------------------------------------------------------------------------------------------------------------------------------------------------+#| tb_admin | CREATE TABLE `tb_admin` (# `id` tinyint(4) DEFAULT NULL,# `username` varchar(20) DEFAULT NULL,# `password` char(32) DEFAULT NULL#) ENGINE=InnoDB DEFAULT CHARSET=utf8 |#+----------+------------------------------------------------------------------------------------------------------------------------------------------------+#1 row in set (0.00 sec)
或mysql > desc 数据包名称;#mysql> desc tb_admin;#+----------+-------------+------+-----+---------+-------+#| Field | Type | Null | Key | Default | Extra |#+----------+-------------+------+-----+---------+-------+#| id | tinyint(4) | YES | | NULL | |#| username | varchar(20) | YES | | NULL | |#| password | char(32) | YES | | NULL | |#+----------+-------------+------+-----+---------+-------+#3 rows in set (0.00 sec)③修改数据表
Ⅰ数据表字段添加
修改=> alter【奥-特】数据表=>table【忒-部】基本语法:
mysql > alter【奥-特】 table【忒-部】 数据表名称 add 新字段名称 字段类型 first【佛斯特】|after【啊夫特】 其他字段名称;选项说明:first【佛斯特】:把新添加字段放在第一位after【啊夫特】 字段名称 :把新添加字段放在指定字段的后面案例:把tb_article【tb_阿尔提扣】文章表中添加一个addtime【艾德-泰姆】字段,类型为date(年-月-日)
mysql > alter【奥-特】 table【忒-部】 tb_article【tb_阿尔提扣】 add addtime【艾德-泰姆】 date【呆特】 after【啊夫特】 content【肯-腾特】;#mysql> alter table tb_article add addtime date after content;#Query OK, 0 rows affected (0.71 sec)#Records: 0 Duplicates: 0 Warnings: 0
mysql > desc tb_article【tb_阿尔提扣】;#mysql> desc tb_article;#+---------+-------------+------+-----+---------+-------+#| Field | Type | Null | Key | Default | Extra |#+---------+-------------+------+-----+---------+-------+#| id | int(11) | YES | | NULL | |#| title | varchar(50) | YES | | NULL | |#| author | varchar(20) | YES | | NULL | |#| content | text | YES | | NULL | |#| addtime | date | YES | | NULL | |#+---------+-------------+------+-----+---------+-------+#5 rows in set (0.00 sec)Ⅱ修改字段名称或字段类型
修改字段名称与字段类型(也可以只修改名称)
mysql > alter【奥-特】 table【忒-部】 tb_admin change【趁(chèn)吉】 username【U斯-内姆】 user【U斯】 varchar【瓦儿-查儿(20);#mysql> alter table tb_admin change username user varchar(20); #把username改为user#Query OK, 0 rows affected (0.13 sec)#Records: 0 Duplicates: 0 Warnings: 0
mysql > desc tb_admin;#mysql> desc tb_admin;#+----------+-------------+------+-----+---------+-------+#| Field | Type | Null | Key | Default | Extra |#+----------+-------------+------+-----+---------+-------+#| id | tinyint(4) | YES | | NULL | |#| user | varchar(20) | YES | | NULL | |#| password | char(32) | YES | | NULL | |#+----------+-------------+------+-----+---------+-------+#3 rows in set (0.00 sec)仅修改字段的类型
mysql > alter【奥-特】 table【忒-部】 tb_admin modify【莫迪fái】 user【U斯】 varchar【瓦儿-查儿(40);#mysql> alter table tb_admin modify user varchar(40); #varchar(20)改为varchar(40)#Query OK, 0 rows affected (0.05 sec)#Records: 0 Duplicates: 0 Warnings: 0
mysql > desc tb_admin;#mysql> desc tb_admin;#+----------+-------------+------+-----+---------+-------+#| Field | Type | Null | Key | Default | Extra |#+----------+-------------+------+-----+---------+-------+#| id | tinyint(4) | YES | | NULL | |#| user | varchar(40) | YES | | NULL | |#| password | char(32) | YES | | NULL | |#+----------+-------------+------+-----+---------+-------+#3 rows in set (0.00 sec)Ⅲ删除某个字段
#mysql> desc tb_article;#+---------+-------------+------+-----+---------+-------+#| Field | Type | Null | Key | Default | Extra |#+---------+-------------+------+-----+---------+-------+#| id | int(11) | YES | | NULL | |#| title | varchar(50) | YES | | NULL | |#| author | varchar(20) | YES | | NULL | |#| content | text | YES | | NULL | |#| addtime | date | YES | | NULL | |#+---------+-------------+------+-----+---------+-------+#5 rows in set (0.00 sec)
mysql > alter【奥-特】 table【忒-部】 tb_article【tb_阿尔提扣】 drop【卓-普】 字段名称;#mysql> alter table tb_article drop addtime;#Query OK, 0 rows affected (0.56 sec)#Records: 0 Duplicates: 0 Warnings: 0
mysql > desc tb_article【tb_阿尔提扣】;#mysql> desc tb_article;#+---------+-------------+------+-----+---------+-------+#| Field | Type | Null | Key | Default | Extra |#+---------+-------------+------+-----+---------+-------+#| id | int(11) | YES | | NULL | |#| title | varchar(50) | YES | | NULL | |#| author | varchar(20) | YES | | NULL | |#| content | text | YES | | NULL | |#+---------+-------------+------+-----+---------+-------+#4 rows in set (0.00 sec)Ⅳ修改数据表引擎
#mysql> show【瘦】 create table tb_article;#+------------+----------------------------------------------------------------------------------------------------------------------------------------------+#| Table | Create Table #|#+------------+----------------------------------------------------------------------------------------------------------------------------------------------+#| tb_article | CREATE TABLE `tb_article` (# `id` int(11) DEFAULT NULL,# `title` varchar(50) DEFAULT NULL,# `author` varchar(20) DEFAULT NULL,# `content` text#) ENGINE=InnoDB DEFAULT CHARSET=utf8 |#+------------+----------------------------------------------------------------------------------------------------------------------------------------------+#1 row in set (0.00 sec)mysql > alter【奥-特】 table【忒-部】 tb_article【tb_阿尔提扣】 engine【 嗯(ing) 京(白话读音) 】=myisam【迈-艾塞姆】;#mysql> alter table tb_article engine=myisam【迈-艾塞姆】;#Query OK, 0 rows affected (0.40 sec)#Records: 0 Duplicates: 0 Warnings: 0
mysql > show【瘦】 create【克瑞特】 table【忒-部】 tb_article【tb_阿尔提扣】;#mysql> show create table tb_article;#+------------+----------------------------------------------------------------------------------------------------------------------------------------------+#| Table | Create Table #|#+------------+----------------------------------------------------------------------------------------------------------------------------------------------+#| tb_article | CREATE TABLE `tb_article` (# `id` int(11) DEFAULT NULL,# `title` varchar(50) DEFAULT NULL,# `author` varchar(20) DEFAULT NULL,# `content` text#) ENGINE=MyISAM DEFAULT CHARSET=utf8 |#+------------+----------------------------------------------------------------------------------------------------------------------------------------------+#1 row in set (0.00 sec)Ⅴ修改数据表的编码格式
#mysql> show【瘦】 create table tb_admin;#+----------+------------------------------------------------------------------------------------------------------------------------------------------------+#| Table | Create Table #|#+----------+------------------------------------------------------------------------------------------------------------------------------------------------+#| tb_admin | CREATE TABLE `tb_admin` (# `id` tinyint(4) DEFAULT NULL,# `user` varchar(20) DEFAULT NULL,# `password` char(32) DEFAULT NULL#) ENGINE=InnoDB DEFAULT CHARSET=utf8 |#+----------+------------------------------------------------------------------------------------------------------------------------------------------------+#1 row in set (0.00 sec)
mysql > alter【奥-特】 table【忒-部】 tb_admin default【迪-佛特】 charset【查赛特】=gbk;#mysql> alter table tb_admin default charset=gbk;#Query OK, 0 rows affected (0.05 sec)#Records: 0 Duplicates: 0 Warnings: 0
mysql > show【瘦】 create【克瑞特】 table【忒-部】 tb_admin;#mysql> show create table tb_admin;#+----------+------------------------------------------------------------------------------------------------------------------------------------------------+#| Table | Create Table #|#+----------+------------------------------------------------------------------------------------------------------------------------------------------------+#| tb_admin | CREATE TABLE `tb_admin` (# `id` tinyint(4) DEFAULT NULL,# `user` varchar(20) DEFAULT NULL,# `password` char(32) DEFAULT NULL#) ENGINE=InnoDB DEFAULT CHARSET=gbk |#+----------+------------------------------------------------------------------------------------------------------------------------------------------------+#1 row in set (0.00 sec)Ⅵ修改数据表名称(把tb_article【tb_阿尔提扣】更改为tb_news【牛斯】)
修改数据表名称#mysql> show tables;#+-----------------+#| Tables_in_db_fq |#+-----------------+#| tb_admin |#| tb_article |#+-----------------+#2 rows in set (0.00 sec)mysql > rename【瑞-内姆】 table【忒-部】 tb_article【tb_阿尔提扣】 to tb_news【牛斯】:#mysql> rename【瑞-内姆】 table tb_article to tb_news;#Query OK, 0 rows affected (0.00 sec)
mysql > show【瘦】 tables【忒-部s】;#mysql> show tables;#+-----------------+#| Tables_in_db_fq |#+-----------------+#| tb_admin |#| tb_news |#+-----------------+#2 rows in set (0.00 sec)
重命名的同时移动数据表到指定的数据表(了解)mysql > create【克瑞特】 database【得塔-贝斯】 db_it#mysql> create database db_it; #创建db_it数据库#Query OK, 1 row affected (0.00 sec)
mysql > rename【瑞-内姆】 table【忒-部】 db_fq.tb_news【牛斯】 to db_it.tb_article【tb_阿尔提扣】;#mysql> rename【瑞-内姆】 table db_fq.tb_news to db_it.tb_article; #剪切db_fq数据库的tb_news表 到 db_it数据库,命令为tb_article#Query OK, 0 rows affected (0.00 sec)④删除数据表
删除=>drop【卓-普】数据表=>table【忒-部】基本语法
mysql > drop【卓-普】 table【忒-部】 数据表名称;#mysql> use db_it;#Database changed#mysql> show tables;#+-----------------+#| Tables_in_db_it |#+-----------------+#| tb_article |#+-----------------+#1 row in set (0.00 sec)
#mysql> drop table tb_article;#Query OK, 0 rows affected (0.00 sec)
#mysql> show tables;#Empty set (0.00 sec)6、数据的增删改查(重点)
增加:insert【因涩特】删除:delete【迪利特】修改:update【阿普 dei 特】查询:select【涩莱克特】①数据的增加操作
基本语法:
mysql > insert【因涩特】 into【因兔】 数据表名称([]字段1,字段2,字段3....) values【挖柳斯】(字段1的值,字段2的值,字段3的值...);特别注意:在SQL语句中,除了数字,其他类型的值,都需要使用引号引起来,否则插入时会报错
第一步:准备数据表
mysql > use db_fq;#mysql> use db_fq;#Database changedmysql > create【克瑞特】 table【忒-部】 tb_user【U斯】( id int【因特】, username【U斯-内姆】 varchar【瓦儿-查儿】(20), age【诶吉】 tinyint【泰尼因特】 unsigned【安赛因德】, gender【间德尔】 enum【ing纽某】('男','女','保密'), address【额拽斯】 varchar【瓦儿-查儿(255))engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;#mysql> create table tb_user(# -> id int,# -> username varchar(20),# -> age tinyint unsigned,# -> gender enum('男','女','保密'),# -> address varchar(255)# -> )engine=innodb default charset=utf8;#Query OK, 0 rows affected (0.34 sec)unsigned【安赛因德】代表无符号型,只有0到正数。tinyint【泰尼因特】 unsigned【安赛因德】无符号型,范围0~255 enum【ing纽某】【硬南姆】枚举类型,多选一。只能从给定的值选择一个
第二步:使用insert【因涩特】语句插入数据
mysql > insert【因涩特】 into【因兔】 tb_user【U斯】 values【挖柳斯】 (1,'李明',24,'男','湖北省武汉市');#mysql> insert into tb_user values (1,'李明',24,'男','湖北省武汉市');#Query OK, 1 row affected (0.05 sec)mysql > insert【因涩特】 into【因兔】 tb_user【U斯】(id,username【U斯-内姆】,age【诶吉】) values【挖柳斯】 (2,'马飞',23);#mysql> insert into tb_user(id,username,age) values (2,'马飞',23);#Query OK, 1 row affected (0.06 sec)②数据的查询操作
基本语法:
mysql > select【涩莱克特】 * from【弗乱】 数据表名称 [where【威尔】 查询条件];mysql > select【涩莱克特】 id,username【U斯-内姆】.age【诶吉】 from【弗乱】 数据表名称 [where【威尔】 查询条件];案例:查询tb_user【U斯】表中所有的记录
mysql > select【涩莱克特】 * from【弗乱】 tb_user【U斯】;#mysql> select * from tb_user;#+------+----------+------+--------+--------------------+#| id | username | age | gender | address |#+------+----------+------+--------+--------------------+#| 1 | 李明 | 24 | 男 | 湖北省武汉市 |#| 2 | 马飞 | 23 | NULL | NULL |#+------+----------+------+--------+--------------------+#2 rows in set (0.00 sec)案例:查询tb_user【U斯】表中的id,username【U斯-内姆】以及age【诶吉】字段中对应的数据信息
mysql > select【涩莱克特】 id,username【U斯-内姆】,age【诶吉】 from【弗乱】 tb_user【U斯】;#mysql> select id,username,age from tb_user;#+------+----------+------+#| id | username | age |#+------+----------+------+#| 1 | 李明 | 24 |#| 2 | 马飞 | 23 |#+------+----------+------+#2 rows in set (0.01 sec)案例:只查询id=2的小伙伴信息
mysql > select【涩莱克特】 * from【弗乱】 tb_user【U斯】 where【威尔】 id=2;#mysql> select * from tb_user where id=2;#+------+----------+------+--------+---------+#| id | username | age | gender | address |#+------+----------+------+--------+---------+#| 2 | 马飞 | 23 | NULL | NULL |#+------+----------+------+--------+---------+#1 row in set (0.00 sec)案例:查询年龄大于23岁的小伙伴信息
mysql > select【涩莱克特】 * from【弗乱】 tb_user【U斯】 where【威尔】 age【诶吉】>23;#mysql> select * from tb_user where age >23;#+------+----------+------+--------+--------------------+#| id | username | age | gender | address |#+------+----------+------+--------+--------------------+#| 1 | 李明 | 24 | 男 | 湖北省武汉市 |#+------+----------+------+--------+--------------------+#1 row in set (0.00 sec)③数据的修改操作
基本语法:
mysql > update【阿普 dei 特】 数据表名称 set【赛特】 字段1=更新后的值,字段2=更新后的值,... where【威尔】 更新条件;特别说明:如果在更新数据时,不指定更新条件,则其会把这个数据表的所有记录全部更新一遍。
案例:修改username【U斯-内姆】=‘马飞’这条记录,将其性别更新为男,家庭住址更新为广东省深圳市
mysql > update【阿普 dei 特】 tb_user【U斯】 set【赛特】 gender【间德尔】='男',address【额拽斯】='广东省深圳市' where【威尔】 username【U斯-内姆】='马飞';#mysql> update tb_user set gender='男',address='广东省深圳市' where username='马飞';#Query OK, 1 row affected (0.04 sec)#Rows matched: 1 Changed: 1 Warnings: 0案例:今年是2023年,假设到了2024年,现在所存储的学生信息年龄都差一岁,需要整体进行一次更新
mysql > update【阿普 dei 特】 tb_user【U斯】 set【赛特】 age【诶吉】=age【诶吉】+1;#mysql> update tb_user set age=age+1;#Query OK, 2 rows affected (0.05 sec)#Rows matched: 2 Changed: 2 Warnings: 0④数据的删除操作
基本语法:
mysql > delete【迪利特】 from【弗乱】 数据表名称 [where【威尔】 删除条件];案例:删除tb_user【U斯】表中,id=1的用户信息
mysql > delete【迪利特】 from【弗乱】 tb_user【U斯】 where【威尔】 id=1;#mysql> delete【迪 利 特】from tb_user where id=1;#Query OK, 1 row affected (0.07 sec)delete【迪利特】 from【弗乱】与truncate【创kí特】清空数据表操作
mysql > delete【迪利特】 from【弗乱】 数据表;#mysql> delete【迪 利 特】from tb_user;#Query OK, 1 row affected (0.05 sec)
或mysql > truncate【创kí特】 数据表;#mysql> truncate tb_user;#Query OK, 0 rows affected (0.26 sec)- delete【迪利特】 from【弗乱】与truncate【创kí特】区别在哪里?
- delete【迪利特】:删除数据记录 数据操作语言(DML) 在事务控制里,DML要么commit【肯米特】,要么rollback【柔拜克】 删除大量记录速度慢,只删除数据部回收高水位线 可以带条件删除
- truncate【创kí特】:删除所有数据记录 数据定义语言(DDL) 不在事务控制里,DDL语句执行前会提交前面所有未提交的事务 清理大量数据速度快,回收高水位线 不能带条件删除
7、自动增长(水位线)与主键约束
①自动增长(对某个字段进行自动编号)
mysql > create【克瑞特】 table【忒-部】 tb_user【U斯】( id int【因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, username【U斯-内姆】 varchar【瓦儿-查儿】(20), age【诶吉】 tinyint【泰尼因特】 unsigned【安赛因德】, gender【间德尔】 enum【ing纽某】('男','女','保密'), address【额拽斯】 varchar【瓦儿-查儿(255))engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;#mysql> create table tb_user(# -> id int not null auto_increment,# -> username varchar(20),# -> age tinyint unsigned,# -> gender enum('男','女','保密'),# -> address varchar(255)# -> )engine=innodb default charset=utf8;#ERROR 1075 (42000): Incorrect table definition; there can be only one auto column and it must be defined as a key#这个错误 ERROR 1075 (42000): Incorrect table definition; there can be only one auto column and it must be defined as a key 表示在表定义中,MySQL 要求自增列(auto_increment 修饰的列)只能有一个,并且必须将其定义为键(通常是主键)not null【nò】代表非空约束,这个字段只要是插入数据就必须要有值
②主键约束(非空、唯一)
mysql >create【克瑞特】 table【忒-部】 tb_user【U斯】( id int【因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, username【U斯-内姆】 varchar【瓦儿-查儿】(20), age【诶吉】 tinyint【泰尼因特】 unsigned【安赛因德】, gender【间德尔】 enum【ing纽某】('男','女','保密'), address【额拽斯】 varchar【瓦儿-查儿(255), primary key(id)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;#mysql> create table tb_user(# -> id int not null auto_increment,# -> username varchar(20),# -> age tinyint unsigned,# -> gender enum('男','女','保密'),# -> address varchar(255),# -> primary key(id)# -> ) engine=innodb default charset=utf8;#Query OK, 0 rows affected (0.34 sec)插入数据时,id位置直接写NULL【nò】即可
mysql > insert【因涩特】 into【因兔】 tb_user【U斯】 values【挖柳斯】 (null【nò】,'李明',24,'男','湖北省武汉市');#mysql> insert into tb_user values (null,'李明',24,'男','湖北省武汉市');#Query OK, 1 row affected (0.05 sec)
mysql > insert【因涩特】 into【因兔】 tb_user【U斯】 values【挖柳斯】 (null【nò】,'马飞',23,'男','广东省深圳市');#mysql> insert into tb_user values (null,'马飞',23,'男','广东省深圳市');#Query OK, 1 row affected (0.06 sec)
mysql > insert【因涩特】 into【因兔】 tb_user【U斯】 values【挖柳斯】 (null【nò】,'李淑',18,'女','浙江省杭州市');#mysql> insert into tb_user values (null,'李淑',18,'女','浙江省杭州市');#Query OK, 1 row affected (0.06 sec)day03-MySQL的基本SQL语句(下)
一、常见的数据类型
1、回顾数据表的创建语法
基本语法:
mysql > create【克瑞特】 table【忒-部】 数据表名称(字段名称1 字段类型 字段约束字段名称1 字段类型 字段约束...primary【普赖莫瑞】 key【发音'ki'】(主键字段 => 不能为空、必须唯一))engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;-
经验:一般情况下,我们在设计数据表时,必须拥有一个id主键字段,非空,自动编号,主键约束
-
在创建数据表时,必须明确指定字段的名称以及字段的类型,那到底Mysql中的SQL语句支持哪些字段类型呢?
参考下图
2、数值类型
⭐整数类型(整数、精准)
- 应用场景:人的年龄、考试成绩等等相关的信息都可以使用整数类型进行存储,那整数类型有这么多的形式,我应该选择哪一个呢?
答:整数类型的选择主要取决于数值的范围
- 比如存储中国的人口类型,可以用INT【因特】类型或者BIGINT【比格因特】类型,但是在数据库设计原则中,不是越大越好,而是正好满足条件即可。
案例:设计一个数据表如tb_student【tb_斯丢等特】学生表(id,username【U斯-内姆】,age【诶吉】,mobile【抹拜儿】)
mysql > use 数据库名称;MySQL > create【克瑞特】 table【忒-部】 tb_student【tb_斯丢等特】(id mediumint【咪迪厄姆-因特】 unsigned【安赛因德】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】,username【U斯-内姆】 varchar【瓦儿-查儿】(20),age【诶吉】 tinyint【泰尼因特】 unsigned【安赛因德】,mobile【抹拜儿】 char【查尔】(11),primary【普赖莫瑞】 key【发音'ki'】(id)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;# create table tb_student(# id mediumint unsigned not null auto_increment,# username varchar(20),# age tinyint unsigned,# mobile char(11),# primary key (id)# ) engine=innodb default charset=utf8;⭐小数类型(浮点类型、定点类型)
①浮点类型(近似值)
FLOAT【弗洛特】和DOUBLE【答步】
- float【弗洛特】和double【答步】类型代表近似数字数据值。Mysql对于单精度值使用四个字节,对于双精度值使用八个字节。FLOAT【弗洛特】单精度浮点数精确到7位小数,double【答步】双精度浮点数精确道大约15位小数。float【弗洛特】类型会随着数值的增大精度会减小
举例:
- FLOAT【弗洛特】(M,D),M表示存储的有效位数,D代表小数点后面的位数;即整数位数+小数部分不能超过M值。
column【科勒姆】1 FLOAT【弗洛特】(7,4)
- 如果插入一个999.00009到column【科勒姆】1列,那么mysql在存储时会四舍五入变为999.0001插入
- DOUBLE【答步】(7,4):DOUBLE【答步】类型的使用与FLOAT【弗洛特】类型完全一致,唯一的区别就是占用字节不同浮点数的精度有所不同。
②定点类型(精确值)
decimal【戴希莫】和NUMERIC【纽麦一克】
- decimal【戴希莫】E和NUMERIC【纽麦一克】类型的存储精确的数值数据。使用这些类型时,重要的是要保留精确的精度,例如使用货币数据。
举例说明:
salary【晒了瑞】 decimal【戴希莫】(5,2)
在上面的例子中,薪水字段的类型为decimal【戴希莫】,表示精确的数字。其中,5代表精度,2代表刻度。精度表示数值存储的有效位数,刻度表示小数点后面可存储的位数。decimal【戴希莫】(5,2)能够存储五位数和两位小数的任何值,因此可以存储在salary【晒了瑞】 列中的值的范围-999.99是 999.99
特殊注意:decimal【戴希莫】(M)和decimal【戴希莫】(M,0)是相等的,存储长度取决于M的值,默认情况下M值为10.刻度为0表示没有小数。案例:定义一个职员表tb_staff【tb_斯戴夫】,定义字段(id,username【U斯-内姆】,salary【晒了瑞】,addtime【艾德泰姆】)
mysql > use db_fq;mysql > create【克瑞特】 table【忒-部】 tb_staff【tb_斯戴夫】 ( id smallint【斯莫尔因特】 unsigned【安赛因德】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, username【U斯-内姆】 varchar【瓦儿-查儿】(20), salary【晒了瑞】 decimal【戴希莫】(11,2), addtime【艾德泰姆】 date【得塔】 , primary【普赖莫瑞】 key【发音'ki'】(id)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;# mysql> create table tb_staff(# id smallint unsigned not null auto_increment,# username varchar(20),# salary decimal(11,2),# addtime date,# primary key(id)# )engine=innodb default charset=utf8;3、字符串类型
⭐CHAR【查尔】类型
- CHAR【查尔】类型的字符串为定长,长度范围是0到255之间的任何值,占用定长的存储空间,不足的部分用空格填充;读取时删掉后面的空格。
password【帕斯沃德】 char【查尔】 (32)username【U斯-内姆】 (10)①存储空间
- CHAR【查尔】(M)类型的存储空间和字符集有关系,一个中文在utf8字符集中占用3个bytes、gbk占用2个bytes、数字和字符统一用一个字符表示。
②存储机制
- 在不够M长度时,Mysq老在存储数据时,需要填充特殊的空格
③举例说明
-
字段名称 CHAR【查尔】(M),M表示字符数
-
应用场景:加密后的密码=>char【查尔】(32),手机号码mobile【抹拜儿】(11),身份证号码等待
案例:创建一个tb_admin数据表,定义字段(id,username【U斯-内姆】,password【帕斯沃德】)
mysql > use db_fq;mysql > create【克瑞特】 table【忒-部】 tb_admin( id tinyint【泰尼因特】 unsigned【安赛因德】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, username【U斯-内姆】 varchar【瓦儿-查儿】(10), password【帕斯沃德】 char【查尔】(32), primary【普赖莫瑞】 key【发音'ki'】(id)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;⭐varchar【瓦儿-查儿】类型
varchar【瓦儿-查儿】是变长存储,仅使用必要的存储空间name varchar【瓦儿-查儿】(10)①存储空间
- varchar【瓦儿-查儿】(M)类型的存储空间和字符集有关,一个中文在utf8中占用3各bytes、gbk占用2各bytes、数字和字符用一个字符表示
②存储机制
- varchar【瓦儿-查儿】(M)字段存储实际是从第二个字节开始存储,然后用1到2各字节表示实际长度,剩下的才是可以存储数据的范围,因为最大可用存储范围是65535-3=65532字节;
- 第一个字节标识是否为空(长度小于255字节,使用一个字节来表示长度;大于255字节使用两个字节来表示长度)。
- 应用场景:主要适合存储长度不固定的字符串信息,入用户名称、产品标题、新闻标题、新闻描述(不超过255个字符)
案例:创建一个tb_news【纽斯】数据表,定义段(id、title【泰头】、description【迪斯克瑞普申】、addtime【艾德泰姆】)
mysql > use db_fq;mysql > create【克瑞特】 table【忒-部】 tb_news【纽斯】( id int【因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, title【泰头】 varchar【瓦儿-查儿】(80), description【迪斯克瑞普申】 varchar【瓦儿-查儿】(255), addtime【艾德泰姆】 date【呆特】 , primary【普赖莫瑞】 key【发音'ki'】(id))engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;⭐TEXT【泰斯特】类型
- TEXT【泰斯特】代表的是文本类型的数据,当我们使用varchar【瓦儿-查儿】类型存储数据时(早期最大只能存储255个字符,mysql5版本中,gbk可用存储3万多个字符,utf格式可用存储2万多个字符),如果超过了varchar【瓦儿-查儿】的最大存储范围,则可以考虑使用TEXT【泰斯特】文本类型
经验之谈:255个字符以内(包括),定长就使用CHAR【查尔】类型,变长就使用varchar【瓦儿-查儿】类型,如果超过了255个字符,则使用TEXT【泰斯特】文本类型
应用场景:文本内容、产品的详细介绍等
案例:创建一个tb_goods【故兹】产品表、定义字段(id、name、price【普莱斯】、content)
mysql > use db_fq;mysql > create【克瑞特】 table【忒-部】 tb_goods【故兹】( id int【因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, name varchar【瓦儿-查儿】(80), price【普莱斯】 decimal【戴希莫】(11,2), content text【泰斯特】, primary【普赖莫瑞】 key【发音'ki'】(id))engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;⭐其他类型
BLOB【拉布】:保存二进制的大型数据(字符串),没有字符集,eg:图片、音频、视频等
实际的运维工作中,很少将文件之间保存在数据库端,一般文件的存储都是基于路径操作
- ENUM【伊牛姆】枚举类型:多选一,从给定的多个选择中选择一个,如 gender【詹德尔】【詹德尔】 enum【伊牛姆】(‘男’,‘女’,‘保密’)
- SET【赛特】集合类型:多选多,从给定的多个选项中选中多个,如hobby【合比】 set【赛特】(‘吃饭’,‘睡觉’,‘看书’)
4、日期时间类型
经验:时间的选择比较简单,主要看你需要的时间格式,是年月日、小时分钟秒等等
㈠ DATE【呆特】类型(年-月-日)
The date type is used for【fò】 values【挖柳斯】 with【威付】 a date part but no time part. MySQL retrieves and displays date values【挖柳斯】 in ‘YYYY-MM-DD’ format. The supported【瑟破踢的】 range is ‘1000-01-01’ to ‘9999-12-31’ .
㈡ DATE【呆特】TIME(年月日小时分钟秒)
The DATETIME【dei 特泰姆】 type is used for【fò】 values【挖柳斯】 that contain both date and time parts. MySQL retrieves and displays DATETIME 【dei 特泰姆】 values【挖柳斯】 in ‘YYYY-MM-DD-HH:MM
DATETIME【dei 特泰姆】范围相对于TIMESTAMP【泰姆斯当普】范围更广,1000-01-01 00:00:00'` to `'9999-12-31 23:59:59'`㈢ TIMESTAMP【泰姆斯当普】(年月日小时分钟秒)
The TIMESTAMP data type is used for【fò】 values【挖柳斯】 that contain both date and time parts. TIMESTAMP has a range
TIMESTAMP【泰姆斯当普】选项如果不插入时间,则MYSQL会自动调用系统时间写入数据㈣ TIME(小时:分钟:秒)
MySQL retrieves and displays TIME values【挖柳斯】 in ‘HH:MM
- 说明:小时部分可以是这么大,因为可以使用TIME类型不仅代表一个时间(必须小于24小时),而且可以表示运行时间或两个事件之间的时间间隔(可能大于24小时,甚至负数)。
注意:
- TIME这一列如果存储缩写,需要注意mysql的解释方式。无效的时间值会被转换成’00:00:00’ 。
㈤ YEAR
YEAR(4) and YEAR(2) diƊer in display format, but have the same range of values. For 4-digit format, MySQL displays YEAR values【挖柳斯】 in YYYY format, with【威付】 a range of 1901 to 2155 , or 0000 . For 2-digit format, MySQL displays only the last two (least signiŨcant) digits; for example, 70 (1970 or 2070) or 69 (2069).
无效的值将会被转换成’0000’.
案例:编写tb_article【阿踢扣】文章表,定义字段(id、title【泰头】、description【迪斯克瑞普申】、addtime【艾德泰姆】)
mysql > use db_fq:
mysql > create【克瑞特】 table【忒-部】 tb_article1【阿踢扣】( id int【因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, title【泰头】 varchar【瓦儿-查儿】(80), description【迪斯克瑞普申】 varchar【瓦儿-查儿】(255), addtime【艾德泰姆】 datetime【dei 特-泰姆】, primary【普赖莫瑞】 key【发音'ki'】(id))engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;
mysql > create【克瑞特】 table【忒-部】 tb_article2【阿踢扣】( id int【因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, title【泰头】 varchar【瓦儿-查儿】(80), description【迪斯克瑞普申】 varchar【瓦儿-查儿】(255), addtime【艾德泰姆】 timestamp【泰姆斯当普】, primary【普赖莫瑞】 key【发音'ki'】(id))engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;
mysql > insert【因涩特】 into【因兔】 tb_article【阿踢扣】1 values【挖柳斯】 (null【nò】,'mysql你好','mysql很好用',null【nò】);
mysql > insert【因涩特】 into【因兔】 tb_article【阿踢扣】2 values【挖柳斯】 (null【nò】,'mysql你好','mysql很好用',null【nò】);二、SQL查询语句(重点)
1、回顾SQL查询语句
基本语法:
mysql > select【涩莱克特】 */字段列表 from【弗乱】 数据表名称 where【威尔】 查询条件;2、SQL查询五子句
基本语法:
mysql > select【涩莱克特】 */字段列表 from【弗乱】 数据表名称 where【威尔】 子句 group【格鲁普】 by【拜】 子句 having【嗨夫营】 子句 order【欧朵】 by【拜】 子句 limit【肋梅特】 子句;①where【威尔】 子句 ②group【格鲁普】 by【拜】子句 ③having【嗨夫营】子句 ④order【欧朵】 by【拜】子句 ⑤limit【肋梅特】子句
特别注意:五子句的顺序是固定的,不能颠倒
3、WHERE【威尔】 子句
| 符号 | 说明 |
|---|---|
| % | 匹配0个或任意多个字符 |
| _(下划线) | 匹配单个字符 |
| like【赖特】 | 模糊匹配 |
| = | 等于,精确匹配 |
| > | 大于 |
| < | 小于 |
| >= | 大于等于 |
| <= | 小于等于 |
| !=和<> | 不等于 |
| ! 和 not【nuō 特】 | 逻辑非 |
| || 和 or | 逻辑或 |
| && 和 and | 逻辑与 |
| between【B豚ing】…and… | 两者之间 |
| in (…) | 在… |
| not【nuō 特】 in (…) | 不在 |
准备测试数据
mysql > use db_fq;mysql > create【克瑞特】 table【忒-部】 tb_student【tb_斯丢等特】( id mediumint【咪迪厄姆-因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, name varchar【瓦儿-查儿】(20), age【诶吉】 tinyint【泰尼因特】 unsigned【安赛因德】 default【迪-佛特】 0, gender【詹德尔】 enum【伊牛姆】('男','女'), address【额拽斯】 varchar【瓦儿-查儿】(255), primary【普赖莫瑞】 key【发音'ki'】(id)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;#插入测试数据mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'刘备',33,'男','湖北省武汉市');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'貂蝉',18,'女','湖南省长沙市');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'关羽',31,'男','湖北省荆州市');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'大桥',20,'女','浙江省杭州市');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'赵云',25,'男','河北省石家庄市');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'小桥',18,'女','江苏省扬州市');案例:使用like【赖特】模糊查询语句,查询姓”关” 的同学信息
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 where【威尔】 name like【赖特】 '关%';# mysql> select * from tb_student where name like '关%';# +----+--------+------+--------+--------------------+# | id | name | age | gender | address |# +----+--------+------+--------+--------------------+# | 3 | 关羽 | 31 | 男 | 湖北省荆州市 |# +----+--------+------+--------+--------------------+# 1 row in set (0.00 sec)like【赖特】模糊查询,有点类似于管道命令中的数据检索。有两个关键字:%和_,%百分号代表任意个任意字符,下划线代表任意的某个字符(只能匹配一个)
案例:like【赖特】模糊查询语句,查询名字中带”蝉”字的同学信息
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 where【威尔】 name like【赖特】 '%蝉%';# mysql> select * from tb_student where name like '%蝉%';# +----+--------+------+--------+--------------------+# | id | name | age | gender | address |# +----+--------+------+--------+--------------------+# | 2 | 貂蝉 | 18 | 女 | 湖南省长沙市 |# +----+--------+------+--------+--------------------+# 1 row in set (0.00 sec)案例:like【赖特】模糊查询语句,查询云字结尾且名字为两个字的同学信息
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 where【威尔】 name like【赖特】 '_云';# mysql> select * from tb_student where name like '_云';# +----+--------+------+--------+-----------------------+# | id | name | age | gender | address |# +----+--------+------+--------+-----------------------+# | 5 | 赵云 | 25 | 男 | 河北省石家庄市 |# +----+--------+------+--------+-----------------------+# 1 row in set (0.00 sec)案例:获取学生表中,id编号为3的同学信息
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 where【威尔】 id=3;# mysql> select * from tb_student where id=3;# +----+--------+------+--------+--------------------+# | id | name | age | gender | address |# +----+--------+------+--------+--------------------+# | 3 | 关羽 | 31 | 男 | 湖北省荆州市 |# +----+--------+------+--------+--------------------+# 1 row in set (0.00 sec)案例:获取年龄大于25周岁的同学信息
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 where【威尔】 age【诶吉】>25;# mysql> select * from tb_student where age >25;# +----+--------+------+--------+--------------------+# | id | name | age | gender | address |# +----+--------+------+--------+--------------------+# | 1 | 刘备 | 33 | 男 | 湖北省武汉市 |# | 3 | 关羽 | 31 | 男 | 湖北省荆州市 |# +----+--------+------+--------+--------------------+# 2 rows in set (0.00 sec)案例:获取学生表中,性别不为男的同学信息(获取女同学的信息)
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 where【威尔】 gender【詹德尔】<>'男';# mysql> select * from tb_student where gender <>'男';# +----+--------+------+--------+--------------------+# | id | name | age | gender | address |# +----+--------+------+--------+--------------------+# | 2 | 貂蝉 | 18 | 女 | 湖南省长沙市 |# | 4 | 大桥 | 20 | 女 | 浙江省杭州市 |# | 6 | 小乔 | 18 | 女 | 江苏省扬州市 |# +----+--------+------+--------+--------------------+# 3 rows in set (0.00 sec)
#mysql> select * from tb_student where gender !='男';#+----+--------+------+--------+--------------------+#| id | name | age | gender | address |#+----+--------+------+--------+--------------------+#| 2 | 貂蝉 | 18 | 女 | 湖南省长沙市 |#| 4 | 大桥 | 20 | 女 | 浙江省杭州市 |#| 6 | 小乔 | 18 | 女 | 江苏省扬州市 |#+----+--------+------+--------+--------------------+#3 rows in set (0.00 sec)案例:获取班级中年龄大于30岁的男同学信息
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 where【威尔】 age【诶吉】>30 && gender【詹德尔】='男';#mysql> select * from tb_student where age>30 and gender='男';#+----+--------+------+--------+--------------------+#| id | name | age | gender | address |#+----+--------+------+--------+--------------------+#| 1 | 刘备 | 33 | 男 | 湖北省武汉市 |#| 3 | 关羽 | 31 | 男 | 湖北省荆州市 |#+----+--------+------+--------+--------------------+#2 rows in set (0.00 sec)
#mysql> select * from tb_student where age>30 && gender='男';#+----+--------+------+--------+--------------------+#| id | name | age | gender | address |#+----+--------+------+--------+--------------------+#| 1 | 刘备 | 33 | 男 | 湖北省武汉市 |#| 3 | 关羽 | 31 | 男 | 湖北省荆州市 |#+----+--------+------+--------+--------------------+#2 rows in set (0.00 sec)案例:获取id值为1、3、5的同学信息
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 where【威尔】 id=1 or id=3 or id=5;# mysql> select * from tb_student where id=1 or id=3 or id=5;# +----+--------+------+--------+-----------------------+# | id | name | age | gender | address |# +----+--------+------+--------+-----------------------+# | 1 | 刘备 | 33 | 男 | 湖北省武汉市 |# | 3 | 关羽 | 31 | 男 | 湖北省荆州市 |# | 5 | 赵云 | 25 | 男 | 河北省石家庄市 |# +----+--------+------+--------+-----------------------+# 3 rows in set (0.00 sec)## mysql> select * from tb_student where id=1 || id=3 || id=5;# +----+--------+------+--------+-----------------------+# | id | name | age | gender | address |# +----+--------+------+--------+-----------------------+# | 1 | 刘备 | 33 | 男 | 湖北省武汉市 |# | 3 | 关羽 | 31 | 男 | 湖北省荆州市 |# | 5 | 赵云 | 25 | 男 | 河北省石家庄市 |# +----+--------+------+--------+-----------------------+# 3 rows in set (0.00 sec)案例:获取年龄在18周岁~25周岁之间的同学信息
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 where【威尔】 age【诶吉】>=18 and age【诶吉】<=25;或mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 where【威尔】 age【诶吉】 between【B豚ing】 18 and 25;# mysql> select * from tb_student where age>=18 and age<=25;# +----+--------+------+--------+-----------------------+# | id | name | age | gender | address |# +----+--------+------+--------+-----------------------+# | 2 | 貂蝉 | 18 | 女 | 湖南省长沙市 |# | 4 | 大桥 | 20 | 女 | 浙江省杭州市 |# | 5 | 赵云 | 25 | 男 | 河北省石家庄市 |# | 6 | 小乔 | 18 | 女 | 江苏省扬州市 |# +----+--------+------+--------+-----------------------+# 4 rows in set (0.00 sec)## mysql> select * from tb_student where age between 18 and 25;# +----+--------+------+--------+-----------------------+# | id | name | age | gender | address |# +----+--------+------+--------+-----------------------+# | 2 | 貂蝉 | 18 | 女 | 湖南省长沙市 |# | 4 | 大桥 | 20 | 女 | 浙江省杭州市 |# | 5 | 赵云 | 25 | 男 | 河北省石家庄市 |# | 6 | 小乔 | 18 | 女 | 江苏省扬州市 |# +----+--------+------+--------+-----------------------+# 4 rows in set (0.00 sec)案例:获取id值为2、4、6的同学信息
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 where【威尔】 id in (2,4,6);# mysql> select * from tb_student where id=2 || id=4 || id=6;# +----+--------+------+--------+--------------------+# | id | name | age | gender | address |# +----+--------+------+--------+--------------------+# | 2 | 貂蝉 | 18 | 女 | 湖南省长沙市 |# | 4 | 大桥 | 20 | 女 | 浙江省杭州市 |# | 6 | 小乔 | 18 | 女 | 江苏省扬州市 |# +----+--------+------+--------+--------------------+# 3 rows in set (0.00 sec)## mysql> select * from tb_student where id in(2,4,6);# +----+--------+------+--------+--------------------+# | id | name | age | gender | address |# +----+--------+------+--------+--------------------+# | 2 | 貂蝉 | 18 | 女 | 湖南省长沙市 |# | 4 | 大桥 | 20 | 女 | 浙江省杭州市 |# | 6 | 小乔 | 18 | 女 | 江苏省扬州市 |# +----+--------+------+--------+--------------------+# 3 rows in set (0.00 sec)4、distinct【迪斯定特】数据去重
案例:获取tb_student【tb_斯丢等特】学生表中学员年龄的分布情况。
mysql > select【涩莱克特】 distinct【迪斯定特】 age【诶吉】 from【弗乱】 tb_student【tb_斯丢等特】;# mysql> select distinct age from tb_student;# +------+# | age |# +------+# | 33 |# | 18 |# | 31 |# | 20 |# | 25 |# +------+# 5 rows in set (0.00 sec)5、GROUP【格鲁普】 BY【拜】子句(重点和难度)
- group【格鲁普】 by【拜】子句的作用:对数据进行分组操作,为什么要进行分组呢?分组的目标就是进行分组统计
日常生活中的分组太多了,如按男女进行分组,按成绩进行分组,按院校,系部分组,按部门进行分组。
根据给定数据列的查询结果进行分组统计,最终得到一个分组汇总表 注:一般情况下group【格鲁普】 by 【拜】需与统计函数一起使用才有意义
①统计函数
| 常见统计函数 | 说明 |
|---|---|
| max【mà 斯】 | 求最大值 |
| min【敏ì】 | 求最小值 |
| sum【桑à姆】 | 求和 |
| avg【A 付阁】 | 求平均值 |
| count【kàn特】 | 求总行数 |
案例:求tb_student【tb_斯丢等特】表中一共有多少个记录
mysql > select【涩莱克特】 count【kàn特】(*) from【弗乱】 tb_student【tb_斯丢等特】;# mysql> select count(*) from tb_student;# +----------+# | count(*) |# +----------+# | 6 |# +----------+# 1 row in set (0.00 sec)案例:求年龄的最大值与最小值
mysql > select【涩莱克特】 max【mà 斯】(age【诶吉】) from【弗乱】 tb_student【tb_斯丢等特】;与mysql > select【涩莱克特】 mi(age【诶吉】) from【弗乱】 tb_student【tb_斯丢等特】;# mysql> select max(age) from tb_student; #最大# +----------+# | max(age) |# +----------+# | 33 |# +----------+# 1 row in set (0.00 sec)## mysql> select min(age) from tb_student; #最小# +----------+# | min(age) |# +----------+# | 18 |# +----------+# 1 row in set (0.00 sec)案例:求针对id字段求和
mysql > select【涩莱克特】 sum【桑à姆】(id) from【弗乱】 tb_student【tb_斯丢等特】;# mysql> select sum(id) from tb_student;# +---------+# | sum(id) |# +---------+# | 21 |# +---------+# 1 row in set (0.00 sec)案例:求学员表中年龄的平均值
mysql > select【涩莱克特】 avg【A 付阁】(age【诶吉】) from【弗乱】 tb_student【tb_斯丢等特】;# mysql> select avg(age) from tb_student;# +----------+# | avg(age) |# +----------+# | 24.1667 |# +----------+# 1 row in set (0.01 sec)#②GROUP【格鲁普】 BY【拜】分组
案例:求tb_student【tb_斯丢等特】表中,男同学的总数量与女同学的总数量
mysql > select【涩莱克特】 gender【詹德尔】,count【kàn特】(*) from【弗乱】 tb_student【tb_斯丢等特】 group【格鲁普】 by【拜】 gender【詹德尔】;# mysql> select gender,count(*) from tb_student group by gender;# +--------+----------+# | gender | count(*) |# +--------+----------+# | 男 | 3 |# | 女 | 3 |# +--------+----------+# 2 rows in set (0.00 sec)在MySQL5.7以后版本中,分组字段必须出现在select【涩莱克特】后面的查询字段中
案例:求tb_student【tb_斯丢等特】表中,男同学年龄的最大值与女同学年龄的最大值
mysql > select【涩莱克特】 gender【詹德尔】,max【mà 斯】(age【诶吉】) from【弗乱】 tb_student【tb_斯丢等特】 group【格鲁普】 by【拜】 gender【詹德尔】;# mysql> select gender,max(age) from tb_student group by gender;# +--------+----------+# | gender | max(age) |# +--------+----------+# | 男 | 33 |# | 女 | 20 |# +--------+----------+# 2 rows in set (0.00 sec)③GROUP【格鲁普】 BY【拜】分组原理
以后只要涉及到要求每个学科,每个部分、每个年级、每个系部薪资最高、成绩最好、薪资的平均值等等,就是基于GROUP【格鲁普】 BY【拜】 + 统计函数
6、HAVING【嗨夫营】子句
- having【嗨夫营】与where【威尔】 类似,根据条件对数据进行过滤筛选
- where【威尔】 针对表中的列发挥作用,查询数据
- having【嗨夫营】针对查询结果集发挥作用,筛选数据
案例:having【嗨夫营】在做简单查询时可以替代where【威尔】 子句
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 having【嗨夫营】 age【诶吉】>20;# mysql> select * from tb_student having age>20;# +----+--------+------+--------+-----------------------+# | id | name | age | gender | address |# +----+--------+------+--------+-----------------------+# | 1 | 刘备 | 33 | 男 | 湖北省武汉市 |# | 3 | 关羽 | 31 | 男 | 湖北省荆州市 |# | 5 | 赵云 | 25 | 男 | 河北省石家庄市 |# +----+--------+------+--------+-----------------------+# 3 rows in set (0.00 sec)案例:按学科进行分组,求每个学科拥有多少人
mysql > drop【卓-普】 table【忒-部】 tb_student【tb_斯丢等特】;mysql > create【克瑞特】 table【忒-部】 tb_student【tb_斯丢等特】( id mediumint【咪迪厄姆-因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, name varchar【瓦儿-查儿】(20), age【诶吉】 tinyint【泰尼因特】 unsigned【安赛因德】 default【迪-佛特】 0, gender【詹德尔】 enum【伊牛姆】('男','女'), subject【萨布杰克特】 enum【伊牛姆】('ui','java','yunwei','python'), primary【普赖莫瑞】 key【发音'ki'】(id)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;# mysql> drop table tb_student;# Query OK, 0 rows affected (0.14 sec)## mysql> create table tb_student(# -> id mediumint not null auto_increment,# -> name varchar(20),# -> age tinyint unsigned default 0,# -> gender enum('男','女'),# -> subject enum('ui','java','yunwei','python'),# -> primary key(id)# -> )engine=innodb default charset=utf8;# Query OK, 0 rows affected (0.33 sec)mysql> insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'悟空',255,'男','ui');mysql> insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'八戒',250,'男','python'),;mysql> insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'唐僧',30,'男','yunwei');mysql> insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'沙僧',150,'男','java');mysql> insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'小白龙',100,'男','yunwei');mysql> insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'白骨精',28,'女','ui');mysql> insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'兔子精',22,'女','yunwei');mysql> insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'狮子精',33,'男','yunwei');# mysql> insert into tb_student values (null,'悟空',255,'男','ui');# Query OK, 1 row affected (0.04 sec)## mysql> insert into tb_student values (null,'八戒',250,'男','python');# Query OK, 1 row affected (0.04 sec)## mysql> insert into tb_student values (null,'唐僧',30,'男','yunwei');# Query OK, 1 row affected (0.04 sec)## mysql> insert into tb_student values (null,'小白',100,'男','yunwei');# Query OK, 1 row affected (0.05 sec)## mysql> insert into tb_student values (null,'白骨精',28,'女','ui');# Query OK, 1 row affected (0.05 sec)## mysql> insert into tb_student values (null,'兔子',22,'女','yunwei');# Query OK, 1 row affected (0.06 sec)## mysql> insert into tb_student values (null,'狮子',33,'男','yunwei');# Query OK, 1 row affected (0.04 sec)或insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values(null【nò】,'悟空',255,'男','ui'),(null【nò】,'八戒',250,'男','python'), (null【nò】,'唐僧',30,'男','yunwei'),(null【nò】,'沙僧',150,'男','java'),(null【nò】,'小白龙',100,'男','yunwei'), (null【nò】,'白骨精',28,'女','ui'),(null【nò】,'兔子精',22,'女','yunwei'),(null【nò】,'狮子精',33,'男','yunwei');
# mysql> insert into tb_student values (null,'悟空',255,'男','ui'),(null,'八戒',250,'男','python'),(null,'唐僧',30,'男','yunwei'),(null,'小白',100,'男','yunwei'),(null,'白骨精',28,'女','ui'),(null,'兔子',22,'女','yunwei'),(null,'狮子',33,'男','yunwei');# Query OK, 7 rows affected (0.03 sec)# Records: 7 Duplicates: 0 Warnings: 0#mysql > select【涩莱克特】 subject【萨布杰克特】,count【kàn特】(*) from【弗乱】 tb_student【tb_斯丢等特】 group【格鲁普】 by【拜】 subject【萨布杰克特】;# mysql> select subject,count(*) from tb_student group by subject;# +---------+----------+# | subject | count(*) |# +---------+----------+# | ui | 2 |# | yunwei | 4 |# | python | 1 |# +---------+----------+# 3 rows in set (0.00 sec)#案例:求每个学科中,学科人数大于3人的学科信息
mysql > select【涩莱克特】 subject【萨布杰克特】,count【kàn特】(*) from【弗乱】 tb_student【tb_斯丢等特】 group【格鲁普】 by【拜】 subject【萨布杰克特】 having【嗨夫营】 count【kàn特】(*)>3;# mysql> select subject,count(*) from tb_student group by subject having count(*)>3;# +---------+----------+# | subject | count(*) |# +---------+----------+# | yunwei | 4 |# +---------+----------+# 1 row in set (0.01 sec)#7、ORDER【欧朵】 BY【拜】子句
主要作用就是对数据进行排序(升序、降序)
- 升序:从小到大 1,2,3,4,5
mysql > select【涩莱克特】 * from【弗乱】 数据表名称 ... order【欧朵】 by【拜】 字段名称 asc;- 降序:从大到小,5,4,3,2,1
mysql > select【涩莱克特】 * from【弗乱】 数据表名称 ... order【欧朵】 by【拜】 字段名称 desc;案例:按年龄进行排序(由大到小)
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 order【欧朵】 by【拜】 age【诶吉】 desc;# mysql> select * from tb_student order by age desc;# +----+-----------+------+--------+---------+# | id | name | age | gender | subject |# +----+-----------+------+--------+---------+# | 1 | 悟空 | 255 | 男 | ui |# | 2 | 八戒 | 250 | 男 | python |# | 4 | 小白 | 100 | 男 | yunwei |# | 7 | 狮子 | 33 | 男 | yunwei |# | 3 | 唐僧 | 30 | 男 | yunwei |# | 5 | 白骨精 | 28 | 女 | ui |# | 6 | 兔子 | 22 | 女 | yunwei |# +----+-----------+------+--------+---------+# 7 rows in set (0.00 sec)8、LIMIT【肋梅特】子句
基本语法:
mysql > select【涩莱克特】 * from【弗乱】 数据表名称 ... limit【肋梅特】 number【能波】;查询满足条件的number【能波】数量或mysql > select【涩莱克特】 * from【弗乱】 数据表名称 ... limit【肋梅特】 offset【奥夫赛特】,number【能波】; 从偏移量为offset【奥夫赛特】开始查询,查询number【能波】条记录,offset【奥夫赛特】的值从0开始offset【奥夫赛特】偏移量:
案例:获取学生表中,年龄最大的学员
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 order【欧朵】 by【拜】 age【诶吉】 desc limit【肋梅特】 1;# mysql> select * from tb_student order by age desc limit 1;# +----+--------+------+--------+---------+# | id | name | age | gender | subject |# +----+--------+------+--------+---------+# | 1 | 悟空 | 255 | 男 | ui |# +----+--------+------+--------+---------+# 1 row in set (0.01 sec)#案例:从偏移量为1的元素开始查询,查询2条记录
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 limit【肋梅特】 1,2;# mysql> select * from tb_student limit 1,2;# +----+--------+------+--------+---------+# | id | name | age | gender | subject |# +----+--------+------+--------+---------+# | 2 | 八戒 | 250 | 男 | python |# | 3 | 唐僧 | 30 | 男 | yunwei |# +----+--------+------+--------+---------+# 2 rows in set (0.00 sec)limit【肋梅特】子句在开发项目中,主要应用于数据分页。
案例:实现数据分页 第一页:
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 limit【肋梅特】 0,2;# mysql> select * from tb_student limit 0,2;# +----+--------+------+--------+---------+# | id | name | age | gender | subject |# +----+--------+------+--------+---------+# | 1 | 悟空 | 255 | 男 | ui |# | 2 | 八戒 | 250 | 男 | python |# +----+--------+------+--------+---------+# 2 rows in set (0.01 sec)第二页:
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】 limit【肋梅特】 2,2;# mysql> select * from tb_student limit 2,2;# +----+--------+------+--------+---------+# | id | name | age | gender | subject |# +----+--------+------+--------+---------+# | 3 | 唐僧 | 30 | 男 | yunwei |# | 4 | 小白 | 100 | 男 | yunwei |# +----+--------+------+--------+---------+# 2 rows in set (0.00 sec)#三、SQL多表查询
1、什么是多表查询
- 我们刚才学习的SQL五子句都主要是针对单表情况,我们在实际工作中,也可能会接触到一些复杂的多表查询
2、union【U凝】联合查询
- UNION【U凝】联合查询的作用:把多个表中的数据联合在一起进行显示。应用场景:分库分表
第一步:创建两个结构相同的学生表tb_student【tb_斯丢等特】1于tb_student【tb_斯丢等特】2
mysql > create【克瑞特】 table【忒-部】 tb_student【tb_斯丢等特】1( id mediumint【咪迪厄姆-因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, name varchar【瓦儿-查儿】(20), age【诶吉】 tinyint【泰尼因特】 unsigned【安赛因德】 default【迪-佛特】 0, gender【詹德尔】 enum【伊牛姆】('男','女'), subject【萨布杰克特】 enum【伊牛姆】('ui','java','yunwei','python'), primary【普赖莫瑞】 key【发音'ki'】(id)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;# mysql> create table tb_student1(# id mediumint not null auto_increment,# name varchar(20),# age tinyint unsigned default 0,# gender enum('男','女'),# subject enum('ui','java','yunwei','python'),# primary key(id)# )engine=innodb default charset=utf8;# Query OK, 0 rows affected (0.42 sec)#mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】1 values【挖柳斯】 (1,'悟空',255,'男','ui');# mysql> insert into tb_student1 values (1,'悟空',255,'男','ui');# Query OK, 1 row affected (0.04 sec)#
mysql > create【克瑞特】 table【忒-部】 tb_student【tb_斯丢等特】2( id mediumint【咪迪厄姆-因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, name varchar【瓦儿-查儿】(20), age【诶吉】 tinyint【泰尼因特】 unsigned【安赛因德】 default【迪-佛特】 0, gender【詹德尔】 enum【伊牛姆】('男','女'), subject【萨布杰克特】 enum【伊牛姆】('ui','java','yunwei','python'), primary【普赖莫瑞】 key【发音'ki'】(id)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;# mysql> create table tb_student2(# id mediumint not null auto_increment,# name varchar(20),# age tinyint unsigned default 0,# gender enum('男','女'),# subject enum('ui','java','yunwei','python'),# primary key(id)# )engine=innodb default charset=utf8;# Query OK, 0 rows affected (0.40 sec)
mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】2 values【挖柳斯】 (2,'唐僧',30,'男','yunwei');# mysql> insert into tb_student2 values (2,'唐僧',30,'男','yunwei');# Query OK, 1 row affected (0.11 sec)#第二步:使用UNION【U凝】进行联合查询
mysql > select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】1 union【U凝】 select【涩莱克特】 * from【弗乱】 tb_student【tb_斯丢等特】2;# mysql> select * from tb_student1 union select * from tb_student2;# +----+--------+------+--------+---------+# | id | name | age | gender | subject |# +----+--------+------+--------+---------+# | 1 | 悟空 | 255 | 男 | ui |# | 2 | 唐僧 | 30 | 男 | yunwei |# +----+--------+------+--------+---------+# 2 rows in set (0.01 sec)#3、交叉查询(了解)
基本语法:
mysql > select【涩莱克特】 */字段列表 from【弗乱】 数据表1,数据表2;或mysql > select【涩莱克特】 */字段列表 form【佛乱】 数据表1 cross【克洛斯】 join【载(白话)】 数据表2;tb_category【tb_凯特厄戈瑞】
mysql > create【克瑞特】 table【忒-部】 tb_category【tb_凯特厄戈瑞】( id smallint【斯莫尔因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, name varchar【瓦儿-查儿】(20), pid smallint【斯莫尔因特】 default【迪-佛特】 0, primary【普赖莫瑞】 key【发音'ki'】(id)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;# mysql> create table tb_category(# -> id smallint not null auto_increment,# -> name varchar(20),# -> pid smallint default 0,# -> primary key(id)# -> )engine=innodb default charset=utf8;# Query OK, 0 rows affected (0.39 sec)#insert【因涩特】 into【因兔】 tb_category【tb_凯特厄戈瑞】 values【挖柳斯】 (null【nò】,'手机',0);insert【因涩特】 into【因兔】 tb_category【tb_凯特厄戈瑞】 values【挖柳斯】 (null【nò】,'电脑',0);insert【因涩特】 into【因兔】 tb_category【tb_凯特厄戈瑞】 values【挖柳斯】 (null【nò】,'游戏手机',1); =>首席手机属于手机分类# mysql> insert into tb_category values (null,'手机',0);# Query OK, 1 row affected (0.05 sec)## mysql> insert into tb_category values (null,'电脑',0);# Query OK, 1 row affected (0.06 sec)## mysql> insert into tb_category values (null,'游戏手机',1);# Query OK, 1 row affected (0.05 sec)#pid代表所属的父级类别,如果自己就是顶级分类,则为0
tb_goods【故兹】
mysql> create【克瑞特】 table【忒-部】 tb_goods【故兹】( id int【因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, title【泰头】 varchar【瓦儿-查儿】(80), price【普莱斯】 decimal【戴希莫】(11,2), cid smallint【斯莫尔因特】 default【迪-佛特】 0, primary【普赖莫瑞】 key【发音'ki'】(id)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;# mysql> create table tb_goods(# -> id int not null auto_increment,# -> title varchar(80),# -> price decimal(11,2),# -> cid smallint default 0,# -> primary key(id)# -> )engine=innodb default charset=utf8;# Query OK, 0 rows affected (0.34 sec)#insert【因涩特】 into【因兔】 tb_goods【故兹】 values【挖柳斯】 (null【nò】,'IPhone 11',5699.00,1);insert【因涩特】 into【因兔】 tb_goods【故兹】 values【挖柳斯】 (null【nò】,'MI 10',4699.00,1);insert【因涩特】 into【因兔】 tb_goods【故兹】 values【挖柳斯】 (null【nò】,'ThinkPad X1',9999.00,2);insert【因涩特】 into【因兔】 tb_goods【故兹】 values【挖柳斯】 (null【nò】,'Nike gt',999.00,10);# mysql> insert into tb_goods values (null,'IPhone',5699.00,1),(null,'MI 10',4699.00,1),(null,'ThinkPad X1',9999.00,2),(null,'Nike gt',999.00,10);# Query OK, 4 rows affected (0.05 sec)# Records: 4 Duplicates: 0 Warnings: 0#cid代表产品的所属分类编号,与tb_category【tb_凯特厄戈瑞】要一一对应
案例:把分类表与产品进行交叉,就结果
mysql >select【涩莱克特】 * from【弗乱】 tb_category【tb_凯特厄戈瑞】 cross【克洛斯】 join【载(白话)】 tb_goods【故兹】;# mysql> select * from tb_category cross join tb_goods;# +----+--------------+------+----+-------------+---------+------+# | id | name | pid | id | title | price | cid |# +----+--------------+------+----+-------------+---------+------+# | 1 | 手机 | 0 | 1 | IPhone | 5699.00 | 1 |# | 2 | 电脑 | 0 | 1 | IPhone | 5699.00 | 1 |# | 3 | 游戏手机 | 1 | 1 | IPhone | 5699.00 | 1 |# | 1 | 手机 | 0 | 2 | MI 10 | 4699.00 | 1 |# | 2 | 电脑 | 0 | 2 | MI 10 | 4699.00 | 1 |# | 3 | 游戏手机 | 1 | 2 | MI 10 | 4699.00 | 1 |# | 1 | 手机 | 0 | 3 | ThinkPad X1 | 9999.00 | 2 |# | 2 | 电脑 | 0 | 3 | ThinkPad X1 | 9999.00 | 2 |# | 3 | 游戏手机 | 1 | 3 | ThinkPad X1 | 9999.00 | 2 |# | 1 | 手机 | 0 | 4 | Nike gt | 999.00 | 10 |# | 2 | 电脑 | 0 | 4 | Nike gt | 999.00 | 10 |# | 3 | 游戏手机 | 1 | 4 | Nike gt | 999.00 | 10 |# +----+--------------+------+----+-------------+---------+------+# 12 rows in set (0.00 sec)
交叉连接本身是没有意义的,其只是强制把两个表甚至多个表进行连接在一起。但是交叉查询中也有正确的结果,所以我们所谓的多表连接只需要在交叉连接的基础上增加一个连接条件,则就是我们想要的结果了。所以交叉查询是多表查询的基础
4、内连接查询
基本语法:
mysql > select【涩莱克特】 数据表1.字段列表,数据表2.字段列表 from【弗乱】 数据表1 inner【ing呐】 join【载(白话)】 数据表2 on【昂】 连接条件;案例:获取产品表中每个产品的分类信息
mysql> select【涩莱克特】 tb_goods【故兹】.*,tb_category【tb_凯特厄戈瑞】.name from【弗乱】 tb_goods【故兹】 inner【ing呐】 join【载(白话)】 tb_category【tb_凯特厄戈瑞】 on【昂】 tb_goods【故兹】.cid=tb_category【tb_凯特厄戈瑞】.id;# mysql> select tb_goods.*,tb_category.name from tb_goods inner join tb_category on tb_goods.cid=tb_category.id;# +----+-------------+---------+------+--------+# | id | title | price | cid | name |# +----+-------------+---------+------+--------+# | 1 | IPhone | 5699.00 | 1 | 手机 |# | 2 | MI 10 | 4699.00 | 1 | 手机 |# | 3 | ThinkPad X1 | 9999.00 | 2 | 电脑 |# +----+-------------+---------+------+--------+# 3 rows in set (0.03 sec)#内连接查询:把两个表甚至多个表进行连接,然后拿表1 中的每一条记录与表2中的每一条记录进行匹配,如果有与之对应的结果,则显示。反之,则忽略这条记录
5、外连接查询
- 内连接查询要求:表1和表2中的每一条记录都必须要一一对应,如果无法匹配,则这条记录会被自动忽略掉,那如果我需要保留表1中的所有记录或表2 中的所有记录怎么办呢?
答:可以使用外连接查询
基本语法:
- 左连接查询:把左表中的每一条数据都保留,右表匹配到结果就显示,匹配不到就null【nò】
select【涩莱克特】 数据表1.字段列表,数据表2.字段列表 from【弗乱】 数据表1 left【列夫特】 数据表2 on【昂】 连接条件;- 右连接查询:把右表中的每一条数据都保留,左表匹配到结果就显示,匹配不到就null【nò】
select【涩莱克特】 数据表1.字段列表,数据表2.字段列表 from【弗乱】 数据表1 right【来特】 join【载(白话)】 数据表2 on【昂】 连接条件;案例:获取产品表中每个产品的分类信息(无论匹配到与否)
mysql > select【涩莱克特】 tb_goods【故兹】.*,tb_category【tb_凯特厄戈瑞】.name from【弗乱】 tb_goods【故兹】 left【列夫特】 join【载(白话)】 tb_category【tb_凯特厄戈瑞】 on【昂】 tb_goods【故兹】.cid=tb_category【tb_凯特厄戈瑞】.id;# mysql> select tb_goods.*,tb_category.name from tb_goods left join tb_category on tb_goods.cid=tb_category.id;# +----+-------------+---------+------+--------+# | id | title | price | cid | name |# +----+-------------+---------+------+--------+# | 1 | IPhone | 5699.00 | 1 | 手机 |# | 2 | MI 10 | 4699.00 | 1 | 手机 |# | 3 | ThinkPad X1 | 9999.00 | 2 | 电脑 |# | 4 | Nike gt | 999.00 | 10 | NULL |# +----+-------------+---------+------+--------+# 4 rows in set (0.00 sec)6、别名机制:简化内外连接
案例:获取产品表中每个产品的分类信息(无论匹配到与否) 原始语句:
mysql > select【涩莱克特】 tb_goods【故兹】.*,tb_category【tb_凯特厄戈瑞】.name from【弗乱】 tb_goods【故兹】 left【列夫特】 join【载(白话)】 tb_category【tb_凯特厄戈瑞】 on【昂】 tb_goods【故兹】.cid=tb_category【tb_凯特厄戈瑞】.id;# mysql> select tb_goods.*,tb_category.name from tb_goods left join tb_category on tb_goods.cid=tb_category.id;# +----+-------------+---------+------+--------+# | id | title | price | cid | name |# +----+-------------+---------+------+--------+# | 1 | IPhone | 5699.00 | 1 | 手机 |# | 2 | MI 10 | 4699.00 | 1 | 手机 |# | 3 | ThinkPad X1 | 9999.00 | 2 | 电脑 |# | 4 | Nike gt | 999.00 | 10 | NULL |# +----+-------------+---------+------+--------+# 4 rows in set (0.00 sec)#给数据表起个简单的名字,如tb_category【tb_凯特厄戈瑞】叫c,tb_goods【故兹】叫做g
原句①mysql > select【涩莱克特】 * from【弗乱】 tb_goods【故兹】 left【列夫特】 join【载(白话)】 tb_category【tb_凯特厄戈瑞】;
起别名②mysql > select【涩莱克特】 * from【弗乱】 tb_goods【故兹】 g left【列夫特】 join【载(白话)】 tb_category【tb_凯特厄戈瑞】 c;
写on条件③mysql > select【涩莱克特】 * from【弗乱】 tb_goods【故兹】 g left【列夫特】 join【载(白话)】 tb_category【tb_凯特厄戈瑞】 c on【昂】 g.cid=c.id;
筛选字段④mysql > select【涩莱克特】 g.*,c.name from【弗乱】 tb_goods【故兹】 g left【列夫特】 join【载(白话)】 tb_category【tb_凯特厄戈瑞】 c on【昂】 g.cid=c.id;# mysql> select g.*,c.name from tb_goods g left join tb_category c on g.cid=c.id;# +----+-------------+---------+------+--------+# | id | title | price | cid | name |# +----+-------------+---------+------+--------+# | 1 | IPhone | 5699.00 | 1 | 手机 |# | 2 | MI 10 | 4699.00 | 1 | 手机 |# | 3 | ThinkPad X1 | 9999.00 | 2 | 电脑 |# | 4 | Nike gt | 999.00 | 10 | NULL |# +----+-------------+---------+------+--------+# 4 rows in set (0.00 sec)#day04-MySQL备份与恢复一
一、用户管理与权限管理
⭐用户管理
1、创建MySQL用户
注意:MySQL中不能单纯通过用户名来创建用户,必须要加上主机。如 jack@192.168.1.1
#创建用户mysql > create【克瑞特】 user '用户名'@'被允许连接的主机名称或主机的IP地址' identified【爱-丹-提伐】 by【拜】 '用户密码';
#查询MySQL服务器中所有用户及其允许连接的主机。mysql > select【涩莱克特】 user,host from【弗乱】 mysql.user;案例:创建一个MySQL账号,用户名:tom,用户密码:123
mysql > create【克瑞特】 user 'tom'@'localhotst' identified【爱-丹-提伐】 by【拜】 '123';# mysql> create user 'tom'@'localhost' identified by '123';# Query OK, 0 rows affected (0.15 sec)#或mysql > create【克瑞特】 user 'tom'@'127.0.0.1' identified【爱-丹-提伐】 by【拜】 '123';# mysql> create user 'tom'@'127.0.0.1' identified by '123';# Query OK, 0 rows affected (0.00 sec)案例:创建一个MySQL账号(要求开通远程连接),主机IP地址:192.168.20.110,用户名:harry,密码:1234
mysql > create【克瑞特】 user 'harry'@'192.168.20.110' identified【爱-丹-提伐】 by【拜】 '123';
# mysql> create user 'harry'@'192.168.20.110' identified by '1234';# Query OK, 0 rows affected (0.00 sec)#测试:在IP地址为192.168.20.110的主机上
# yum install【因-斯多】 mysql -y# mysql -h 192.168.20.111 -P 3306 -uharry -pEnter password【帕斯沃德】:123选项说明:192.168.20.111:MySQL服务器端的IP地址yum安装Mysql:代表安装的是MySQL的客户端 YUM安装mysql-server【涩·沃】:代表安装的是MySQL服务器端
案例:创建一个MySQL账号(要求开通远程连接),主机IP的网段:192.168.20.0,用户名:jack ,用户密码:1234
mysql > create【克瑞特】 user 'jack'@'192.168.20.%' identified【爱-丹-提伐】 by【拜】 '1234';# mysql> create user 'jack'@'192.168.20.%' identified by '1234';# Query OK, 0 rows affected (0.00 sec)#案例:创建一个MySQL账号(要求开通远程连接),要求面向所有主机开放,用户名:root,用户密码:1234
mysql > create【克瑞特】 user 'root'@'%' identified【爱-丹-提伐】 by【拜】 '1234';# mysql> create user 'root'@'%' identified by '1234';# Query OK, 0 rows affected (0.00 sec)2、删除用户
基本语法:
mysql > drop【卓-普】 user '用户名'@'主机名称或主机的IP地址';特别说明:如果在删除用户时没有指定主机的名称或主机的IP地址,则默认删除这个账号的所有信息。案例:删除tom这个账号
mysql > drop【卓-普】 user 'tom'@'localhost';# mysql> drop user 'tom'@'127.0.0.1';# Query OK, 0 rows affected (0.00 sec)#案例:删除jack这个账号
mysql > drop【卓-普】 user 'jacl'@'192.168.20.%';# mysql> drop user 'jack'@'192.168.20.%';# Query OK, 0 rows affected (0.00 sec)#案例:创建两个harry账号(localhost/192.168.20.110),然后删除其中的某个
mysql > create【克瑞特】 user 'harry'@'192.168.20.110' identified【爱-丹-提伐】 by【拜】 '1234';mysql > create【克瑞特】 user 'harry'@'localhost' identified【爱-丹-提伐】 by【拜】 '1234';mysql > drop【卓-普】 user 'harry'@'192.168.20.110';# mysql> create user 'harry'@'localhost' identified by '123';# Query OK, 0 rows affected (0.00 sec)## mysql> create user 'harry'@'192.168.20.110' identified by '123';# Query OK, 0 rows affected (0.00 sec)## mysql> drop user 'harry'@'192.168.20.110';# Query OK, 0 rows affected (0.00 sec)#扩展:删除MySQL账号的另外一种方式
mysql > delete【迪 利 特】from【弗乱】 mysql.user where【威尔】 user='root' and host ='%';mysql > flush【福 辣 徐】 privileges【P符类 杰 斯】;# mysql> delete from mysql.user where user='harry' and host='localhost';# Query OK, 1 row affected (0.00 sec)## mysql> flush privileges;# Query OK, 0 rows affected (0.00 sec)#3、修改MySQL用户
特别说明:Mysql用户重命名通常可以更改两部分,一部分是用户的名称,一部分是被允许访问的主机名称或主机的IP地址。 基本语法:
mysql > rename【瑞-内姆】 user 旧用户信息 to 新用户信息;案例:把用户’root’@’%‘更改为’root’@‘192.168.20.%’
mysql > create【克瑞特】 user 'root'@'%' identified【爱-丹-提伐】 by【拜】 'mysql1234';mysql > rename【瑞-内姆】 user 'root'@'%' to 'root'@'192.168.20.%';# mysql> create user 'root'@'%' identified by 'mysql1234';# Query OK, 0 rows affected (0.00 sec)# mysql> rename user 'root'@'%' to 'root'@'192.168.20.%';# Query OK, 0 rows affected (0.00 sec)#案例:把’tom’@‘localhost’更名为’harry’@‘localhost’
mysql > create【克瑞特】 user 'tom'@'localhost' identified【爱-丹-提伐】 by【拜】 'mysql1234';mysql > rename【瑞-内姆】 user 'tom'@'localhotst' to 'jack'@'localhost'# mysql> create user 'tom'@'localhost' identified by 'mysql1234';# Query OK, 0 rows affected (0.00 sec)## mysql> rename user 'tom'@'localhost' to 'jack'@'localhost';# Query OK, 0 rows affected (0.00 sec)#扩展:使用update【阿普 dei 特】语句更新用户信息
mysql > update【阿普 dei 特】 mysql.user set【赛特】 user='tom',host='localhost' where【威尔】 user='jack' and host='localhost';mysql > flush【福 辣 徐】 privileges【P符类 杰 斯】;# mysql> update mysql.user set user='tom',host='localhost' where user='jack' and host='localhost';# Query OK, 1 row affected (0.00 sec)# Rows matched: 1 Changed: 1 Warnings: 0## mysql> flush privileges;# Query OK, 0 rows affected (0.00 sec)#⭐权限管理
1、权限说明
USAGE 无权限,只有登录数据库,只可以使用test【泰斯特】或test_*数据库ALL【哦】 所有权限以下权限为指定权限select【涩莱克特】/update【阿普 dei 特】/delete【迪利特】/super/replication【瑞普利K申】 slave【斯累夫】/reload【率漏德】...with【威付】 grant【古亮普】 option【阿普申】 选项表示允许把自己的权限授予其它用户或者从其他用户收回自己的权限默认情况下,分配权限时如果没有指定with【威付】 grant【古亮普】 option【阿普申】,代表这个用户不能下发权限给其他用户,但是这个权限分配不能超过自身权限
2、权限保存位置(了解)
mysql.user 所有mysql用户的账号和密码,以及用户对全库全表权限(*.*)mysql.db 非mysql库的授权都保存在此(db.*)mysql.table【忒-部】_priv 某库某表的授权(db.table【忒-部】)mysql.columns_priv 某库某表某列的授权(db.table【忒-部】.col1)mysql.procs_priv 某库存储过程的授权3、给用户授权
基本语法:
mysql > grant【古亮普】 权限1,权限2 on【昂】 库.表 to 用户@主机mysql > grant【古亮普】 权限(列1,列2,...) on【昂】 库.表 to 用户@主机库.表表示方法:.代表所有数据库的所有数据表,db_fq.*代表db_fq数据库中的所有数据表,db_fq.tb_admin,代表db_fq数据库中的tb_admin表
案例:给tom账号分配db_fq的查询权限
mysql > grant【古亮普】 select【涩莱克特】 on【昂】 db_fq.* to 'tom'@'localhost';mysql > flush【福 辣 徐】 privileges【P符类 杰 斯】;mysql> grant select on db_fq.* to 'tom'@'localhost';# mysql> grant select on db_fq.* to 'tom'@'localhost';# Query OK, 0 rows affected (0.15 sec)## mysql> flush privileges;# Query OK, 0 rows affected (0.00 sec)#案例:给tom账号分配db_fq.tb_student【tb_斯丢等特】数据表的权限(要求只能更改age【诶吉】字段)
mysql > grant【古亮普】 update【阿普 dei 特】(age【诶吉】) on【昂】 db_fq.tb_student【tb_斯丢等特】 to 'tom'@'localhost';mysql > flush【福 辣 徐】 privileges【P符类 杰 斯】;# mysql> grant update(age) on db_fq.tb_student to 'tom'@'localhost';# Query OK, 0 rows affected (0.10 sec)## mysql> flush privileges;# Query OK, 0 rows affected (0.00 sec)#案例:添加一个root@%账号,然后分配所有权限
mysql > create【克瑞特】 user 'root'@'%' identified【爱-丹-提伐】 by【拜】 'mysql1234';mysql > grant【古亮普】 all【哦】 on【昂】 *.* to 'root'@'%';mysql > flush【福 辣 徐】 privileges【P符类 杰 斯】;# mysql> create user 'root'@'%' identified by 'mysql1234';# Query OK, 0 rows affected (0.00 sec)# mysql> grant all on *.* to 'root'@'%';# Query OK, 0 rows affected (0.00 sec)## mysql> flush privileges;# Query OK, 0 rows affected (0.00 sec)#4、查询用户权限
查询当前用户权限
mysql > show【瘦】 grants【哥亮特s】;查询其他用户权限
mysql > show【瘦】 grants【哥亮特s】 for【fò】 '用户名称'@'授权的主机名称或IP地址';5、with【威付】 grant【古亮普】 option【阿普申】选项
with【威付】 grant【古亮普】 option【阿普申】选项作用:代表此账号可以为其他用户下发权限,但是下发权限不能超过自身权限
mysql> grant【古亮普】 all【哦】 on【昂】 *.* to 'amy'@'10.1.1.%' identified【爱-丹-提伐】 by【拜】 '123' with【威付】 grant【古亮普】 option【阿普申】;mysql> grant【古亮普】 all【哦】 on【昂】 *.* to 'harry'@'10.1.1.%' identified【爱-丹-提伐】 by【拜】 '123';如以上命令显示:amy拥有下发权限的功能,而harry不具备下发权限的功能如果grant【古亮普】授权时,没有with【威付】 grant【古亮普】 option【阿普申】选项,则其无法为其他用户授权
6、使用grant【古亮普】创建用户
说明:5.7以后不推荐,未来会被弃用 基本语法:
mysql grant【古亮普】 权限 on【昂】 数据库.数据表 to '新用户名称'@'授权主机名称或IP地址' identified【爱-丹-提伐】 by【拜】 '用户的密码';案例:创建一个root账号,主机为%,授予所有权限,密码为mysql1234
mysql > grant【古亮普】 all【哦】 on【昂】 *.* to 'root'@'%' identified【爱-丹-提伐】 by【拜】 'mysql1234';# mysql> grant all on *.* to 'root'@'%' identified by 'mysql1234';# Query OK, 0 rows affected, 1 warning (0.00 sec)#7、revoke【瑞 - 沃克】回收权限
基本语法:
revoke【瑞 - 沃克】 权限 on【昂】 库.表 from【弗乱】 用户;案例:从tom张中回收select【涩莱克特】权限
撤消指定的权限mysql> revoke【瑞 - 沃克】 update【阿普 dei 特】 on【昂】 db01.tt1 from【弗乱】 'tom'@'10.1.1.1';# mysql> revoke update on db01.tt1 from 'tom'@'10.1.1.1';撤消所有的权限mysql> revoke【瑞 - 沃克】 select【涩莱克特】 on【昂】 db01.* from【弗乱】 'tom'@'10.1.1.1';# mysql> revoke select on db01.* from 'tom'@'10.1.1.1'二、MySQL备份的任务背景
1、任务需求
某天,公司领导安排刚入职不久的小冯同学将生产环境中的数据(MySQL数据库)全部导入到测试环境给测试人员使用。当小冯去拿备份数据时发现,备份数据是1个礼拜之前的。原因是之前运维同事通过脚本每天对数据库进行备份,根据结果判断应该是脚本的问题导致备份失败。于是乎,领导让小冯重新制定备份策略对数据库进行备份,并且把数据导入到测试环境。
2、核心技术
- ①掌握MySQL的备份工具使用及各自特点
- ②熟悉SHELL脚本
- ③熟悉MySQL数据的导入到出
3、任务步骤
- ①选择合适的工具和方法对mysql数据库进行备份
- ②编写脚本实现自动化备份
4、任务目标:
- 了解MySQL常见的备份方式和类型
- 能够使用mysqldump【mysql-当普】工具进行数据库的备份。如全库备份,库级别备份,表级别备份
- 能够使用mysqldump【mysql-当普】工具+binlog【宾-劳格】日志实现增量备份
- 理解xtrabackup【xtra-拜克阿普】工具实现增量备份的原理和方法
- 能够使用xtrabackup【xtra-拜克阿普】工具对数据库进行全备和增备
三、MySQL备份概述
1、关于数据保存你要知道
备份和冗余有什么区别?
备份
能够防止由于机械故障以及人为误操作带来的数据丢失,例如将数据库文件保存在了其它地方。
冗余
数据有多份冗余,但不等备份,只能防止机械故障带来的数据丢失,例如主备模式、数据库集群。
2、到底要备份什么
⭐备份什么
数据库:一堆物理文件的集合:日志文件+数据文件+配置文件
- ①数据文件
- ②配置文件 => my.cnf
- ③日志文件(主要是二进制日志文件)
⭐MySQL体系结构
扩展:MySQL体系结构(MySQL => DBMS软件到底是由哪些层构成的)
⭐存储引擎层(MyLSAM与innodb【伊诺 DB】引擎)
存储引擎层:简单来所,就是数据的存储方式。在MySQL中,我们可以使用show【瘦】 engines【 嗯(ing) 京(白话读音)s 】查看当前数据库版本支持哪些引擎,常见的数据库引擎:innodb【伊诺 DB】、MyISAM【迈-艾塞姆】、NDB、、、
常见面试题:请简述MySQL的MyISAM【迈-艾塞姆】引擎与innodb【伊诺 DB】引擎的区别
①MyISAM【迈-艾塞姆】引擎:擅长数据的查询,支持全文索引②innodb【伊诺 DB】引擎:支持事务处理、行级锁、支持外键⭐存储层(数据文件是如何进行存储的)
问题:存储引擎到底是如何保存数据文件的?
mysql > create【克瑞特】 database【得塔-贝斯】 db_fq default【迪-佛特】 charset【查赛特】=utf8;#mysql > create database db_fq default charset =utf8;问题:能不能不进入MySQL终端,然后在命令行中直接创建一个数据库呢? -e 当数据库创建完毕后,查看/mysql_3306/data文件夹:
在db_fq文件夹中还有一个文件db.opt,存放内容为数据库的编码格式。
MyISAM【迈-艾塞姆】引擎
mysql > use db_fq;mysql > create【克瑞特】 table【忒-部】 tb_user(id int, name char【查尔】(1)) engine【 嗯(ing) 京(白话读音) 】=myisam【迈-艾塞姆】 default【迪-佛特】 charset【查赛特】=utf8;# mysql> create table tb_user(id int, name char(1)) engine=myisam default charset=utf8;# Query OK, 0 rows affected (0.07 sec)#
创建完成后,查看db_fq目录信息,发现产生了3个文件
*.frm:框架文件,定义数据表结构 *.MYI:INDEX索引,主要用于存放索引文件 *.MYD:数据文件
innodb【伊诺 DB】引擎
mysql > use db_fq;mysql > create【克瑞特】 table【忒-部】 tb_user(id int, name char【查尔】(1)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;# mysql> create table tb_user(id int, name char(1)) engine=innodb default charset=utf8;# Query OK, 0 rows affected (0.49 sec)#创建完成后,查看db_fq目录信息,发现产生了2个文件
*.frm:框架文件,定义数据表结构 *.ibd:索引文件+数据文件
其实innodb【伊诺 DB】引擎不仅仅会产生两个文件,其在外部data目录下也会产生一个文件 (确切来说不能叫做产生文件,而应该叫做共享文件)
所以由此可知,innodb【伊诺 DB】引擎的数据备份不能简单的通过拷贝方式实现,必须使用专业的备份工具。
⭐日志文件(MySQL中我们需要了解哪些日志)
| 日志类型 | 写入日志的信息 |
|---|---|
| error【诶 若】错误日志 | 存放数据库的启动、停止或运行时的错误信息(找ERROR【诶 若】) |
| binlog【宾-劳格】二进制日志 | 数据库的所有更改操作(DDL/DML/DCL),不包含select【涩莱克特】或者show【瘦】这类语句 |
error【诶 若】错误日志的命令规则与存放的目录:/data目录下+主机名称.err
更改错误日志的存放位置:
# vim my.cnf[mysqld]...log_error【劳格-诶 若】=data数据目录/主机名称.err或mysql.errbinlog【宾-劳格】二进制日志应用场景: 用户主从复制,master【马斯特】主服务器将二进制日志中的更改操作发送给slave【斯累夫】从服务器,从服务器执行这些更改操作 目的和主服务器的更改相同用于数据的恢复操作
binlog【宾-劳格】二进制日志如何开启? 默认binlog【宾-劳格】日志是关闭的,可以通过修改配置文件完成开启,如下:
# vim my.cnf[mysqld]...server【涩·沃】-id=1log_bin=data数据目录/binlog【宾-劳格】当我们更改了my.cnf配置文件,一定要记得重启MySQL服务器。service【瑟为斯】命令
[root@mysql ~]# service mysql_3306 restart【 率 s 达r】3、备份过程考虑的因素
- 必须制定详细的备份计划(策略)(备份频率、时间点、周期)
- 备份数据应该放在非数据库本地,并建议有多份副本
- 必须做好数据恢复的演练(每隔一段时间,对备份的数据在测试环境中进行模拟恢复,保证当出现数据灾难的时候能够及时恢复数据。)
- 根据数据应用的场合、特点选择正确的备份工具。
- 数据的一致性
- 服务的可用性
4、备份的类型
⭐逻辑备份
- 备份的是建表、建库、插入等操作所执行SQL语句(DDL DML DCL)。
- 适用于中小型数据库,效率相对较低。 一般在数据库正常提供服务的前提下进行,如:mysqldump【mysql-当普】、mydumper【my-邓破儿~】、into【因兔】 outfile【奥特-伐尔】(表的导出导入)等。
- 备份的本质:就是把备份的数据导出成.sql文件或.txt文件
⭐物理备份
- 直接复制数据库文件
- 适用于大型数据库环境,不受存储引擎的限制,但不能恢复到不同的MySQL版本。
- 一般是在数据库彻底关闭或者不能完成正常提供服务的前提下进行的备份);如:tar、cp、xtrabackup【xtra-拜克阿普】(数据库可以正常提供服务)、lvm snapshot【斯奈普肖特】、rsync【啊 xing(4声)可】等
- 备份的实质:对数据文件+配置文件+日志文件进行拷贝操作
⭐在线热备
- MySQL的replication【瑞普利K申】架构,如M-S|M-S-S|M-M-S等
- 实时在线备份
5、备份工具
㈠ 社区版安装包中的备份工具
① mysqldump【mysql-当普】(逻辑备份,只能全量备份)
- 1)企业版和社区版都包含
- 2)本质上使用SQL语句描述数据库及数据并导出
- 3)在MYISAM【迈-艾塞姆】引擎上锁表,innodb【伊诺 DB】引擎上锁行
- 4)数据量很大时不推荐使用
② mysqlhotcopy(物理备份工具)
- 1)企业版和社区版都包含
- 2)perl写的一个脚本,本质上是使用锁表语句后再拷贝数据
- 3)只支持MYISAM【迈-艾塞姆】数据引擎
㈡ 企业版安装包中的备份工具
mysqlbackup【mysql-拜克阿普】
- 1)在线备份
- 2)增量备份
- 3)部分备份
- 4)在某个特定时间的一致性状态的备份
㈢ 第三方备份工具
① xtrabackup【xtra-拜克阿普】和innobackupex(物理备份)
- 1)xtrabackup【xtra-拜克阿普】是一个对innodb【伊诺 DB】做数据备份的工具,支持在线热备份(备份时不影响数据读写),是商业备份工具innodb【伊诺 DB】 Hotbackup的一个很好的替代品。
- 2)xtrabackup【xtra-拜克阿普】有两个主要的工具:xtrabackup【xtra-拜克阿普】、innobackupex
- a、xtrabackup【xtra-拜克阿普】只能备份innodb【伊诺 DB】和XtraDB【插穴-DB】两种数据表,不能备份myisam类型的表。
- b、innobackupex是将xtrabackup【xtra-拜克阿普】进行封装的perl脚本,所以能同时备份处理innodb【伊诺 DB】和myisam【迈-艾塞姆】的存储引擎,但在处理myisam【迈-艾塞姆】时需要加一个读锁。
② mydumper【my-邓破儿~】(逻辑备份,备份SQL语句)
多线程备份工具 https://launchpad.net/mydumper/mydumper-0.9.1.tar.gz 2015-11-06(最后更新时间)
6、备份方法
完全备份 增量备份
四、MySQL逻辑备份
1、mysqldump【mysql-当普】基本备份
- 本质:导出的是sql语句文件
- 优点:无论是什么存储引擎,都可以用mysqldump【mysql-当普】备份成sql语句
- 缺点:速度较慢,导入时可能会出现格式不兼容的突发状况,无法直接做增量备份提供三种级别的备份,表级,库级和全库级
2、mysqldump【mysql-当普】基本语法
#表级别备份mysqldump【mysql-当普】 [OPTIONS]【阿普申s】 database【得塔-贝斯】 [table【忒-部】s]#库级别备份mysqldump【mysql-当普】 [OPTIONS]【阿普申s】 --databases【得塔-贝斯】 [OPTIONS]【阿普申s】 DB1 [DB2 DB3...]#全库级别备份mysqldump【mysql-当普】 [OPTIONS]【阿普申s】 --all【哦】-databases【得塔-贝斯】 [OPTIONS]【阿普申s】准备一些要备份的数据:
mysql> create【克瑞特】 database【得塔-贝斯】 db_fq default【迪-佛特】 charset【查赛特】=utf8;mysql> use db_fq;mysql> create【克瑞特】 table【忒-部】 tb_student【tb_斯丢等特】( id int【因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, name varchar【瓦儿-查儿】(20), age【诶吉】 tinyint【泰尼因特】 unsigned【安赛因德】 default【迪-佛特】 0, gender【詹德尔】 enum【伊牛姆】('male','female'), subject【萨布杰克特】 enum【伊牛姆】('ui','java','yunwei','python'), primary【普赖莫瑞】 key【发音'ki'】(id)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'刘备','33','male','java');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'关羽','32','male','yunwei');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'张飞','30','male','python');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'貂蝉','18','female','ui');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'大乔','18','female','ui');
# mysql> create database db_fq default charset=utf8;# Query OK, 1 row affected (0.00 sec)## mysql> use db_fq;# Database changed# mysql> create table tb_student(# -> id int not null auto_increment,# -> name varchar(20),# -> age tinyint unsigned default 0,# -> gender enum('male','female'),# -> subject enum('ui','java','yunwei','python'),# -> primary key(id)# -> ) engine=innodb default charset=utf8;# Query OK, 0 rows affected (0.45 sec)## mysql> insert into tb_student values (null,'刘备','33','male','java');# Query OK, 1 row affected (0.09 sec)## mysql> insert into tb_student values (null,'关羽','32','male','yunwei');# Query OK, 1 row affected (0.06 sec)## mysql> insert into tb_student values (null,'张飞','30','male','python');# Query OK, 1 row affected (0.05 sec)## mysql> insert into tb_student values (null,'貂蝉','18','female','ui');# Query OK, 1 row affected (0.07 sec)## mysql> insert into tb_student values (null,'大乔','18','female','ui');# Query OK, 1 row affected (0.16 sec)#3、mysqldump【mysql-当普】表级备份与还原
⭐备份
案例:把db_fq数据库中的tb_student【tb_斯丢等特】数据表进行备份
#mkdir【摸克跌儿】 /tmp/sqlbak#mysqldump【mysql-当普】 db_fq tb_student【tb_斯丢等特】 > /tmp/sqlbak/tb_student【tb_斯丢等特】.sql -p⭐还原
# mysql 数据库名称 < .sql文件位置 -pEnter password【帕斯沃德】:123或#mysql -uroot -pEnter password【帕斯沃德】:123mysql > use db_fq;mysql > source .sql文件位4、mysqldump【mysql-当普】库级备份与还原
⭐备份
单库
案例:把db_fq数据库进行备份
#mysqldump【mysql-当普】 --databases【得塔-贝斯】 db_fq > /tmp/sqlbak/db_fq.sql -p多库
案例:把db_fq2和db30数据库进行备份
#mysqldump【mysql-当普】 --databases【得塔-贝斯】 db_fq2 db30 > /root/sqlbak/db_fq2-db30.sql -p⭐还原
# mysql < .sql文件位置 -pEnter password【帕斯沃德】:123或# mysq -uroot -pEnter password【帕斯沃德】:123mysql > source .sql文件的位置
-- 通过 -D参数直接指定数据库,一步到位mysql -u root -p -D your_database < /path/to/your_database.sql5、mysqldump【mysql-当普】全库级备份
在MySQL中,如果想使用mysqldump【mysql-当普】进行全库备份,必须开启二进制日志!!!
开启二进制日志
#vim my.cnf[mysqld]...server【涩·沃】-id=1log_bin=/mysql_3306/data/binlog【宾-劳格】#service【瑟为斯】 mysql_3306 restart【 率 s 达r】mysqldump【mysql-当普】高级选项说明:
| 常用选项 | 描述说明 |
|---|---|
| —flush【福 辣 徐】-logs,-F | 开始备份前刷新日志(二进制日志)binlog【宾-劳格】.000001 =>binlog【宾-劳格】.000002 |
| —flush【福 辣 徐】-privileges【P符类 杰 斯】 | 备份包含mysql数据库时刷新授权表 => 刷新用户和授权信息 |
| —lock【拉克】-all【哦】-table【忒-部】s,-x | MyISAM【迈-艾塞姆】一致性,服务可用性(针对所有库所有表) |
| —lock【拉克】-table【忒-部】s,-l | 备份前锁表(针对要备份的库) |
| —single【辛格欧】-transaction【穿插神】 | 适用innodb【伊诺 DB】引擎,保证一致性,服务可用性 |
| —master【马斯特】-data=2 | 表示将二进制日志位置和文件名写入到备份文件并在dump文件中注释掉这一行 |
| —master【马斯特】-data=1 | 表示将二进制日志位置和文件名写入到备份文件,在dump文件中不注释这一行 |
—master【马斯特】-data参数其他说明:
- 1)恢复时会执行,默认是1
- 2)需要RELOAD【率漏德】 privilege【P符类 杰 】并必须打开二进制文件
- 3)这个选项会自动打开—lock-all【哦】-table【忒-部】s,关闭—lock-table【忒-部】s
⭐备份
前提:一定要开启二进制日志
#mysqldump【mysql-当普】 --all【哦】--databases【得塔-贝斯】 --master【马斯特】-data --single【辛格欧】-transaction【穿插神】 > /tmp/sqlbak/all【哦】.sql -pEnter password【帕斯沃德】:123
说明:1.--all-databases【得塔-贝斯】:备份所有数据库(注意拼写)2.--master【马斯特】-data:在备份中包含二进制日志位置信息(用于复制)3.--single【辛格欧】-transaction【穿插神】:使用事务保证备份一致性(适合 InnoDB 表)4.> sqlbak/all.sql:输出到指定文件5.-p:提示输入密码⭐还原
#mysql < all【哦】.sql -pEnter password【帕斯沃德】:123总结
- mysqldump【mysql-当普】工具备份的是SQL语句,故备份不需要停服务
- 使用备份文件恢复时,要保证数据库处于运行状态
- 只能实现全库,指定库,表级别的某一时刻的备份,本身不能增量备份
- 适用于中小型数据库
五、mysqldump【mysql-当普】 + binlog【宾-劳格】实现增量备份
1、核心思路
什么是增量备份?
答:
- ①要有全量备份
- ②继续增删改数据
- ③再次需要备份时i,不需要进行全量备份,
- 只需要备份binlog【宾-劳格】日志文件即可(因为binlog【宾-劳格】日志记记录了增删改操作的所有SQL语句)
2、增量备份实验步骤
- 第一步:先准备数据(前提)
- 第二步:开启二进制,然后做全量备份(全库备份)
- 第三步:继续对数据库进行增删改操作
- 第四步:突然发生了硬件故障,数据库丢失了
- 第五步:恢复全量备份导出的数据(不完整,可能只有90%)
- 第六步:备份二进制日志,根据其信息(导入剩余的10%的数据)
- …
- 完成
3、增量备份的具体实践
第一步:准备数据
mysql> create【克瑞特】 database【得塔-贝斯】 db_fq default【迪-佛特】 charset【查赛特】=utf8;mysql> use db_fq;mysql> create【克瑞特】 table【忒-部】 tb_student【tb_斯丢等特】( id int【因特】 not【nuō 特】 null【nò】 auto_increment【奥特欧_因克瑞门特】, name varchar【瓦儿-查儿】(20), age【诶吉】 tinyint【泰尼因特】 unsigned【安赛因德】 default【迪-佛特】 0, gender【詹德尔】 enum【伊牛姆】('male','female'), subject【萨布杰克特】 enum【伊牛姆】('ui','java','yunwei','python'), primary【普赖莫瑞】 key【发音'ki'】(id)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8;mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'刘备','33','male','java');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'关羽','32','male','yunwei');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'张飞','30','male','python');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'貂蝉','18','female','ui');mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'大乔','18','female','ui');
# mysql> create database db_fq default charset=utf8;# mysql> use db_fq;# mysql> create table tb_student(# id int not null auto_increment,# name varchar(20),# age tinyint unsigned default 0,# gender enum('male','female'),# subject enum('ui','java','yunwei','python'),# primary key(id)# ) engine=innodb default charset=utf8;# mysql > insert into tb_student values (null,'刘备','33','male','java');# mysql > insert into tb_student values (null,'关羽','32','male','yunwei');# mysql > insert into tb_student values (null,'张飞','30','male','python');# mysql > insert into tb_student values (null,'貂蝉','18','female','ui');# mysql > insert into tb_student values (null,'大乔','18','female','ui');第二步:开启二进制日志,重启服务,然后进行全库备份
[root@mysql ~]# vim my.cnf[mysqld]...server【涩·沃】-id=1log_bin=/mysql_3306/data/binlog【宾-劳格】
[root@mysql ~]# service【瑟为斯】 mysql_3306 restart【 率 s 达r】[root@mysql ~]# rm -rf /tmp/sqlbak/*[root@mysql ~]# mysqldump【mysql-当普】 --single【辛格欧】-transaction【穿插神】 --flush【福 辣 徐】-logs --master【马斯特】-data=2 --all-databases【得塔-贝斯】 > /tmp/sqlbak/all.sql -p
#[root@mysql ~]# mysqldump --single-transaction --flush-logs --master-data=2 --all-databases【得塔-贝斯】 > sqlbak/all.sql -p第三步:继续对数据库进行增删改操作
mysql > insert【因涩特】 into【因兔】 tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'小乔',16,'female','ui');mysql > delete【迪 利 特】from【弗乱】 tb_student【tb_斯丢等特】 where【威尔】 id = 3;# mysql> insert into tb_student values (null,'小乔',16,'female','ui');# Query OK, 1 row affected (0.12 sec)## mysql> delete from tb_student where id=3;# Query OK, 1 row affected (0.16 sec)#第四步:突然发生了硬件故障,数据库丢失了
#mysql -e "drop【卓-普】 database【得塔-贝斯】 db_fq;" -pEnter password【帕斯沃德】:123…故事了(删库)
第五步:动员运维工程师开始进行数据恢复,马上把最新的二进制文件进行备份
#cp /mysql_3306/data/binlog【宾-劳格】.000006 /tmp/sqlbak第六步:先进行全库恢复
#mysql < /tmp/sqlbak/all.sql -pEnter password【帕斯沃德】:123第七步:通告binlog【宾-劳格】增量备份还原数据到100%
学会读二进制日志文件,必须通过专业工具
[root@mysql ~]# mysqlbinlog【mysql-宾-劳格】 /tmp/sqlbak/binlog【宾-劳格】.000006 =》重点找事故的临界点,如drop【卓-普】 database【得塔-贝斯】 确认at位置[root@mysql ~]# mysqlbinlog【mysql-宾-劳格】 --start【s 达儿】-position【珀谁申】=4 --stop【 s 多】-position【珀谁申】=720 /tmp/sqlbak/binlog【宾-劳格】.000006 |mysql -p
# [root@mysql ~]# mysqlbinlog sqlbak/binlog.000002# /*!50530 SET @@SESSION.PSEUDO_SLAVE_MODE【眸的】=1*/;# /*!50003 SET @OLD_COMPLETION_TYPE=@@COMPLETION_TYPE,COMPLETION_TYPE=0*/;# DELIMITER /*!*/;# at 4# #250902 13:40:56 server【涩·沃】 id 1 end_log_pos 123 CRC32 0x1a85e54f Start: binlog v 4, server【涩·沃】 v 5.7.31-log created 250902 13:40:56# Warning: this binlog is either in use or was not closed properly.# BINLOG '# aIO2aA8BAAAAdwAAAHsAAAABAAQANS43LjMxLWxvZwAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAA# AAAAAAAAAAAAAAAAAAAAAAAAEzgNAAgAEgAEBAQEEgAAXwAEGggAAAAICAgCAAAACgoKKioAEjQA# AU/lhRo=# '/*!*/;# at 123# .........# [root@mysql ~]# mysqlbinlog --start【s 达儿】-position【珀谁申】=4 --stop【 s 多】-position【珀谁申】=783 sqlbak/binlog.000002 | mysql -p# Enter password:# [root@mysql ~]#
说明:1. mysqlbinlog sqlbak/binlog.000002 命令是读取binlog日记,检索你需要恢复的操作范围2. --start【s 达儿】-position【珀谁申】=4 是你需要恢复的起始位置3. --stop【 s 多】-position【珀谁申】=783 是你需要恢复的结束位置4. 起始和结束位置是binlog文件中的'at 数字'位置day05-MySQL备份与恢复(二)
一、逻辑备份
1、回顾什么是逻辑备份
逻辑备份就是把数据库、数据包或者数据进行导出,导出到一个文本文件中。
2、逻辑备份工具
- mysqldump【mysql-当普】:提供全库级、数据库级别以及表级别的数据备份
- mysqldump【mysql-当普】+binlog【宾-劳格】:二进制日志实现增量备份
3、逻辑的导出与导入
⭐导出(数据备份)
无论是什么存储引擎,以下方式本身是一种数据导出的方法,同时可以用来辅助备份,它可以对一个表的其中一列或者某几列做备份。备份的是数据记录
案例:把tb_student数据表中的数据记录进行逻辑导出
#mysql -uroot -pEnter password【帕斯沃德】:123mysql > select【涩莱克特】 * into【因兔】 outfile【奥特-伐尔】'/tmp/sqlbak/tb_student【tb_斯丢等特】.txt' from【弗乱】 db_fq.tb_student【tb_斯丢等特】;ERROR 1290 (HY000): The MySQL server【涩·沃】 is running【乱宁】 with【威付】 the --secure-file-priv option【阿普申】 so it cannot execute this statement【斯忒特门特】出现以上问题的主要原因在于我们没有指定MySQL逻辑导出时指定的路径
#vim my.cnf[mysqld]...secure【瑟Q儿】_file【伐尔】_priv【破略夫】=/tmp/sqlbak
[root@mysql ~]# mkdir【摸克跌儿】 /tmp/sqlbak[root@mysql ~]# chown【吃-昂】 -R mysql:mysql /tmp/sqlbak[root@mysql ~]#chmod【吃-默德】-R 750 /tmp/sqlbak[root@mysql ~]# service【瑟为斯】 mysql_3306 restart【 率 s 达r】mysql > select【涩莱克特】 * into【因兔】 outfile【奥特-伐尔】 '/tmp/sqlbak/tb_student【tb_斯丢等特】.txt' from【弗乱】 db_fq.tb_student【tb_斯丢等特】;ERROR 1 (HY000): Can't create/write to file '/tmp/sqlbak/tb_student.txt' (Errcode: 13 - Permission denied)出现以上问题的主要原因在于mysql账户对/tmp/sqlbak没有写入权限
#setfacl -m u:mysql:rwx /tmp/sqlbak⭐导入(数据还原)
#mysql -uroot -pEnter password【帕斯沃德】:123mysql> truncate【创kí特】 tb_student【tb_斯丢等特】;mysql> load【漏德】 data local infile【因-伐尔】 '/tmp/sqlbak/tb_student【tb_斯丢等特】.txt' into【因兔】 table【忒-部】 tb_student【tb_斯丢等特】;或#mysqlimport dbname /path/file -p => 要求,导出的文件必须何数据表名称完全一致例如:#mysqlimport db_fq /tmp/sqlbak/tb_student【tb_斯丢等特】.txt -pEnter password【帕斯沃德】:123典型应用场景:可以把一些规则的文本文件导入到数据表中 案例:把/etc/passwd文件中的数据导入到password【帕斯沃德】数据表中 第一步:创建一个password【帕斯沃德】数据表,password【帕斯沃德】是mysql保留关键字,建议适用“反引号括起来
mysql > use db_fq;mysql> create【克瑞特】 table【忒-部】 `password【帕斯沃德】` ( `uname` varchar【瓦儿-查儿】(50) default【迪-佛特】 null【nò】, `pass` char【查尔】(2) default【迪-佛特】 null【nò】, `uid` int(11) default【迪-佛特】 null【nò】, `gid` int(11) default【迪-佛特】 null【nò】, `comment【坑门特】` varchar【瓦儿-查儿】(255) default【迪-佛特】 null【nò】, `home` varchar【瓦儿-查儿】(50) default【迪-佛特】 null【nò】, `shell` varchar【瓦儿-查儿】(50) default【迪-佛特】 null【nò】) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】 default【迪-佛特】 charset【查赛特】=utf8mb4;
# mysql> create table `password` (# -> `uname` varchar(50) default null,# -> `pass` char(2) default null,# -> `uid` int(11) default null,# -> `gid` int(11) default null,# -> `comment` varchar(255) default null,# -> `home` varchar(50) default null,# -> `shell` varchar(50) default null# -> ) engine=innodb default charset=utf8mb4;# Query OK, 0 rows affected (0.40 sec)## mysql>- 第二步:把/etc/passwd文件拷贝到/tmp/sqlbak目录下,起名叫password【帕斯沃德】.txt
#cp /etc/passwd /tmp/sqlbak/password【帕斯沃德】.txt- 第三步:使用mysqlimport把password【帕斯沃德】.txt文件中的内容写入到数据表
[root@mysql ~]# mysqlimport db_fq --fields-terminated-by=':' --lines-terminated-by='\n' /tmp/sqlbak/password【帕斯沃德】.txt -pEnter password【帕斯沃德】:db_fq.password【帕斯沃德】: Records: 25 Deleted: 0 Skipped: 0 Warnings: 0
选项说明--fields-terminated-by=':',指定导出文件的分隔符为冒号:--lines-terminated-by='\n',指定每一行的结尾使用的符号,\n代表换行符4、扩展:逻辑备份还原小工具
MySQL其实还支持很多管理软件(windows版):MySQL-Front、Navicat
-
第一步:选择MySQL连接
-
第二步:输入MySQL连接信息
-
第三步:功能演示=> 创建数据库、创建数据表、插入数据…
-
第四步:数据库的备份与还原
①逻辑的导出与导入
②数据表的备份和还原
③数据库的备份与还原
二、物理备份
1、xtrabackup【xtra-拜克阿普】备份介绍
㈠ xtrabackup【xtra-拜克阿普】优缺点
优点:
- 备份过程快速、可靠(因为是物理备份);
- 支持增量备份,更为灵活
- 备份过程不会打断正在执行的事务;
- 能够基于压缩等功能节约磁盘空间和流量;
- 自动实现备份检验;
- 还原速度快;
缺点:
- 只能对innodb【伊诺 DB】表增量备份,myisam【迈-艾塞姆】表增量备份时是全备
- innobackupex备份MyISAM【迈-艾塞姆】表之前要对全库进行加READ【滤德】 LOCK【拉克】,阻塞写操作,若备份是在从库上进行的话会影响主从同步,造成延迟。对innodb【伊诺 DB】表备份不会阻塞读写。
㈡ xtrabackup【xtra-拜克阿普】备份原理
- innobackupex首先会启动一个xtrabackup_log【埃斯-拜克阿普-劳格】后台检测的进程,实时检测mysql的redo【率度】 log的变化,一旦发现redo【率度】有新的日志写入,立刻将日志写入到日志文件xtrabackup_log【埃斯-拜克阿普-劳格】中。
- 物理拷贝innodb【伊诺 DB】的数据文件和系统表空间文件idbdata1到对应的以默认时间戳为备份目录的地方
- 复制结束后,执行flush【福 辣 徐】 table【忒-部】 with【威付】 read【滤德】 lock【拉克】操作进行全库锁表准备备份非innodb【伊诺 DB】文件
- 物理复制.frm .myd .myi等非innodb【伊诺 DB】引擎文件到备份目录
- 查看二进制日志的位置
- 解锁表unlock【嗯 拉克】 table【忒-部】s
- 停止xtrabackup_log【埃斯-拜克阿普-劳格】进程
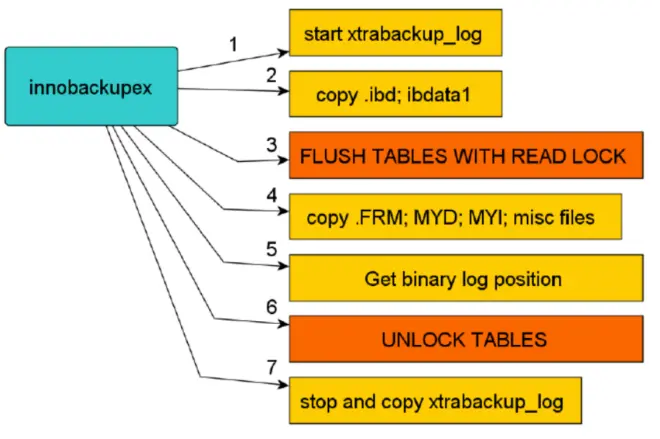
扩展:redo【率度】 log日志
- 事务日志或称redo【率度】日志,在mysql中默认以ib_logfile0,ib_logfile1名称存在。
- redo【率度】 log通常是物理日志,记录的是数据页的物理修改,而不是某一行或某几行修改成怎样怎样,它用来恢复提交后的物理数据页(恢复数据页,且只能恢复到最后一次提交的位置)。
㈢ xtrabackup【xtra-拜克阿普】备份恢复原理
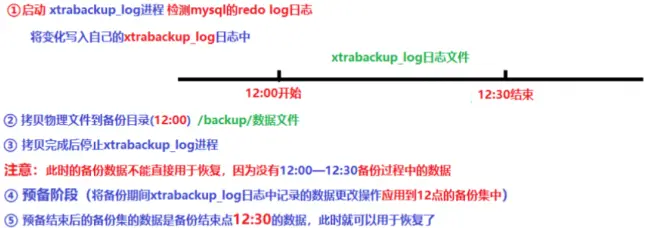
具体文字描述如下(了解):
-
在innodb【伊诺 DB】内部会维护一个redo【率度】日志文件,我们也可以叫做事务日志文件。事务日志会存储每一个innodb【伊诺 DB】表数据的记录修改。当innodb【伊诺 DB】启动时,innodb【伊诺 DB】会检查数据文件和事务日志,并执行两个步骤:它应用(前滚)已经提交的事务日志到数据文件,并将修改过但没有提交的数据进行回滚操作。
-
xtrabackup【xtra-拜克阿普】在启动时会记住log sequence【西・捆斯】 number【能波】(LSN),并且复制所有的数据文件。复制过程需要一些时间,所以这期间如果数据文件有改动,那么将会使数据库处于一个不同的时间点。这时,xtrabackup【xtra-拜克阿普】会运行一个后台进程,用于监视事务日志,并从事务日志复制最新的修改。xtrabackup【xtra-拜克阿普】必须持续的做这个操作,是因为事务日志是会轮转重复的写入,并且事务日志可以被重用。所以xtrabackup【xtra-拜克阿普】自启动开始,就不停的将事务日志中每个数据文件的修改都记录下来。
-
上面就是xtrabackup【xtra-拜克阿普】的备份过程。接下来是准备(prepare【普・佩尔】)过程。在这个过程中,xtrabackup【xtra-拜克阿普】使用之前复制的事务日志,对各个数据文件执行灾难恢复(就像MySQL刚启动时要做的一样)。当这个过程结束后,数据库就可以做恢复还原了。
-
以上的过程在xtrabackup【xtra-拜克阿普】的编译二进制程序中实现。程序innobackupex可以允许我们备份MyISAM【迈-艾塞姆】表和frm文件从而增加了便捷和功能。Innobackupex会启动xtrabackup【xtra-拜克阿普】,直到xtrabackup【xtra-拜克阿普】复制数据文件后,然后执行FLUSH【福 辣 徐】 table【忒-部】S WITH【威付】 READ【滤德】 LOCK【拉克】来阻止新的写入进来并把MyISAM【迈-艾塞姆】表数据刷到硬盘上,之后复制MyISAM【迈-艾塞姆】数据文件,最后释放锁。
-
备份MyISAM【迈-艾塞姆】和innodb【伊诺 DB】表最终会处于一致,在准备(prepare【普・佩尔】)过程结束后,innodb【伊诺 DB】表数据已经前滚到整个备份结束的点,而不是回滚到xtrabackup【xtra-拜克阿普】刚开始时的点。这个时间点与执行FLUSH【福 辣 徐】 table【忒-部】S WITH【威付】 READ【滤德】 LOCK【拉克】的时间点相同,所以MyISAM【迈-艾塞姆】表数据与innodb【伊诺 DB】表数据是同步的。类似Oracle【欧 瑞 扣】的recover【率 卡沃】和restore【瑞斯多尔】,innodb【伊诺 DB】的prepare【普・佩尔】过程可以称为recover【率 卡沃】(恢复),MyISAM【迈-艾塞姆】的数据复制过程可以称为restore【瑞斯多尔】(还原)。
2、获取xtrabackup【xtra-拜克阿普】备份工具
网站域名:www.percona.com
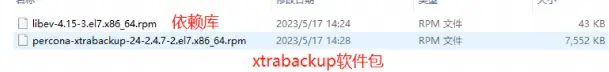
3、xxtarbackup软件的安装
- 第一步:上传软件及依赖库到Linux服务器端
- 第二步:安装依赖库
#rpm -ivh libev-4.15-3.el7.x86_64.rpm- 第三步:安装xtrabackup【xtra-拜克阿普】软件
#yum install【因-斯多】 percona-xtrabackup【xtra-拜克阿普】-24-2.4.7-2.el7.x86_64.rpm -y4、xtrabackup【xtra-拜克阿普】全库备份与恢复
备份核心思路:
- 使用innobackupex对数据库中的所有库进行全量备份,备份完成后,不能立即进行数据恢复(数据不完成,缺少12:00~12:30这个过程中的数据)
- 预备阶段,备份过程中产生的xtrabackup_log【埃斯-拜克阿普-劳格】应用到全量备份集
- 模拟故障(删除数据) => rm -rf data/*
- 动员运维工程师进行全库恢复
- 测试验证
第一步:准备数据
mysql > create【克瑞特】 database【得塔-贝斯】 db_sql default【迪-佛特】 charset【查赛特】=utf8;mysql > use db_sql;mysql > create【克瑞特】 table【忒-部】 t1(id int,name varchar【瓦儿-查儿】(10)) engine【 嗯(ing) 京(白话读音) 】=myisam【迈-艾塞姆】;mysql > insert【因涩特】 into【因兔】 t1 values【挖柳斯】 (1,'吕布');mysql > create【克瑞特】 table【忒-部】 t2(id int,name varchar【瓦儿-查儿】(10)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】;mysql > insert【因涩特】 into【因兔】 t2 values【挖柳斯】 (1,'貂蝉');第二步:准备一个数据库备份账号,开通相应权限
创建备份用户admin,并授予相应权限mysql> grant【古亮普】 reload【率漏德】,process【坡塞斯】,lock【拉克】 table【忒-部】s,replication【瑞普利K申】 client【克莱恩特】 on【昂】 *.* to 'admin'@'localhost' identified【爱-丹-提伐】 by【拜】 'mysql123';mysql> flush【福 辣 徐】 privileges【P符类 杰 斯】;
说明:在数据库中需要以下权限:RELOAD【率漏德】和LOCK【拉克】 table【忒-部】S权限:为了执行FLUSH【福 辣 徐】 table【忒-部】S WITH【威付】 READ【滤德】 LOCK【拉克】REPLICATION【瑞普利K申】 CLIENT【克莱恩特】权限:为了获取binary【拜讷瑞】 log位置PROCESS【坡塞斯】权限:显示有关在服务器中执行的线程的信息(即有关会话执行的语句的信息),允许使用SHOW【瘦】 engine【 嗯(ing) 京(白话读音) 】第三步:使用innobackupex工具进行备份
[root@mysql ~]# innobackupex --user=admin --password【帕斯沃德】=mysql123 /full_xtrabackup【xtra-拜克阿普】IMPORTANT: Please check【切克】 that the backup run completes successfully. At the end of a successful backup run innobackupex prints "completed OK!".- 第一次运行报错
[root@mysql ~]# innobackupex --user=admin --password【帕斯沃德】=mysql123 /full_xtrabackup250903 16:48:51 innobackupex: Starting the backup operation
IMPORTANT: Please check【切克】 that the backup run completes successfully. At the end of a successful backup run innobackupex prints "completed OK!".
Can't locate Digest/MD5.pm in @INC (@INC contains: /usr/local/lib64/perl5 /usr/local/share/perl5 /usr/lib64/perl5/vendor_perl /usr/share/perl5/vendor_perl /usr/lib64/perl5 /usr/share/perl5 .) at - line 693.BEGIN failed--compilation aborted at - line 693.250903 16:48:52 Connecting to MySQL server host: localhost, user: admin, password【帕斯沃德】: set, port【破特】: not set, socket: not setFailed to connect to MySQL server: Can't connect to local MySQL server through socket '/var/lib/mysql/mysql.sock' (2).[root@mysql ~]#- 出现以上问题的原因主要在于我们的mysql.sock并不在/var/lib/mysql目录下,和Perl 模块缺失
- 错误一:Can’t locate Digest/MD5.pm in @INC … 这是一个 Perl 模块缺失的错误。innobackupex是一个用 Perl 编写的脚本,它运行时需要 Digest::MD5这个 Perl 模块
- 原因:您的系统上可能没有安装这个必要的 Perl 模块。
- 解决方案:安装 perl-Digest-MD5包。
[root@mysql ~]# yum install【因-斯多】 -y perl-Digest-MD5[root@mysql ~]# yum install【因-斯多】 -y perl-DBD-MySQL-
为什么会自动连接/var/lib/mysql目录下的mysql.sock呢?
-
原因1:可能在/etc目录下还有my.cnf文件,影响了innobackupex的执行
-
原因2:innobackupex拥有自己的默认配置,默认读取了/var/lib/mysql/mysql.sock文件
-
解决方案: 方案1:把你的套接字文件创建一个软链接,放置于/var/lib/mysql/mysql.sock文件中
[root@mysql ~]# mkdir【摸克跌儿】 /var/lib/mysql[root@mysql ~]# ln -s /tmp/mysql.sock /var/lib/mysql/mysql.sock方案2:;在innobackupex中添加一个-S选项,执行套接字
[root@mysql ~]# innobackupex -S /tmp/mysql.sock --user=admin --password【帕斯沃德】=mysql123 /full_xtrabackup【xtra-拜克阿普】第四步:预备阶段,把备份这段时间内产生的日志整合到全量备份中
[root@mysql ~]# innobackupex --user=admin --password【帕斯沃德】=mysql123 --apply0【阿普来】-log /full_xtrabackup【xtra-拜克阿普】/2024-01-06_11-12-53第五步:模拟数据库故障
[root@mysql ~]# rm -rf /mysql_3306/data/*[root@mysql ~]# pkill mysqld[root@mysql ~]# # systemctl【西斯屯-ctl】 stop【 s 多】 mysql_3306.service第六步:快速的恢复数据库中的数据
[root@mysql ~]# rm -rf /mysql_3306/data/*[root@mysql ~]# innobackupex --copy-back /full_xtrabackup【xtra-拜克阿普】/2024-01-06_11-12-53第一次恢复报错
[root@mysql ~]# innobackupex --copy-back /full_xtrabackup/2025-09-03_17-28-59250903 18:00:47 innobackupex: Starting the copy-back operation
IMPORTANT: Please check【切克】 that the copy-back run completes successfully. At the end of a successful copy-back run innobackupex prints "completed OK!".
innobackupex version 2.4.7 based on MySQL server 5.7.13 Linux (x86_64) (revision id: 05f1fcf)Error: datadir must be specified.-
出现以上问题的主要原因在于,innobackupex工具无法找到MySQL中的数据目录
-
解决方案:把my.cnf配置文件传递给innobackupex,让其自动识别这个文件中的datadir
[root@mysql ~]# innobackupex --default【迪-佛特】s-file=/mysql_3306/my.cnf --copy-back /full_xtrabackup【xtra-拜克阿普】/2024-01-06_11-12-53第七步:恢复数据时,一定要记得更改/mysql_3306/data目录下的文件拥有者以及所属组权限,否则mysql无法启动
[root@mysql ~]# chown【吃-昂】 -R mysql.mysql /mysql_3306/data第八步:启动MySQL,测试是否正常
[root@mysql ~]# service【瑟为斯】 mysql_3306 start【s 达儿】[root@mysql ~]# mysql -pEnter password【帕斯沃德】:1235、xtrabackup【xtra-拜克阿普】增量备份与恢复
什么是增量?增量一定要有一个前提,必须要现有一个全量
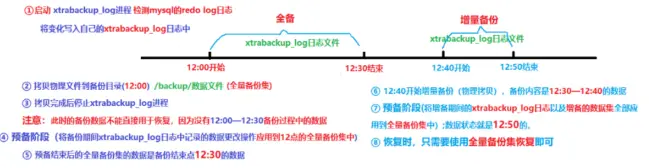
- ①全量备份
- ②把全量备份产生的日志整合到全量备份
- ③进行数据的增删改操作
- ④增量备份
- ⑤把增量备份及备份产生的日志文件全部整合到全量备份中
- ⑥模拟故障
- ⑦数据恢复
- ⑧启动数据库,测试验证数据
第一步:准备数据
mysql > create【克瑞特】 database【得塔-贝斯】 db_sql default【迪-佛特】 charset【查赛特】=utf8;mysql > use db_sql;mysql > create【克瑞特】 table【忒-部】 t1(id int,name varchar【瓦儿-查儿】(10)) engine【 嗯(ing) 京(白话读音) 】=myisam【迈-艾塞姆】;mysql > insert【因涩特】 into【因兔】 t1 values【挖柳斯】 (1,'吕布');mysql > create【克瑞特】 table【忒-部】 t2(id int,name varchar【瓦儿-查儿】(10)) engine【 嗯(ing) 京(白话读音) 】=innodb【伊诺 DB】;mysql > insert【因涩特】 into【因兔】 t2 values【挖柳斯】 (1,'貂蝉');第二步:创建一个账号,专门用于备份
创建备份用户admin,并授予相应权限mysql> grant【古亮普】 reload【率漏德】,process【坡塞斯】,lock【拉克】 table【忒-部】s,replication【瑞普利K申】 client【克莱恩特】 on【昂】 *.* to 'admin'@'localhost' identified【爱-丹-提伐】 by【拜】 'mysql123';mysql> flush【福 辣 徐】 privileges【P符类 杰 斯】;
# mysql> grant reload,process,lock tables,replication client on *.* to 'admin'@'localhost' identified by 'mysql123';# Query OK, 0 rows affected, 1 warning (0.05 sec)# mysql> flush privileges;
说明:在数据库中需要以下权限:1. RELOAD【率漏德】和LOCK table【忒-部】S权限:为了执行FLUSH【福 辣 徐】 table【忒-部】S WITH【威付】 READ【滤德】 LOCK【拉克】2. REPLICATION【瑞普利K申】 CLIENT【克莱恩特】权限:为了获取binary【拜讷瑞】 log位置3. PROCESS【坡塞斯】权限:显示有关在服务器中执行的线程的信息(即有关会话执行的语句的信息),允许使用SHOW【瘦】 engine【 嗯(ing) 京(白话读音) 】第三步:全量备份
[root@mysql ~]# rm -rf /full_xtrabackup【xtra-拜克阿普】/*[root@mysql ~]# innobackupex --user=admin --password【帕斯沃德】=mysql123 /full_xtrabackup【xtra-拜克阿普】/第四步:把全备过程中产生的日志进行整合
[root@mysql ~]# innobackupex --user=admin --password【帕斯沃德】=mysql123 --apply【阿普来】-log --redo【率度】-only【欧利】 /full_xtrabackup【xtra-拜克阿普】/2024-01-06_17-29-11
选项说明:1. "--apply【阿普来】-log" 表示整合日志2. "--redo【率度】-only【欧利】" 表示只应用以及提交的事务,不回滚未提交的事务(12:00~12:30产生很多事务操作,事务处理=>开启事务,成功了提交事务,写入磁盘,失败了回滚事务,不写入硬盘)注意:如果已经回滚了未提交事务,那么就无法再应用增量备份Preparing an Incremental Backup with【威付】 innobackupex Preparing incremental backups is a bit diƊerent than full ones. This is, perhaps, the stage where【威尔】 more attention is needed: • First, only【欧利】 the committed transactions must be replayed on each backup. This will merge the base full backup with【威付】 the incremental ones. • Then, the uncommitted transaction must be rolled back in order【欧朵】 to have a ready-to-use backup. 对于增量备份的Prepare【普・佩尔】阶段,有2个需要注意的地方,一个是提交的事务需要 replayed,一个未提交的事务需要rollback【柔拜克】。 If you replay the committed transactions and rollback【柔拜克】 the uncommitted ones on the base backup, you will not【nuō 特】 be able to add the incremental ones. If you do this on an incremental one, you won’t be able to add data from【弗乱】 that moment and the remaining increments. Having【嗨夫营】 this in mind, the procedure is very straight-forward using the —redo【率度】-only【欧利】 option【阿普申】, starting with【威付】 the base backup: 如果在Prepare【普・佩尔】阶段replay了已提交的事务以及回滚了未提交的事务,则后续 的增量备份无法添加到当前全备。因此在Prepare【普・佩尔】阶段全备应使用—redo【率度】-only【欧利】 选项。 —redo【率度】-only【欧利】 should be used when merging all incrementals except the last one. That’s why the previous line doesn’t contain the —redo【率度】-only【欧利】 option【阿普申】. Even if the —redo【率度】-only【欧利】 was used on the last step, backup would still be consistent but in that case server would perform the rollback【柔拜克】 phase. 对于存在多次增量的情形,仅仅只有最后一个增量不需要使用—redo【率度】-only【欧利】 选 项。如果使用了的话,rollback【柔拜克】将由服务器启动的时候来完成。
第五步:修改数据(进行增删改操作,让其产生增量数据)
#mysql -pEnter password【帕斯沃德】:123mysql > insert【因涩特】 into【因兔】 db_sql.t1 values【挖柳斯】 (2,'王朗');mysql > insert【因涩特】 into【因兔】 db_sql.t1 values【挖柳斯】 (3,'袁术');第六步:做增量备份
[root@mysql ~]# innobackupex --user=admin --password【帕斯沃德】=mysql123 --incremental /incre_backup --incremental-basedir=/full_xtrabackup【xtra-拜克阿普】/2024-01-06_17-29-11
选项说明:1. "--incremental" 设置增量备份目录"/incre_backup"2. "--incremental-basedir" 这个增量是相对于哪个全量的第七步:把增量备份产生的数据以及日志文件整合到全量备份中
[root@mysql ~]# innobackupex --user=admin --password【帕斯沃德】=mysql123 --apply【阿普来】-log /full_xtrabackup【xtra-拜克阿普】/2024-01-06_17-29-11 --incremental-dir=/incre_backup/2024-01-06_17-39-15
说明:1. "--redo【率度】-only【欧利】" 除了最后一个不用加之外,其他的增量应用都要加,最后一个应用的时候可以直接进入回滚未提交事务阶段;如果加了也没事,服务启动的时候会进入recovery【率 卡沃】过程,来回滚2. 应用增量备份的时候只能按照备份的顺序来应用。如果应用顺序错误,那么备份就不可用。如果无法确定顺序,可以使用xtrabackup【xtra-拜克阿普】-checkpoints【切克破安茨】来确定顺序。周天做了一个全量,周一、周二、周三、周四、周五、周六全部做增量到此,增量备份就全部结束了
第八步:模拟数据库故障
[root@mysql ~]# rm -rf /mysql_3306/data/*[root@mysql ~]# pkill mysqld第九步:数据恢复
#innobackupex --defaults【迪-佛特】-file=/mysql_3306/my.cnf --user=admin --password【帕斯沃德】=mysql123 --copy-back /full_xtrabackup【xtra-拜克阿普】/2024-01-06_17-29-11
[root@mysql ~]# innobackupex --defaults-file=/mysql_3306/my.cnf --user=admin --password【帕斯沃德】=mysql123 --copy-back /full_xtrabackup/2025-09-03_18-14-56#chown【吃-昂】 -R mysql.mysql /mysql_3306/data启动数据库,测试验证是否正常
[root@mysql ~]# service【瑟为斯】 mysql_3306 start【s 达儿】[root@mysql ~]# mysql -pEnter password【帕斯沃德】:123mysql > use db_sql;mysql > select【涩莱克特】 * from【弗乱】 t1;day06-MySQL主从复制架构
MySQL主从复制架构
一、任务背景
1、真实案例
某同学刚入职公司,在熟悉公司业务环境的时候,发现他们的数据库架构是一主两从,但是两台从数据库和主库不同步。询问得知,已经好几个月不同步了,但是每天会全库备份主服务器上的数据到从服务器上,由于数据量不是很大,所以一直没有人处理主从不同步的问题。这次正好问到了,于是乎就安排该同学处理一下这个主从不同步的问题。
2、案例背后的核心技术
- 熟悉MySQL数据库常见的主从架构
- 理解MySQL主从架构的实现原理
- 掌握MySQL主从架构的搭建
3、任务场景
随着业务量不断增长,公司对数据的安全性越来越重视,由于常规的备份不能够实时记录下数据库的所有状态,为了能够保障数据库的实时备份冗余,希望将现有单机数据库变成双机热备。
- ①任务要求 备份数据库 搭建双机热备数据库架构M-S
- ②任务目标 了解什么是MySQL的Replication【瑞普利K申】 理解MySQL的Replication【瑞普利K申】的架构原理 掌握MySQL的基本复制架构的搭建(M-S重点) 了解和掌握基于GTIDs的复制特点及搭建
二、MySQL集群概述
1、集群的主要类型
- 高可用集群(High【嗨】 Available【呃 维 勒 布(白话)】 Cluster【克拉斯特】,HA Cluster【克拉斯特】)
- 高可用集群是指通过特殊的软件把独立的服务器连接起来,组成一个能够提供故障切换功能的集群
2、如何衡量高可用
| 可用性级别(指标) | 年度宕机时间 | 描述 | 叫法 |
|---|---|---|---|
| 99% | 3.65天/年 | 基本可用系统 | 2个9 |
| 99.9% | 8.76小时/年 | 可用系统 | 3个9 |
| 99.99% | 52.6分钟/年 | 高可用系统 | 4个9 |
| 99.999% | 5.3分钟/年 | 抗故障系统 | 5个9 |
| 99.9999% | 32秒/年 | 容错系统 | 6个9 |
计算方法:
1年 = 365天 = 8760小时99% = 8760 * 1% = 8760 * 0.01 = 87.6小时=3.65天99.9 = 8760 * 0.1% = 8760 * 0.001 = 8.76小时99.99 = 8760 * 0.0001 = 0.876小时 = 0.876 * 60 = 52.6分钟99.999 = 8760 * 0.00001 = 0.0876小时 = 0.0876 * 60 = 5.26分钟3、常用的集群架构
- MySQL Replication【瑞普利K申】 主从架构
- MySQL Cluster【克拉斯特】 集群架构
- MySQL Group【格鲁普】 Replication【瑞普利K申】 (MGR) 多主一从
- MariaDB Galera【哥 雷 拉】 Cluster【克拉斯特】
- MHA | Keepalived【ki 普赖夫】 | HeartBeat【哈迪 比踢】 | Lvs,HAproxy【哈扑若西】等技术构建高可用集群
三、MySQL复制
1、什么是MySQL复制
- Replication【瑞普利K申】可以实现将数据从一台数据库服务器(master【马斯特】)复制到一台到多台数据库服务器(slave【斯累夫】)
- 默认情况下,属于异步复制,所以无需维持长连接
2、MySQL复制原理
- 简单来说,master【马斯特】将数据库的改变写入二进制日志,slave【斯累夫】同步这些二进制日志,并根据这些二进制日志进行数据重演操作,实现数据异步同步。
- master【马斯特】:主
- slave【斯累夫】:从
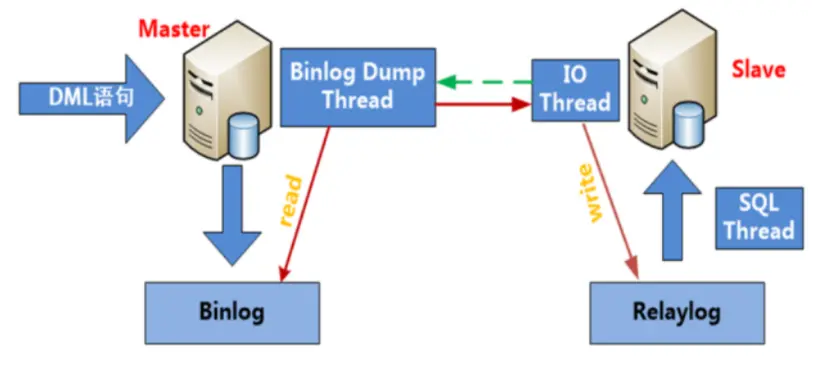
详细描述:
- 当主从同步配置完毕后:
- slave【斯累夫】端的IO线程发送请求给master【马斯特】端的binlog【宾-劳格】 dump【邓破】线程
- master【马斯特】端binlog【宾-劳格】 dump【邓破】线程获取二进制日志信息(文件名和位置信息)发送给slave【斯累夫】端的IO线程
- slave【斯累夫】端IO线程获取到的内容依次写到slave【斯累夫】端relay【瑞雷】 log(中继日志)里,并把master【马斯特】端的bin-log文件名和位置记录到master【马斯特】.info【因否】里
- slave【斯累夫】端的SQL线程,检测到relay【瑞雷】 log中内容更新,就会解析relay【瑞雷】 log里更新的内容,并执行这些操作,从而达到和master【马斯特】数据一致
relay【瑞雷】 log中继日志
- 作用:记录从(slave【斯累夫】)服务器接收来自主(master【马斯特】)服务器的二进制日志
- 场景:用于主从复制
- master【马斯特】主服务器将自己的二进制日志发送给slave【斯累夫】从服务器,slave【斯累夫】先保存在自己的中继日志中,然后再执行自己本地的relay【瑞雷】 log里的sql达到数据库更改和master【马斯特】保持一致。
如何开启?
- 默认中继日志没有开启,可以通过修改配置文件完成开启。
# vim my.cnf[mysqld]#指定二进制日志存放位置及文件名relay【瑞雷】_log=/mysql_3306/data/relay【瑞雷】log3、MySQL复制架构
①双机热备(AB复制)
- 默认情况下,master【马斯特】接收读写请求,slave【斯累夫】只接收读请求以减轻master【马斯特】的压力
②级联复制
- 优点:进一步分担读压力
- 缺点:slave【斯累夫】 1出现故障,后面的所有级联slave【斯累夫】服务器都会同步失败
③并联复制(一主多从)
- 优点:解决上面的slave【斯累夫】1的单点故障,同时也分担读压力
- 缺点:间接增加master【马斯特】的压力
④双主复制
特点:
- 从名称上来看,两台master【马斯特】好像都能接受读、写 请求,但实际上,往往运作的过程中,同一时刻只有其中一台master【马斯特】会接收请求,另外一台只接收读请求。
四、MySQL主从复制的搭建(AB复制)
1、传统AB复制架构
- 说明:在配置MySQL主从架构时,必须保障数据库的版本高度一致,统一版本为5.7.31
2、环境规划
| 编号 | 主机名称 | 主机地址 | 角色信息 |
|---|---|---|---|
| 1 | master【马斯特】.it.cn | 192.168.20.50 | MASTER【马斯特】主服务器 |
| 2 | slave【斯累夫】.it.cn | 192.168.20.60 | SLAVE【斯累夫】从服务器 |
3、安装前准备工作
第一步:克隆服务器
- 克隆两台全新的数据库服务器,MASTER【马斯特】/SLAVE【斯累夫】
第二步:更改主机名称
- 首先启动MASTER【马斯特】,然后启动SLAVE【斯累夫】,更改主机名称
Master【马斯特】:
# hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 master【马斯特】.it.cnSlave【斯累夫】:
#hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 slave【斯累夫】.it.cn第三步:设置静态IP
- 更改静态IP地址,把Master【马斯特】和Slave【斯累夫】配置与规划一致 Master【马斯特】
#vim /etc/sysconfig【西斯肯菲格】/network【孽特 - 沃克】-scripts【斯贵 普茨】/ifcfg-ens33...IPADDR=192.168.20.50Slave【斯累夫】
#vim /etc/sysconfig【西斯肯菲格】/network【孽特 - 沃克】-scripts【斯贵 普茨】/ifcfg-ens33...IPADDR=192.168.20.60Master【马斯特】/Slave【斯累夫】
## systemctl【西斯屯-ctl】 stop【 s 多】 NetworkManager【孽特沃克 面尼杰额】## systemctl【西斯屯-ctl】 disable【滴 s 步】 NetworkManager【孽特沃克 面尼杰额】注意:关闭 NetworkManager【孽特沃克 面尼杰额】服务是配置静态IP过程中一个非常关键且常见的步骤,为了避免 NetworkManager【孽特沃克 面尼杰额】服务与传统的 network【孽特 - 沃克】-scripts【斯贵 普茨】服务发生冲突,让系统只通过传统的 network【孽特 - 沃克】-scripts【斯贵 普茨】方式来管理网络,从而确保静态IP地址配置的稳定性和可靠性
- 设置完成后,重启网络,然后使用shell或MX远程连接
第四步:绑定hosts
- 由于两台机器处于集群架构,需要相互连接。绑定主机名称与IP地址到/etc/hosts
Master【马斯特】/Slave【斯累夫】:
# vim /etc/hosts192.168.20.50 master【马斯特】.it.cn192.168.20.60 slave【斯累夫】.it.cn第五步:关闭防火墙与SElinux
- 关闭防火墙与SElinux
## systemctl【西斯屯-ctl】 stop【 s 多】 firewalld【fai 额 沃 得】## systemctl【西斯屯-ctl】 disable【滴 s 步】 firewalld【fai 额 沃 得】#setenforce【赛特-因佛尔斯】 0#vim /etc/selinux/congSELINUX=disable【滴 s 步】第六步:配置yum源
- 配置yum源(建议使用腾讯源)
# yum install【因-斯多】 wget -y# mv /etc/yum.repos.d/CentOS-Base.repo /etc/yum.repos.d/CentOS-Base.repo.backup# wget -O /etc/yum.repos.d/CentOS-Base.repo http://mirrors.cloud.tencent.com/repo/centos7_base.repo# yum clean【科林恩】 all# yum makecache第七步:时间同步
- 时间同步
#ntpdate 182.92.12.114、MySQL主从复制核心思路
- slave【斯累夫】必须安装相同版本的mysql数据库软件
- master【马斯特】端必须开启二进制日志;slave【斯累夫】端必须开启relay【瑞雷】 log日志
- master【马斯特】端和slave【斯累夫】端的server【涩·沃】-id号不能一致
- slave【斯累夫】端配置向master【马斯特】来同步数据
master【马斯特】端必须创建一个复制用户 保证master【马斯特】和slave【斯累夫】端初始数据一致 配置主从复制(slave【斯累夫】端)
5、MySQL主从复制的具体实践
第一步:上传MySQL软件包到Master【马斯特】与Slave【斯累夫】
第二步:在Master【马斯特】端安装、初始化以及运行mysql软件
安装需求:
| 选项 | 值 |
|---|---|
| 安装路径 | /usr/local/mysql |
| 数据路径 | /usr/local/mysql/data |
| 端口号 | 3306 |
①安装MySQL软件
[root@master ~]# vim mysql.sh#!/bin/bashyum install【因-斯多】 libaio -ytar -xf mysql-5.7.31-linux-glibc【哥里布C】2.12-x86_64.tar.gzrm -rf /usr/local/mysqlmv mysql-5.7.31-linux-glibc【哥里布C】2.12-x86_64 /usr/local/mysqluseradd -r -s /sbin/nologin mysqlrm -rf /etc/my.cnfcd /usr/local/mysqlmkdir【摸克跌儿】 mysql-fileschown【吃-昂】 mysql:mysql mysql-fileschmod【吃-默德】750 mysql-filesbin/mysqld --initialize【因 尼 舍 来斯】 --user=mysql --basedir=/usr/local/mysql &> /root/password【帕斯沃德】.txtbin/mysql_ssl_rsa_setup --datadir=/usr/local/mysql/datacp /usr/local/mysql/support【瑟破特】-files/mysql.server【涩·沃】 /etc/init.d/mysqldservice【瑟为斯】 mysqld start【s 达儿】echo 'export【e斯 破特】 PATH=$PATH:/usr/local/mysql/bin' >> /etc/profilesource /etc/profile
[root@master ~]# source mysql.sh- shell脚本其实就是命令的堆砌,把一堆Linux命令写在同一个文件中,一起执行
②安全配置
[root@master ~]# mysql_secure_installation【因-斯多 雷申】
Securing the MySQL server【涩·沃】 deployment.
Enter password for【fò】 user root: # 输入原始root密码
The existing password for【fò】 the user account root has expired. Please set a new password.
New password: # 设置新root密码
Re-enter new password:
VALIDATE PASSWORD PLUGIN【普辣 京(白话)】 can be used to test passwordsand improve security. It checks the strength of passwordand allows the users to set only【欧利】 those passwords which aresecure enough. Would you like【赖特】 to setup VALIDATE PASSWORD plugin【普辣 京(白话)】?
Press y|Y for Yes, any other key for No: n # 是否安装“密码验证插件”。这个插件可以强制要求用户设置高强度的密码(例如,要求包含数字、大小写字母、特殊符号,并达到最小长度)Using existing password for root.Change the password for root ? ((Press y|Y for Yes, any other key for No) : n # 是否更改root密码
... skipping.By default, a MySQL installation has an anonymous user,allowing anyone to log into【因兔】 MySQL without having to havea user account created for them. This is intended only【欧利】 fortesting, and to make the installation go a bit smoother.You should remove them before moving into【因兔】 a productionenvironment.
Remove anonymous users? (Press y|Y for Yes, any other key for No) : y # 移除匿名用户Success.
Normally, root should only【欧利】 be allowed to connect from【弗乱】'localhost'. This ensures that someone cannot guess atthe root password from【弗乱】 the network.
Disallow root login remotely? (Press y|Y for Yes, any other key for No) : y # 禁止root远程登录Success.
By default, MySQL comes with a database named 'test' thatanyone can access. This is also intended only【欧利】 for testing,and should be removed before moving into【因兔】 a productionenvironment.
Remove test database and access to it? (Press y|Y for Yes, any other key for No) : y # 移除测试数据库 - Dropping test database...Success.
- Removing privileges on test database...Success.
Reloading the privilege tables will ensure that all changesmade so far will take effect immediately.
Reload【率漏德】 privilege tables now? (Press y|Y for Yes, any other key for No) : y # 重载权限表Success.
All done![root@slave ~]#③配置my.cnf(重点开启二进制日志)
[root@master ~]# cd /usr/local/mysql[root@master mysql]# vim my.cnf[mysqld]basedir=/usr/local/mysqldatadir=/usr/local/mysql/datasocket=/tmp/mysql.sockport【破特】=3306log_error=/usr/local/mysql/data/master【马斯特】.errlog_bin=/usr/local/mysql/data/binlog【宾-劳格】 一定要开启二进制日志server【涩·沃】_id=10character_set_server【涩·沃】=utf8mb4 utf8mb4相当于utf8升级版配置完成后,重启mysqld服务
[root@master mysql]# service【瑟为斯】 mysqld restart【 率 s 达r】[root@master mysql]# chkconfig【切-坑菲格】 --add mysqld[root@master mysql]# chkconfig【切-坑菲格】 mysqld on第三步:在Slave【斯累夫】从服务器端安装mysql软件(不需要初始化)
①安装MySQL软件
[root@slave ~]# vim mysql.sh#!/bin/bashyum install【因-斯多】 libaio -ytar -xf mysql-5.7.31-linux-glibc【哥里布C】2.12-x86_64.tar.gzrm -rf /usr/local/mysqlmv mysql-5.7.31-linux-glibc【哥里布C】2.12-x86_64 /usr/local/mysqluseradd -r -s /sbin/nologin mysqlrm -rf /etc/my.cnfcd /usr/local/mysqlmkdir【摸克跌儿】 mysql-fileschown【吃-昂】 mysql:mysql mysql-fileschmod【吃-默德】750 mysql-filescp /usr/local/mysql/support【瑟破特】-files/mysql.server【涩·沃】 /etc/init.d/mysqldecho 'export【e斯 破特】 PATH=$PATH:/usr/local/mysql/bin' >> /etc/profilesource /etc/profile
[root@slave ~]# source mysql.sh相对于主服务器MySQL的安装与配置,从服务器端不需要进行初始化操作,因为其数据将来自于主服务器
②配置my.cnf文件
[root@slave ~]# cd /usr/local/mysql[root@slave mysql]# vim my.cnf[mysqld]basedir=/usr/local/mysqldatadir=/usr/local/mysql/datasocket=/tmp/mysql.sockport【破特】=3310log_error=/usr/local/mysql/data/slave【斯累夫】.errrelay【瑞雷】_log=/usr/local/mysql/data/relay【瑞雷】logserver【涩·沃】_id=100character_set_server【涩·沃】=utf8mb4③把master【马斯特】主服务器的数据目录同步到slave【斯累夫】从服务器
- 把Master【马斯特】服务器中的mysqld停止掉
[root@master mysql]# service【瑟为斯】 mysqld stop【 s 多】Shutting down MySQL... SUCCESS![root@master mysql]#- 把MASTER【马斯特】服务器中的/usr/local/mysql/data目录下的auto【奥特欧】.cnf文件删除
[root@master ~]# rm -rf /usr/local/mysql/data/auto【奥特欧】.cnf每安装一个mysql软件,其data数据目录都会产生一个auto【奥特欧】.cnf文件,里面是一个唯一性的编号,相当于我们每个人的身份证号码
- 把master【马斯特】服务器中的/usr/local/mysql中的data目录拷贝一份到slave【斯累夫】从服务器的/usr/local/mysql目录
[root@master ~]# rsync -av /usr/local/mysql/data root@192.168.20.60:/usr/local/mysql或[root@master ~]# scp -r /usr/local/mysql/data root@192.168.20.60:/usr/local/mysql/
slave端授权[root@slave ~]# chown【吃-昂】 -R mysql:mysql /usr/local/mysql/data- 同步完成后,把主服务器与从服务器中的mysqld启动
#service【瑟为斯】 mysqld start【s 达儿】常见问题解决方案
⭐常见问题1:MySQL无法启动
#service【瑟为斯】 mysql start【s 达儿】Redirecting to /bin/# systemctl【西斯屯-ctl】 start【s 达儿】 mysqld.service【瑟为斯】Failed to start【s 达儿】 mysqld.service【瑟为斯】: Unit not found.出现以上问题的原因在于/etc/init.d目录中没有Mysqld这个文件,换句话说就是cpmysql.servet脚本
#cp /usr/local/mysql/support0files【瑟破踢的-0-伐尔】/mysql.server【涩·沃】 /etc/init.d/mysqld记录:/etc/init.d目录中的文件叫什么名字,我们service【瑟为斯】的时候就应该使用什么名字#service【瑟为斯】 mysql start【s 达儿】常见问题2:MySQL没有安装在/usr/local/mysql目录中,service【瑟为斯】也无法启动
#service【瑟为斯】 mysqld start【s 达儿】无法启动的原因可能是你的MySQL并没有安装在/usr/local/mysql目录中,因为/etc/init.d/mysqld脚本中的basedir于datadir默认指向的都是/usr/local/mysql所以如果我们更换了Mysql的安装位置,则必须更改/etc/init.d/mysqld脚本中basedir与datadir目录
#vim /etc/init.d/mysqldbasedir=你的安装路径datadir=你的安装路径/data常见问题3:因为my.cn配置文件导致mysql无法启动
#vim my.cnf[mysqld]basedir=/usr/local/mysql =>安装路径datadir=/usr/local/mysql/data =>数据目录socket=/tmp/mysql.sock => GLIBC【哥里布C】默认就是/tmp/mysql.sockport【破特】=3310log_error=/usr/local/mysql/data/slave【斯累夫】.err =>错误日志放在哪里relay【瑞雷】_log=/usr/local/mysql/data/relay【瑞雷】logserver【涩·沃】_id=100character_set_server【涩·沃】=utf8mb4启动时报错问题
2024-01-15T06:18:55.566951Z mysqld_safe error: log-error set to'/usr/local/mysql/slave【斯累夫】.err', however le don't exists. Create writable for【fò】 user'mysql'.产生以上问题的主要原因在于mysql这个用户对/usr/local/mysql文件夹没有写入权限
#ll -d /usr/local/mysqldrwxr-xr-x. 11 7161 31415 174 Jan 15 14:18 /usr/local/mysql发现文件拥有者位置与所属组位置都是两个数字,正常应该是文件拥有者的名称与文件所属组的名称。但是由于GLIBC【哥里布C】已经提前打包了,我们解压后,如果在我们系统中,找不到源文件对应的文件拥有者与所属组,则以两个数字代替文件拥有者与所属组的显示。解决方案: 方案一:建议把错误日志,丢在数据目录中
#vim my.cnf...log_error=/usr/local/mysql/data/slave【斯累夫】.err方法二:直接更改/usr/local/mysql目录的权限
#chown【吃-昂】 -R mysql.mysql /usr/local/mysql④配置MASTER【马斯特】-SLAVE【斯累夫】主从同步
1.在MASTER【马斯特】主服务器中创建一个账户,专门用于实现数据同步
Mysql5.7及以下版本:
mysql> grant【古亮普】 replication【瑞普利K申】 slave【斯累夫】 on *.* to 'slave【斯累夫】'@'192.168.20.%' identified【爱-丹-提伐】 by '123';MySQL新版本中:
mysql> create【克瑞特】 user 'slave【斯累夫】'@'192.168.20.%' identified【爱-丹-提伐】 by '123';mysql> grant【古亮普】 replication【瑞普利K申】 slave【斯累夫】 on *.* to 'slave【斯累夫】'@'10.1.1.%';mysql> flush【福 辣 徐】 privileges【P符类 杰 斯】;2. 在MASTER【马斯特】中锁表,然后查看二进制文件的名称及位置
mysql> flush【福 辣 徐】 tables with【威付】 read【滤德】 lock【拉克】;mysql> show【瘦】 master【马斯特】 status【 斯dèi 特斯】;+---------------+----------+--------------+------------------+-------------------+| File | Position | Binlog【宾-劳格】_Do_DB | Binlog【宾-劳格】_Ignore_DB | Executed_Gtid_Set |+---------------+----------+--------------+------------------+-------------------+| binlog【宾-劳格】.000006 | 449 | | | |+---------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)3.在SLVAE【斯累夫】从服务器中,使用change【趁(chèn)吉】 master【马斯特】 to 指定主服务器,并实现数据同步
mysql > change【趁(chèn)吉】 master【马斯特】 to master【马斯特】_host='192.168.20.50',master【马斯特】_user='slave【斯累夫】',master【马斯特】_password【帕斯沃德】='123',master【马斯特】_port【破特】=3306,master【马斯特】_log_file='binlog【宾-劳格】.000006',master【马斯特】_log_pos=449;
说明:MASTER【马斯特】_HOST=:主机的IP地址MASTER【马斯特】_USER=:主机的user账号MASTER【马斯特】_PASSWORD【帕斯沃德】=:主机的user账号密码MASTER【马斯特】_PORT【破特】=主机MYSQL端口号MASTER【马斯特】_LOG_FILE=:二进制文件名称MASTER【马斯特】_LOG_POS=:二进制文件位置主从复制的change【趁(chèn)吉】 master【马斯特】 to语句不知道怎么写或记不住怎么办 答:求帮助
mysql> help change【趁(chèn)吉】 master【马斯特】 to;CHANGE【趁(chèn)吉】 MASTER【马斯特】 TOMASTER【马斯特】_HOST='master【马斯特】2.example.com',MASTER【马斯特】_USER='replication【瑞普利K申】',MASTER【马斯特】_PASSWORD【帕斯沃德】='password【帕斯沃德】',MASTER【马斯特】_PORT【破特】=3306,MASTER【马斯特】_LOG_FILE='master【马斯特】2-bin.001',MASTER【马斯特】_LOG_POS=4,MASTER【马斯特】_CONNECT_RETRY=10;4.启动slave【斯累夫】数据同步
mysql > start【s 达儿】 slave【斯累夫】;mysql > show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】\G常见问题解决方案 在配置主从时,一般遇到错误,大部分都是change【趁(chèn)吉】 master【马斯特】 to语句写错了(80%) 解决方案
mysql > stop【 s 多】 slave【斯累夫】;mysql > change【趁(chèn)吉】 master【马斯特】 to master【马斯特】_host='192.168.20.50',master【马斯特】_user='slave【斯累夫】',master【马斯特】_password【帕斯沃德】='123',master【马斯特】_port【破特】=3306,master【马斯特】_log_le='binlog【宾-劳格】.000006',master【马斯特】_log_pos=449;mysql > start【s 达儿】 slave【斯累夫】;mysql > show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】\G⑤主MASTER【马斯特】服务解锁
mysql > unlock【嗯 拉克】 tables;⑥SLAVE【斯累夫】从服务器不小心写入数据解决方案
正常情况下: MASTER【马斯特】既可以读,也可以写。但是SLAVE【斯累夫】从服务器,只能执行读取操作。一旦我们在SLQVE从服务器种写入数据,则主从架构会失败。 SLAVE【斯累夫】:
#show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】\G
遇到以上问题:如果数量较少,还可以通过当前语句的方式解决,但是如果从服务器写入数据过多,则以上架构必须要重新搭建
解决方案: 如果由于人为操作或者其他原因直接将数据更改到从服务器导致数据同步失效,怎么解决? 答:可以通过变量 sql_slave【斯累夫】_skip_counter【坑俀】 临时跳过事务进行处理
SET GLOBAL【格喽部】 sql_slave【斯累夫】_skip_counter【坑俀】 = N N代表跳过N个事务举例说明:mysql> SET GLOBAL【格喽部】 sql_slave【斯累夫】_skip_counter【坑俀】=1;mysql> stop【 s 多】 slave【斯累夫】;mysql> start【s 达儿】 slave【斯累夫】;注意:1. 跳过事务应该在slave【斯累夫】上进行2. 传统的AB复制方式可以使用变量:sql_slave【斯累夫】_skip_counter【坑俀】,基于GTIDs的方式不支持五、基于GTIDs的AB复制架构(M-S)
1、GTIDs概述
- 什么是GTIDs以及有什么特点?
- GTIDs(Global【格喽部】 transaction【穿插神】 identifiers【爱垫德伐 r s】)全局事务标识符,是mysql 5.6新加入的一项技术
- 当使用GTIDs时,每一个事务都可以被识别并且跟踪
- 添加新的slave【斯累夫】或者当发生故障需要将master【马斯特】身份或者角色迁移到slave【斯累夫】上时,都无需考虑是哪一个二进制日志以及哪个position【珀谁申】值,极大简化了相关操作
- GTIDs是完全基于事务的,因此不支持MYISAM【迈-艾塞姆】存储引擎
- GTID由source【索尔斯】_id和transaction【穿插神】_id组成:
1)source【索尔斯】_id来自于server【涩·沃】_uuid,可以在auto【奥特欧】.cnf中看到 2)transaction【穿插神】_id是一个序列数字,自动生成.
- 使用GTIDs的限制条件有哪些?
- 不支持非事务引擎(MyISAM【迈-艾塞姆】),因为可能会导致多个gtid分配给同一个事务
- create【克瑞特】 table【忒-部】 … select【涩莱克特】 语句不支持(主库语法报错)
- create【克瑞特】/drop temporary table【忒-部】 语句不支持
- 必须使用enforce【因佛尔斯】-gtid-consistency【肯西斯腾西】参数
- sql-slave【斯累夫】-skip-counter【坑俀】不支持(传统的跳过错误方式)
- GTID复制环境中必须要求统一开启和GTID或者关闭GTID
- 在mysql 5.6.7之前,使用mysql_upgrade【阿普格瑞德】 命令会出现问题
2、基于GTIDs的主从复制
在生产环境中,大多数情况下使用的MySQL5.6基本上都是从5.5或者更低的版本升级而来,这就意味着之前的mysql replication【瑞普利K申】方案是基于传统的方式部署,并且已经在运行,因此,接下来我们就利用已有的环境升级至基于GITDs的Replication【瑞普利K申】
思路:
- 修改配置文件支持GTIDs (主+从)
- 重启数据库 (主+从)
- 为了保证数据一致性,master【马斯特】和slave【斯累夫】设置为只读模式 (主+从)
- 从服务器上重新配置同步 (从)
3、基于GTIDs的主从复制实践
①修改配置文件支持GTIDs
MASTER【马斯特】 => my.cnf
# vim my.cnf...gtid_mode【眸的】=onlog_slave【斯累夫】_updates【阿普 dei 茨】=1enforce【因佛尔斯】_gtid_consistency【肯西斯腾西】
# gtid_mode=on# log_slave_updates=1# enforce_gtid_consistency=onSLAVE【斯累夫】 => my.cnf
#rm -rf data/binlog【宾-劳格】.*# vim my.cnf...log_bin=/usr/local/mysql/data/binlog【宾-劳格】 => 必须要开启二进制gtid_mode【眸的】=onlog_slave【斯累夫】_updates【阿普 dei 茨】=1enforce【因佛尔斯】_gtid_consistency【肯西斯腾西】skip_slave【斯累夫】_start【s 达儿】 =>当MASTER【马斯特】主服务器GTIDs没有启动时,跳过SLAVE【斯累夫】服务器的启动
# [root@slave ~]# rm -rf /usr/local/mysql/data/binlog.*# [root@slave ~]# cat /usr/local/mysql/my.cnf# [mysqld]# ......# log_bin=/usr/local/mysql/data/binlog# gtid_mode=on# log_slave_updates=1# enforce_gtid_consistency# skip_slave_start说明: 1)开启GITDs需要在master【马斯特】和slave【斯累夫】上都配置gtid-mode【眸的】,log-bin,log-slave【斯累夫】-updates【阿普 dei 茨】,enforce【因佛尔斯】-gtid-consistency【肯西斯腾西】(该参数在5.6.9之前是—disable【滴 s 步】-gtid-unsafe【安 谁夫】-statement【斯忒特门特】) 2)其次,slave【斯累夫】还需要增加skip-slave【斯累夫】-start【s 达儿】参数,目的是启动的时候,先不要把 slave【斯累夫】起来,需要做一些配置 3)基于GTIDs复制从服务器必须开启二进制日志!
②重新启动mysqld服务
#service【瑟为斯】 mysqld restart【 率 s 达r】
# [root@master/slave ~]# service mysqld restart# Shutting down MySQL.. SUCCESS!# Starting MySQL. SUCCESS!③主从配置只读模式(配置切换期间,防止用户意外写入从库导致数据混乱)
mysql> set【赛特】 @@global【格喽部】.read【滤德】_only【欧利】=ON;
# mysql> set @@global.read_only=ON;# Query OK, 0 rows affected (0.00 sec)#④SLAVE【斯累夫】重新配置change【趁(chèn)吉】 master【马斯特】 to
mysql > stop【 s 多】 slave【斯累夫】;mysql > reset【瑞 赛特】 slave【斯累夫】;mysql > change【趁(chèn)吉】 master【马斯特】 to master【马斯特】_host='192.168.20.50',master【马斯特】_user='slave【斯累夫】',master【马斯特】_password【帕斯沃德】='123',master【马斯特】_port【破特】=3306,master【马斯特】_auto【奥特欧】_position【珀谁申】=1;注意:1、确保有复制用户2、主要区别于传统复制的参数是:change【趁(chèn)吉】 master【马斯特】 to master【马斯特】_host='192.168.20.50',master【马斯特】_user='slave【斯累夫】',master【马斯特】_password【帕斯沃德】='123',master【马斯特】_port【破特】=3306,master【马斯特】_auto【奥特欧】_position【珀谁申】=1;mysql > start【s 达儿】 slave【斯累夫】;mysql > show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】\G
# mysql> stop slave;# Query OK, 0 rows affected, 1 warning (0.00 sec)## mysql> reset slave;# Query OK, 0 rows affected (0.30 sec)## mysql> change master to master_host='192.168.88.50',master_user='slave',master_password='123',master_port=3306,master_auto_position=1;# Query OK, 0 rows affected, 2 warnings (0.66 sec)## mysql> start slave;# Query OK, 0 rows affected (0.02 sec)## mysql> show slave status\G# *************************** 1. row ***************************# Slave_IO_State: Waiting for master to send event# Master_Host: 192.168.88.50# Master_User: slave# Master_Port: 3306# Connect_Retry: 60# Master_Log_File: binlog.000006# Read_Master_Log_Pos: 194# Relay_Log_File: relaylog.000004# Relay_Log_Pos: 401# Relay_Master_Log_File: binlog.000006# Slave_IO_Running: Yes# Slave_SQL_Running: Yes⑤关闭主从服务器的只读模式(恢复主从服务器写入权限)
mysql> set【赛特】 @@global【格喽部】.read【滤德】_only【欧利】=OFF;
# mysql> set @@global.read_only=OFF;# Query OK, 0 rows affected (0.00 sec)#⑥设置slave同步自动重连
[mysqld]...# 取消跳过启动# skip_slave_start=1
# 添加自动重连relay_log_recovery = ONmaster_info_repository = TABLErelay_log_info_repository = TABLE测试验证(往主服务器在写入部分数据,验证一下)
mysql> insert【因涩特】 into【因兔】 db_fq.tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'j');mysql> select【涩莱克特】 * from【弗乱】 db_fq.tb_student【tb_斯丢等特】;
# mysql> insert into db_fq.tb_sutdent values (null,null,null,'男','ui');# Query OK, 1 row affected (0.11 sec)## mysql> select * from db_fq.tb_sutdent;# +----+------+------+--------+---------+# | id | name | age | gender | subject |# +----+------+------+--------+---------+# | 1 | NULL | NULL | 男 | ui |# +----+------+------+--------+---------+# 1 row in set (0.01 sec)#4、SLAVE【斯累夫】从服务器不小心写入数据解决方案
方法一:重新同步data目录,重新change【趁(chèn)吉】 master【马斯特】 to… 方法二:跳过事务
指定需要跳过的GTIDs编号SET【赛特】 GTID_NEXT='aaa-bbb-ccc-ddd:N';开始一个空事务BEGIN;COMMIT;使用下一个自动生成的全局事务ID。SET【赛特】 GTID_NEXT='AUTOMATIC';举例说明:insert【因涩特】 into【因兔】 db_fq.tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'h');SET【赛特】 @@SESSION.GTID_NEXT= '23e8dd07-b12d-11ee-bcfa-000c29e151df:3'/*!*/;mysql > stop【 s 多】 slave【斯累夫】;mysql > SET【赛特】 @@SESSION.GTID_NEXT= '23e8dd07-b12d-11ee-bcfa-000c29e151df:4'/*!*/;mysql > BEGIN;mysql > commit;mysql > SET【赛特】 @@SESSION.GTID_NEXT= 'AUTOMATIC';mysql > start【s 达儿】 slave【斯累夫】;mysql > show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】\G说明:需要跳过哪个事务,需要手动查看relay【瑞雷】log文件得到#mysqlbinlog【宾-劳格】 relay【瑞雷】log.000002# at 624#240116 15:25:35 server id 10 end_log_pos 522 CRC32 0xb1e9834d GTIDlast_committed=1 sequence_number=2 rbr_only【欧利】=yes/*!50718 SET【赛特】 TRANSACTION ISOLATION LEVEL【列沃】 READ COMMITTED*//*!*/;SET【赛特】 @@SESSION.GTID_NEXT= '23e8dd07-b12d-11ee-bcfa-000c29e151df:3'/*!*/;# at 689#240116 15:25:35 server id 10 end_log_pos 590 CRC32 0x66bee6ef Querythread【素瑞德】_id=2 exec_time=0 error_code=0SET【赛特】 TIMESTAMP=1705389935/*!*/;BEGINday07-半同步复制与MHA高可用架构设计
一、半同步复制
1、什么是半同步复制
所谓的半同步复制就是master【马斯特】每commit【肯米特】一个事务(简单来说就是做一个改变数据的操作),要确保slave【斯累夫】接受完主服务器发送的binlog【宾-劳格】日志文件并写入到自己的中继日志relay【瑞雷】 log里,然后会给master【马斯特】信号,告诉对方已经接收完毕,这样master【马斯特】才能把事物成功commit【肯米特】。这样就保证了master【马斯特】-slave【斯累夫】的数据绝对的一致(但是以牺牲master【马斯特】的性能为代价).但等待时间也是可以调整的。
2、半同步复制的基本实现
第一步:准备一套M-S的主从架构(建议使用基于GTIDs架构设计)
第二步:给MASTER【马斯特】与SLAVE【斯累夫】安装插件plugin【普辣 京(白话)】
MASTER【马斯特】:
mysql> install【因-斯多】 plugin【普辣 京(白话)】 rpl_semi【射米】_sync【xing(4声)可】_master【马斯特】 soname【搜 内姆】 'semisync【射米 xing(4声)可】_master【马斯特】.so【搜】';mysql> show【瘦】 global【格喽部】 variables【wèi 利 bóu 斯】 like【赖特】 'rpl_semi【射米】_sync【xing(4声)可】%';
# mysql> install plugin rpl_semi_sync_master soname 'semisync_master.so';## Query OK, 0 rows affected (0.14 sec)## mysql> show global variables like 'rpl_semi_sync%';# +-------------------------------------------+------------+# | Variable_name | Value |# +-------------------------------------------+------------+# | rpl_semi_sync_master_enabled | OFF |# | rpl_semi_sync_master_timeout | 10000 |# | rpl_semi_sync_master_trace_level | 32 |# | rpl_semi_sync_master_wait_for_slave_count | 1 |# | rpl_semi_sync_master_wait_no_slave | ON |# | rpl_semi_sync_master_wait_point | AFTER_SYNC |# +-------------------------------------------+------------+# 6 rows in set (0.01 sec)SLAVE【斯累夫】:
mysql> install【因-斯多】 plugin【普辣 京(白话)】 rpl_semi【射米】_sync【xing(4声)可】_slave【斯累夫】 soname【搜 内姆】 'semisync【射米 xing(4声)可】_slave【斯累夫】.so【搜】';mysql> show【瘦】 global【格喽部】 variables【wèi 利 bóu 斯】 like【赖特】 'rpl_semi【射米】_sync【xing(4声)可】%';
# mysql> install plugin rpl_semi_sync_slave soname 'semisync_slave.so';# Query OK, 0 rows affected (0.13 sec)## mysql> show global variables like 'rpl_semi_sync%';# +---------------------------------+-------+# | Variable_name | Value |# +---------------------------------+-------+# | rpl_semi_sync_slave_enabled | OFF |# | rpl_semi_sync_slave_trace_level | 32 |# +---------------------------------+-------+# 2 rows in set (0.00 sec)#第三步:激活MASTER【马斯特】与SLAVE【斯累夫】服务器中的半同步复制插件
MASTER【马斯特】:
mysql > set【赛特】 global【格喽部】 rpl_semi【射米】_sync【xing(4声)可】_master【马斯特】_enabled【伊内部特】=on【昂】;mysql> show【瘦】 global【格喽部】 variables【wèi 利 bóu 斯】 like【赖特】 'rpl_semi【射米】_sync【xing(4声)可】%';
# mysql> set global rpl_semi_sync_master_enabled=on;# Query OK, 0 rows affected (0.00 sec)## mysql> show global variables like 'rpl_semi_sync%';# +-------------------------------------------+------------+# | Variable_name | Value |# +-------------------------------------------+------------+# | rpl_semi_sync_master_enabled | ON |# | rpl_semi_sync_master_timeout | 10000 |# | rpl_semi_sync_master_trace_level | 32 |# | rpl_semi_sync_master_wait_for_slave_count | 1 |# | rpl_semi_sync_master_wait_no_slave | ON |# | rpl_semi_sync_master_wait_point | AFTER_SYNC |# +-------------------------------------------+------------+# 6 rows in set (0.00 sec)#SLAVE【斯累夫】:
mysql > set【赛特】 global【格喽部】 rpl_semi【射米】_sync【xing(4声)可】_slave【斯累夫】_enabled【伊内部特】=on【昂】;mysql> show【瘦】 global【格喽部】 variables【wèi 利 bóu 斯】 like【赖特】 'rpl_semi【射米】_sync【xing(4声)可】%';
# mysql> set global rpl_semi_sync_slave_enabled=on;# Query OK, 0 rows affected (0.00 sec)## mysql> show global variables like 'rpl_semi_sync%';# +---------------------------------+-------+# | Variable_name | Value |# +---------------------------------+-------+# | rpl_semi_sync_slave_enabled | ON |# | rpl_semi_sync_slave_trace_level | 32 |# +---------------------------------+-------+# 2 rows in set (0.00 sec)#第四步:在SLAVE【斯累夫】服务器中重启IO线程
mysql > stop【 s 多】 slave【斯累夫】 IO_THREAD【素瑞德】;MYSQL > START【s 达儿】 SLAVE【斯累夫】 IO_THREAD【素瑞德】;
# mysql> stop slave IO_THREAD;# Query OK, 0 rows affected (0.02 sec)## mysql> start slave IO_THREAD;# Query OK, 0 rows affected (0.00 sec)#第五步:测试验证半同步复制
注意:当slave【斯累夫】从库的IO_Thread【素瑞德】 线程将binlog【宾-劳格】日志接受完毕后,要给master【马斯特】一个确认,如果超过10s未收到slave【斯累夫】的接收确认信号,那么就会自动转换为传统的异步复制模式。
①master【马斯特】插入一条记录,查看slave【斯累夫】是否有成功返回
mysql > insert【因涩特】 into【因兔】 db_fq.tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'k');mysql> show【瘦】 global【格喽部】 status【 斯dèi 特斯】 like【赖特】 'rpl_semi【射米】_sync【xing(4声)可】%_yes_tx';+-----------------------------------------------------------+-------+| Variable【V啊伊部】_name【内母】 | Value |+-----------------------------------------------------------+-------+| Rpl_semi【射米】_sync【xing(4声)可】_master【马斯特】_yes_tx | 2 |表示这次事务成功从slave【斯累夫】返回一次确认信息该值表示 主库已成功通过半同步复制提交的事务数量自 MySQL 启动以来,已有 2 个事务 被至少一个从库确认接收+-----------------------------------------------------------+-------+说明:
| 状态变量 | 含义 | 健康值 |
|---|---|---|
| Rpl_semi_sync_master_yes_tx | 半同步成功的事务数 | 持续增长 |
| Rpl_semi_sync_master_no_tx | 超时降级为异步的事务数 | 接近0 |
| Rpl_semi_sync_master_status | 半同步功能状态 | ON |
| Rpl_semi_sync_master_clients | 连接的半同步从库数 | ≥1 |
# mysql> insert into db_fq.tb_student values (null,null,null,'男','ui');# Query OK, 1 row affected (0.12 sec)## mysql> show global status like 'rpl_semi_sync%_yes_tx';# +-----------------------------+-------+# | Variable_name | Value |# +-----------------------------+-------+# | Rpl_semi_sync_master_yes_tx | 4 |# +-----------------------------+-------+# 1 row in set (0.01 sec)## 该值表示 主库已成功通过半同步复制提交的事务数量# 自 MySQL 启动以来,已有 4 个事务 被至少一个从库确认接收②模拟SLAVE【斯累夫】服务器故障
SLAVE【斯累夫】:
#service【瑟为斯】 mysqld stop【 s 多】# [root@slave ~]# service mysqld stop# Shutting down MySQL... SUCCESS!# [root@slave ~]#MASTER【马斯特】
mysql> insert【因涩特】 into【因兔】 db_fq.tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'m');默认等待10s时间mysql> insert【因涩特】 into【因兔】 db_fq.tb_student【tb_斯丢等特】 values【挖柳斯】 (null【nò】,'n');现在自动转变了原来的异步模式# mysql> insert into db_fq.tb_student values (null,'m',null,'男','ui');# Query OK, 1 row affected (10.14 sec)## mysql> insert into db_fq.tb_student values (null,'n',null,'男','ui');# Query OK, 1 row affected (0.12 sec)#③重新启动半同步复制
SLAVE【斯累夫】:
#service【瑟为斯】 mysqld start【s 达儿】#mysql -P 3310 -pmysql > set【赛特】 global【格喽部】 rpl_semi【射米】_sync【xing(4声)可】_slave【斯累夫】_enabled【伊内部特】=on【昂】;mysql > stop【 s 多】 slave【斯累夫】 IO_THREAD【素瑞德】;MYSQL > START【s 达儿】 SLAVE【斯累夫】 IO_THREAD【素瑞德】;
# [root@slave ~]# service mysqld start# Starting MySQL. SUCCESS!# [root@slave ~]# mysql -uroot -p# Enter password:# ......# mysql> set global rpl_semi_sync_slave_enabled=on;# Query OK, 0 rows affected (0.00 sec)## mysql> stop slave IO_THREAD;# Query OK, 0 rows affected, 1 warning (0.00 sec)## mysql> start slave IO_THREAD;# Query OK, 0 rows affected (0.00 sec)master【马斯特】需要等到slave【斯累夫】确认后才能提交,如果等不到确认消息,master【马斯特】等到10s钟后自动变成异步模式;slave【斯累夫】启动后,master【马斯特】上改变的数据还是会自动复制过来,数据又会回到一致。
常见故障
当重启半同步复制之后,发现数据没有同步过来,大多数情况下都是GTIDs复制没有配置自启动,导致重启服务后同步失效
mysql> show slave status\G*************************** 1. row *************************** Slave_IO_State: Waiting for master to send event Master_Host: 192.168.88.50 Master_User: slave Master_Port: 3306 Connect_Retry: 60 Master_Log_File: binlog.000011 Read_Master_Log_Pos: 1444 Relay_Log_File: relaylog.000019 Relay_Log_Pos: 445 Relay_Master_Log_File: binlog.000011 Slave_IO_Running: No Slave_SQL_Running: No
[root@slave ~]# vim /usr/local/mysql/my.cnf[mysqld]...# 取消跳过启动# skip_slave_start=1
# 添加自动重连relay_log_recovery = ONmaster_info_repository = TABLErelay_log_info_repository = TABLE
之后重新配置半同步设置3、等待时间的修改(默认10s)
mysql> show【瘦】 global【格喽部】 variables【wèi 利 bóu 斯】 like【赖特】 'rpl_semi【射米】_sync【xing(4声)可】%';mysql> set【赛特】 global【格喽部】 rpl_semi【射米】_sync【xing(4声)可】_master【马斯特】_timeout【泰毛特】=3600000;+------------------------------------------------------------------------------------------------------------+---------------------------+| Variable【V啊伊部】_name【内母】 | Value |+------------------------------------------------------------------------------------------------------------+---------------------------+| rpl_semi【射米】_sync【xing(4声)可】_master【马斯特】_enabled【伊内部特】 | ON【昂】 || rpl_semi【射米】_sync【xing(4声)可】_master【马斯特】_timeout【泰毛特】 | 3600000 || rpl_semi【射米】_sync【xing(4声)可】_master【马斯特】_trace【崔丝】_level【列沃】 | 32 || rpl_semi【射米】_sync【xing(4声)可】_master【马斯特】_wait【威特】_for【fò】_slave【斯累夫】_count【kàn特】 | 1 || rpl_semi【射米】_sync【xing(4声)可】_master【马斯特】_wait【威特】_no_slave【斯累夫】 | ON【昂】 || rpl_semi【射米】_sync【xing(4声)可】_master【马斯特】_wait【威特】_point【破因特】 | AFTER【啊夫特】_SYNC【xing(4声)可】 |+------------------------------------------------------------------------------------------------------------+---------------------------+6 rows in set【赛特】 (0.00 sec)
# mysql> set global rpl_semi_sync_master_timeout=3600000;# Query OK, 0 rows affected (0.00 sec)## mysql> show global variables like 'rpl_semi_sync%';# +-------------------------------------------+------------+# | Variable_name | Value |# +-------------------------------------------+------------+# | rpl_semi_sync_master_enabled | ON |# | rpl_semi_sync_master_timeout | 3600000 |# | rpl_semi_sync_master_trace_level | 32 |# | rpl_semi_sync_master_wait_for_slave_count | 1 |# | rpl_semi_sync_master_wait_no_slave | ON |# | rpl_semi_sync_master_wait_point | AFTER_SYNC |# +-------------------------------------------+------------+# 6 rows in set (0.00 sec)#4、卸载半同步复制插件
mysql> select【涩莱克特】 plugin【普辣 京(白话)】_name,load【漏德】_option【阿普申】 from【弗乱】 information【因弗梅申】_schema【斯基么】.plugins【普辣 京(白话)】; 获取插件名称mysql > uninstall【安 因-斯多】 plugin【普辣 京(白话)】 插件名称;
# mysql> select plugin_name,load_option from information_schema.plugins;# +----------------------------+-------------+# | plugin_name | load_option |# +----------------------------+-------------+# | binlog | FORCE |# | mysql_native_password | FORCE |# | sha256_password | FORCE |# | PERFORMANCE_SCHEMA | FORCE |# | MEMORY | FORCE |# | ............... |# | CSV | FORCE |# | MyISAM | FORCE |# | partition | ON |# | FEDERATED | OFF |# | BLACKHOLE | ON |# | ARCHIVE | ON |# | ngram | ON |# | rpl_semi_sync_master | ON |# +----------------------------+-------------+# 45 rows in set (0.00 sec)## mysql> uninstall plugin rpl_semi_sync_master;# ERROR 1883 (HY000): Plugin 'rpl_semi_sync_master' cannot be uninstalled now. Stop any active semisynchronous slaves of this master first.# mysql> #因为半同步服务还在运行所有卸载失败卸载插件步骤:需先获取插件名称步骤一:先停止slave【斯累夫】的IO线程mysql> stop【 s 多】 slave【斯累夫】 IO_THREAD【素瑞德】;步骤二:卸载slave【斯累夫】的插件mysql> uninstall【安 因-斯多】 plugin【普辣 京(白话)】 rpl_semi【射米】_sync【xing(4声)可】_slave【斯累夫】;步骤三:将master【马斯特】插件状态改为offmysql> set【赛特】 global【格喽部】 rpl_semi【射米】_sync【xing(4声)可】_master【马斯特】_enabled【伊内部特】=off;步骤四:卸载master【马斯特】的插件mysql> uninstall【安 因-斯多】 plugin【普辣 京(白话)】 rpl_semi【射米】_sync【xing(4声)可】_master【马斯特】;
# slave服务器操作# mysql> stop slave IO_THREAD;# Query OK, 0 rows affected (0.06 sec)## mysql> uninstall plugin rpl_semi_sync_slave;# Query OK, 0 rows affected (0.06 sec)## master服务器操作# mysql> set global rpl_semi_sync_master_enabled=off;# Query OK, 0 rows affected (0.01 sec)## mysql> uninstall plugin rpl_semi_sync_master;# Query OK, 0 rows affected (0.05 sec)补充:mysqld重启后,需要手工启动主从同步
#service【瑟为斯】 mysqld stop【 s 多】#service【瑟为斯】 mysqld start【s 达儿】#mysql -P 3310 -pmysql > show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】\GSlav【斯累夫】e_IO_Running【乱宁】: NoSlave【斯累夫】_SQL_Running【乱宁】: No出现以上情况代表mysqld重启后,主从同步也会随之关闭,需要手工启动
mysql > start【s 达儿】 slave【斯累夫】;二、MHA任务背景
1、真实案例
公司现在需要做MySQL数据库迁移,之前数据库是一主两从,使用MHA做了高可用,跑在私有云平台,现在需要这三台数据库迁移到物理机上,而且云上的数据库正在跑,希望做到热迁移,即不影响业务的情况下,把现有数据库从私有云平台迁移到物理真机上。
2、需要掌握的技术
①熟悉MHA高可用的原理和部署 ②掌握MySQL数据库的迁移 ③熟悉MySQL主从复制的模式和搭建(基于GTIDs)
三、MHA简介
1、什么是MHA
MHA(Master【马斯特】 High【嗨】 Availability【呃维勒倍勒提】)目前在MySQL高可用方面是一个相对成熟的解决方案,它由日本DeNA公司youshimaton【哟西马通】(现就职于Facebook【非斯步可】公司)开发,是一套优秀的作为MySQL高可用性环境下故障切换和主从提升的高可用软件。在MySQL故障切换过程中,MHA能做到在0~30秒之内自动完成数据库的故障切换操作,并且在进行故障切换的过程中,MHA能在较大程度上保证数据的一致性,以达到真正意义上的高可用。
2、MHA工作原理
- 当master【马斯特】出现故障时,通过对比slave【斯累夫】之间I/O线程读取master【马斯特】上binlog【宾-劳格】的位置,选取最接近的slave【斯累夫】做为最新的slave【斯累夫】(latest【累提斯特】 slave【斯累夫】)。
- 其它slave【斯累夫】通过与latest【累提斯特】 slave【斯累夫】对比生成差异中继日志,并应用。
- 在latest【累提斯特】 slave【斯累夫】上应用从master【马斯特】保存的binlog【宾-劳格】,同时将latest【累提斯特】 slave【斯累夫】提升为master【马斯特】。
- 最后在其它slave【斯累夫】上应用相应的差异中继日志并开始从新的master【马斯特】开始复制.
3、MHA组件
-
MHA Manager【面尼杰额】(管理节点) MHA Manager【面尼杰额】可以单独部署在一台独立的机器上管理多个master【马斯特】-slave【斯累夫】集群,也可以部署在一台slave【斯累夫】节点上。
-
MHA Node【NO 德】(数据节点) MHA Node【NO 德】运行在每台MySQL服务器上,MHA Manager【面尼杰额】会定时探测集群中的master【马斯特】节点,当master【马斯特】出现故障时,它可以自动将数据的slave【斯累夫】提升为新的master【马斯特】,然后将所有其他的slave【斯累夫】重新指向新的master【马斯特】。整个故障转移过程对应用程序完全透明。
4、MHA组件介绍
-
MHA Manager【面尼杰额】 运行一些工具,比如masterha【马斯特-哈】_Manager【面尼杰额】工具实现自动监控MySQL Master【马斯特】和实现master【马斯特】故障切换,其它工具手动实现master【马斯特】故障切换、在线master【马斯特】转移、连接检查等等。一个Manager【面尼杰额】可以管理多 个master【马斯特】-slave【斯累夫】集群
-
MHA Node【NO 德】 部署在所有运行MySQL的服务器上,无论是master【马斯特】还是slave【斯累夫】。主要有三个作用: 1)保存二进制日志 如果能够访问故障master【马斯特】,会拷贝master【马斯特】的二进制日志 2)应用差异中继日志 从拥有最新数据的slave【斯累夫】上生成差异中继日志,然后应用差异日志。 3)清除中继日志 在不停止SQL线程的情况下删除中继日志
5、MHA工具介绍
(一) Manager【面尼杰额】工具
| 工具 | 说明 |
|---|---|
| masterha【马斯特-哈】_check【切克】_ssh | 检查MHA的SSH配置 |
| masterha【马斯特-哈】_check【切克】_repl | 检查MySQL复制 |
| masterha【马斯特-哈】_manager【面尼杰额】 | 启动MHA |
| masterha【马斯特-哈】_check【切克】_status【 斯dèi 特斯】 | 检测当前MHA运行状态 |
| masterha【马斯特-哈】_master【马斯特】_monitor【魔尼特】 | 监测master【马斯特】是否宕机 |
| masterha【马斯特-哈】_master【马斯特】_switch【斯微曲】 | 控制故障转移(自动或手动) |
| masterha【马斯特-哈】_conf【坑富】_host | 添加或删除配置的server【涩·沃】信息 |
(二) Node【NO 德】工具
| 工具 | 说明 |
|---|---|
| save【C 符】_binary【拜讷瑞】_logs | 保存和复制master【马斯特】的二进制日志 |
| apply【阿普来】_di_relay【瑞雷】_logs | 识别差异的中继日志事件并应用于其它slave【斯累夫】 |
| lter【诶特】_mysqlbinlog【宾-劳格】 | 去除不必要的ROLLBACK【柔拜克】事件(MHA已不再使用这个工具) |
| purge【pò取】_relay【瑞雷】_logs | 清除中继日志(不会阻塞SQL线程) |
注意:Node【NO 德】这些工具通常由MHA Manager【面尼杰额】的脚本触发,无需人手操作。
四、MHA部署架构
1、部署规划
| 角色 | IP | 主机名 | server【涩·沃】-id | 功能 | 备注 |
|---|---|---|---|---|---|
| MHA-Manager【面尼杰额】 | 192.168.20.40 | mha.it.cn | — | 管理节点 | |
| MHA-Node【NO 德】(Master【马斯特】) | 192.168.20.10 | master【马斯特】.it.cn | 10 | 数据节点 | 写 |
| MHA-Node【NO 德】(Slave【斯累夫】1) | 192.168.20.20 | slave【斯累夫】1.it.cn | 20 | 数据节点 | 读 |
| MHA-Node【NO 德】(Slave【斯累夫】2) | 192.168.20.30 | slave【斯累夫】2.it.cn | 30 | 数据节点 | 读 |
2、系统和软件版本
| 系统版本 | MySQL版本 | MHA版本 |
|---|---|---|
| CentOS7.6 | MySQL-5.7.31 | mha4mysql-manager【面尼杰额】-0.57 mha4mysql-node【NO 德】-0.57 |
3、系统环境初始化
第一步:克隆机器,首先启动MASTER【马斯特】,然后在一次启动SLAVE【斯累夫】1、SLAVE【斯累夫】2以及MHA
第二步:更改计算机的主机名称
#hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 master【马斯特】.it.cn#su#hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 slave【斯累夫】1.it.cn#su#hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 slave【斯累夫】2.it.cn#su#hostnamectl【厚斯内姆 ctl】 set-hostname【赛特-厚斯内姆】 mha.it.cn#su第三步:更改IP地址以及绑定主机名称及IP地址到/ets/hosts文件
#vim /etc/sysconfig【西斯肯菲格】/network【孽特 - 沃克】-scripts【斯贵 普茨】/ifcfg-ens33...IPADDR=192.168.20.10 IPADDR=192.168.20.20 IPADDR=192.168.20.30IPADDR=192.168.20.40...## systemctl【西斯屯-ctl】 stop【 s 多】 NetworkManager【孽特沃克 面尼杰额】## systemctl【西斯屯-ctl】 disable【滴 s 步】 NetworkManager【孽特沃克 面尼杰额】## systemctl【西斯屯-ctl】 restart【 率 s 达r】 network【孽特 - 沃克】使用MX连接4台服务器,绑定IP地址与主机名称到/etc/hosts文件中
#vim /etc/hosts192.168.20.10 master【马斯特】.it.cn192.168.20.20 slave1【斯累夫】.it.cn192.168.20.30 slave2【斯累夫】.it.cn192.168.20.40 mha.it.cn第四步:关闭防护墙与SElinux
## systemctl【西斯屯-ctl】 stop【 s 多】 firewalld【fai 额 沃 得】## systemctl【西斯屯-ctl】 disable【滴 s 步】 firewalld【fai 额 沃 得】#setenforce【赛特-因佛尔斯】 0#vim /etc/selinux/congSELINUX=disable【滴 s 步】第五步:配置YUM源 基础源(建议使用腾讯源。略)
# yum install【因-斯多】 wget -y# mv /etc/yum.repos.d/CentOS-Base.repo /etc/yum.repos.d/CentOS-Base.repo.backup# wget -O /etc/yum.repos.d/CentOS-Base.repo http://mirrors.cloud.tencent.com/repo/centos7_base.repo# yum clean【科林恩】 all# yum makecache配置epel源
#wget -O /etc/yum.repos.d/epel.repo http://mirrors.cloud.tencent.com/repo/epel-7.repo#yum clean【科林恩】 all#yum makecache配置本地自建仓库的yum源 ①上传mha-yum软件包到/soft【索夫特】/mha目录
#mkdir【摸克跌儿】 -p /soft【索夫特】/mha②配置本地yum源,当我们使用yum时,可以自动找到mha-yum这个仓库目录
#vim /etc/yum.repos.d/local.repo[mha]name=mha soft【索夫特】baseurl=le:///soft【索夫特】/mha/mha-yumenabled【伊内部特】=1gpgcheck=0测试MHA依赖软件库的安装
#cd /etc/yum.repos.d/#mv local.repo local.repo.bak#yum provides【普歪尺】 createrepo【克瑞特-瑞婆】#yum install【因-斯多】 createrepo【克瑞特-瑞婆】 -y#createrepo【克瑞特-瑞婆】 /soft【索夫特】/mha/mha-yum#mv local.repo.bak local.repo#yum clean【科林恩】 all#yum makecache fastyum -y install【因-斯多】 perl-DBD-MySQL \perl-Cong-Tiny \perl-Time-HiRes \perl-Mail-Sender \perl-Mail-Sendmail \perl-MIME-Base32 \perl-MIME-Charset \perl-MIME-EncWords \perl-Params-Classify \perl-Params-Validate.x86_64 \perl-Log-Dispatch \perl-Parallel-ForkManager \net-tools第六步:ntpdate时间同步
#ntpdate 182.92.12.114、部署MySQL主从复制环境
数据库安装位置:/usr/local/mysql 数据库的数据目录:/usr/local/mysql/data 套接字文件:/tmp/mysql.sock 端口设置:3306 配置文件位置:/usr/local/mysql/my.cnf (MySQL => 安装目录下 => /etc目录下)
⭐MASTER【马斯特】主服务器 第一步:上传软件到/root目录 第二步:使用脚本安装MySQL软件
[root@master mysql]# vim mysql.sh#!/bin/bashyum install【因-斯多】 libaio -ytar -xf mysql-5.7.31-linux-glibc【哥里布C】2.12-x86_64.tar.gzmv mysql-5.7.31-linux-glibc【哥里布C】2.12-x86_64 /usr/local/mysqluseradd -r -s /sbin/nologin mysqlrm -rf /etc/my.cnfcd /usr/local/mysqlmkdir【摸克跌儿】 mysql-fileschown【吃-昂】 mysql:mysql mysql-fileschmod【吃-默德】750 mysql-filesbin/mysqld --initialize【因 尼 舍 来斯】 --user=mysql --basedir=/usr/local/mysql &> /root/password【帕斯沃德】.txtbin/mysql_ssl_rsa_setup --datadir=/usr/local/mysql/datacp support【瑟破特】-files/mysql.server【涩·沃】 /etc/init.d/mysqldservice【瑟为斯】 mysqld start【s 达儿】echo 'export【e斯 破特】 PATH=$PATH:/usr/local/mysql/bin' >> /etc/profilesource【索尔斯】 /etc/profile[root@master mysql]# source【索尔斯】 mysql.sh第三步:设置MySQL密码
[root@master mysql]# mysql -pmysql > set【赛特】 password【帕斯沃德】='123'mysql > flush【福 辣 徐】 privileges【P符类 杰 斯】;第四步:进行安全初始化
[root@master mysql]# mysql_secure_installation;【因-斯多 雷申】第五步:编写MSTER主机中的my.cnf配置文件
[root@master mysql]# vim /usr/local/mysql/my.cnf[mysqld]basedir=/usr/local/mysqldatadir=/usr/local/mysql/datasocket=/tmp/mysql.sockport【破特】=3306log_error=/usr/local/mysql/data/master【马斯特】.errlog_bin=/usr/local/mysql/data/binlog【宾-劳格】server【涩·沃】_id=10character_set【赛特】_server【涩·沃】=utf8mb4gtid_mode【眸的】=onlog_slave【斯累夫】_updates【阿普 dei 茨】=1enforce【因佛尔斯】_gtid_consistency【肯西斯腾西】[root@master mysql]# service【瑟为斯】 mysqld restart【 率 s 达r】⭐SLAVE1【斯累夫】/SLAVE2【斯累夫】从服务器 第一步:上传MySQL软件到服务器端 第二步:使用脚本安装MySQL。但是不需要进行初始化
# vim mysql.sh#!/bin/bashyum install【因-斯多】 libaio -ytar -xf mysql-5.7.31-linux-glibc【哥里布C】2.12-x86_64.tar.gzrm -rf /usr/local/mysqlmv mysql-5.7.31-linux-glibc【哥里布C】2.12-x86_64 /usr/local/mysqluseradd -r -s /sbin/nologin mysqlrm -rf /etc/my.cnfcd /usr/local/mysqlmkdir【摸克跌儿】 mysql-fileschown【吃-昂】 mysql:mysql mysql-fileschmod【吃-默德】750 mysql-filescp support【瑟破特】-files/mysql.server【涩·沃】 /etc/init.d/mysqldecho 'export【e斯 破特】 PATH=$PATH:/usr/local/mysql/bin' >> /etc/profilesource【索尔斯】 /etc/profile#source【索尔斯】 mysql.sh第三步:使用rsync【啊 xing(4声)可】把MASTER【马斯特】服务器中的data数据目录同步到SLAVE1【斯累夫】与SLAVE2【斯累夫】 MASTER【马斯特】
#rm -rf /usr/local/mysql/data/auto【奥特欧】.cnf#rsync【啊 xing(4声)可】 -av /usr/local/mysql/data root@192.168.20.30:/usr/local/mysql/第四步:给SLAVE1【斯累夫】与SLAVE2【斯累夫】配置my.cnf文件 SLAVE1【斯累夫】:
#vim /usr/local/mysql/my.cnf[mysqld]basedir=/usr/local/mysqldatadir=/usr/local/mysql/datasocket=/tmp/mysql.sockport【破特】=3306log_error=/usr/local/mysql/data/slave1【斯累夫】.errlog_bin=/usr/local/mysql/data/binlog【宾-劳格】relay【瑞雷】_log=/usr/local/mysql/data/relay【瑞雷】logserver【涩·沃】_id=20character_set【赛特】_server【涩·沃】=utf8mb4gtid_mode【眸的】=onlog_slave【斯累夫】_updates【阿普 dei 茨】=1enforce【因佛尔斯】_gtid_consistency【肯西斯腾西】skip_slave【斯累夫】_start【s 达儿】SLAVE2【斯累夫】:
#vim /usr/local/mysql/my.cnf[mysqld]basedir=/usr/local/mysqldatadir=/usr/local/mysql/datasocket=/tmp/mysql.sockport【破特】=3306log_error=/usr/local/mysql/data/slave2【斯累夫】.errlog_bin=/usr/local/mysql/data/binlog【宾-劳格】relay【瑞雷】_log=/usr/local/mysql/data/relay【瑞雷】logserver【涩·沃】_id=30character_set【赛特】_server【涩·沃】=utf8mb4gtid_mode【眸的】=onlog_slave【斯累夫】_updates【阿普 dei 茨】=1enforce【因佛尔斯】_gtid_consistency【肯西斯腾西】skip_slave【斯累夫】_start【s 达儿】配置完成后,启动MySQL软件
#service【瑟为斯】 mysql restart【 率 s 达r】⭐配置主从数据同步 第一步:在MASTER【马斯特】服务器中创建一个slave【斯累夫】同步账号
mysql > create【克瑞特】 user 'slave【斯累夫】'@'192.168.20.%' identified【爱-丹-提伐】 by '123';mysql > grant【古亮普】 replication【瑞普利K申】 slave【斯累夫】 on *.* to 'slave【斯累夫】'@'192.168.20.%';mysql > flush【福 辣 徐】 privileges【P符类 杰 斯】;第二步:创建一个mha账号(方便后期MHA监控主从同步状态)
mysql> create【克瑞特】 user 'mha'@'192.168.20.40' identified【爱-丹-提伐】 by '123';mysql> grant【古亮普】 all【哦】 privileges【P符类 杰 斯】 on *.* to 'mha'@'192.168.20.40';mysql> flush【福 辣 徐】 privileges【P符类 杰 斯】;第三步:在SLAVE1【斯累夫】与SLAVE2【斯累夫】中配置主从数据同步
mysql> change【趁(chèn)吉】 master【马斯特】 to master【马斯特】_host='192.168.20.10',master【马斯特】_port【破特】=3306,master【马斯特】_user='slave【斯累夫】',master【马斯特】_password【帕斯沃德】='123',master【马斯特】_auto【奥特欧】_position【珀谁申】=1;mysql > start【s 达儿】 slave【斯累夫】;mysql > show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】\G到此整个一主两从就配置完毕了!
5、MHA软件的安装
①不同节点安装软件
说明:在所有节点安装mha-node【NO 德】软件包,在mha管理端再安装mha-manager【面尼杰额】软件包
[root@mha ~]# yum –y install【因-斯多】 mha4mysql-node【NO 德】-0.57-0.el7.noarch.rpm[root@master【马斯特】 ~]# yum –y install【因-斯多】 mha4mysql-node【NO 德】-0.57-0.el7.noarch.rpm[root@slave1【斯累夫】 ~]# yum -y install【因-斯多】 mha4mysql-node【NO 德】-0.57-0.el7.noarch.rpm[root@slave2【斯累夫】 ~]# yum –y install【因-斯多】 mha4mysql-node【NO 德】-0.57-0.el7.noarch.rpm[root@mha ~]# yum –y install【因-斯多】 mha4mysql-manager【面尼杰额】-0.57-0.el7.noarch.rpm如果以及提前安装依赖软件,则大家可以使用rpm -ivh直接安装
②配置SSH互信(免密登录)
说明:
- 在生产环境中几乎都是禁止root远程登陆服务器的,所以ssh免密码登陆要在admin用户下进行配置,这是处于安全角度考虑出发。
- admin用户可以是任意普通用户
- 该普通用户用于mha的管理节点远程访问mysql复制组中的所有主机,完成一些其他工作
第一步:在所有机器上创建一个普通账号admin,密码123
#useradd admin#echo 123|passwd --stdin admin第二步:配置mha主机到其他主机的admin用户互信
mha端[root@mha ~]# su - admin[admin@mha ~]$ ssh-keygen -P "" -f ~/.ssh/id_rsa[admin@mha ~]$ cd .ssh/[admin@mha .ssh]$ lsid_rsa id_rsa.pub[admin@mha .ssh]$ mv id_rsa.pub authorized_keys[admin@mha .ssh]$ for【fò】 i in 10 20 30;do scp -r ../.ssh/ 192.168.20.$i:~/;done测试免密登录[admin@mha .ssh]$ ssh 192.168.20.10[admin@mha .ssh]$ ssh 192.168.20.20[admin@mha .ssh]$ ssh 192.168.20.30疑问:SSH免密只需要拷贝公钥,但是以上代码把整个.ssh目录拷贝过去了 答:因为MHA的互信,要求的不仅仅是MHA免密到MASTER【马斯特】、SLAVE1【斯累夫】、SLAVE2【斯累夫】、MASTER【马斯特】也要免密到MHA、SLAVE1【斯累夫】、SLAVE2【斯累夫】…
③配置admin用户的sudo权限
MASTER【马斯特】主机上:
[root@master【马斯特】 ~]# vim /etc/sudoers.d/admin#User_Alias 表示具有sudo权限的用户列表; Host_Alias表示主机的列表User_Alias MYSQL_USERS = admin#Runas_Alias 表示用户以什么身份登录Runas_Alias MYSQL_RUNAS = root#Cmnd_Alias 表示允许执行命令的列表(命令需要使用完整路径)Cmnd_Alias MYSQL_CMNDS = /sbin/ifconfig, /sbin/ip, /sbin/arpingMYSQL_USERS ALL = (MYSQL_RUNAS) NOPASSWD: MYSQL_CMNDS把这个权限分发给SLAVE1【斯累夫】与SLAVE2【斯累夫】一份(当故障发生时,从服务器也可以自己设置VIP)
[root@master ~]# for【fò】 i in 20 30;do scp /etc/sudoers.d/admin 192.168.20.$i:/etc/sudoers.d/;done测试admin用户是否可以挂载VIP(只能在MASTER【马斯特】机器上挂载VIP)
#su -admin[admin@master ~]$ sudo /sbin/ifcong ens33:1 192.168.20.100 broadcast 192.168.20.255 netmask 255.255.255.0[admin@master ~]$ sudo /sbin/arping -fqc 5 -w 5 -I ens33 -s 192.168.20.100 -U 192.168.20.10[admin@master ~]$ ip a
补充:arping:用来向局域网内的其它主机发送ARP请求的指令,可以用来测试局域网内的某个IP是否已被使用。-f:收到第一个响应包后退出。-q:quite模式,不显示输出。-c:发送指定的count【kàn特】个ARP REQUEST包后停止。如果指定了-w参数,则会等待相同数量的ARP REPLY包,直到超时为止。-w:指定一个超时时间,单位为秒,arping在到达指定时间后退出,无论期间发送或接收了多少包。在这种情况下,arping在发送完指定的count【kàn特】(-c)个包后并不会停止,而是等待到超时或发送的count【kàn特】个包都进行了回应后才会退出。-I:指定设备名,用来发送ARP REQUEST包的网络设备的名称。-D:重复地址探测模式,用来检测有没有IP地址冲突,如果没有IP冲突则返回0。-s:设置发送ARP包的IP资源地址-U:无理由的(强制的)ARP模式去更新别的主机上的ARP CACHE列表中的本机的信息,不需要响应。-h:显示帮助页。④创建mha相关配置文件
MHA服务器:创建工作目录
#mkdir【摸克跌儿】 /etc/mha创建mha局部配置文件:
#vim /etc/mha/app1.conf【坑富】[server【涩·沃】 default]# 设置监控用户和密码(修改1)user=mhapassword【帕斯沃德】=123# 设置复制环境中的复制用户和密码(修改2)repl_user=slave【斯累夫】repl_password【帕斯沃德】=123# 设置ssh的登录用户名(修改3)ssh_user=admin# 设置监控主库,发送ping包的时间间隔,默认是3秒,尝试三次没有回应的时候自动进行failoverping_interval=3# 设置mgr的工作目录manager【面尼杰额】_workdir=/data/mha/masterha【马斯特-哈】/app1# 设置mysql master【马斯特】保存binlog【宾-劳格】的目录,以便MHA可以找到master【马斯特】的二进制日志(修改4)master【马斯特】_binlog【宾-劳格】_dir=/usr/local/mysql/data# 设置master【马斯特】的pid文件(修改5)master【马斯特】_pid_file=/usr/local/mysql/data/master【马斯特】.it.cn.pid# 设置mysql master在发生切换时保存binlog【宾-劳格】的目录(在mysql master【马斯特】上创建这个目录)remote_workdir=/data/mysql/mha# 设置mgr日志文件(MHA遇到问题,主要看这个日志)manager【面尼杰额】_log=/data/mha/masterha【马斯特-哈】/app1/app1-3306.log# MHA到master【马斯特】的监控之间出现问题,MHA Manager【面尼杰额】将会尝试从slave1【斯累夫】和slave2【斯累夫】登录到master【马斯特】上secondary_check【切克】_script=/usr/bin/masterha【马斯特-哈】_secondary_check【切克】 -s 192.168.20.20 -s 192.168.20.30 --user=admin --port【破特】=22 --master【马斯特】_host=192.168.20.10 --master【马斯特】_port【破特】=3306# 设置自动failover时候的切换脚本(故障发生时,自动挂载VIP到SLAVE1【斯累夫】或SLAVE2【斯累夫】)master【马斯特】_ip_failover_script="/etc/mha/master【马斯特】_ip_failover.sh 192.168.20.100 1"# 设置手动切换时候的切换脚本#master【马斯特】_ip_online_change【趁(chèn)吉】_script="/etc/mha/master【马斯特】_ip_online_change【趁(chèn)吉】.sh 192.168.20.100 1"# 设置故障发生后关闭故障主机脚本# shutdown_script="/etc/mha/power_manager【面尼杰额】"[server【涩·沃】1]hostname=192.168.20.10port【破特】= 3306candidate_master【马斯特】=1[server【涩·沃】2]hostname=192.168.20.20port【破特】= 3306candidate_master【马斯特】=1[server【涩·沃】3]hostname=192.168.20.30port【破特】= 3306candidate_master【马斯特】=1⑤上传相应脚本/etc/mha目录。然后更改配置信息,授权
[root@mha ~]# ls /etc/mha/app1.conf【坑富】 master【马斯特】_ip_failover.sh注意:脚本内容中要修改网卡名字和连接用户为adminmy $vip = shift;my $interface = 'ens33'; 网卡名(38行)my $key = shift;...sub stop_vip() { my $ssh_user = "admin"; 用户名(110行) print "=======$ssh_stop_vip==================\n"; `ssh $ssh_user\@$orig_master【马斯特】_host \" $ssh_stop_vip \"`;}[root@mha ~]#chmod【吃-默德】+x /etc/mha/master【马斯特】_ip_*6、检测SSH互信以及MySQL主从状态
MHA:
#su - admin#检测SSH互信[admin@mha ~]$ masterha【马斯特-哈】_check【切克】_ssh --conf【坑富】=/etc/mha/app1.conf【坑富】#检测集群状态[admin@mha ~]$ masterha【马斯特-哈】_check【切克】_repl --conf【坑富】=/etc/mha/app1.conf【坑富】7、检查MHA状态,然后运行MHA(监控开始)
MHA:
[admin@mha ~]$ masterha【马斯特-哈】_check【切克】_status【 斯dèi 特斯】 --conf【坑富】=/etc/mha/app1.conf【坑富】app1 is stopped(2:NOT_RUNNING【乱宁】).开启MHA Manager【面尼杰额】监控(关键,代表启动MHA):[admin@mha ~]$ nohup masterha【马斯特-哈】_manager【面尼杰额】 --conf【坑富】=/etc/mha/app1.conf【坑富】 --remove_dead_master【马斯特】_conf【坑富】 --ignore_last_failover &再次查看监控状态:[admin@mha ~]$ masterha【马斯特-哈】_check【切克】_status【 斯dèi 特斯】 --conf【坑富】=/etc/mha/app1.conf【坑富】app1 (pid:8913) is running【乱宁】(0:PING_OK), master【马斯特】:192.168.20.10注意:1. 如果正常,会显示”PING_OK ”,否则会显示”NOT_RUNNING【乱宁】 ”,说明 MHA监控没有开启2. 使用admin用户启动监控,否则会报权限拒绝3. 手动停止监控命令:masterha【马斯特-哈】_stop【 s 多】 --conf【坑富】=/etc/mha/app1.conf【坑富】到此为止,MHA就已经配置完毕了
五、自动failover测试
1、在MASTER【马斯特】服务器安装测试工具
[root@master【马斯特】 ~]# yum -y install【因-斯多】 sysbench2、插入测试数据
master【马斯特】服务器上创建测试库testmysql> create【克瑞特】 database test charset【查赛特】 utf8mb4;Query OK, 1 row aected (0.17 sec)mysql> grant【古亮普】 all on *.* to 'mha'@'localhost' identified【爱-丹-提伐】 by '123';Query OK, 0 rows aected (0.14 sec)mysql> flush【福 辣 徐】 privileges【P符类 杰 斯】;Query OK, 0 rows aected (0.11 sec)mysql> exit 【诶西特】Bye[root@master【马斯特】 ~]# sysbench /usr/share/sysbench/oltp_read【滤德】_only【欧利】.lua \--mysql-host=192.168.20.10 --mysql-port【破特】=3306 --mysql-user=mha \--mysql-password【帕斯沃德】=123 --mysql-socket=/tmp/mysql.sock \--mysql-db=test --db-driver=mysql --tables【忒-部】=1 \--table【忒-部】-size=100000 --report【瑞破特】-interval=10 --threads【素瑞德s】=128 --time=120 preparemysql> select【涩莱克特】 count【kàn特】(*) from【弗乱】 sbtest1;+----------+| count【kàn特】(*) |+----------+| 100000 |+----------+1 row in set【赛特】 (0.01 sec)select【涩莱克特】 * from【弗乱】 sbtest1 limit 0,10;3、拍摄快照
MHA、MASTER【马斯特】、SLAVE1【斯累夫】、SLAVE2【斯累夫】
4、模拟MASTER【马斯特】服务器故障
MHA服务器:监控日志
[root@mgr ~]# tail -f /data/mha/masterha【马斯特-哈】/app1/app1-3306.logMASTER【马斯特】服务器:
#service【瑟为斯】 mysqld stop【 s 多】MHA日志显示结果:
故障切换:
VIP漂移:
常见问题
1、管理节点配置文件错误
[root@mgr ~]# cat /etc/mha/app1.conf【坑富】[server【涩·沃】 default]# 设置监控用户和密码,该用户是master【马斯特】上创建的数据库管理账号,拥有所有权限user=mhapassword【帕斯沃德】=123# 设置复制环境中的复制用户和密码,注意需要有以下权限:#REPLICATION【瑞普利K申】 SLAVE【斯累夫】和REPLICATION【瑞普利K申】 CLIENTrepl_user=slave【斯累夫】repl_password【帕斯沃德】=123# 设置ssh的登录用户名ssh_user=admin....[server【涩·沃】1]hostname=10.1.1.10port【破特】= 3306candidate_master【马斯特】=1[server【涩·沃】2]hostname=10.1.1.20port【破特】= 3306candidate_master【马斯特】=1[server【涩·沃】3]hostname=10.1.1.30port【破特】= 3306candidate_master【马斯特】=1注意:一定要配置正确的IP和端口号2、配置MHA时数据只读设置
解决办法:设置从服务器为只读
mysql> set【赛特】 @@global【格喽部】.read【滤德】_only【欧利】=1;Query OK, 0 rows aected (0.00 sec)mysql> show【瘦】 variables【wèi 利 bóu 斯】 like【赖特】 'read【滤德】_only【欧利】';+---------------+-------+| Variable_name | Value |+---------------+-------+| read【滤德】_only【欧利】 | ON |+---------------+-------+1 row in set【赛特】 (0.00 sec)3、复制用户权限密码错误
原因:
- 复制用户slave【斯累夫】没有相关权限,REPLICATION【瑞普利K申】 SLAVE【斯累夫】和REPLICATION【瑞普利K申】 CLIENT
- 从服务器没有创建复制用户
4、其他错误
MHA集群至少需要2个slave【斯累夫】,所以如果只有一台slave【斯累夫】的话,检查也是通不过的!
Mysql 主从复制实操手册
实验一:Mysql 主从复制集群部署
实验目的:
部署 mysql 主从复制集群,实现 mysql 数据库服务的高可用
实验环境:
centos7,内存建议 2G 及以上
实验步骤:
一、主服务配置
1.如果主机已经有数据了,需要先备份数据,后期去从机上恢复因为,主从复制只会同步配置好以后的数据
mysqldump【mysql-当普】 -uroot -p123 -A --single-transaction【穿插神】 > /tmp/all.sql1.需要开启二进制日志(8.0 默认开启)
vim /etc/my.cnfserver【涩·沃】_id=1log_bin=binlog【宾-劳格】 (5.7 版本需要开启)2.重启服务,创建复制用户
create【克瑞特】 user 'repl'@'%' identified【爱-丹-提伐】 by 'Aa123456!';grant【古亮普】 replication【瑞普利K申】 slave【斯累夫】 on *.* to 'repl'@'%';flush【福 辣 徐】 privileges【P符类 杰 斯】;3.查看 binlog【宾-劳格】 二进制的 postition 位置点(从哪个位置开始读取新的日志内容)
show【瘦】 master【马斯特】 status【 斯dèi 特斯】;二、从服务器配置
1.安装(略) 恢复主服务器上的旧数据
mysql -uroot -pAa123456! < all.sql2.自定标识符,不可与主机或其他从机重复
vim /etc/my.cnfserver【涩·沃】_id=2 #不可重复重启服务
3.启动主从复制,指定主机相关参数
change【趁(chèn)吉】 master【马斯特】 to-> master【马斯特】_host='192.168.100.170', #指定主服务器 ip 地址-> master【马斯特】_user='repl', #指定用与复制的用户名-> master【马斯特】_password【帕斯沃德】='Aa123456!', 密码-> master【马斯特】_log_file='mybinlog【宾-劳格】.000003', #指定从哪个二进制日志开始同步-> master【马斯特】_log_pos=469; #指定从上面这个日志的哪个位置开始同步,这两个信息在主服务器上执行 show【瘦】 master【马斯特】 status【 斯dèi 特斯】 查看4.启动主从复制
start【s 达儿】 slave【斯累夫】;5.验证 查看从服务状态:
show【瘦】 slave【斯累夫】 status【 斯dèi 特斯】\G;结果里重点看这两行:....Slave【斯累夫】_IO_Running【乱宁】: YesSlave【斯累夫】_SQL_Running【乱宁】: Yes都是 Yes,表示成功在主服务器上修改数据,从服务器上可以自动同步
实验总结: